

 MySQL

为什么我插入100万条数据要4.04个小时,帮帮我看看原因
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
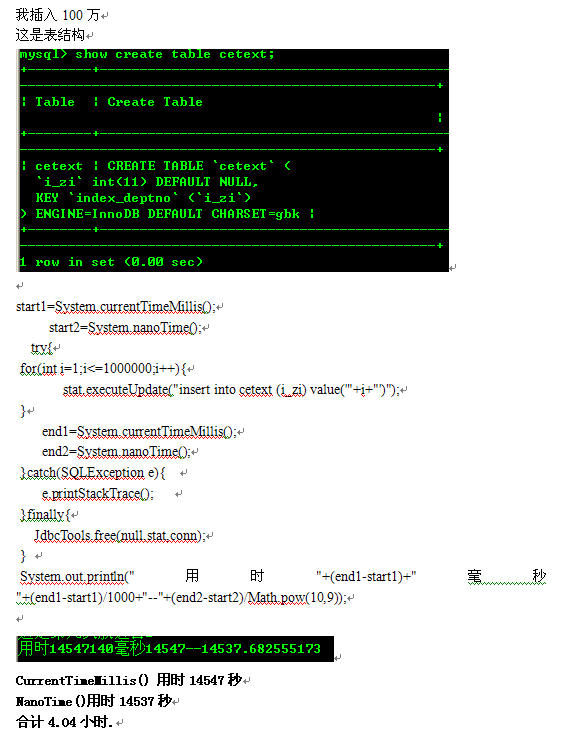
为什么要用这么长的时间呀。让小弟好不久等呀,大神help,help。。小弟在线狂等呀!
相关推荐
100万条数据导入SQL数据库仅用4秒
在IT领域,高效的数据处理能力是至关重要的,尤其是在大数据量的场景下。本文将深入探讨如何使用C#语言实现100万条数据快速导入SQL Server数据库,仅需4秒的惊人速度。
40亿数据Map插入
原文: http://kotek.net/blog/3G_map 思考Java中内存管理的问题,以及Java集合对内存使用的效率情况。我做了一个简单的实验,测试在16G内存条件下,Java的Map可以插入多少对象。这个试验的目的是为了得出集合的内部上限。所以,我决定使用很小的key和value。所有的测试,都是在64w位linux环境下进行的,操作系统是ubuntu12.04。JVM版本为Ora
3分钟如何向MySQL数据库中插入100万条数据
通过这种方式,我们可以实现高效的数据插入,特别是对于100万条数据这样的大数据量。
教你如何6秒钟往MySQL插入100万条数据的实现
在数据库管理中,高效的数据插入是提升系统性能的关键因素之一。本文将详细解析如何在6秒钟内向MySQL数据库中插入100万条数据的实现方法。以下将围绕标题和描述中的关键点展开讨论。
Ubuntu 14.04下MongoDB备份避坑指南:为何不能复制data目录
MongoDB备份本质是保障数据逻辑一致性,而非简单文件拷贝。其核心依赖存储引擎(如WiredTiger或MMAPv1)的事务日志、检查点与元数据协同机制,直接复制data目录会破坏这种强一致性,导致恢复失败。在Ubuntu 14.04这类老旧环境中,问题更突出:默认MongoDB 2.4/2.6版本缺乏现代引擎保护,Upstart进程管理不可靠,且系统级限制(如inodes耗尽、ulimit过低、权限缺失)极易引发mongodump命令未找到或静默失败。因此,必须采用官方推荐的mongodump/mong




