

 Hadoop生态社区












sqoop增量导入数据到hive,生成太多的小文件,如何合并
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
初学sqoop hive,定时增量导入花了几天时间终于搞好,但还是有个问题.我用sqoop创建了job增量导入mysql数据到hive,并开启cron定时器,测试时一分钟运行一次.实际mysql的数据可能是一小时更新一次,即sqoop一分钟运行的job导入时数据都是空的.问题是就算数据是空的也会生成两个文件,一个是_SUCCESS_copy_x,另一个是part-m-0000_copyx,这两个文件大小都是0字节.如图:
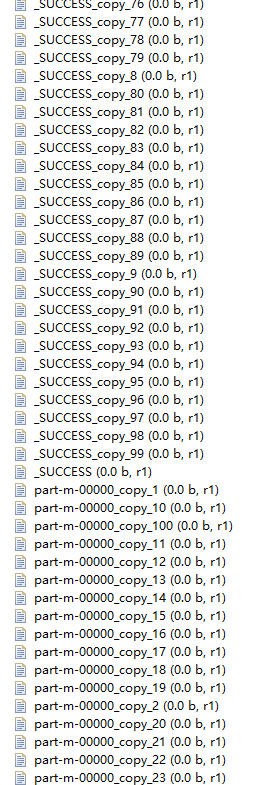
就算mysql里有数据,实际上也是很少的,应该需要合并,
我看hive文档里有个合并小文件的属性,但配了没用.配置如下:
hive.merge.mapfiles=true
hive.merge.mapredfiles=true
请高手指点.
就算mysql里有数据,实际上也是很少的,应该需要合并,
我看hive文档里有个合并小文件的属性,但配了没用.配置如下:
hive.merge.mapfiles=true
hive.merge.mapredfiles=true
请高手指点.
...全文
相关推荐
sqoop导入数据到hive中,数据不一致
NULL 博文链接:https://kingding.iteye.com/blog/2435018
彻底解决Hive小文件问题
最近发现离线任务对一个增量Hive表的查询越来越慢,这引起了我的注意,我在cmd窗口手动执行count操作查询发现,速度确实很慢,才不到五千万的数据,居然需要300s,这显然是有问题的,我推测可能是有小文件。 我去hdfs目录查看了一下该目录: 发现确实有很多小文件,有480个小文件,我觉得我找到了问题所在,那么合并一下小文件吧: insert into test select * from table distribute by floor (rand()*5); 这里使用distribute by进
数仓工具—Hive进阶之优化小文件问题(11)
小文件问题 读者交流群已经开通了,有需要的可以私信进入读者交流群 小文件在HDFS中存储本身就会占用过多的内存空间,这是因为每个文件都有元数据存储在内存中,给namenode内存中fsImage的合并造成压力,如果namenode内存使用完了,这个集群将不能再存储文件了; 对于MR查询过程中过多的小文件又会造成启动过多的Mapper Task, 每个Mapper都是一个后台线程,会占用JVM的空间 即使map阶段都设置了小文件合并,org.apache.hadoop.hive.ql.io.Combin
Sqoop导Oracle数据到Hive
Sqoop导Oracle数据到Hive,代码清晰一目了然
sqoop从mysql中导入数据到parquet格式的hive中
sqoop导入数据到hive




