社区
Java
帖子详情
怎么用java写网络爬虫将网页中的指定数据下载到本地excel文档中
sunshinewxz
2015-04-11 06:27:56
刚开始学网络爬虫,只会把相关的数据打印出来,但是不知道怎么才能下载到本地的文档中,并且如果那个数据是动态的又该怎么办呢?求各位大神详细的java代码
...全文
349
3
打赏
收藏
怎么用java写网络爬虫将网页中的指定数据下载到本地excel文档中
刚开始学网络爬虫,只会把相关的数据打印出来,但是不知道怎么才能下载到本地的文档中,并且如果那个数据是动态的又该怎么办呢?求各位大神详细的java代码
复制链接
扫一扫
分享
举报
写回复
配置赞助广告
用AI写文章
3 条
回复
切换为时间正序
请发表友善的回复…
发表回复
打赏红包
午阿哥
2016-07-12
打赏
举报
回复
午阿哥
2016-07-12
打赏
举报
回复
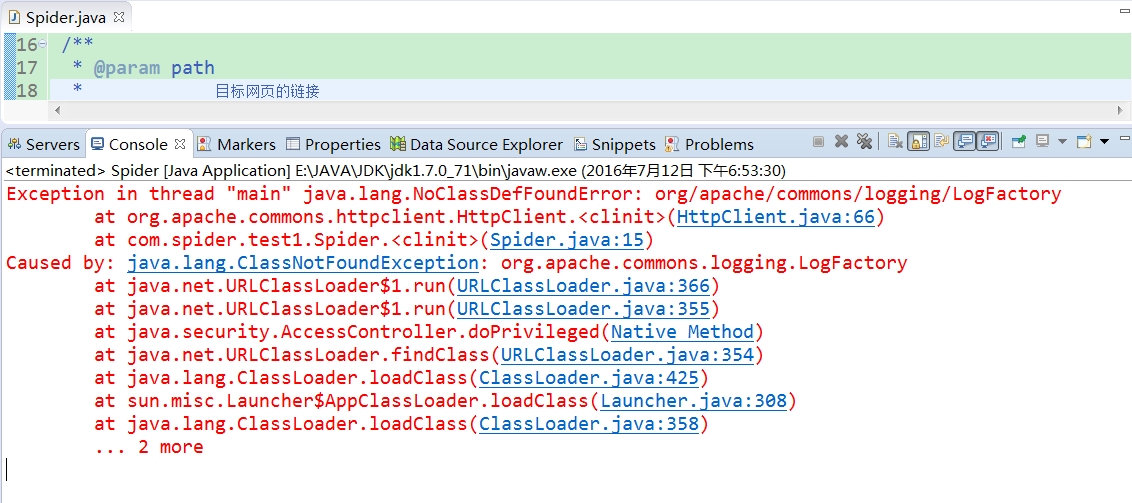
我刚开始学习写爬虫,代码跑起来,是异常,帮我看看; import java.io.FileOutputStream; import java.io.InputStream; import java.io.OutputStream; import org.apache.commons.httpclient.HttpClient; import org.apache.commons.httpclient.HttpStatus; import org.apache.commons.httpclient.methods.GetMethod; /** * * @author CallMeWhy * */ public class Spider { private static HttpClient httpClient = new HttpClient(); /** * @param path * 目标网页的链接 * @return 返回布尔值,表示是否正常下载目标页面 * @throws Exception * 读取网页流或写入本地文件流的IO异常 */ public static boolean downloadPage(String path) throws Exception { // 定义输入输出流 InputStream input = null; OutputStream output = null; // 得到 post 方法 GetMethod getMethod = new GetMethod(path); // 执行,返回状态码 int statusCode = httpClient.executeMethod(getMethod); // 针对状态码进行处理 // 简单起见,只处理返回值为 200 的状态码 if (statusCode == HttpStatus.SC_OK) { input = getMethod.getResponseBodyAsStream(); // 通过对URL的得到文件名 String filename = path.substring(path.lastIndexOf('/') + 1) + ".html"; // 获得文件输出流 output = new FileOutputStream(filename); // 输出到文件 int tempByte = -1; while ((tempByte = input.read()) > 0) { output.write(tempByte); } // 关闭输入流 if (input != null) { input.close(); } // 关闭输出流 if (output != null) { output.close(); } return true; } return false; } public static void main(String[] args) { try { // 抓取百度首页,输出 Spider.downloadPage("http://www.baidu.com"); } catch (Exception e) { e.printStackTrace(); } } }
marzone
2016-04-06
打赏
举报
回复
问题解决没?我也在学习!
爬虫
网页
的
数据
java
_怎么用
java
写
网络
爬虫
将
网页
中
的
指定
数据
下载
到本地
excel
文档
中
...
使用HttpURLConnection会用到
java
.net底下的物件以及
java
.io.InputStream,因此需要在程式一开始载入,如下:import
java
.io.InputStream;import
java
.net.*;public class HelloHttp {}接著就可以仿照下列范例建立HTTP连线:URL url = new URL("http://tw.yahoo.co...
常用的
网络
爬虫
工具推荐
在推荐常用的
网络
爬虫
工具时,我们可以根据工具的易用性、功能强大性、用户口碑以及是否支持多种操作系统等多个维度进行考量。
【推荐收藏】33款可用来抓
数据
的开源
爬虫
软件工具
网络
爬虫
是一种自动提取
网页
内容的程序,是搜索引擎的重要组成部分。传统
爬虫
从一个或若干初始
网页
的URL开始,获得初始
网页
上的URL,在抓取
网页
的过程
中
不断从当前页面上抽取新的URL放入队列,直到满足系统的一定停止条件。聚焦
爬虫
的工作流程更为复杂,需要根据一定的
网页
分析算法过滤与主题无关的链接,保留有用的链接并将其放入等待抓取的URL队列。所有被
爬虫
抓取的
网页
会被系统存储、分析、过滤,并建立索引以便查询和检索。对于需要抓取
网络
数据
但不想从头开发
爬虫
的用户,(抓包大师)是一个不错的选择。
Java
网络
爬虫
实际的
爬虫
是从一系列的种子链接开始。种子链接是起始节点,种子页面的超链接指向的页面是子节点(
中
间节点),对于非html
文档
,如
excel
等,不能从
中
提取超链接,看做图的终端节点
网络
爬虫
的基本知识
网络
爬虫
通过遍历互联
网络
,把
网络
中
的相关
网页
全部抓取过来,这体现了爬的概念。
爬虫
如何遍历
网络
呢,互联网可以看做是一张大图,每个页面看做其
中
的一个节点,页面的连接看做是有向边。图的遍历方式分为宽度遍历和深度
用python抓取一个
网页
的xhr,python爬取网站
数据
代码
使用Python进行
网页
抓取时还有一些更高级功能的选项,这些将在最后概述,并提供一些使用上的建议。如果您选择了一个简单的目标,在大多数情况下,
数据
将以与上述示例类似的方式嵌套。由于从同一个类
中
获取
数据
只是意味着一个额外的列表,我们应该尝试从不同的类
中
提取
数据
,但同时保持我们表的结构。在之前的文章
中
我们介绍了怎么用C#和
JAVA
两种方法来抓取
网页
,这一期给大家介绍一种更容易,也是使用最广泛的一种抓取方法,那就是。我们的第二次搜索查找
文档
中
的所有标签(被包括在内,而像这样的部分匹配则不被包括在内)。
Java
51,407
社区成员
86,124
社区内容
发帖
与我相关
我的任务
Java
Java相关技术讨论
复制链接
扫一扫
分享
社区描述
Java相关技术讨论
java
spring boot
spring cloud
技术论坛(原bbs)
社区管理员
加入社区
获取链接或二维码
近7日
近30日
至今
加载中
查看更多榜单
社区公告
暂无公告
试试用AI创作助手写篇文章吧
+ 用AI写文章


 发帖
 与我相关
 我的任务

 分享