

 CUDA高性能计算讨论

关于Cuda优化寄存器问题
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
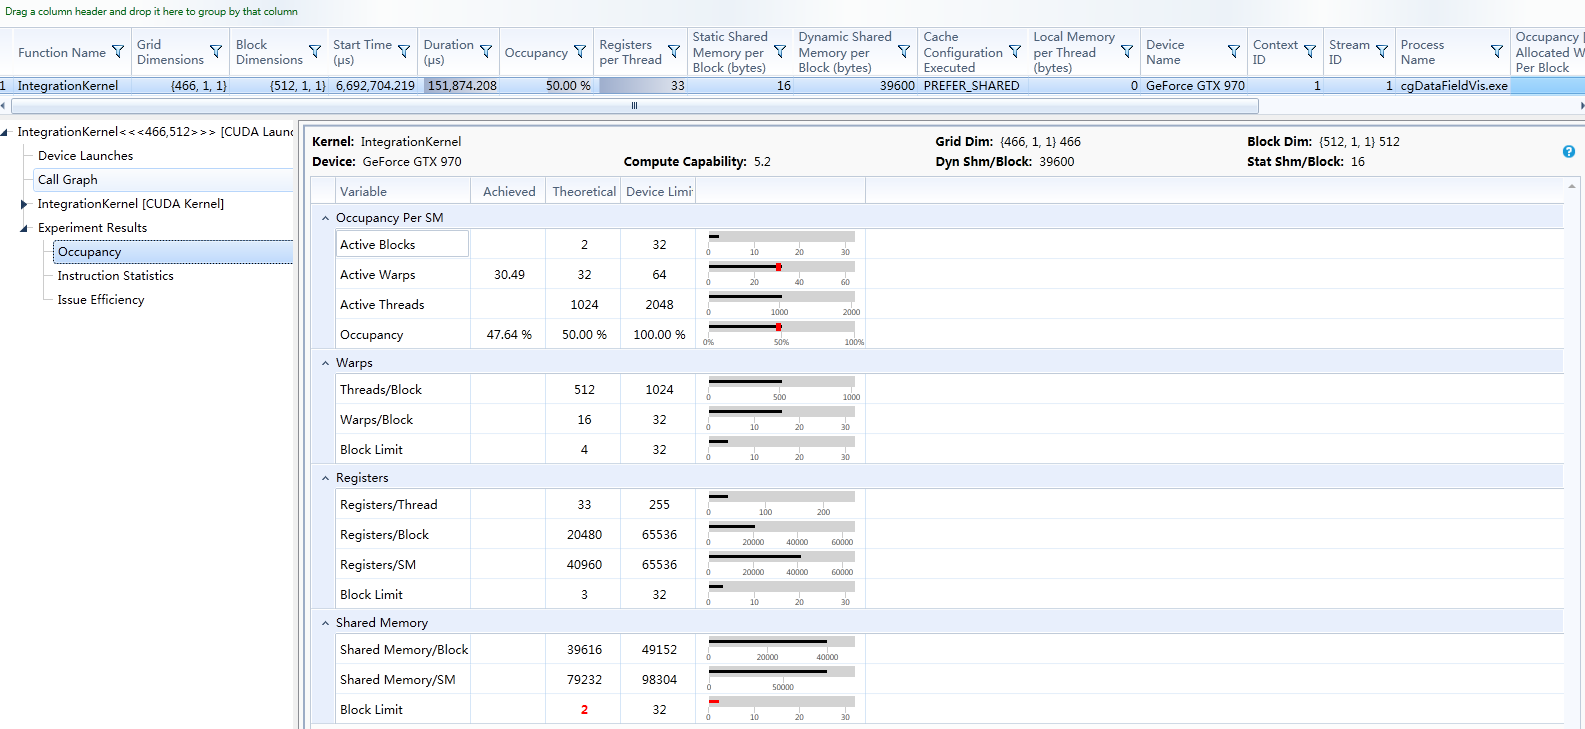
上图为本人程序Nsight分析结果,由于寄存器个数为33,始终找不到方法将寄存器的个数降到32,已将程序中使用的中间变量全部替换,请各位大神帮忙,通过分析此程序,给予优化建议。尤其是,如何降低寄存器的使用个数。
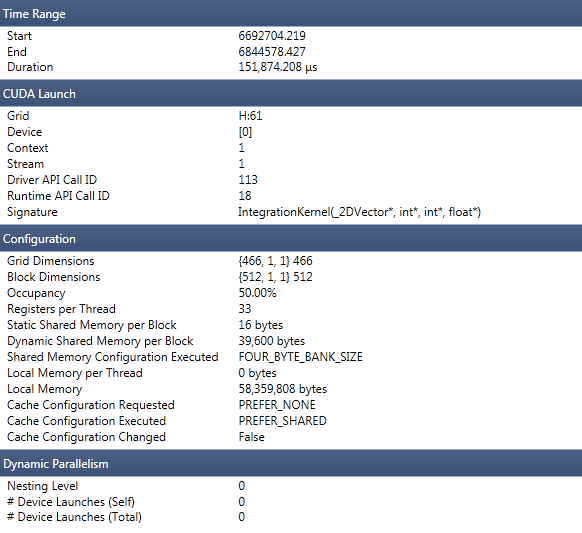
上图显示Local memory per thread 的使用量为0,所以,我想可否将寄存器转换到LOCAL MEMEORY?已降低寄存器数量?谢谢~~
...全文
相关推荐
推荐CUDA程序优化的15个策略
通过优化寄存器使用,可以减少寄存器访问次数,从而提高程序性能。CUDA 程序优化是一个复杂的过程,需要了解 CUDA 架构和内存模型,并且需要了解各种优化策略。
Cuda reduce算子实现与优化
本文分析了CUDA并行归约计算的优化思路。原始归约方法存在线程闲置、线程束分歧和存储体冲突等问题,导致性能受限。优化方案通过warpReduce函数实现:1)采用无分支执行消除线程束分化;2)保持全线程参与避免闲置;3)利用寄存器级通信(__shfl_down_sync)替代共享内存访问,规避存储体冲突。这些改进使同一warp内的32个线程能同步执行相同操作,显著提升了并行计算效率。最终实现了更高效的GPU归约计算模式。
CUDA——性能优化(一)
内存访问是CUDA性能优化的另一个关键点。全局内存访问通常伴随着显著的延迟,大约400-600个时钟周期,这远高于其他内存层次(如共享内存和寄存器)。
cuda存储器
此外,NVIDIA提供的CUDA工具和文档,如CUDA C Programming Guide,能帮助开发者深入理解和调试存储器相关的性能问题。
cuda-TSP:使用 CUDA 扩展在 C 中实现旅行商问题
- 内存层次结构(包括寄存器、共享内存、全局内存和常量内存)是CUDA优化的关键,合理利用不同类型的内存可以提升性能。3.




