

 Hadoop生态社区












运行hadoop的MapReduce示例,在running job卡住,不能继续运行
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
求大神解答!!在网上搜索解决办法,都没搜到答案
我的hadoop版本是CDH5.4的,安装了伪分布模式,想运行示例程序验证一下,结果就卡在running job上,没法继续运行
运行示例如下:
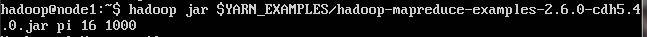
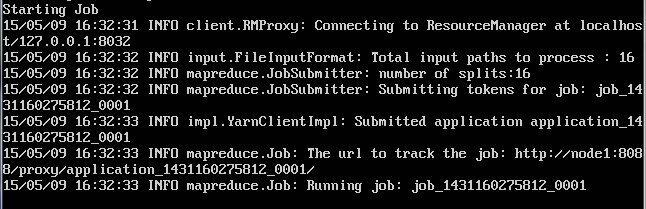
结果在running job上卡住了
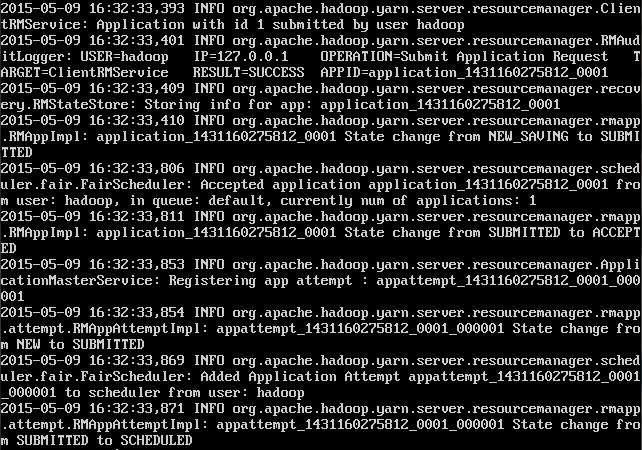
查看resourcesmanager的日志,提示到了"State change from SUBMITTED to SCHEDULED"就没有了:
求大神指导阿!!要崩溃了……
我的hadoop版本是CDH5.4的,安装了伪分布模式,想运行示例程序验证一下,结果就卡在running job上,没法继续运行
运行示例如下:
结果在running job上卡住了
查看resourcesmanager的日志,提示到了"State change from SUBMITTED to SCHEDULED"就没有了:
求大神指导阿!!要崩溃了……
...全文
相关推荐
大数据 hadoop mapreduce 词频统计
**运行Job**:配置好MapReduce作业后,提交到Hadoop集群进行执行。集群会自动调度任务,将工作分配给各个节点。5.
Hadoop:INFO mapreduce.Job: Running job
(-1)把Yarn运行的内存搞成8g,4g也行,如果是开的虚拟机,这个好办,如果是用云服务器搭建的,那就换个运存大点的服务器,不想换那就参照(0),CSDN上最吊的。 (0)CSDN最迪吊解决办法,涉及到本质,其他都是不让MapReduce运行在Yran上,这个是真正修改了Yran与运行所需要的内存包括物理内存和虚拟内存 Hadoop提交MapReduce任务后卡在mapreduce.Job: Running job_阿团团的博客-CSDN博客 (1)查看所有的结点的NodeManager开启情况
使用命令行编译打包运行自己的MapReduce程序 Hadoop2.6.0
在Hadoop 2.6.0中,运行一个简单的MapReduce示例——WordCount,至少需要以下三个JAR文件:- `$HADOOP_HOME/share/hadoop/common/hadoop-common
Hadoop-MapReduce实践示例
MapReduce的实践示例往往涉及到数据的分布式存储、任务的切分、并行处理以及最终的数据汇总。该实践涉及的主要知识点包括:1.
hadoop mapreduce多表关联join多个job相互依赖传递参数
4. ** guidjoinapp 示例**: - 这个应用程序很可能是一个示例,演示了如何在Hadoop MapReduce中实现多表关联并处理Job间的依赖和参数传递。




