

 Web 开发

去除重复查询的解决方案
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
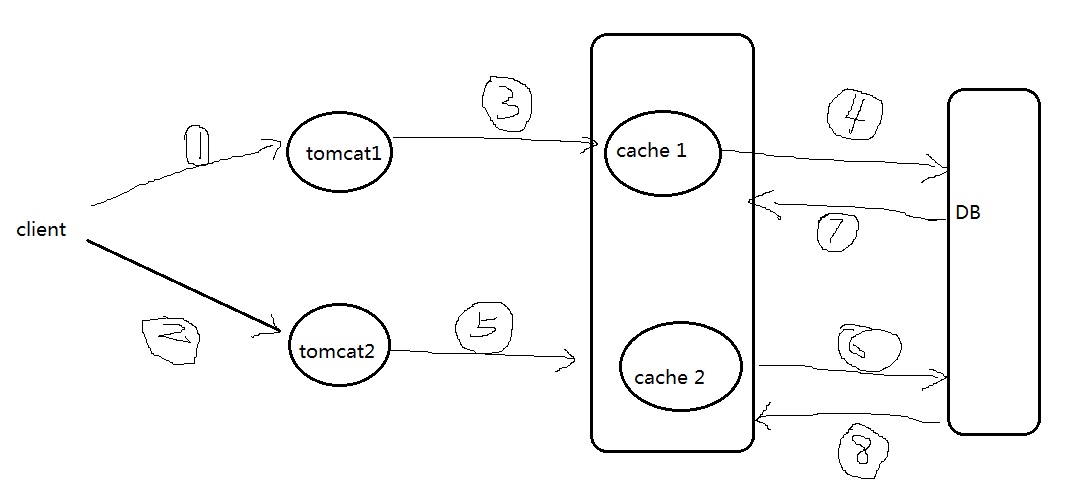
场景(按时间顺序进行)
1. 客户发送请求 1 到tomcat1,
2. tomcat1 去查询缓存(图片中的3),发现没有命中
3. 这时候去去查询db(图片中的4),
4. 返回 (图片7)
5. 另一个客服发送同样的请求到 tomcat2,(图片中的2)
6, 查询缓存,未命中(图片5)
7. 查询db (图片6)
8. 返回 (图片8)
问题
当并发请求的时候,当步骤4正在进行的时候, 步骤7 就是一个重复的查询,可能步骤7刚开始进行的时候,步骤4完成了,那步骤7就是无用的,响应降低。
好的方式应该是步骤6 结束后,去查询db 前,发现已经有同样的查询正在进行了,那就不应该再次进行查询,应该等待上一个查询结束,直接从cache里面获取结果。
我的问题是,在分布式的系统里面,如何避免这种重复查询啊。哪位朋友指点一下,谢谢了。
相关推荐
使用distinct在mysql中查询多条不重复记录值的解决办法
在使用mysql时,有时需要查询出某个字段不重复的记录,虽然mysql提供有distinct这个关键字来过滤掉多余的重复记录只保留一条,但往往只用它来返回不重复记录的条数,而不是用它来返回不重记录的所有值。其原因是distinct只能返回它的目标字段,而无法返回其它字段,这个问题让我困扰了很久,用distinct不能解决的话,我只有用二重循环查询来解决,而这样对于一个数据量非常大的站来说,无疑是会直接影响到效率的。所以我花了很多时间来研究这个问题,网上也查不到解决方案,期间把容容拉来帮忙,结果是我们两人都郁闷了。。。。。。。。。 下面先来看看例子: table id name
表格查询(去除重复数据)
本次任务完成时间:2019年7月16日 开发工具与关键技术:MyEclipse 10、Java 一、第一种 1、当在操作多表查询的时候,经常会出现查询的数据有多条是重复的,查询结果并不是我们想要的,那么这时候就要考虑怎么把重复的数据去除掉,只留下一条数据作为显示结果。 下面是我多表连接查询的结果,因为新增的时候,有些数据的某个ID是一样,所以查询的时候,就出现了笛卡尔集,其每条数据都去匹配,就会出...
第2关:查询空值与去除重复结果
查询空值与去除重复结果
去除显示重复的conda环境
Anaconda Navigator shows duplicated Conda-envs Anaconda导航器显示重复的conda环境 Github问题页面如下:https://github.com/ContinuumIO/anaconda-issues/issues/8623 问题描述 在执行查询conda环境命名时conda info -e 或conda info --envs 或conda env list,某些环境重复出现 问题展示如下: (base) C:\WINDOWS\system3
Django 解决distinct无法去除重复数据的问题
今天需要使用Django查询一列的字段(不含重复),搞了一上午,发现这样的事情:如图: 得到的数据几乎是相等的,没有区别。 但是仔细看会发现:下面的数据比起上面的还是少了一个。 解决办法: django的distinct在使用之前必须先使用order_by方法排序,如图: 这样就完美解决了这个问题。 补充知识:Distinct和Group by去除重复字段记录 重复记录 有两个意义,一是完全重复的记录,也即所有字段均重复的记录 二是部分关键字段重复的记录,比如Name字段重复,而其他字段不一定重复或都重复可以忽略。 1、对于第一种重复,比较容易解决,使用 select distinct




