

 脚本语言

Python 如何爬取相同url下,多个页面的链接内容
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
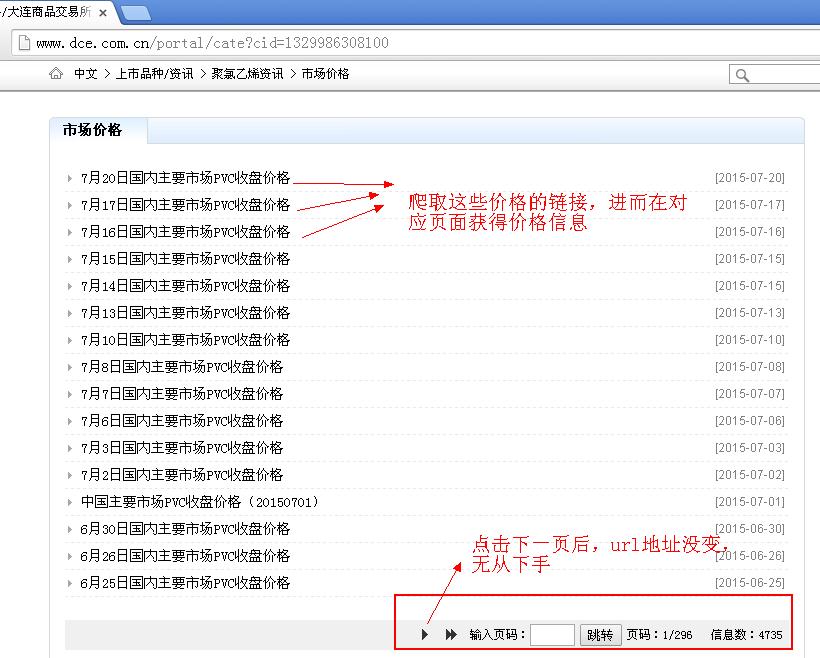
目前已能够从以上链接的第一页,把该页显示的市场价格链接爬取下来,并提取出价格信息(github托管的代码https://github.com/songwill/download-pvc-data/blob/master/pagelink.txt)。
但是点击第二页后,发现url和第一页显示的一模一样,不能用学过的循环去爬取接下来的第2页、第3页……的价格链接。求大神们指点下:
1、为什么不同页面内容会在同一个url下显示
2、要爬取后续页面里的链接,代码该如何写
相关推荐
利用python爬取豆瓣音乐TOP250的数据----爬取的247首歌曲的网址
需要说明的是,豆瓣页面上第4、5、6页只有24首(不是25首),所以总数量是247,不是250。不是爬虫代码有问题,是豆瓣页面上就只有247条数据。 通过函数get_music_info()可以获取所有的网页,通过写入TXT文本文档中,可以直观看到有多少内容。
用python爬取漫画!
Hi~ 大家好! 今日教大家用Python爬取某网站的全部漫画,让你想看什么漫画就看什么漫画!本文代码量有的多,请耐心看完!如果不想看分析网页,可拉取到爬取思路和实现代码区域,查看基本思路和代码!经过作者测试,测试过的漫画都可以下载!本文图片以及文本仅供学习、交流使用,要想获得更好的体验,请支持正版! 本文完整代码见文末! 分析网页 受害者: https://www.kanman.com/sort/ 漫画其实是一张一张图片来着,所以我们先找到这些图片的链接在哪里!因为本文是为了实现想看什么漫画就爬取什么漫
Python爬虫实战[源码]
本文分享了作者通过学习小甲鱼的Python课程后,动手实践编写的一个图片爬虫程序。该程序能够从指定网站爬取图片并保存到本地文件夹中。文章详细介绍了程序的各个功能模块,包括URL请求、页面解析、图片地址提取、图片保存等。作者还展示了如何通过循环遍历多个图包并下载其中的图片,同时设置了适当的延迟以避免对服务器造成过大压力。虽然代码中缺少注释,但整体逻辑清晰,适合对Python爬虫感兴趣的读者参考学习。
Python爬虫获取页面所有URL链接过程详解
主要介绍了Python爬虫获取页面所有URL链接过程详解,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友可以参考下
Python3 实现爬取网站下所有URL方式
获取首页元素信息: 目标 test_URL:http://www.xxx.com.cn/ 首先检查元素,a 标签下是我们需要爬取得链接,通过获取链接路径,定位出我们需要的信息 soup = Bs4(reaponse.text, "lxml") urls_li = soup.select("#mainmenu_top > div > div > ul > li") 首页的URL链接获取: 完成首页的URL链接获取,具体代码如下: ''' 遇到不懂的问题?Python学习交流群:821460695满足你的需求,资料都已经上传群文件,可以自行下载! ''' def get_first_url()




