小弟刚学hadoop,运行第一个mapreduce就出错了

hdfs://itcast01/test/下有个wordcount.txt文件,内空如下:
hello a
hello a
hello b
hello b
hello c
hello a
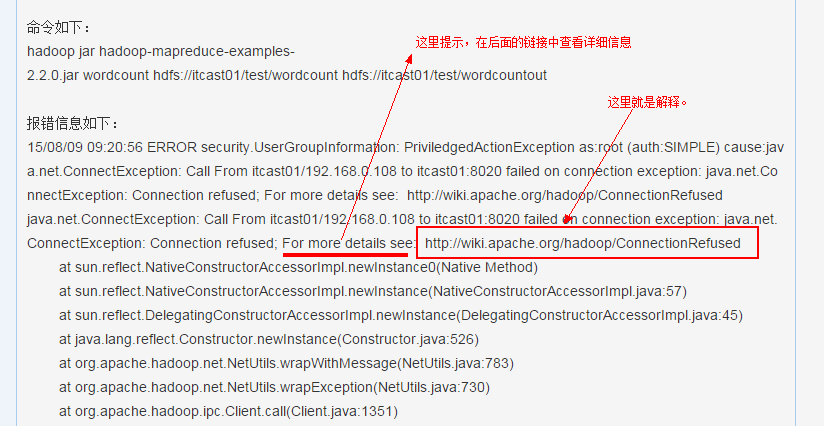
命令如下:
hadoop jar hadoop-mapreduce-examples-2.2.0.jar wordcount hdfs://itcast01/test/wordcount hdfs://itcast01/test/wordcountout
报错信息如下:
15/08/09 09:20:56 ERROR security.UserGroupInformation: PriviledgedActionException as:root (auth:SIMPLE) cause:java.net.ConnectException: Call From itcast01/192.168.0.108 to itcast01:8020 failed on connection exception: java.net.ConnectException: Connection refused; For more details see: http://wiki.apache.org/hadoop/ConnectionRefused
java.net.ConnectException: Call From itcast01/192.168.0.108 to itcast01:8020 failed on connection exception: java.net.ConnectException: Connection refused; For more details see: http://wiki.apache.org/hadoop/ConnectionRefused
at sun.reflect.NativeConstructorAccessorImpl.newInstance0(Native Method)
at sun.reflect.NativeConstructorAccessorImpl.newInstance(NativeConstructorAccessorImpl.java:57)
at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java:45)
at java.lang.reflect.Constructor.newInstance(Constructor.java:526)
at org.apache.hadoop.net.NetUtils.wrapWithMessage(NetUtils.java:783)
at org.apache.hadoop.net.NetUtils.wrapException(NetUtils.java:730)
at org.apache.hadoop.ipc.Client.call(Client.java:1351)
at org.apache.hadoop.ipc.Client.call(Client.java:1300)
at org.apache.hadoop.ipc.ProtobufRpcEngine$Invoker.invoke(ProtobufRpcEngine.java:206)
at com.sun.proxy.$Proxy9.getFileInfo(Unknown Source)
at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)
at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:57)
at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)
at java.lang.reflect.Method.invoke(Method.java:606)
at org.apache.hadoop.io.retry.RetryInvocationHandler.invokeMethod(RetryInvocationHandler.java:186)
at org.apache.hadoop.io.retry.RetryInvocationHandler.invoke(RetryInvocationHandler.java:102)
at com.sun.proxy.$Proxy9.getFileInfo(Unknown Source)
at org.apache.hadoop.hdfs.protocolPB.ClientNamenodeProtocolTranslatorPB.getFileInfo(ClientNamenodeProtocolTranslatorPB.java:651)
at org.apache.hadoop.hdfs.DFSClient.getFileInfo(DFSClient.java:1679)
at org.apache.hadoop.hdfs.DistributedFileSystem$17.doCall(DistributedFileSystem.java:1106)
at org.apache.hadoop.hdfs.DistributedFileSystem$17.doCall(DistributedFileSystem.java:1102)
at org.apache.hadoop.fs.FileSystemLinkResolver.resolve(FileSystemLinkResolver.java:81)
at org.apache.hadoop.hdfs.DistributedFileSystem.getFileStatus(DistributedFileSystem.java:1102)
at org.apache.hadoop.fs.FileSystem.exists(FileSystem.java:1397)
at org.apache.hadoop.mapreduce.lib.output.FileOutputFormat.checkOutputSpecs(FileOutputFormat.java:145)
at org.apache.hadoop.mapreduce.JobSubmitter.checkSpecs(JobSubmitter.java:456)
at org.apache.hadoop.mapreduce.JobSubmitter.submitJobInternal(JobSubmitter.java:342)
at org.apache.hadoop.mapreduce.Job$10.run(Job.java:1268)
at org.apache.hadoop.mapreduce.Job$10.run(Job.java:1265)
at java.security.AccessController.doPrivileged(Native Method)
at javax.security.auth.Subject.doAs(Subject.java:415)
at org.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java:1491)
at org.apache.hadoop.mapreduce.Job.submit(Job.java:1265)
at org.apache.hadoop.mapreduce.Job.waitForCompletion(Job.java:1286)
at org.apache.hadoop.examples.WordCount.main(WordCount.java:84)
at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)
at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:57)
at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)
at java.lang.reflect.Method.invoke(Method.java:606)
at org.apache.hadoop.util.ProgramDriver$ProgramDescription.invoke(ProgramDriver.java:72)
at org.apache.hadoop.util.ProgramDriver.run(ProgramDriver.java:144)
at org.apache.hadoop.examples.ExampleDriver.main(ExampleDriver.java:74)
at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)
at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:57)
at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)
at java.lang.reflect.Method.invoke(Method.java:606)
at org.apache.hadoop.util.RunJar.main(RunJar.java:212)
Caused by: java.net.ConnectException: Connection refused
at sun.nio.ch.SocketChannelImpl.checkConnect(Native Method)
at sun.nio.ch.SocketChannelImpl.finishConnect(SocketChannelImpl.java:739)
at org.apache.hadoop.net.SocketIOWithTimeout.connect(SocketIOWithTimeout.java:206)
at org.apache.hadoop.net.NetUtils.connect(NetUtils.java:529)
at org.apache.hadoop.net.NetUtils.connect(NetUtils.java:493)
at org.apache.hadoop.ipc.Client$Connection.setupConnection(Client.java:547)
at org.apache.hadoop.ipc.Client$Connection.setupIOstreams(Client.java:642)
at org.apache.hadoop.ipc.Client$Connection.access$2600(Client.java:314)
at org.apache.hadoop.ipc.Client.getConnection(Client.java:1399)
at org.apache.hadoop.ipc.Client.call(Client.java:1318)
... 40 more


 发帖
 与我相关
 我的任务

 分享