

 脚本语言

[求助] 如何使用selenium+python获取动态显示的图片
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
最近在学习selenium和python相关的自动化测试及爬虫知识,可以通过selenium+PhantomJS获取一些JavaScript或Ajax动态生成的信息,但是有个朋友问我如何获取http://www.huazhu.com/首页中动态滚动的6张图片时,不知道如何获取?
我的想法如下:通过find_element_by_xpath函数获取路径,在分析HTML获取图片url,通过代码实现。
但是在使用selenium获取的代码输出driver.page_source中,发现并没有加载JS后的源码,如下:
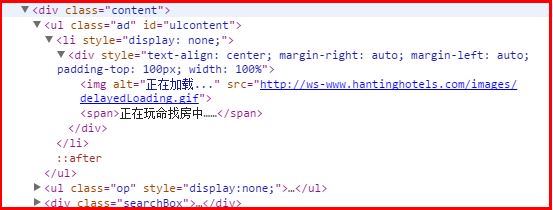
总是输出“正在玩命找房子中...”而通过Chrome审查元素想获取的图片格式代码如下所示,这几张图片是循环交替显示的,每次class="actSelected"时显示当前图片,路径为<div><ul><li><a><div style>中。
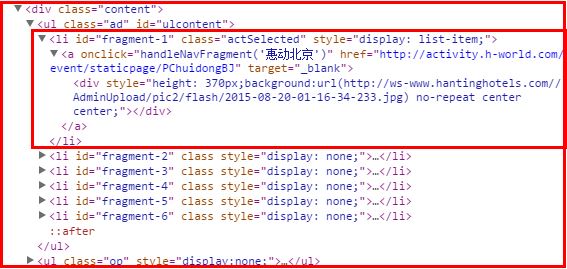
里面包含图片的URL链接如下所示:
想请教各位几个问题:
1.为什么通过selenium+PhantomJS获取的两个页面不一样,是因为没有加载JS吗?
2.如何获取这几张图片,它们是动态滚动的。
3.selenium能够获取源码吗?如果获取源码,通过下面这段代码是能够获取图片的(前提是JS显示后的源码)
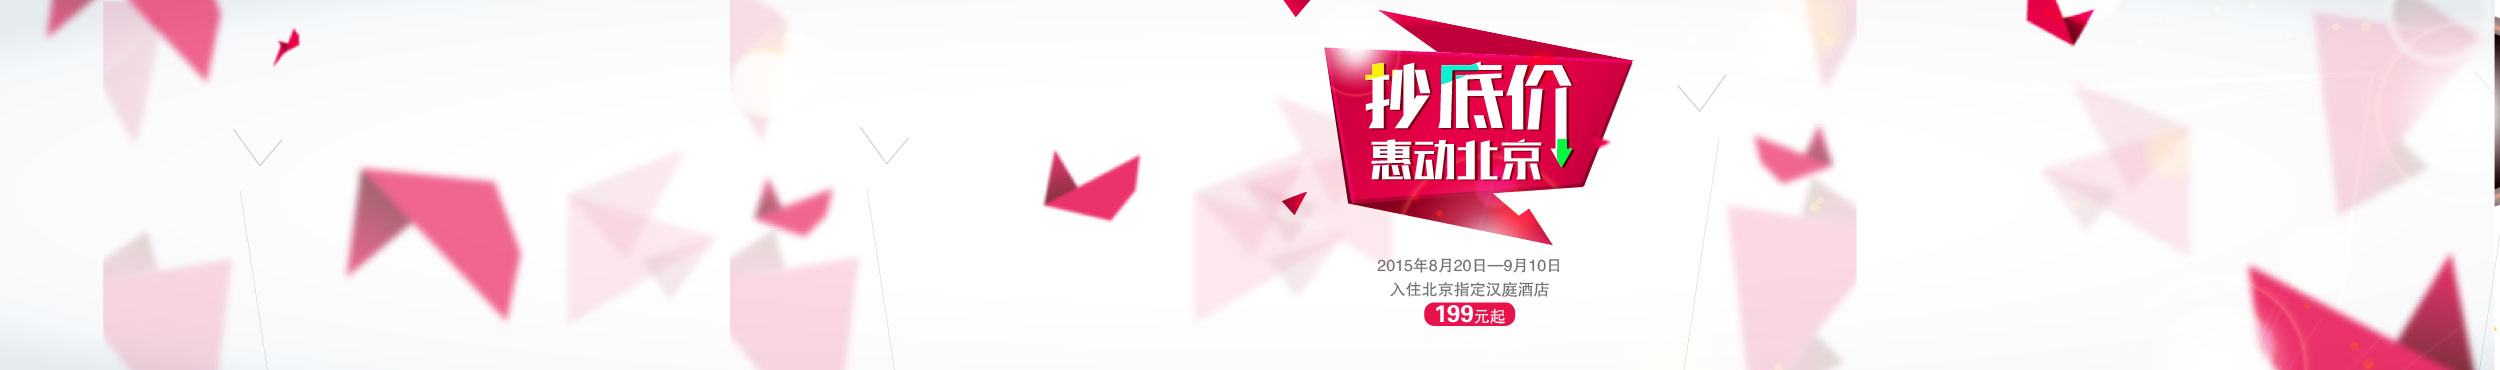
获取如下图所示:
PS:刚学习selenium,问题可能有点低级;同时主要是测试动态显示和下载图片功能,没有去恶意破坏那个网站,希望各位程序猿交流,告知我解决方法,小弟谢谢~
我的想法如下:通过find_element_by_xpath函数获取路径,在分析HTML获取图片url,通过代码实现。
driver=webdriver.PhantomJS()

driver.get('http://www.huazhu.com')

wait = ui.WebDriverWait(driver,10)

details = driver.find_element_by_xpath("//div[@class='content']/ul/li")

print details.text


filename = os.path.basename(pic_url)

urllib.urlretrieve(pic_url, 'E:\\Picture\\'+filename)
但是在使用selenium获取的代码输出driver.page_source中,发现并没有加载JS后的源码,如下:
总是输出“正在玩命找房子中...”而通过Chrome审查元素想获取的图片格式代码如下所示,这几张图片是循环交替显示的,每次class="actSelected"时显示当前图片,路径为<div><ul><li><a><div style>中。
里面包含图片的URL链接如下所示:
<div style="height: 370px;background:url(http://ws-www.hantinghotels.com//AdminUpload/pic2/flash/2015-06-18-04-00-07-380.jpg)no-repeat center center;"></div>
想请教各位几个问题:
1.为什么通过selenium+PhantomJS获取的两个页面不一样,是因为没有加载JS吗?
2.如何获取这几张图片,它们是动态滚动的。
3.selenium能够获取源码吗?如果获取源码,通过下面这段代码是能够获取图片的(前提是JS显示后的源码)
# coding=utf-8

import urllib

import time

import re

import os

strs = "<div style='height: 370px;background:url(http://ws-www.hantinghotels.com//AdminUpload/pic2/flash/2015-08-20-01-16-34-233.jpg) no-repeat center center;'></div>"

start = strs.find(r'http')

end = strs.find(r')')

url = strs[start:end]

print url

filename = os.path.basename(url)

urllib.urlretrieve(url, 'E:\\'+filename)
获取如下图所示:
PS:刚学习selenium,问题可能有点低级;同时主要是测试动态显示和下载图片功能,没有去恶意破坏那个网站,希望各位程序猿交流,告知我解决方法,小弟谢谢~
...全文
相关推荐
Python+selenium实现截图图片并保存截取的图片
介绍如何利用Selenium的方法进行截图并保存截取的图片,需要的朋友参考下本
Python +Selenium解决图片验证码登录或注册问题(推荐)
主要介绍了Python Selenium解决图片验证码登录或注册问题,本文通过实例代码给大家介绍的非常详细,具有一定的参考借鉴价值,需要的朋友可以参考下
python + selenium +pyquery 爬虫 爬取 1688详情图片 阿里巴巴详情图片 与标题 下载图片并进行压缩 仅供学习交流使用 .zip
python + selenium +pyquery 爬虫 爬取 1688详情图片 阿里巴巴详情图片 与标题 下载图片并进行压缩 仅供学习交流使用
python+selenium+Chrome options参数的使用
主要介绍了python+selenium+Chrome options参数的使用,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友们下面随着小编来一起学习学习吧
Selenium+PhantomJS+python获取html动态生成的数据
python获取html动态生成的数 python获取html动态生成的数





