

 .NET社区

C# PDF转Word
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
目前在做银行征信报告的数据抓取功能,由于银行征信报告版本较多,分为DOC、DOCX、PDF、HTML等格式文件,且同格式的情况下,里面内容还分版本,不同版本排版不同内容也有出入,目前已做DOC、DOCX格式其中一版本数据抓取,即将要做PDF格式的抓取,由于我对DOC、DOCX格式的抓取方式为通过office组件转换为HTML格式,在用正则匹配相关信息。故为了开发进度以及简洁角度考虑,打算将PDF格式转为DOC、DOCX后,在调用office组件使用同方法(转换为HTML)执行抓取,但目前似乎没发现有可以这样转换的写法,希望大家给一些建议,了解部分操作PDF组件的插件,如iTextSharp,PDFBox,Adobe Reader,Aspose,但仅仅使用过iTextSharp,而且用的还不熟练。
格式如下,希望大家给个建议参考~如何可以正确抓取PDF文件信息中的内容,由于每一个信息的字段都是单独存储的,要求准确性较高,在线等,由于银行征信报告属于个人隐私,所以对敏感数据做处理,请谅解~
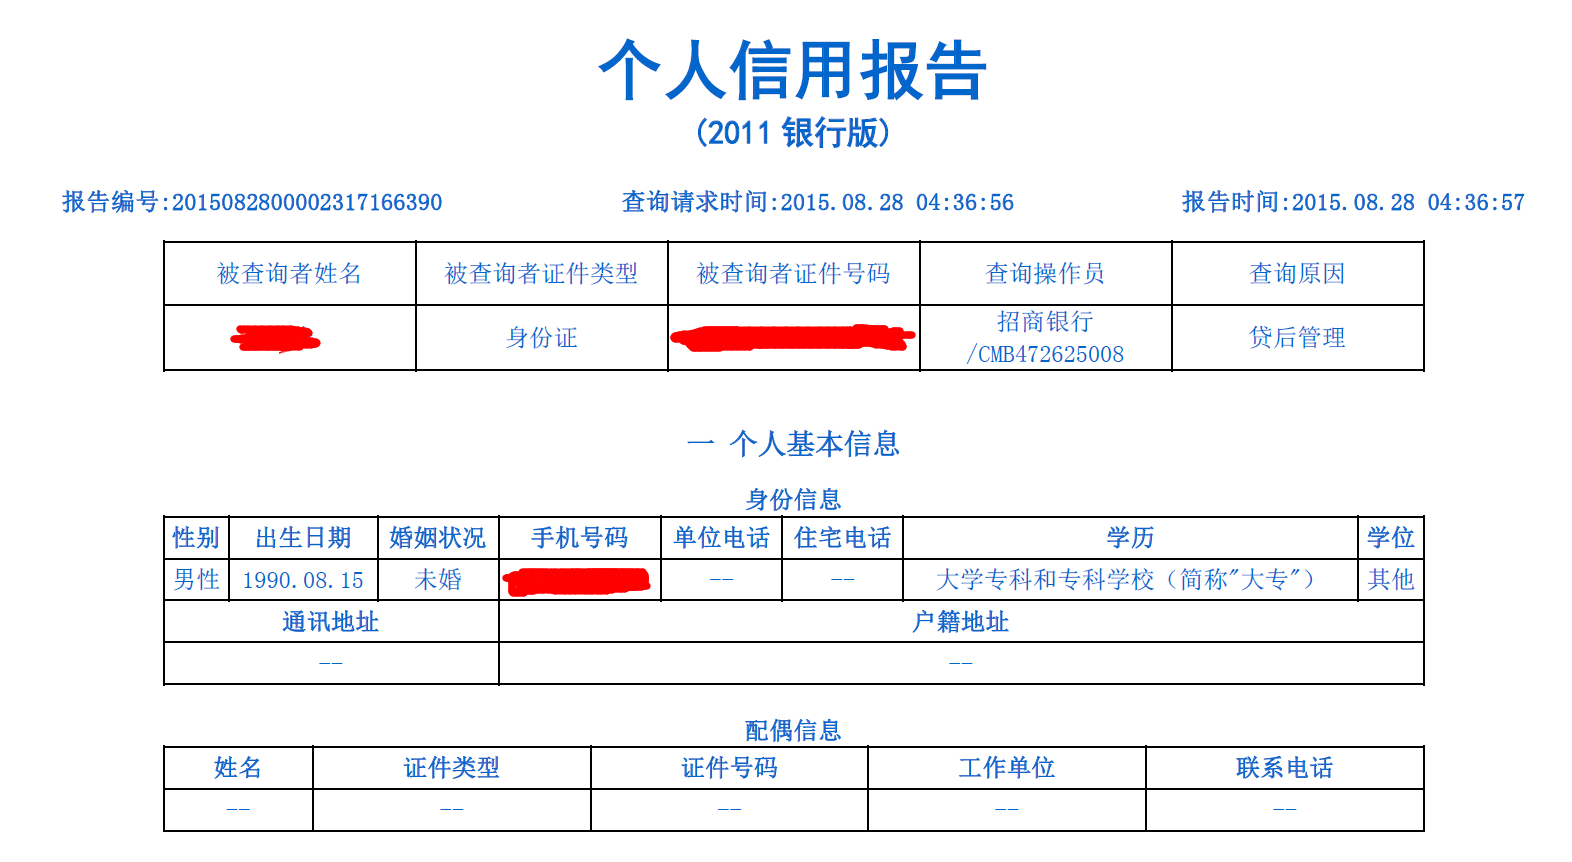
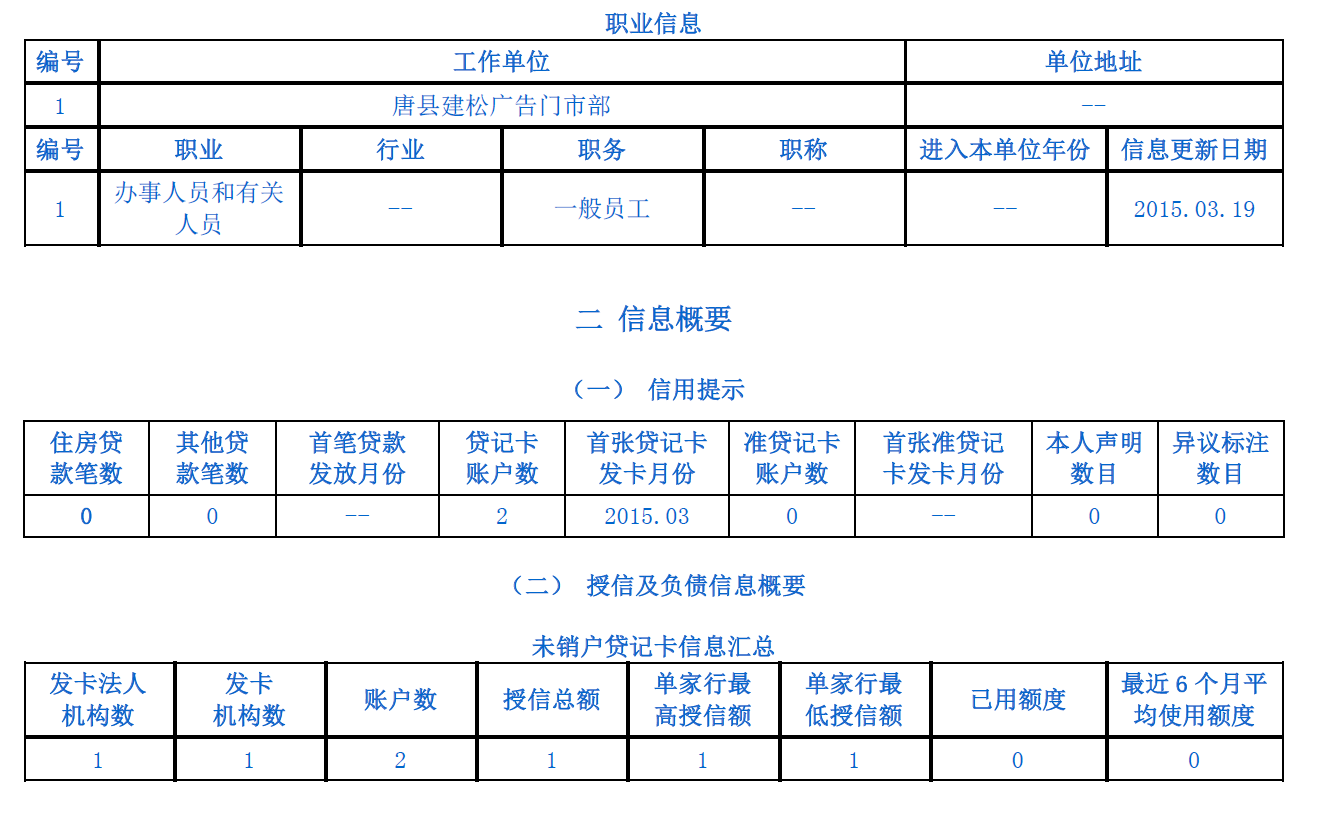
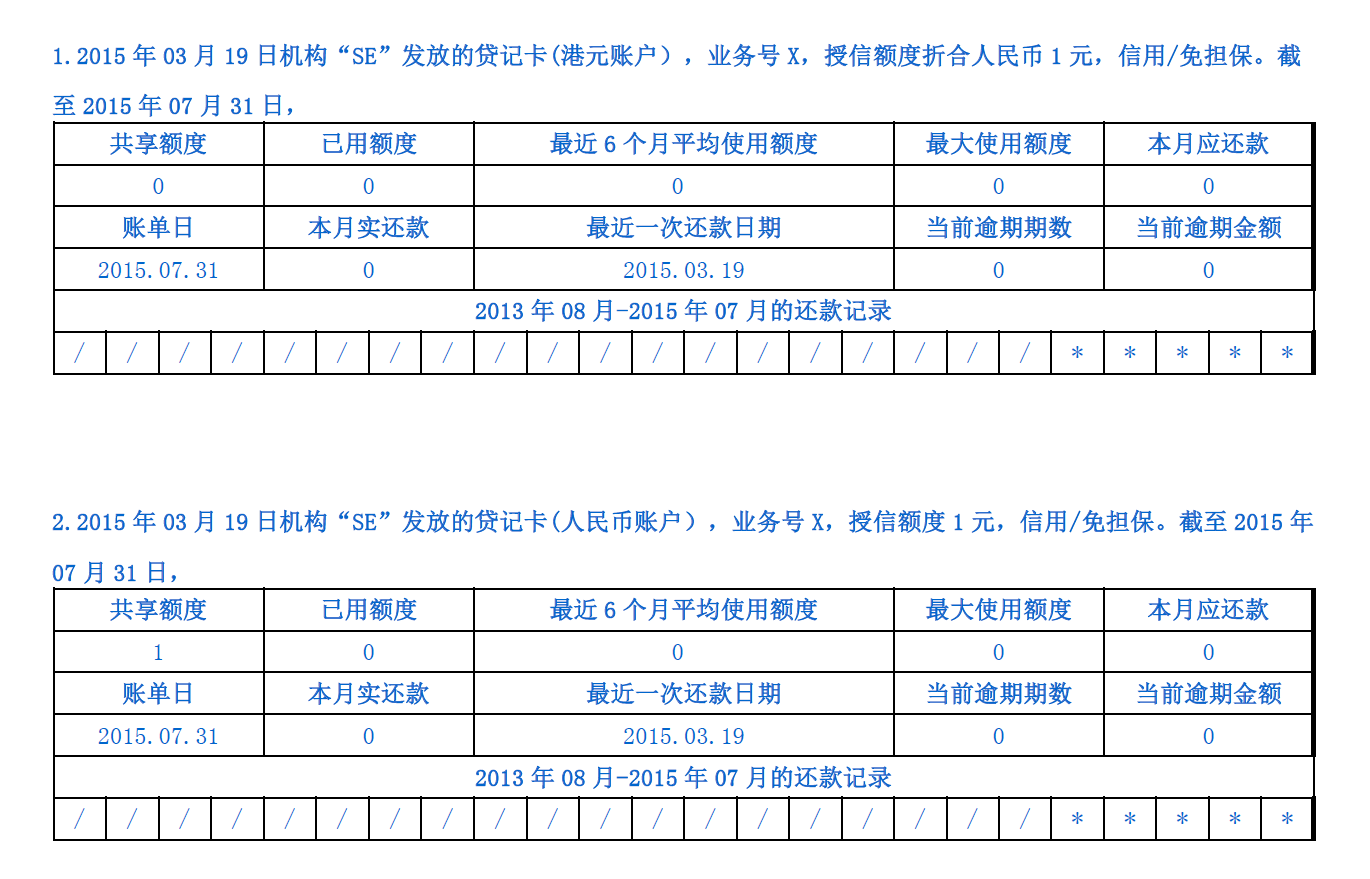
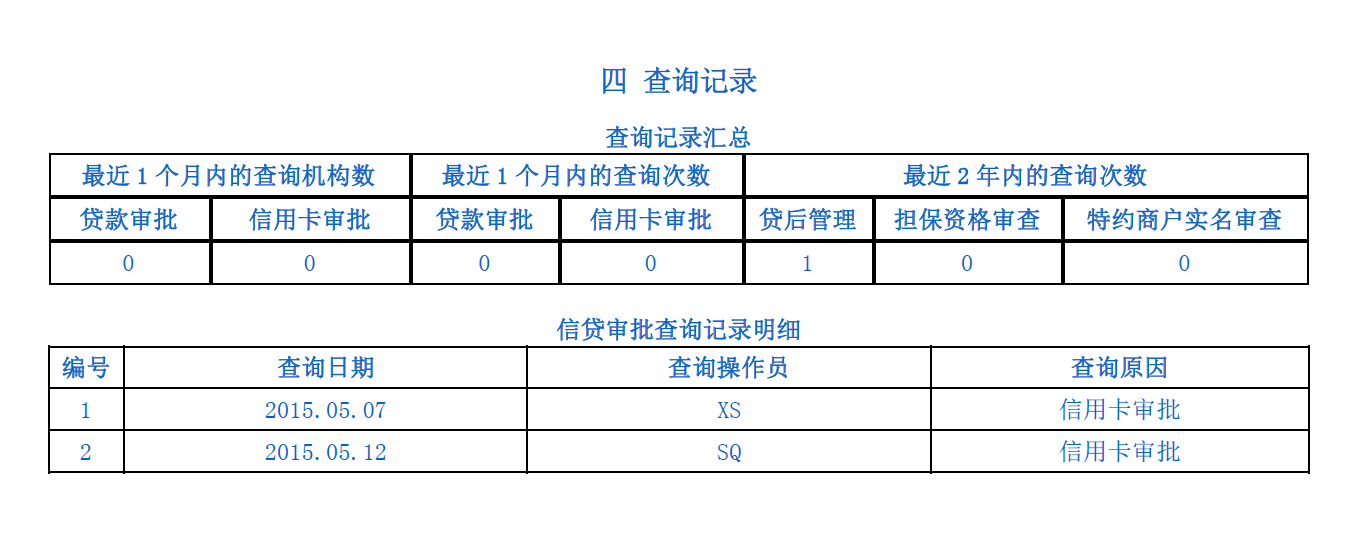
格式如下,希望大家给个建议参考~如何可以正确抓取PDF文件信息中的内容,由于每一个信息的字段都是单独存储的,要求准确性较高,在线等,由于银行征信报告属于个人隐私,所以对敏感数据做处理,请谅解~
...全文
相关推荐
C#中PDF文件转WORD文件完整源码
C#中PDF文件转WORD文件完整源码
C#实现Word转PDF转换工具开发指南
Aspose.Words for .NET 是一个功能强大的文档处理库,它可以用来创建、修改、转换和渲染Microsoft Word文档。Aspose.Words库提供了广泛的API,支持各种文档格式,包括但不限于DOC, DOCX, RTF, TXT, HTML, MHTML, EPUB, OpenDocument, PDF, XPS, SWF和图像格式。它的主要功能特点包括:跨平台支持:能够在任何支持.NET的平台上使用,如Windows、Linux和Mac。格式转换。
c#写的pdf转word程序源码
c#写的pdf转word程序源码项目,基于的环境是.net 4.0;
C#中PDF文件转WORD文件
C#中PDF文件转WORD文件
word转pdf c#实现
word转pdf的c#实现 同时发来俺这小白都理解了,发出来共享。




