

 Java

网络爬虫得到的数据 这是什么格式 如何整理处理比较好
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
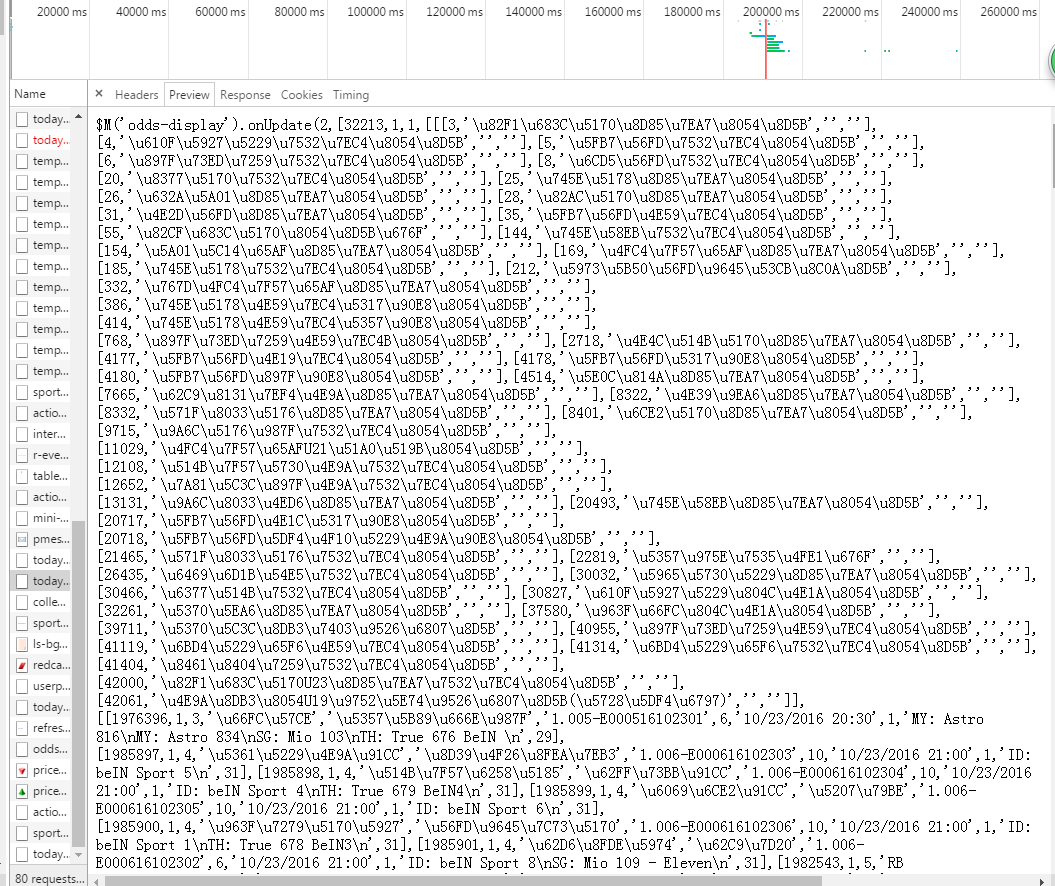
网络爬虫 爬某个网站的数据
已经存到本地
请问这是什么格式的数据?好像不是JSON啊
存到本地后应该怎么处理整理比较好 求思路
...全文
相关推荐
Python网络爬虫实习报告.doc
二、爬虫原理网络爬虫,又称为网页蜘蛛或网络机器人,是一种自动浏览互联网并按照一定规则抓取信息的程序。爬虫通常包含以下几个步骤:1.
Matlab网络爬虫实现与案例分析
网络爬虫(Web Crawler),又称网络蜘蛛(Web Spider)或网络机器人(Web Robot),是一种自动化地访问互联网并收集网页数据的程序。它按照一定的规则,自动地从互联网上抓取信息,以实现对网络数据的整理和挖掘。超文本传输协议(HTTP)是互联网上应用最为广泛的一种网络协议,它是应用层协议之一,用于分布式、协作式和超媒体信息系统的应用。HTTP协议基于TCP/IP通信协议,遵循请求/响应模型,客户端通过发送请求来获取服务器上的资源,服务器响应请求后,返回客户端相应的数据。
Python网络爬虫实习报告计划.pdf
Python网络爬虫实习报告计划详述了通过Python进行网络数据抓取的相关技术和实践。网络爬虫,也称为网页蜘蛛或网络机器人,是一种自动遍历互联网并抓取网页内容的程序。
Python网络爬虫实习报告python实习报告.docx
数据整理、转换为了便于后续处理和分析,需要对提取的数据进行格式化处理。例如,统一日期格式、去除字符串中的空白字符等。#### 4.
Python网络爬虫实习报告计划.docx
爬取数据- 定义函数`getHtml()`来获取指定URL的HTML源码。- 通过循环处理不同页面的数据。#### 3. 数据整理、变换- 对获取的数据进行清洗和格式化,例如去除多余的空格、换行符等。




