

 脚本语言

知乎模拟登陆提交表单数据的问题
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
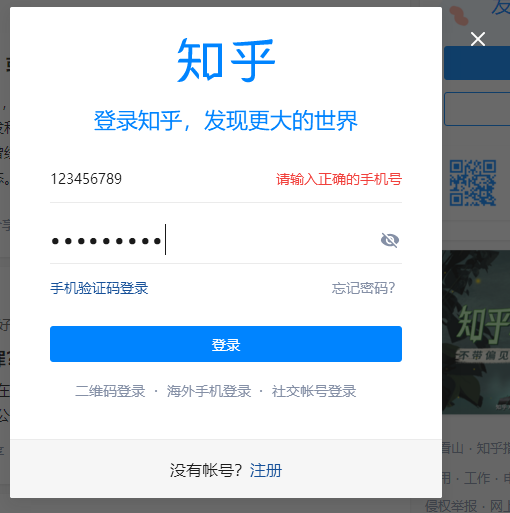
发送登录数据后从发现发送的数据是这个样子的,Form-Data里一串看不懂的字母
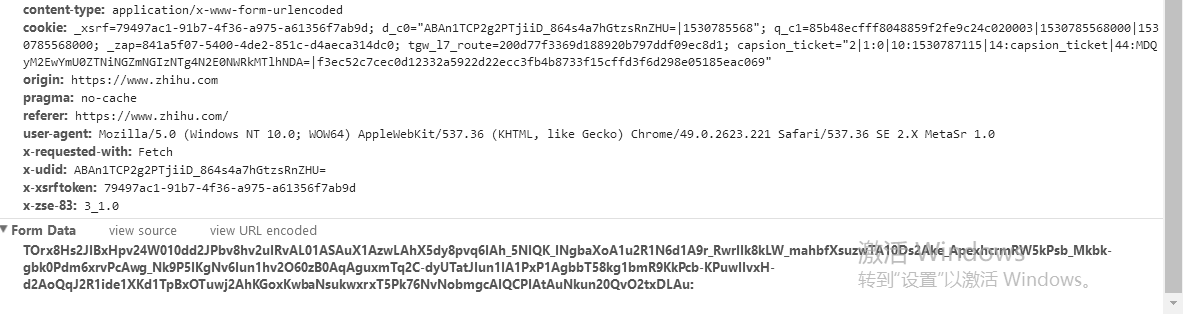
请问这里知乎用了什么方式进行编码?我想进行解码好知道究竟发送了什么数据
相关推荐
表单自动填写,网页自动提交工具
模拟人工提交网页表单操作,同时监控提交结果变化并报警提示或自动处理报警动作。可广泛用于注册表单、登陆表单、信息添加修改表单提交。 1、支持多任务多操作连续提交,实现无人值守。 2、支持通过多代理服务器访问并提交 3、支持自动获取填写表单项 4、自动填写内容可以是固定值、从字典文件中读取的内容或验证图片的识别结果。 5、支持按钮提交、表单提交以及自定义脚本提交。 6、批量导入相似页面,实现顺序提交或随机提交 7、实现网页整体监控、HTML元素监控、源代码监控。 8、多种报警处理方式:声音报警、弹窗报警、触发新任务或第三方程序 9、支持定时任务,程序可后台隐藏执行
Python 爬虫模拟登陆知乎
在之前写过一篇使用python爬虫爬取电影天堂资源的文章,重点是如何解析页面和提高爬虫的效率。由于电影天堂上的资源获取权限是所有人都一样的,所以不需要进行登录验证操作,写完那篇文章后又花了些时间研究了一下python模拟登陆,网上关于这部分的资料很多,很多demo都是登陆知乎的,原因是知乎的登陆比较简单,只需要post几个参数,保存cookie。而且还没有进行加密,很适合用来做教学。我也是是新手,一点点的摸索终于成功登陆上了知乎。就通过这篇文章分享一下学习这部分的心得,希望对那些和我一样的初学者有所帮助。 先来说一下,爬虫模拟登陆的基本原理吧,我也是刚开始接触对于一些深层次的东西也不是掌
Python使用Srapy框架爬虫模拟登陆并抓取知乎内容
里我们来看如何通过Python使用Srapy框架爬虫模拟登陆并抓取知乎内容的实例,要实现持续的爬取需要利用到cookie的保存,我们首先还是来回顾一下cookie的相关知识点:
CSDN爬虫(三)——网络爬虫模拟登陆两种策略
文章同步:http://blog.csdn.net/wgyscsf
登陆界面表单提交js特效.zip
登陆界面表单提交js特效是一款HTML5登录表单验证,表单默认只对输入的长度作验证,你也可以自己修改正则表达式来完成更复杂的表单验证。




