

 Hadoop生态社区

求助,flume不能从kafka中读取数据并且写入hdfs中
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
我的配置如下:
a1.channels = c1
a1.sinks = k1
#定义kafka-channel
a1.channels.c1.type = org.apache.flume.channel.kafka.KafkaChannel
a1.channels.c1.parseAsFlumeEvent = false
a1.channels.c1.kafka.bootstrap.servers = slave1:9092,slave3:9092,slave4:9092
a1.channels.c1.kafka.topic = incharge
a1.channels.c1.kafka.consumer.group.id = g101
#具体定义sink
a1.sinks.k1.type = hdfs
a1.sinks.k1.hdfs.path = hdfs://master:9000/gamelog/%Y%m%d
a1.sinks.k1.hdfs.useLocalTimeStamp = true
a1.sinks.k1.hdfs.filePrefix = log-
a1.sinks.k1.hdfs.fileType = DataStream
#不按照条数生成文件
a1.sinks.k1.hdfs.rollCount = 0
#HDFS上的文件达到128M时生成一个文件
a1.sinks.k1.hdfs.rollSize = 134217728
#HDFS上的文件达到60秒生成一个文件
a1.sinks.k1.hdfs.rollInterval = 60
a1.sinks.k1.channel = c1
然后我启动后,如图所示:
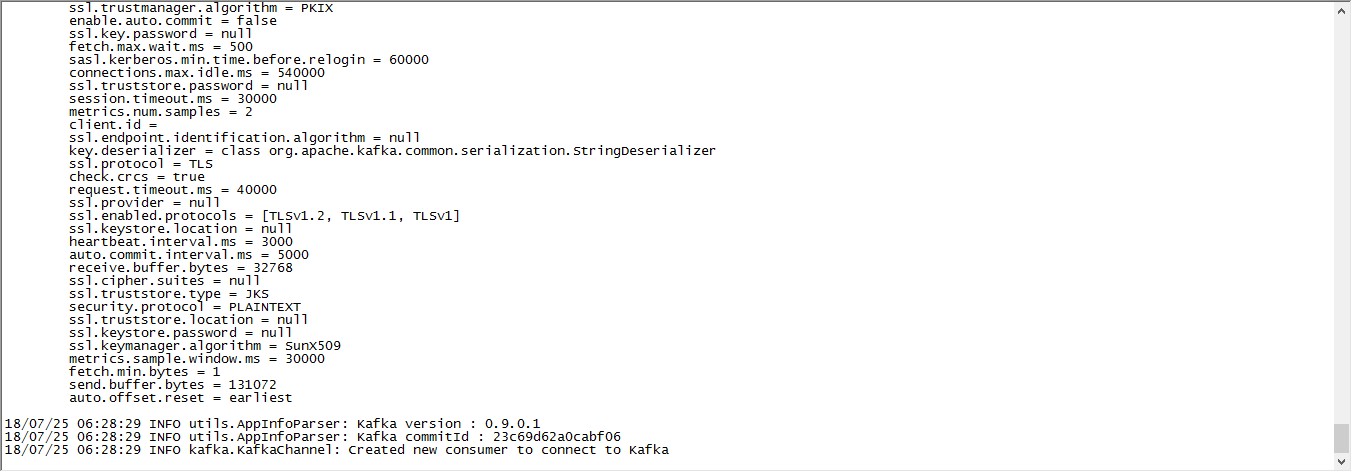
这是怎么回事儿?求大哥大姐帮帮我呀,谢谢!
a1.channels = c1
a1.sinks = k1
#定义kafka-channel
a1.channels.c1.type = org.apache.flume.channel.kafka.KafkaChannel
a1.channels.c1.parseAsFlumeEvent = false
a1.channels.c1.kafka.bootstrap.servers = slave1:9092,slave3:9092,slave4:9092
a1.channels.c1.kafka.topic = incharge
a1.channels.c1.kafka.consumer.group.id = g101
#具体定义sink
a1.sinks.k1.type = hdfs
a1.sinks.k1.hdfs.path = hdfs://master:9000/gamelog/%Y%m%d
a1.sinks.k1.hdfs.useLocalTimeStamp = true
a1.sinks.k1.hdfs.filePrefix = log-
a1.sinks.k1.hdfs.fileType = DataStream
#不按照条数生成文件
a1.sinks.k1.hdfs.rollCount = 0
#HDFS上的文件达到128M时生成一个文件
a1.sinks.k1.hdfs.rollSize = 134217728
#HDFS上的文件达到60秒生成一个文件
a1.sinks.k1.hdfs.rollInterval = 60
a1.sinks.k1.channel = c1
然后我启动后,如图所示:
这是怎么回事儿?求大哥大姐帮帮我呀,谢谢!
...全文
相关推荐
Flume采集数据到Kafka,然后从kafka取数据存储到HDFS的方法思路和完整步骤
自己研究大数据多年,写的一个日志数据采集方案笔记,可快速熟悉Flume,Kafka,Hdfs的操作使用,以及相互的操作接口。
Kafka【集成篇】01:Flume集成Kafka
Flume集成Kafka
kafka+flume 实时采集oracle数据到hive中.docx
讲述如何采用最简单的kafka+flume的方式,实时的去读取oracle中的重做日志+归档日志的信息,从而达到日志文件数据实时写入到hdfs中,然后将hdfs中的数据结构化到hive中。
利用Flume将MySQL表数据准实时抽取到HDFS、MySQL、Kafka
利用Flume将MySQL表数据准实时抽取到HDFS、MySQL、Kafka用到的jar包
Kafka接收Flume数据并存储至HDFS.docx
自己研究大数据多年,写的一个日志数据采集方案笔记,可快速熟悉Flume,Kafka,Hdfs的操作使用,以及相互的操作接口。详细的记录下来Kafka接收Flume数据并存储至HDFS过程




