

 Java SE

请问java怎么实现爬取网页信息?
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
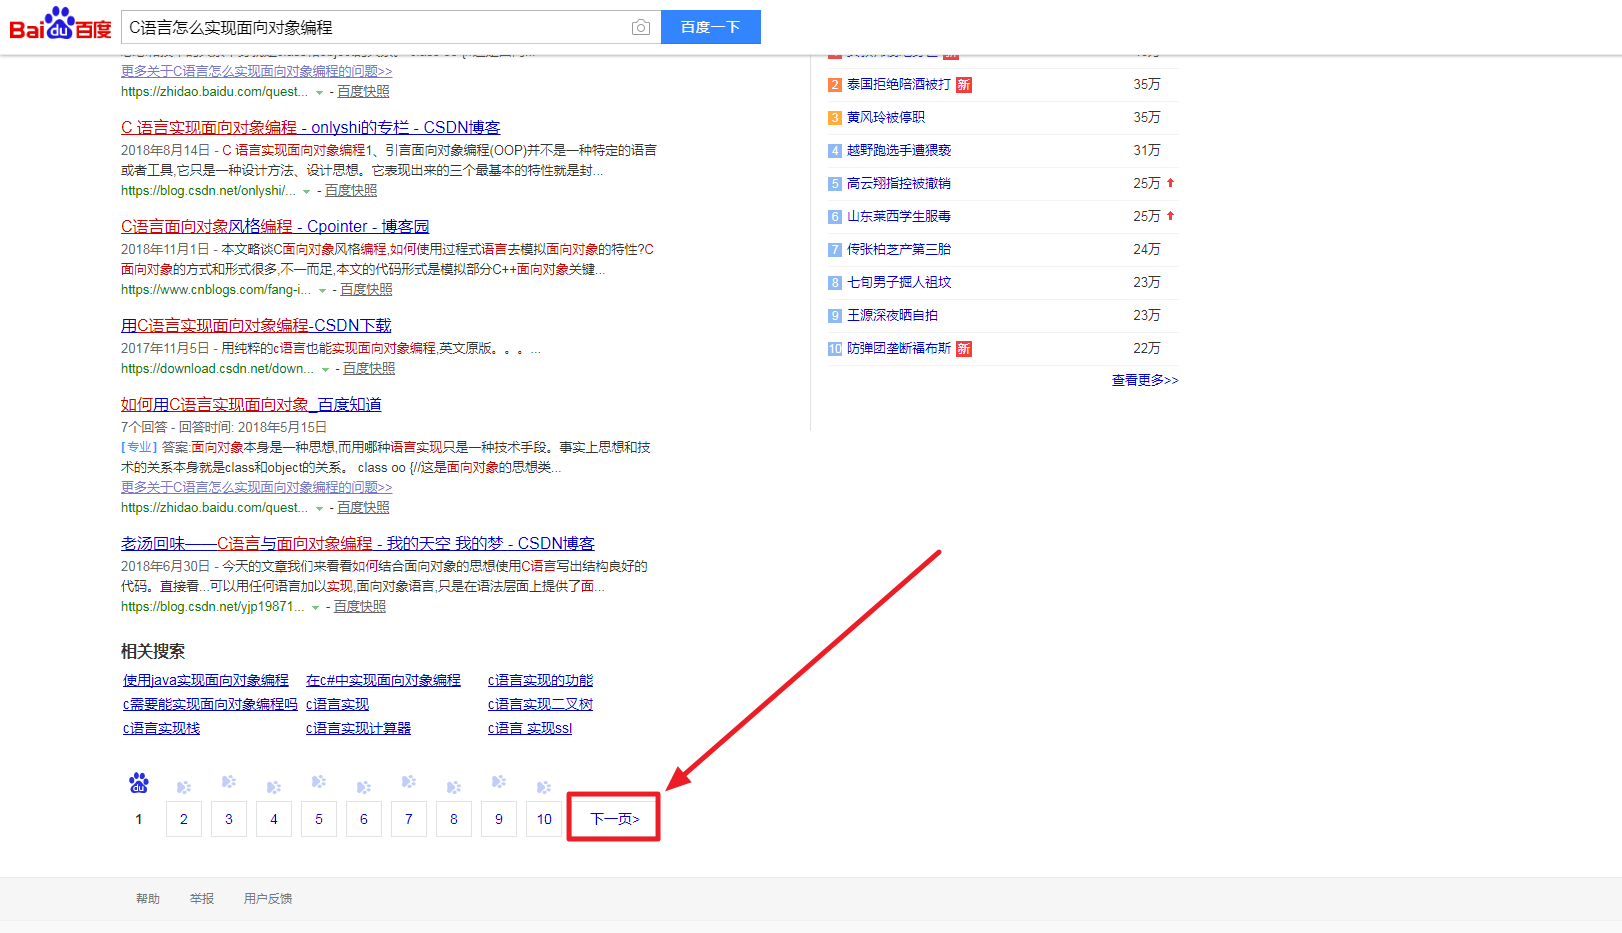
比如说,我搜索“C语言怎么实现面向对象编程”,会出来很多信息,假设我想看前10页的信息
请问除了用浏览器点击下一页,一直到第10页,用java怎么写程序把这10页的信息都爬取下来保存到文件里呢?
请问java能不能实现,如果可以,需要学习哪些知识呢,请大神指教。
相关推荐
基于 webmagic 的 Java 爬虫应用:爬取企信网企业基本信息.zip
基于 webmagic 的 Java 爬虫应用:爬取企信网企业基本信息
基于Java WebMagic实现的豆瓣分类图书爬虫.zip
基于Java WebMagic实现的豆瓣分类图书爬虫
Java采集最新动态代理IP
Jsoup实现代理IP的爬取,突破IP的访问限制,实现动态IP代理
爬虫开发常见面试题.docx
- 1. 什么是网络爬虫(Web Crawler)?它们在互联网中的作用是什么? - 2. 请简要介绍一下爬虫开发的工作原理及流程。 - 3. 爬虫开发中常用的编程语言有哪些?你更倾向于使用哪种语言进行爬虫开发? - 4. 请说明一下你在爬虫开发中使用过的爬虫框架(如 Scrapy、Beautiful Soup 等),以及其优势和劣势。 - 5. 在爬虫开发中,如何设置爬取的频率和爬取的深度?请谈谈如何避免被网站封禁或拉入反爬虫机制。 - 6. 请解释一下如何处理爬取到的数据,例如数据清洗(Data Cleaning)和数据存储(Data Storage)。 - 7. 爬虫开发中常见的反爬虫策略有哪些?请说明在爬虫开发中如何绕过反爬虫机制。 - 8. 在爬虫开发中,如何提高爬虫爬取效率和性能?请分享一些优化技巧。 - 9. 爬虫开发中的并发和异步编程是如何实现的?请说明在爬虫中如何利用并发和异步提升效率。 - 10. 如何处理在爬取过程中可能遇到的异常和错误?请说明在爬虫开发中如何进行异常处理。 - 11. 爬虫开发中如何避免重复爬取数据和处理重复数据?请说明在爬虫开发中的去重策略。
JAVA 爬行BOT
一個簡單好用的蒐尋器,可以輕鬆抓取網頁資料回傳伺服器!java網絡爬蟲,可用於網站採集,搜索,-java network reptiles, can be used for site acquisition, search,




