

 脚本语言

tushare 下载股票行情数据,复权处理100万行需要10分钟,请教如何优化。
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
本人菜鸟一只,上代码,大佬给看看。

我每天下载最新未复权行情,自己做复权处理,复权公式:复权价=收盘价*当日复权因子/最新复权因子。
下图是我本地存储的数据。adj_factor是因子列。
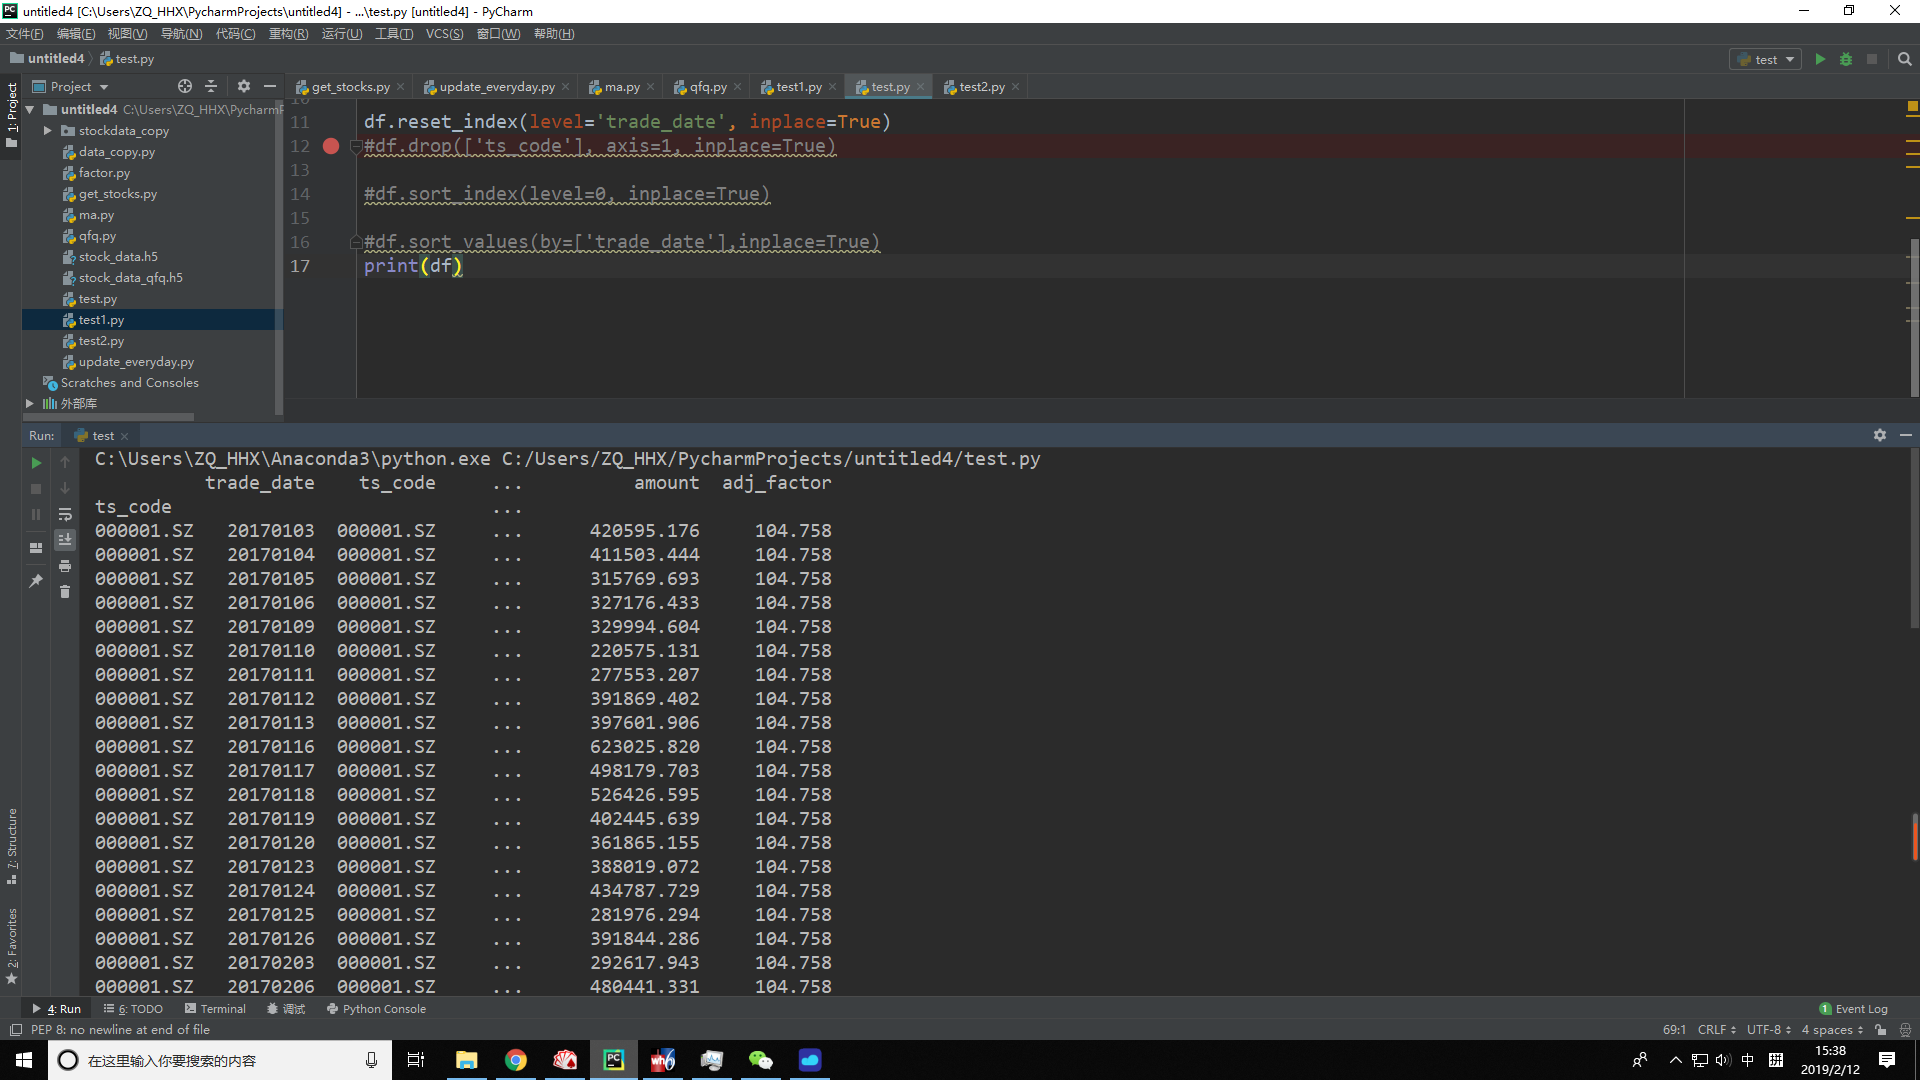
我复权处理,就是用for循环,用df1 = df.ix[code] 来保存一只股票全部代码,用i存储最新日期的因子,再用 df1['factor'] = df1['adj_factor']/i,就可以得到股票复权的系数。后面直接系列相乘,这个简单。关键是这个for循环里,1百多万行耗时8分。
网上看了很多优化的文章,才知道自己这个最愚蠢。可是按文章里说的iterrow,apply,矢量化等等,我这个很难套进去。除了我的办法之外,怎么更快速得到复权的这个系数???????????
我每天下载最新未复权行情,自己做复权处理,复权公式:复权价=收盘价*当日复权因子/最新复权因子。
下图是我本地存储的数据。adj_factor是因子列。
我复权处理,就是用for循环,用df1 = df.ix[code] 来保存一只股票全部代码,用i存储最新日期的因子,再用 df1['factor'] = df1['adj_factor']/i,就可以得到股票复权的系数。后面直接系列相乘,这个简单。关键是这个for循环里,1百多万行耗时8分。
网上看了很多优化的文章,才知道自己这个最愚蠢。可是按文章里说的iterrow,apply,矢量化等等,我这个很难套进去。除了我的办法之外,怎么更快速得到复权的这个系数???????????
...全文
相关推荐
Python全栈开发-第9章 量化金融回测系统
第9章 量化金融回测系统,用代码验证你的交易策略
Python股票数据可视化分析系统:从数据获取到图表展示
数据分析与可视化是大数据时代挖掘价值的关键手段,通过对原始数据的采集、清洗、建模与图表化呈现,能够帮助决策者快速洞察规律。在金融投资领域,这一技术被广泛应用于行情监控与量化研究。基于Python生态,开发者可以高效地构建数据流水线:利用akshare等开源接口获取股票历史与实时数据,借助pandas完成数据清洗和技术指标计算,再通过pyecharts等可视化库生成交互式K线图与走势图。结合东方财富等公开数据源,个人投资者和量化研究者能够以低成本搭建属于自己的可视化分析系统,实现从数据获取到图表展示的完整闭环
国央企创新负责人如何进行企业创新综合能力分析?.docx
国央企创新负责人如何进行企业创新综合能力分析?
国央企在开展创新技术攻关时,如何实现技术需求与科研成果的精准匹配?.docx
国央企在开展创新技术攻关时,如何实现技术需求与科研成果的精准匹配?
国央企创新负责人如何打通科技成果与企业研发的需求对接?.docx
国央企创新负责人如何打通科技成果与企业研发的需求对接?




