

 网络

超详细案例解读,利用FPGA加速深度神经网络运算
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
全联接神经网络是一种计算量比较大的机器学习模型,在训练和推断过程中需要对所有神经元进行矩阵计算。为了加快计算速度,各公司的大佬们采取了不同手段进行数据的抽象和综合。
通常来说,我们采用卷积操作,将数据进行抽象和综合,然后送入到全连接神经网络进行最后的计算,实质上就是矩阵运算等数学计算的一系列综合操作。
熟悉矩阵运算的朋友都知道,矩阵当中的每个元素和其他元素是没有关联的,这种特性天然就适合使用并行计算的方式来加快其计算速度。
重点来了!并行计算正是 FPGA 等芯片的强项,利用FPGA将有效实现深度学习神经网络的加速计算(推理),下面是具体的操作展示。
1. 深度学习神经网络的环境搭建
2. 安装 OpenCL的开发环境,使Intel Arria 10 FPGA作为OpenCL的设备,注意安Intel对应的SDK
3. 利用 Tensorflow 作为框架,实现一个简单的全连接神经网络
(提供一个算法描述示例,使用 Mnist 数据集作为训练和测试)
1)Mnist 数据集每张图片为 28×28 像素,将每张图片的像素点作为输入
2)第一个隐藏层设置 500 个神经元,与输入图像的 784 个像素点做计算(矩阵乘法)
3)将得到的结果使用 relu 函数进行结果,只保留数值 >0 的结果,其他的设置为 0
4)第二个隐藏层设置 10 个神经元,与第一个隐藏层的输出进行计算(矩阵乘法),最终得到 10 个结果作为输出
从上述的算法描述当中,我们可以看到实际上就是几次矩阵的计算过程:一个 [1,784] 和 [784, 500] 的矩阵乘法,得到一个 [1,500] 的中间矩阵;然后这个 [1,500] 的中间矩阵与 [500, 10] 的矩阵进行计算,最终得到一个 [1,10] 的矩阵,这个就是我们的最终结果。
4. 对搭建完成的神经网络进行训练,训练之后得到模型文件
5. 通过一定的操作方式,提取这些模型文件中的模型参数
6. 把模型参数当作输入的参数,送入到FPGA当中进行加速计算,实现推理过程
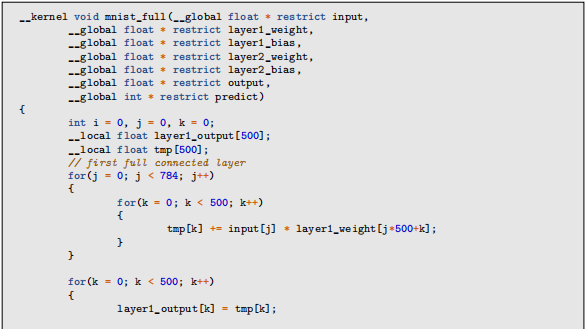
上述神经网络算法的OpenCL实现,大致如下:
7. 最后使用C/C++编写CPU程序,与 FPGA 进行交互,来验证 OpenCL 算法实现的正确性。
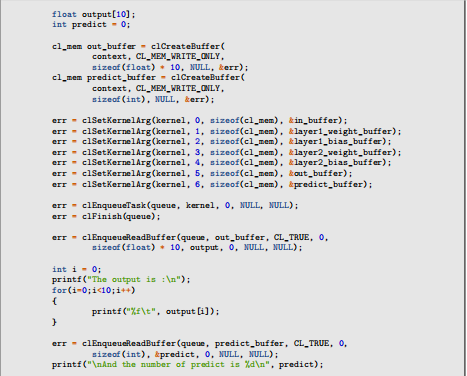
以下是 CPU 程序的部分代码。
通过以上步骤,我们就成功的使用OpenCL在Intel FPGA上实现了一个简单的神经网络的推理加速。
通常来说,我们采用卷积操作,将数据进行抽象和综合,然后送入到全连接神经网络进行最后的计算,实质上就是矩阵运算等数学计算的一系列综合操作。
熟悉矩阵运算的朋友都知道,矩阵当中的每个元素和其他元素是没有关联的,这种特性天然就适合使用并行计算的方式来加快其计算速度。
重点来了!并行计算正是 FPGA 等芯片的强项,利用FPGA将有效实现深度学习神经网络的加速计算(推理),下面是具体的操作展示。
1. 深度学习神经网络的环境搭建
2. 安装 OpenCL的开发环境,使Intel Arria 10 FPGA作为OpenCL的设备,注意安Intel对应的SDK
3. 利用 Tensorflow 作为框架,实现一个简单的全连接神经网络
(提供一个算法描述示例,使用 Mnist 数据集作为训练和测试)
1)Mnist 数据集每张图片为 28×28 像素,将每张图片的像素点作为输入
2)第一个隐藏层设置 500 个神经元,与输入图像的 784 个像素点做计算(矩阵乘法)
3)将得到的结果使用 relu 函数进行结果,只保留数值 >0 的结果,其他的设置为 0
4)第二个隐藏层设置 10 个神经元,与第一个隐藏层的输出进行计算(矩阵乘法),最终得到 10 个结果作为输出
从上述的算法描述当中,我们可以看到实际上就是几次矩阵的计算过程:一个 [1,784] 和 [784, 500] 的矩阵乘法,得到一个 [1,500] 的中间矩阵;然后这个 [1,500] 的中间矩阵与 [500, 10] 的矩阵进行计算,最终得到一个 [1,10] 的矩阵,这个就是我们的最终结果。
4. 对搭建完成的神经网络进行训练,训练之后得到模型文件
5. 通过一定的操作方式,提取这些模型文件中的模型参数
6. 把模型参数当作输入的参数,送入到FPGA当中进行加速计算,实现推理过程
上述神经网络算法的OpenCL实现,大致如下:
7. 最后使用C/C++编写CPU程序,与 FPGA 进行交互,来验证 OpenCL 算法实现的正确性。
以下是 CPU 程序的部分代码。
通过以上步骤,我们就成功的使用OpenCL在Intel FPGA上实现了一个简单的神经网络的推理加速。
...全文
相关推荐
深度神经网络(DNN)
通过以上九个部分的学习,我们可以深入理解深度神经网络的基本原理、开发工具、硬件加速技术以及未来的发展趋势。这些知识对于理解和应用DNN至关重要,并且可以帮助我们更好地优化和利用DNN解决实际问题。
MIT深度神经网络硬件架构设计教程
总结来说,这份教程详细介绍了深度神经网络在硬件层面的设计考虑和实现方法,以及如何利用FPGA和ASIC这类专用硬件平台来加速神经网络的运算。
基于FPGA的深度学习加速器设计与实现
本文主要探讨的是"基于FPGA的深度学习加速器设计与实现"这一主题。FPGA(Fie
一种基于FPGA的CNN加速器设计.pdf
因此,为不同类型的卷积核设计专用的运算单元,可以充分利用FPGA的并行处理能力,进一步优化性能。
一种支持稀疏卷积的深度神经网络加速器的设计.pdf
卷积计算是DNN的主要运算负担,它涉及输入特征(IFM)和权重的三维卷积计算,生成输出特征向量(OFM)。




