

 脚本语言

请教大家一个关于爬虫爬取网站的问题。
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
我用python写了一个爬取水木社区(http://www.newsmth.net/nForum/#!board/Python?p=1)的爬虫,来爬取这一页的每个帖子的链接,我用浏览器查看了每个帖子的链接放在<td class='title_9'> <td>和<td class='title_9 bg-odd'> <td>这样的标签里。我使用td=tbody.find_all('td',class_='title_9')可以返回所有class='title_9'和class='title_9 bg-odd'的所有帖子,为什么class='title_9 bg-odd'的帖子也能找到? 我使用td=tbody.find_all('td',class_='title_9 bg-odd')时,却返回空,一个帖子也找不到。然后我print(tbody)把tbody的内容打印出来,发现打印出来的所有帖子都在<td class='title_9'> <td>里面,所有的class='title_9 bg-odd'都变成了class='title_9'了,为什么会这样呢?为什么程序打印出来的tbody的内容和在浏览器上看到的不一样?求大神帮忙解答一下,谢谢啦。
浏览器看到的:
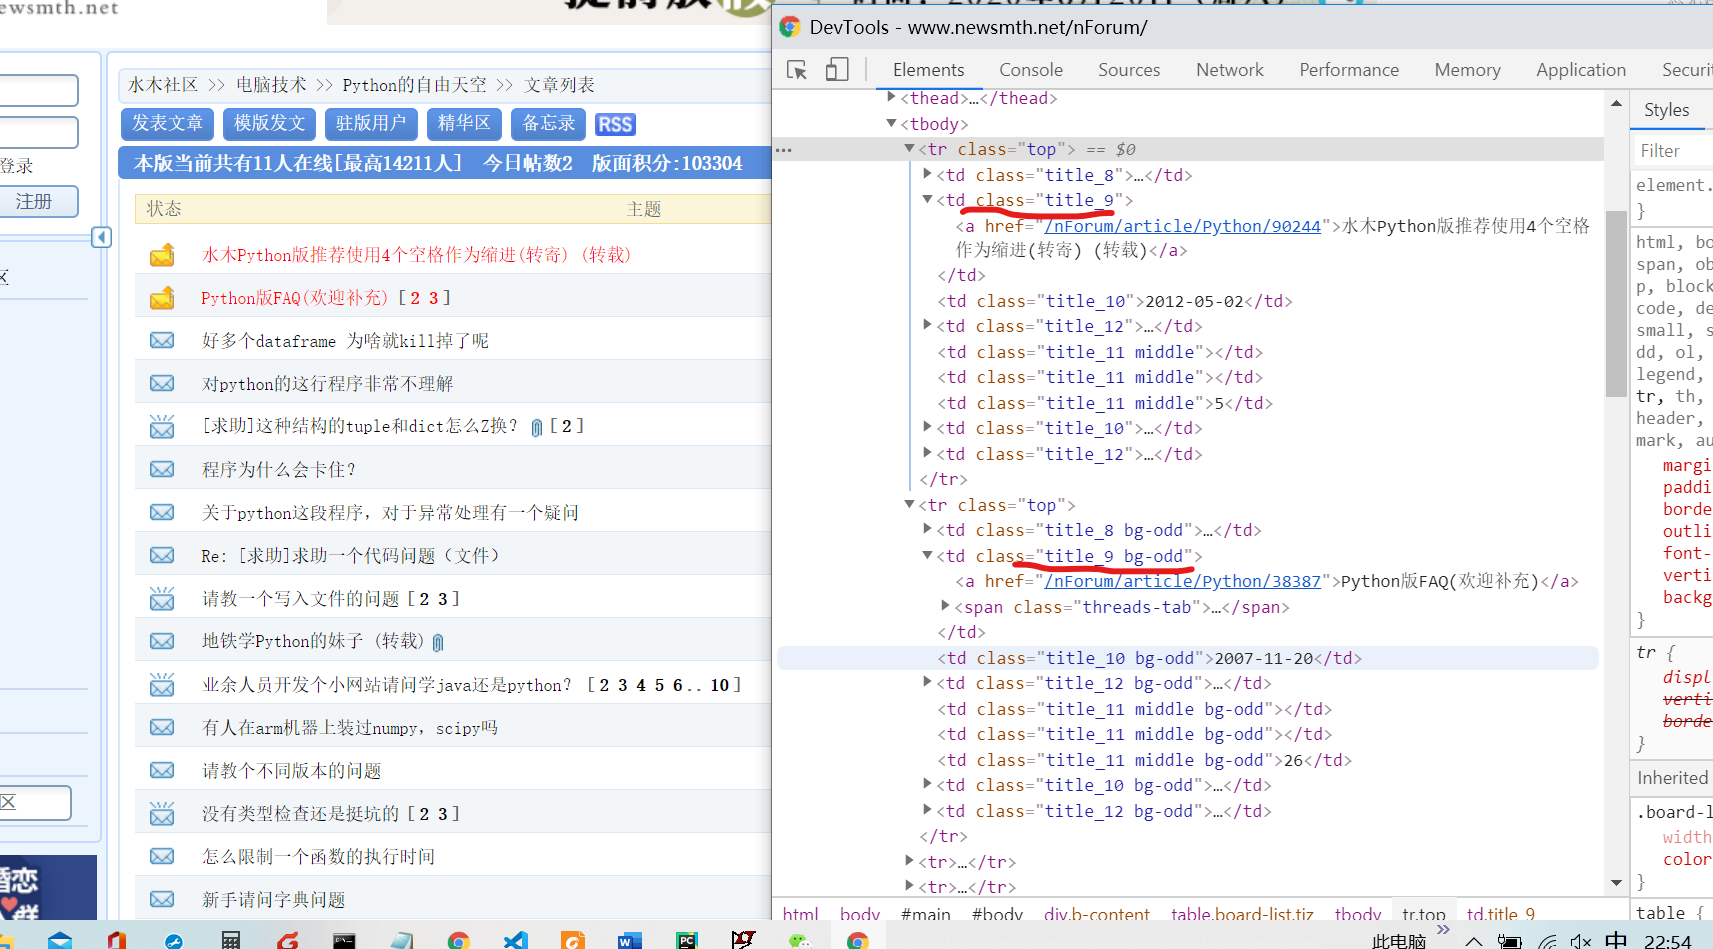
程序输出的:

浏览器看到的:
程序输出的:
...全文
相关推荐
Python探索之爬取电商售卖信息代码示例
### Python探索之爬取电商售卖信息代码示例#### 网络爬虫基本概念网络爬虫(Web crawler),也常被称作网页蜘蛛(Web spider)、网络机器人(Robot)或网页追逐者(Web
hadoop分布式网络爬虫
网络爬虫,又称为网页蜘蛛或网络机器人,是一种自动遍历互联网、搜集信息的程序。它通过遵循HTML页面中的超链接,逐个访问网页,抓取所需的数据。
关于51job网站的爬虫课程设计
它也被称为网页蜘蛛、网络机器人、网页追逐者、蚂蚁、自动索引、模拟程序或者蠕虫。网络爬虫的出现是为了解决万维网信息的提取和利用问题。
用java写的crawler(spider)网络爬虫 源代码
#### 三、网络爬虫开发注意事项- **合法性问题**:确保爬虫行为合法,尊重目标网站的robots.txt文件,避免对网站服务器造成过大压力。
基于Python的网络爬虫程序设计.docx
### 基于Python的网络爬虫程序设计#### 一、网络爬虫概述网络爬虫(Web Crawler),也称为网页蜘蛛或网络机器人,是一种自动浏览互联网并下载有用信息的程序。




