

 脚本语言

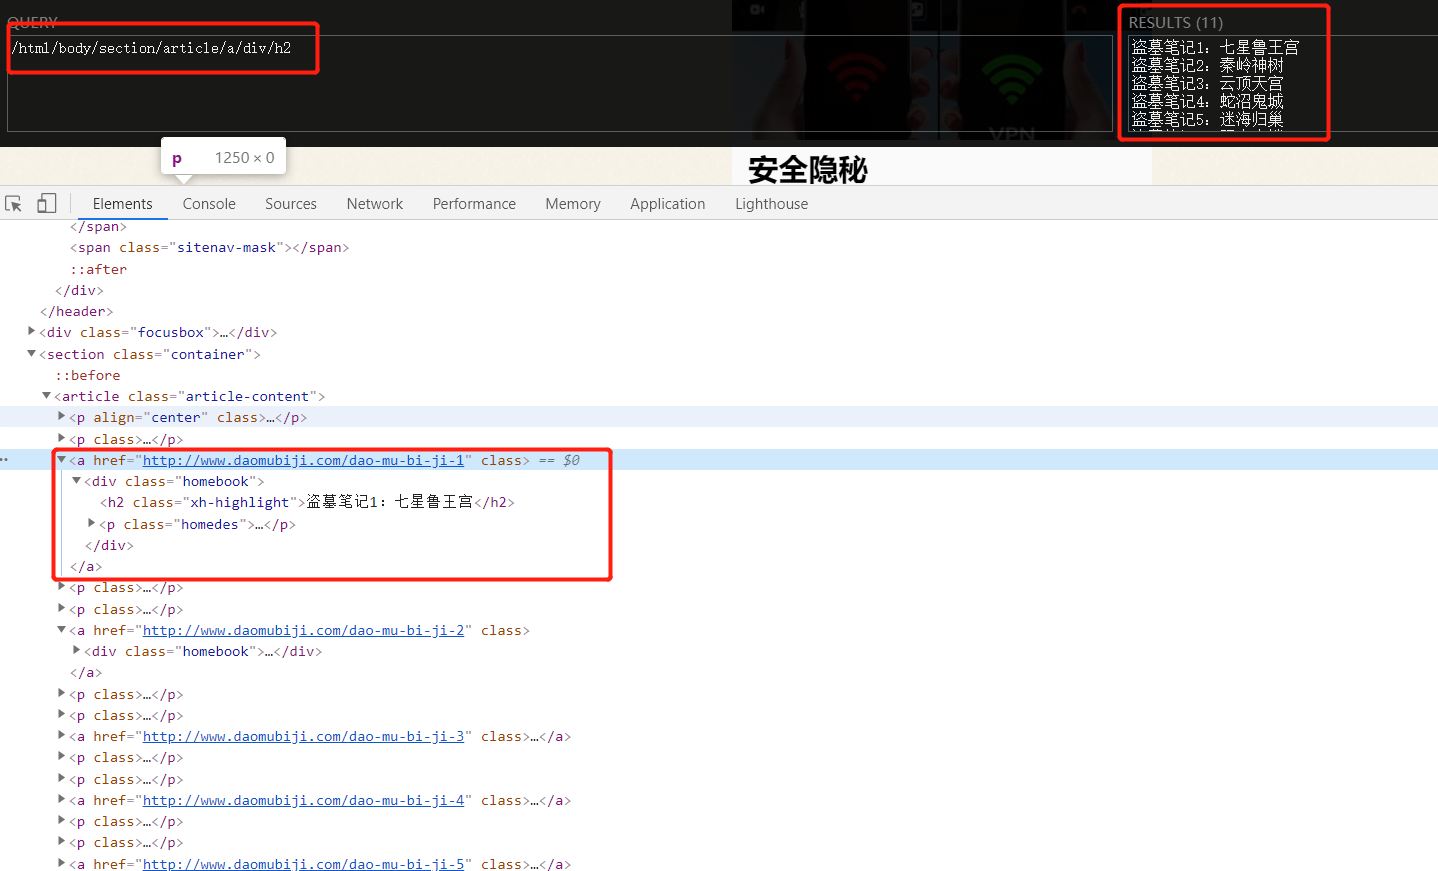
Xpath 定位元素,为何网页可以定位到,代码捕捉不到?
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
import requests

from lxml import etree


city_url = "http://www.daomubiji.com/"

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/81.0.4044.113 Safari/537.36"}

response = requests.get(url=city_url,headers=headers)

html = etree.HTML(response.text)

result = html.xpath('/html/body/section/article/a/div/h2/text()')

print(result)


# 结果为空 []
...全文
相关推荐
Selenium WebDriver中使用By.Xpath快速定位页面元素
在Selenium WebDriver中使用By.Xpath快速定位页面元素,实现多属性定位一个元素。
Selenium_XPath定位详解
Selenium_XPath定位详解 想下载csdn上的东西,苦于无积分,被逼无奈,才生此计,只设置了2分,跪求大佬支持一下。
页面元素xpath定位工具.rar
页面元素xpath定位工具,快速获取页面的所有可点击,输入的元素,并生成对应xpath
scrapy爬虫始终定位不到元素
scrapy爬虫始终定位不到元素 欲抓取网页链接 谷歌浏览器审查时界面 复制的xpath路径为//*[@id=“history”]/tr[1]/td[1],使用浏览器控制台验证无误 但使用get和xpath得到值为空列表 查看网页源代码对应路径下确实无此元素疑为异步加载网页,查看network 搜索并未找到欲抓取元素,难受。 不断调试试验,最终在firefox复制xpath绝对路径,并使用selenium成功定位到元素,成功代码如下: headers = { 'Accept': 'text/html,application/xhtml+xml,application/xml;
python selenium xpath定位操作
主要介绍了python selenium xpath定位操作,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧




