

 脚本语言

[python] 小白求助:有人帮我分析一下梨视频的视频真正网址在哪吗?
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
https://www.pearvideo.com/video_1703247
这个视频是应该是动态加载的。通过抓包工具,在XHR找到一个数据包,这里的Response里面应该有视频的真正地址。
import requests

from lxml import etree

headers = {

      'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_0) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.121 Safari/537.36'

}

url = 'https://www.pearvideo.com/videoStatus.jsp?contId=1703247&mrd=0.9431604561367266'

data = requests.get(url=url, headers=headers).json()

print(data)
但是爬下来的不是下面截图的这个。请问我应该怎么样才能找到视频的真正地址?
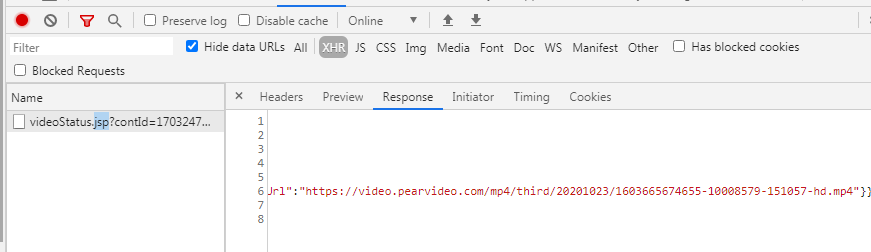
PS. 小白是自学某个爬虫教程,但这个教程的代码已经挂了,所以小白自己写。现在还没学到selenium,所以大佬不要讲得太高级。我只学了BS4, XPATH, 正则。
相关推荐
python安装网址
python开发网址大全,各种文档资料网址,常用插件网址等等。
利用python做文本分析——以爬取B站视频弹幕评论为例
本篇文章主要运用了机器学习以及Python爬虫以及nlp以及lda主题分析相关的操作内容 本文主要展示实战分析相关内容,关于理论的相关介绍不做过多展开 机器学习根据我的个人理解就是建立相关的模型,利用已有的数据对模型进行相关的训练,不断的丰富模型的准确度和适用范围。从而更加有效高效的解决问题 Python爬虫是利用网页的url链接,使用Python的相关库对网页进行解析并抓取相关的内容,从而便于进一步的分析处理 NLP主题分析和lDA主题分析都是常用的文本分析的方法,通过这两种方法可以对文本所含
Python爬虫教学视频-最全的Python爬虫视频教程全集
本Python爬虫教学视频,全集共51天课程,整套课程以Python语言为核心,通过各种经典案例的讲解,很好的演示了python爬虫如何抓取数据的全过程,非常值得Python爬虫工程师和想掌握python爬虫技术的同学借鉴学习。 Python爬虫实战学习day1 1Python爬虫的基本概念 2Fiddler简介 3网页信息简介 4读取网页三种方法 5正则表达式回顾 6抓取智联招聘 7抓取51job 8作业 Python爬虫实战学习day2 1response网络详细信息 2agent代{过}{滤}理解决网站屏蔽3agent也可以冒充手机或者ipad浏览器4get模拟百度5get模拟智联招聘6get小结7post通信8postogi 9get与post小结 10综合应用模拟android手机浏览器11本地代{过}{滤}理12代{过}{滤}理密码验证13下载14重定向 15加密网址的访问16debug调试17readcookie 18save与Loadcookie19人人网cookie模拟登陆
初级python网址下载
python入门书籍,值得初学者学习。提供网上源码地址下载
PyUrl-Downloader:网址下载器
Python-网址下载器 它是为Linux操作系统开发的,并且是用python语言编写的。 它是用于通过Linux Terminal下载文件链接的工具。 注意:必须安装Wget模块。 视频: : 源代码: :




