社区
CUDA高性能计算讨论
帖子详情
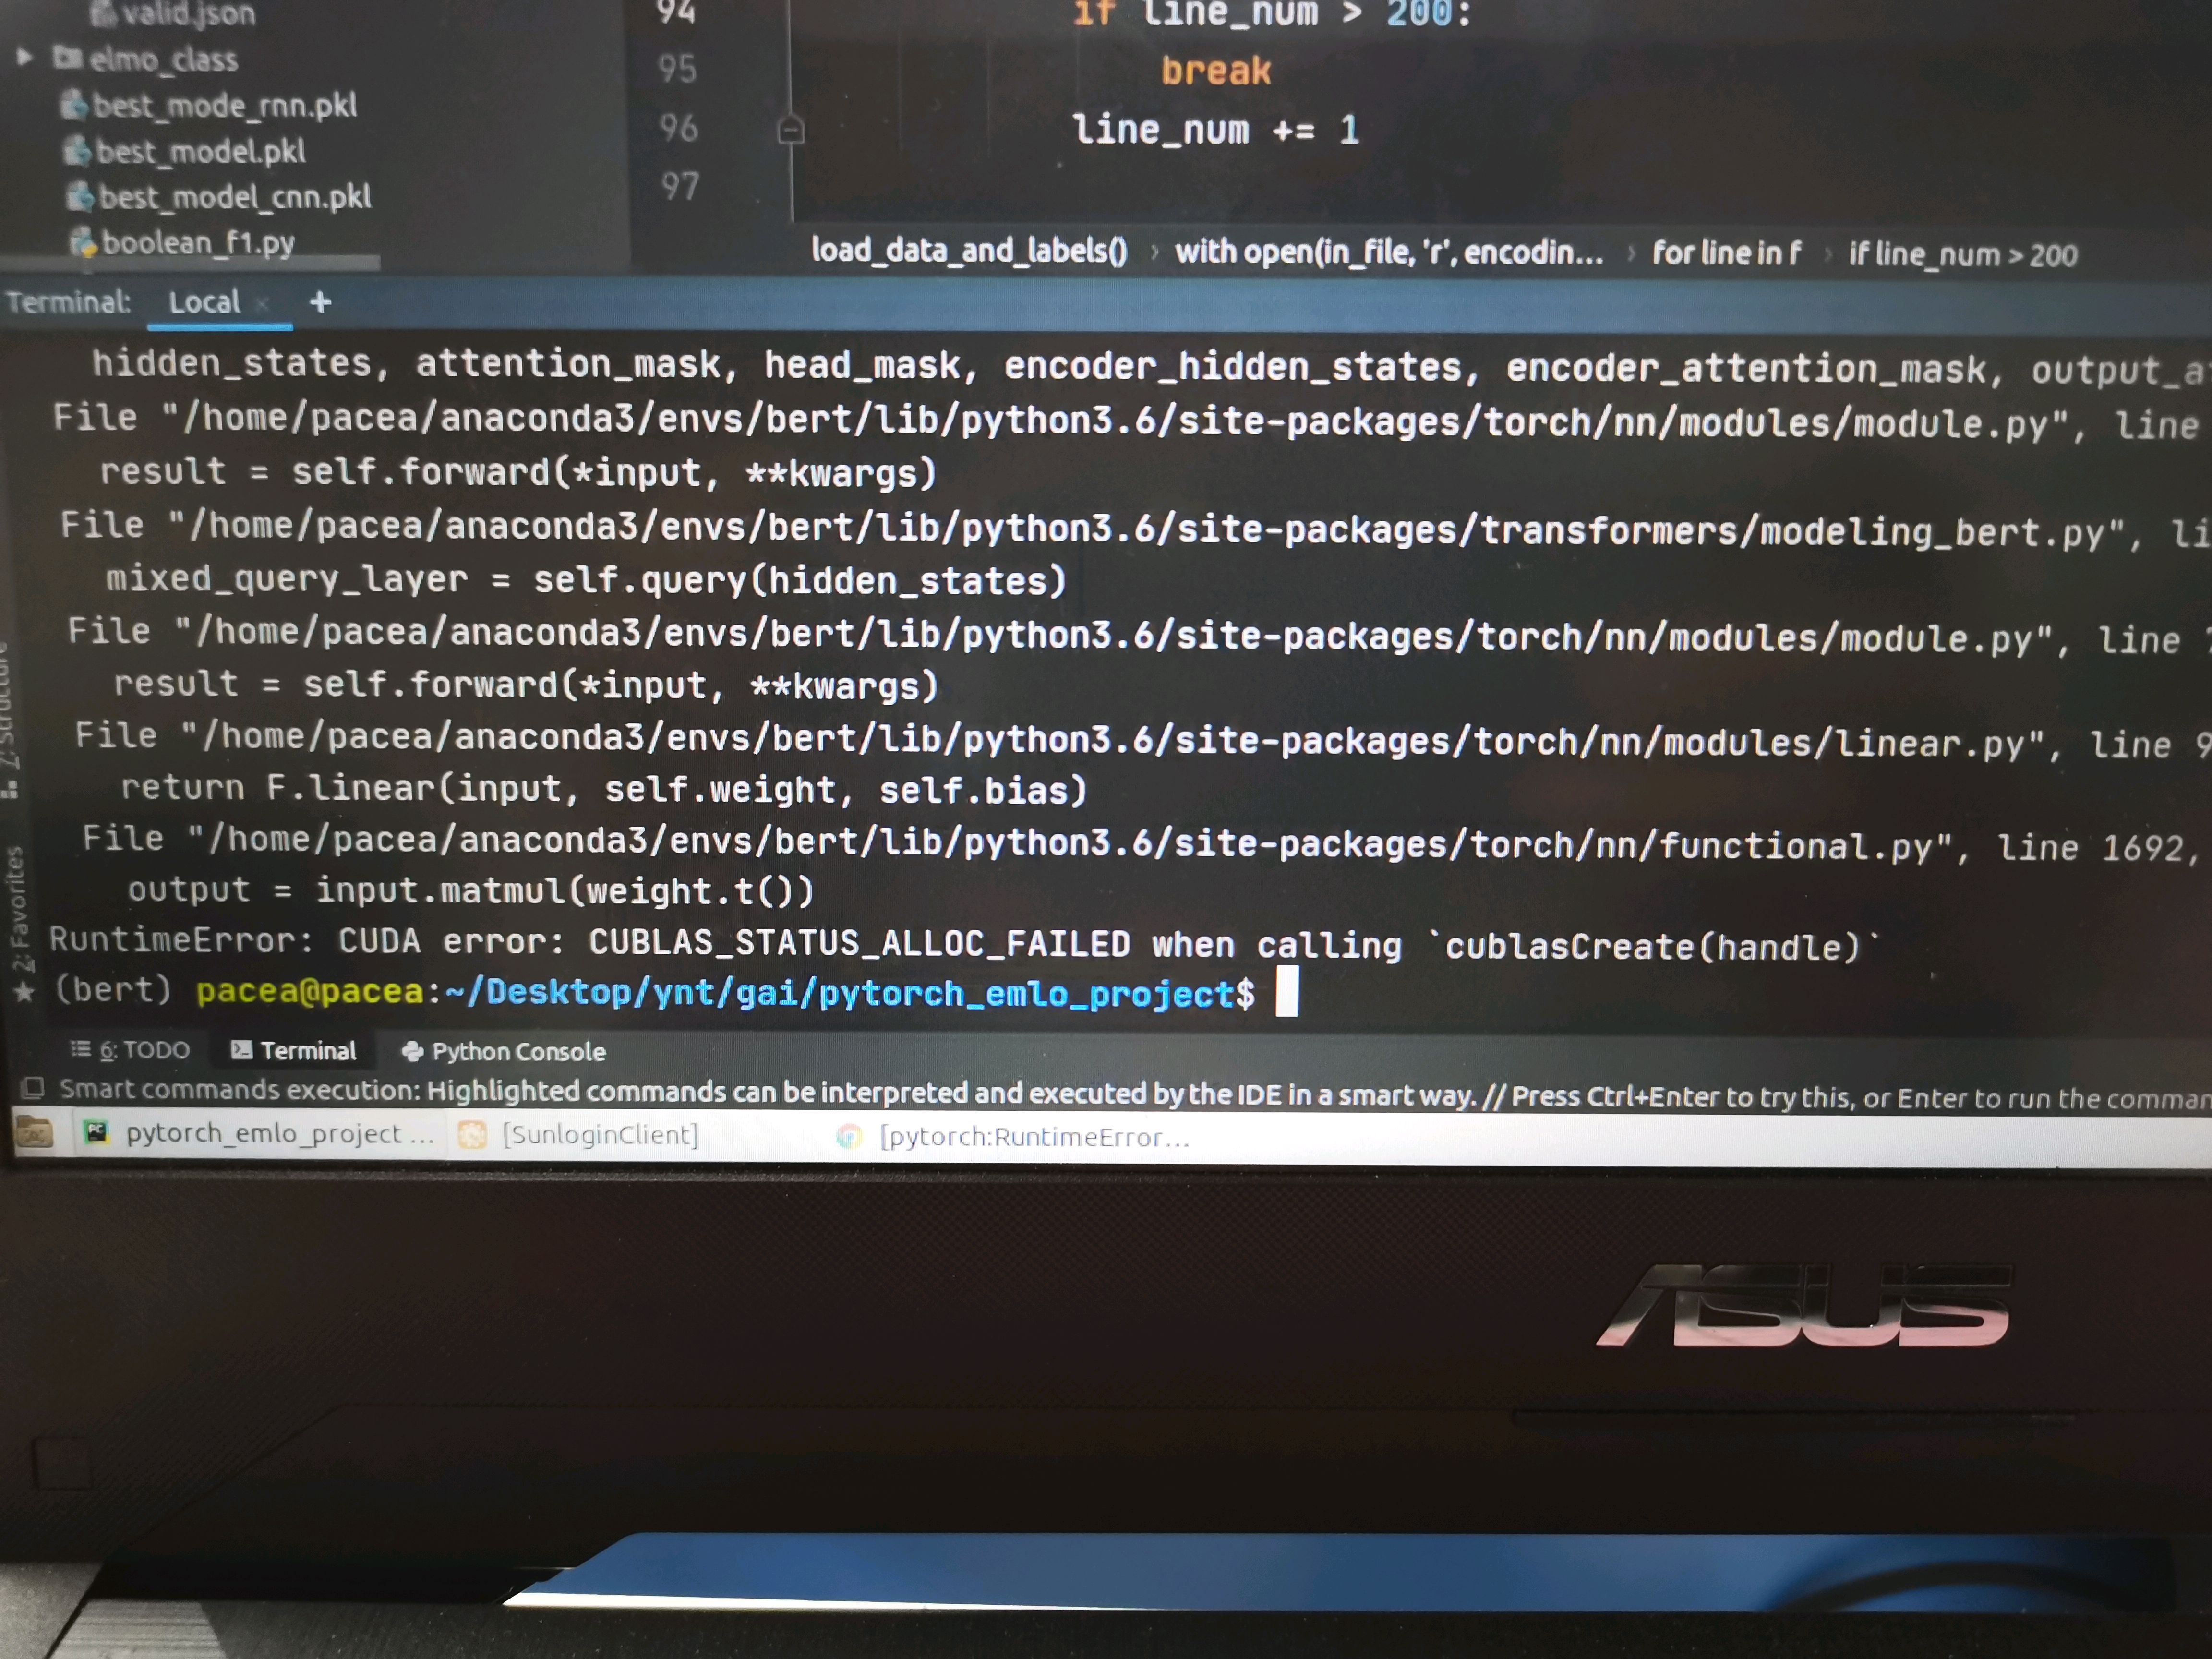
以pytorch为框架运行bert,在gpu内存分配遇到问题?在网上找解决方案,说是减小bachsize,减小后还是报错。
Emma_YeNT
2020-11-12 09:11:03
...全文
894
回复
打赏
收藏
以pytorch为框架运行bert,在gpu内存分配遇到问题?在网上找解决方案,说是减小bachsize,减小后还是报错。
[图片]
复制链接
扫一扫
分享
举报
写回复
配置赞助广告
用AI写文章
回复
切换为时间正序
请发表友善的回复…
发表回复
打赏红包
dataloader合理设置num_works和batch
size
避免爆内存
dataloader合理设置num_works和batch
size
,避免爆内存1.内存2.显存总结 个人总结,禁止以任何形式的转载!! 1.内存 1)dataloader会开启num_works个进程,如图所示:(这里设置的是6) 2)以图片为例,每个worker通过主进程获得自己需要采集的图片id(id的顺序由sampler或shuffle得到)。然后每个worker开始采集一个batch的数据,存放在内存中。(因此增大num_workers,内存占用也会增加。因为每个worker都需要缓存一个bat
深度学习复试项目-08:
bert
实战
整理训练日志、loss/acc 曲线,对比不同超参数下模型效果,分析模型优缺点,撰写完整实验报告。
RNN与torch DataParallel的爱恨情仇
torch.nn.DataParallel是通常用来多
gpu
加速的一个torch包。在我的实验过程中,发现了很多很多的bug。 在训练RNN模型时,由于RNN模型一般将batch_
size
放在第二个维度(输入、state)。DataParallel会将一个batch的数据切分开来,然后放到多个
gpu
上,默认按照第一维度进行切分(可以通过dim进行更换)。这里的
问题
就在于: 输入X是我们自己定义的,所以维度可以进行控制。 state向量一般是由RNN layer自己生成,所以batch_
size
必然在第二个
丹青幻境·Z-Image Atelier详细步骤:4090显卡24GB内存下的最优batch
size
设置
本文介绍了如何在星图
GPU
平台上自动化部署🏮 丹青幻境 · Z-Image Atelier镜像,并针对RTX 4090显卡的24GB显存,详细探讨了如何设置最优的批处理大小(batch
size
)以提升AI图片生成效率。通过分析分辨率、模型等关键因素,为数字艺术创作提供了从快速草图到高清成图的稳定高效工作流参考。
分布鲁棒数据驱动的多离散场景电热综合能源系统分布鲁棒优化算法研究(Matlab代码实现)
【分布鲁棒】数据驱动的多离散场景电热综合能源系统分布鲁棒优化算法研究(Matlab代码实现)
CUDA高性能计算讨论
357
社区成员
615
社区内容
发帖
与我相关
我的任务
CUDA高性能计算讨论
CUDA高性能计算讨论
复制链接
扫一扫
分享
社区描述
CUDA高性能计算讨论
社区管理员
加入社区
获取链接或二维码
近7日
近30日
至今
加载中
查看更多榜单
社区公告
暂无公告
试试用AI创作助手写篇文章吧
+ 用AI写文章



 发帖
 与我相关
 我的任务

 分享
