

 英特尔边缘计算技术












使用OpenVINO加速Pytorch表情识别模型
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
关于模型
OpenVINO自带的表情识别模型是Caffe版本的,这里使用的模型是前面一篇文章中训练生成的pytorch全卷积网络,模型基于残差网络结构全卷积分类网络。
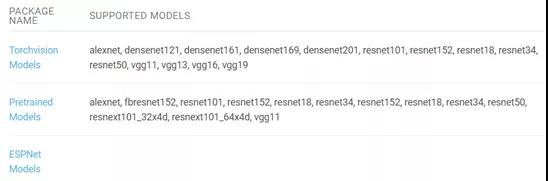
支持八种表情识别,列表如下:
转ONNX
训练好的Pytorch模型可以保存为pt文件,通过pytorch自带的脚本可以转换为ONNX模型,这一步的转换脚本如下:
OpenCV DNN调用ONNX模型测试
转换为ONNX格式的模型,是可以通过OpenCV DNN模块直接调用的,调用方式如下:
运行结果如下:
ONNX转IR
如何把ONNX文件转换OpenVINO的IR文件?答案是借助OpenVINO的模型优化器组件工具,OpenVINO的模型优化器组件工具支持常见的Pytorch预训练模型与torchvision迁移训练模型的转换,
要转换ONNX到IR,首先需要安装ONNX组件支持,直接运行OpenVINO预安装脚本即可获得支持,截图如下:

然后执行下面的转换脚本即可:
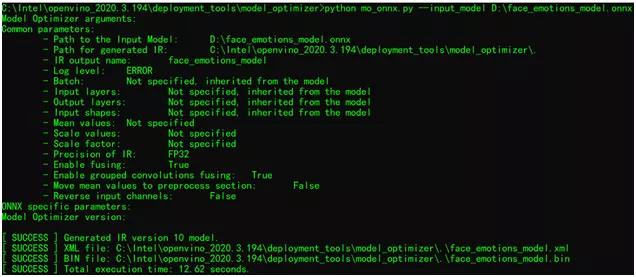
不用怀疑了,转换成功!
加速推理
使用OpenVINO的Inference Engine加速推理,对得到的模型通过OpenVINO安装包自带的OpenCV DNN完成调用,设置加速推理引擎为Inference Engine,这部分的代码如下:
其中readNetFromModelOptimizer表示使用OpenVINO模型优化器来加载文件,并使用inference engine执行加速推理。
执行推理与输出解析,得到表情分类的结果,代码如下:
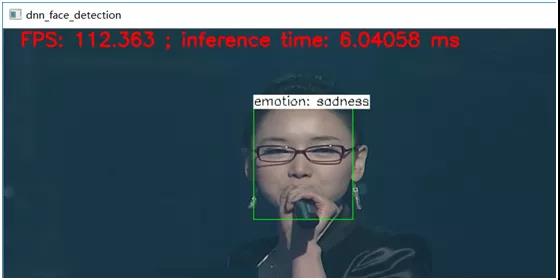
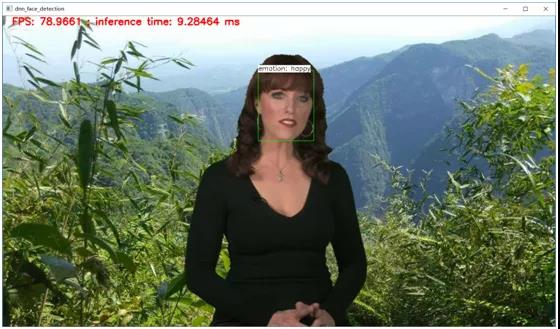
最终的运行结果如下图:
OpenVINO自带的表情识别模型是Caffe版本的,这里使用的模型是前面一篇文章中训练生成的pytorch全卷积网络,模型基于残差网络结构全卷积分类网络。
支持八种表情识别,列表如下:
转ONNX
训练好的Pytorch模型可以保存为pt文件,通过pytorch自带的脚本可以转换为ONNX模型,这一步的转换脚本如下:
dummy_input = torch.randn(1, 3, 64, 64, device='cuda')

 model = torch.load("./face_emotions_model.pt")

 output = model(dummy_input)

 model.eval()

 model.cuda()

 torch.onnx.export(model, dummy_input, "face_emotions_model.onnx", output_names={"output"}, verbose=True)
OpenCV DNN调用ONNX模型测试
转换为ONNX格式的模型,是可以通过OpenCV DNN模块直接调用的,调用方式如下:
landmark_net = cv.dnn.readNetFromONNX("landmarks_cnn.onnx")

 image = cv.imread("D:/facedb/test/464.jpg")

 cv.imshow("input", image)

 h, w, c = image.shape

 blob = cv.dnn.blobFromImage(image, 0.00392, (64, 64), (0.5, 0.5, 0.5), False) / 0.5

 print(blob)

 landmark_net.setInput(blob)

 lm_pts = landmark_net.forward()

 print(lm_pts)

for x, y in lm_pts:

    print(x, y)

    x1 = x * w

    y1 = y * h

    cv.circle(image, (np.int32(x1), np.int32(y1)), 2, (0, 0, 255), 2, 8, 0)

cv.imshow("人脸五点检测", image)

cv.imwrite("D:/landmark_det_result.png", image)

cv.waitKey(0)

cv.destroyAllWindows()
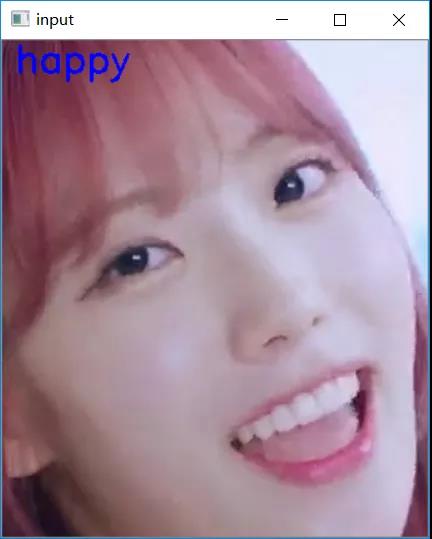
运行结果如下:
ONNX转IR
如何把ONNX文件转换OpenVINO的IR文件?答案是借助OpenVINO的模型优化器组件工具,OpenVINO的模型优化器组件工具支持常见的Pytorch预训练模型与torchvision迁移训练模型的转换,
要转换ONNX到IR,首先需要安装ONNX组件支持,直接运行OpenVINO预安装脚本即可获得支持,截图如下:
然后执行下面的转换脚本即可:
不用怀疑了,转换成功!
加速推理
使用OpenVINO的Inference Engine加速推理,对得到的模型通过OpenVINO安装包自带的OpenCV DNN完成调用,设置加速推理引擎为Inference Engine,这部分的代码如下:
dnn::Net emtion_net = readNetFromModelOptimizer(emotion_xml, emotion_bin);

2emtion_net.setPreferableTarget(DNN_TARGET_CPU);

3emtion_net.setPreferableBackend(DNN_BACKEND_INFERENCE_ENGINE);
其中readNetFromModelOptimizer表示使用OpenVINO模型优化器来加载文件,并使用inference engine执行加速推理。
执行推理与输出解析,得到表情分类的结果,代码如下:
Rect box(x1, y1, x2 - x1, y2 - y1);

 Mat roi = frame(box);

 Mat face_blob = blobFromImage(roi, 0.00392, Size(64, 64), Scalar(0.5, 0.5, 0.5), false, false);

 emtion_net.setInput(face_blob);

 Mat probs = emtion_net.forward();

 int index = 0;

 float max = -1;

 for (int i = 0; i < 8; i++) {

     const float *scores = probs.ptr<float>(0, i, 0);

    float score = scores[0];

    if (max < score) {

        max = score;

        index = i;

    }

}

rectangle(frame, box, Scalar(0, 255, 0));
最终的运行结果如下图:
...全文
相关推荐
RK3568实现人脸检测和人脸五点关键点检测【人工智能项目实战】
**移植模型**:将训练好的模型转换为能在RK3568上运行的格式,如TensorRT或OpenVINO的中间表示(IR)文件。5.
OpenVINO视觉加速库依赖包
**Model Optimizer**:这是一个命令行工具,用于将训练好的深度学习模型(如TensorFlow、Caffe、PyTorch等框架的模型)转换为中间表示(IR)文件,这个格式是OpenVINO
【模型c++部署】yolov8(检测、分类、分割、姿态)使用openvino进行部署
使用Model Optimizer将PyTorch模型转换为IR。
YOLO人脸检测与表情识别双任务系统实战指南
人脸检测与表情识别是计算机视觉中典型的多任务协同问题,其核心在于共享特征提取与解耦预测头的设计原理。基于YOLO架构的轻量级单阶段模型,凭借高推理速度与良好精度平衡,成为边缘端部署的主流选择;通过主干频域增强、BiFPN颈部重构及检测-关键点-表情三支路协同设计,可显著提升小脸召回率与表情判别鲁棒性。该技术广泛应用于智能门禁、情绪分析终端与人机交互设备等实时场景,本文聚焦于YOLOv8/v10实际工程改造路径,涵盖数据对齐、课程学习、ONNX/TensorRT部署及OpenVINO CPU加速等落地关键环节
win10+python环境OpenVINO推理加速自己训练的yolov5模型(csdn)————程序.pdf
在本文中,我们将探讨如何在Windows 10操作系统和Python环境下,使用OpenVINO工具包来加速自己训练的YOLOv5模型的推理过程。





