

 脚本语言

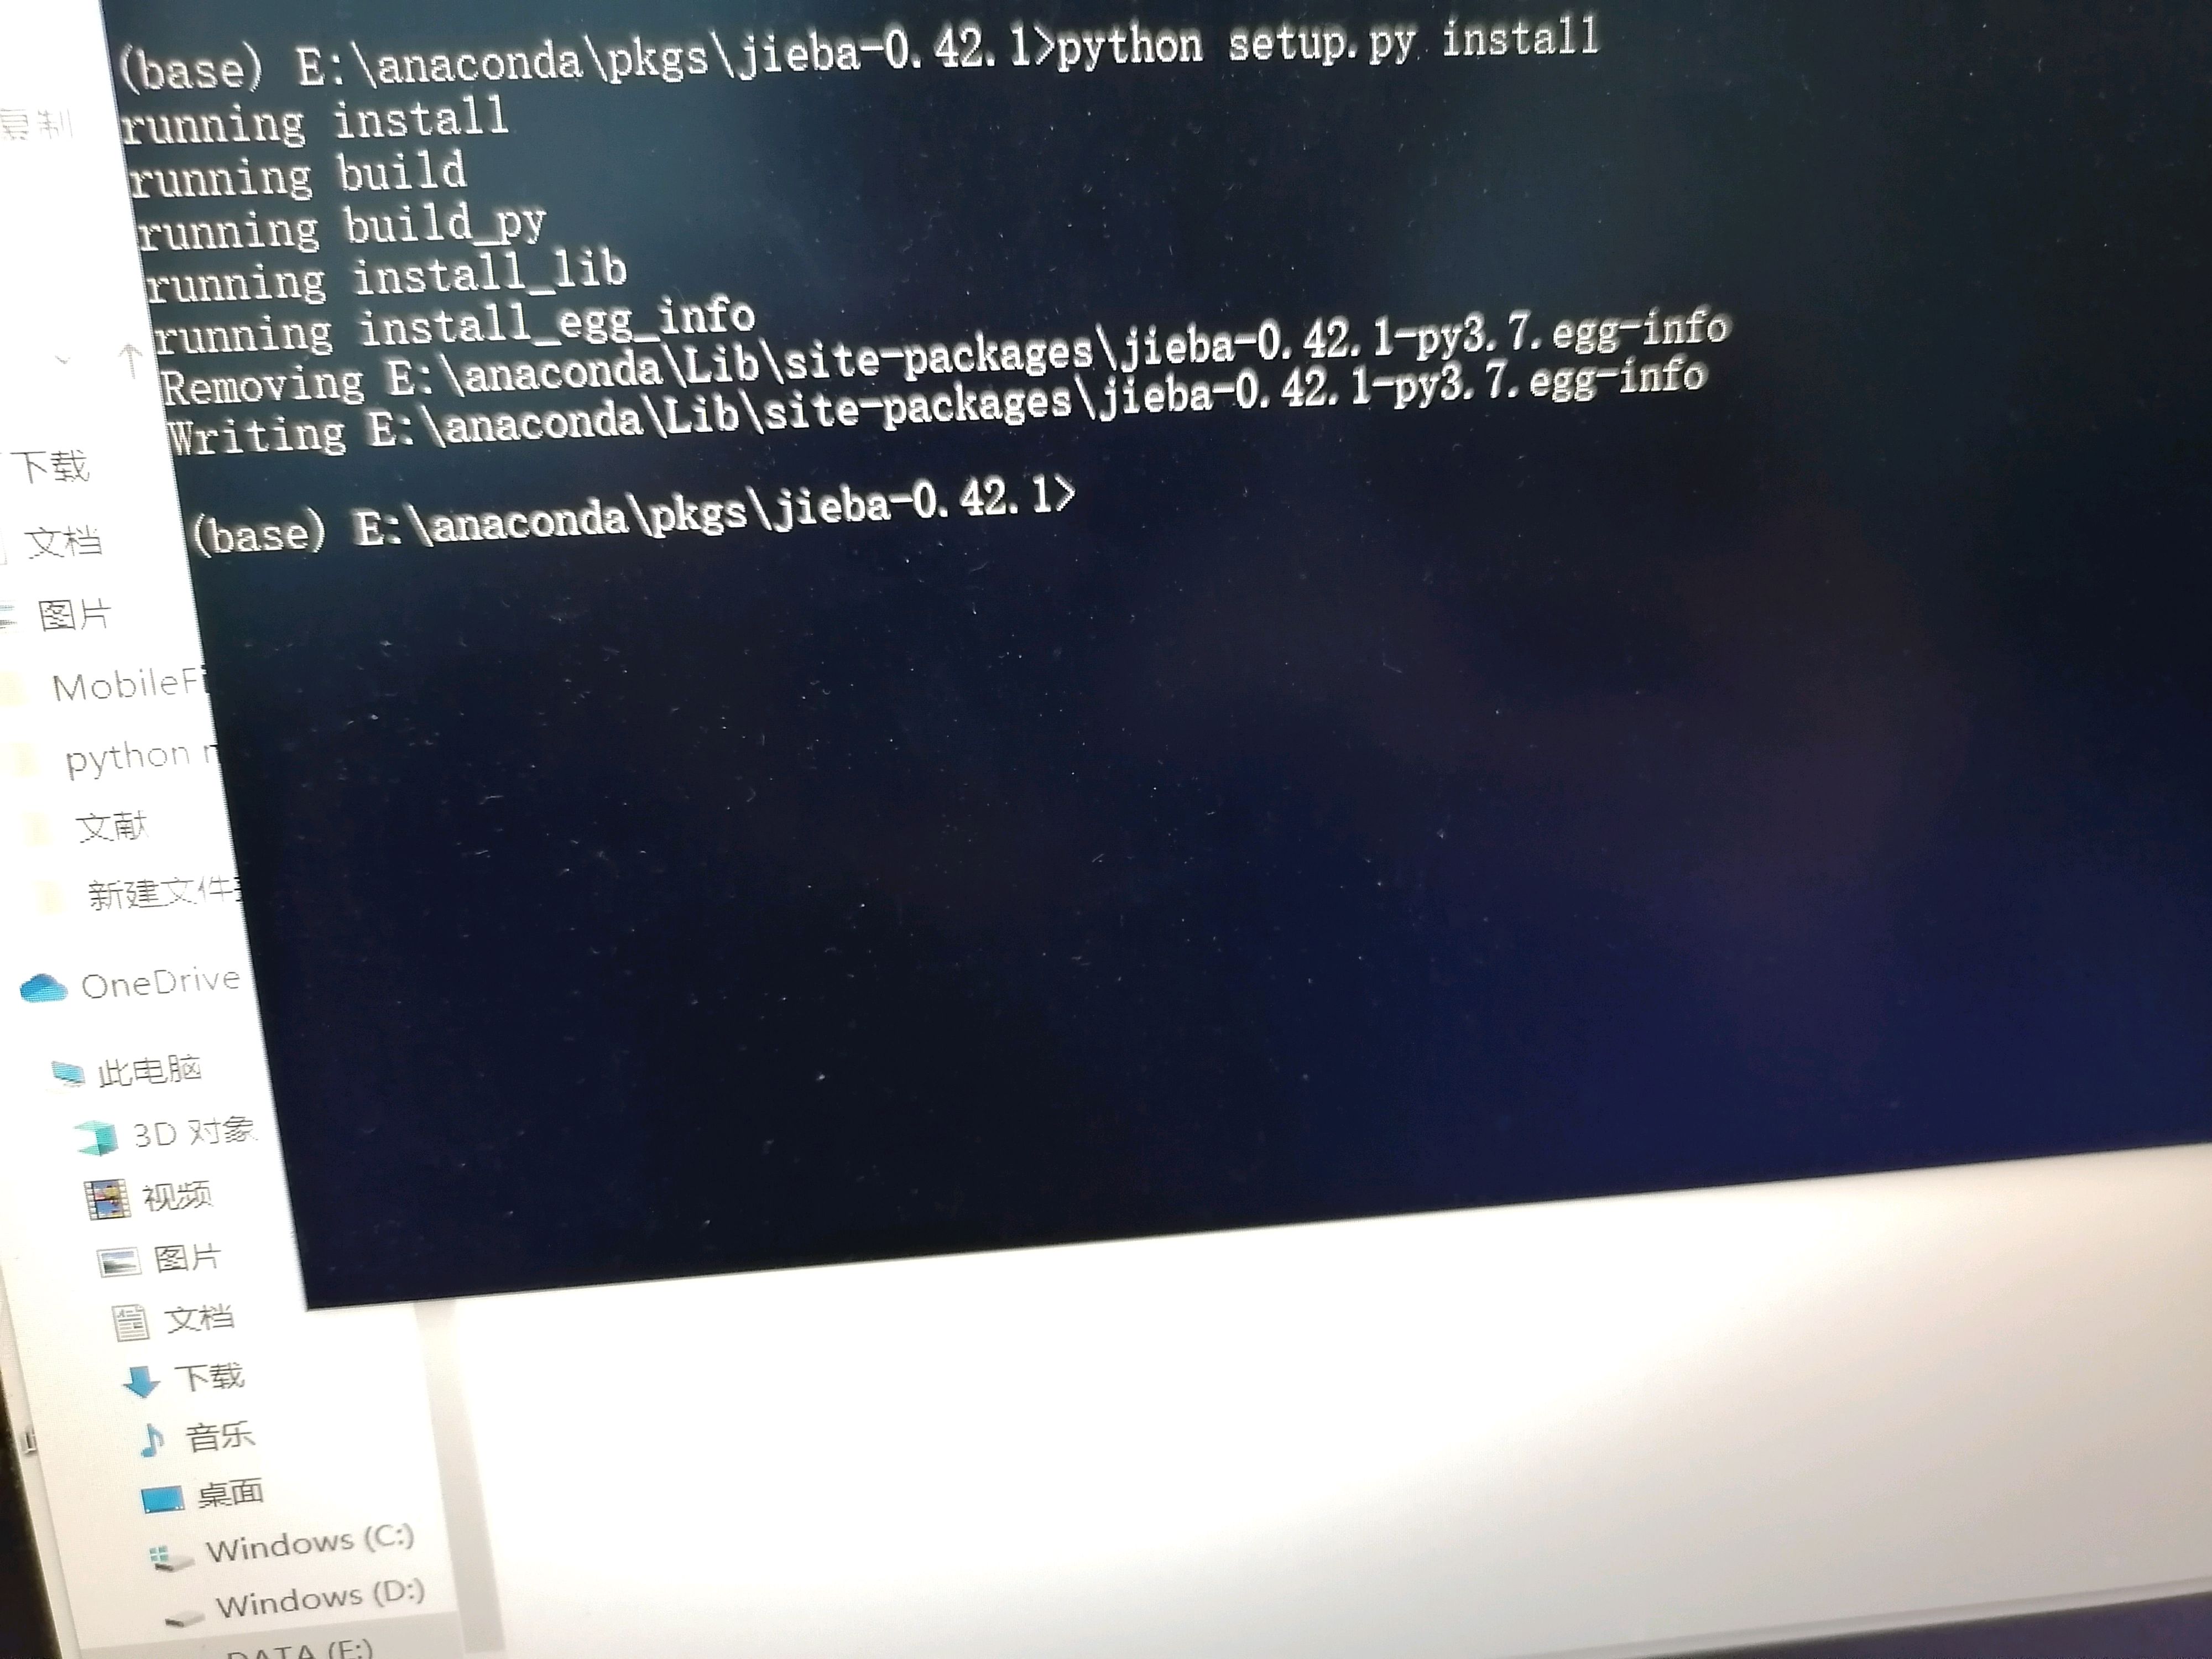
在acc中显示jieba已经安装,但是打开acc后发现找不到jieba.
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区

相关推荐
基于python的电影评论数据的中文情感分析源码(含训练数据、验证数据).zip
基于python的电影评论数据的中文情感分析(含训练数据、验证数据) 1).数据集 使用电影评论数据作为训练数据集. 其中, 训练数据集20000条(正负向各10000条); 测试数据集6000条(正负向各3000条) 2).数据预处理 1.去除停用词, 并使用jieba进行分词 2.使用预训练的词向量模型,对句子进行向量化 2. 各种实现方法准确率对比 3. 各种实现方法acc-loss曲线绘制 1).NN(MLP)实现方法结果绘制: 2).CNN实现方法结果绘制
PyTorch全连接网络实现垃圾邮件分类实战指南
垃圾邮件分类是典型的文本二分类任务,其本质是在高维稀疏词向量空间中寻找线性可分边界。全连接神经网络凭借结构简洁、参数可控、训练稳定等优势,成为小样本、低算力场景下的务实选择——它无需复杂序列建模,却能自动学习TF-IDF特征权重,兼顾可解释性与工程落地性。相比CNN、RNN或BERT等重型模型,全连接网络在2500封中英文混合邮件数据上实现93.1% F1-score,训练仅需CPU 3分钟,且支持t-SNE可视化、梯度追踪与错误归因分析。本文聚焦毕业设计级交付:从乱码邮件清洗、增强式特征工程,到带Batc
基于双向LSTM的智能问答系统,有交互界面、详细注释、多版本、能运行、文件齐全。.zip
LSTM (Long Short-Term Memory) 是一种特殊的循环神经网络(RNN)架构,用于处理具有长期依赖关系的序列数据。传统的RNN在处理长序列时往往会遇到梯度消失或梯度爆炸的问题,导致无法有效地捕捉长期依赖。LSTM通过引入门控机制(Gating Mechanism)和记忆单元(Memory Cell)来克服这些问题。 以下是LSTM的基本结构和主要组件: 记忆单元(Memory Cell):记忆单元是LSTM的核心,用于存储长期信息。它像一个传送带一样,在整个链上运行,只有一些小的线性交互。信息很容易地在其上保持不变。 输入门(Input Gate):输入门决定了哪些新的信息会被加入到记忆单元中。它由当前时刻的输入和上一时刻的隐藏状态共同决定。 遗忘门(Forget Gate):遗忘门决定了哪些信息会从记忆单元中被丢弃或遗忘。它也由当前时刻的输入和上一时刻的隐藏状态共同决定。 输出门(Output Gate):输出门决定了哪些信息会从记忆单元中输出到当前时刻的隐藏状态中。同样地,它也由当前时刻的输入和上一时刻的隐藏状态共同决定。 LSTM的计算过程可以大致描述为: 通过遗忘门决定从记忆单元中丢弃哪些信息。 通过输入门决定哪些新的信息会被加入到记忆单元中。 更新记忆单元的状态。 通过输出门决定哪些信息会从记忆单元中输出到当前时刻的隐藏状态中。 由于LSTM能够有效地处理长期依赖关系,它在许多序列建模任务中都取得了很好的效果,如语音识别、文本生成、机器翻译、时序预测等。
快速搭建垃圾分类智能问答机器人--完整工程
# 快速搭建垃圾分类智能问答机器人 基于深度学习实现的垃圾分类智能问答机器人 垃圾分类垂直领域问答机器人核心做法: 1、将问题分八大类,每个问题太类别给出一个回答 2、使用 word2vec + TextCNN 建立模型 - 环境要求 python: 3.x tensorflow: 1.x jieba word2vec # 模型训练 - 词向量方法 训练: 200个epoch,loss 0.829977, acc 0.686275 评估:0.791946 - 词汇索引方法 训练:200个epoch,loss 0.657236, acc 0.862745 评估:Accuracy: 0.852349
机器学习与深度学习结合BERT的虚假新闻检测项目源码
【资源说明】 1、该资源包括项目的全部源码,下载可以直接使用。 2、本项目适合作为计算机、数学、电子信息等专业的课程设计、期末大作业和毕设项目,作为参考资料学习借鉴。 3、本资源作为“参考资料”如果需要实现其他功能,需要能看懂代码,并且热爱钻研,自行调试。 基于机器学习+深度学习+bert方法的虚假新闻检测项目源码.zip 虚假新闻检测项目,简单的nlp分类问题 使用机器学习、深度学习和bert模型解决问题 仓库中只上传了代码,大文件统统没有上传,下面网盘链接用于下载需要的大文件,照着文件夹融合网盘文件和代码文件即可 ### 问题描述 数据集是中文微信消息,包括微信消息的Official Account Name,Title,News Url,Image Url,Report Content,label。Title是微信消息的标题,label是消息的真假标签(0是real消息,1是fake消息)。训练数据保存在train.news.csv,测试数据保存在test.news.csv。 实验过程中先统计分析训练数据【train.news.csv】。根据train.news.csv中的Title文字训练模型,然后在test.news.csv上测试,给出Precision, Recall, F1-Score, AUC的结果。 ### 环境配置 使用anaconda集成开发环境,pytorch深度学习框架 ### 方法介绍 #### 机器学习模型 主要流程就是数据加载、预处理、特征工程、模型训练与评估,nlp的任务需要将文本数据转换成向量数据,这里用了词袋模型和`tyidf`两张方法。 代码在`traditional.py`中,都有现成的包用,简单调包调参就行,使用了随机森林、支持向量机、朴素贝叶斯、逻辑回归等方法,有的算法可以加入网格搜索与交叉验证调参,不过感觉如果想继续优化可能得在特征工程部分下手。 最后得到的结果: | 使用模型 | 向量化方法 | acc | recall(1) | precision(1) | auc | | :------------------------------: | :--------: | :----: | :-------: | :------------: | :--: | | 朴素贝叶斯+jieba精确模式 | 词袋模型 | 84.33% | 0.60 | 0.47 | 0.74 | | 同上 | tyidf | 88.97% | 0.33 | 0.80 | 0.66 | | 高斯内核支持向量机+jieba搜索引擎 | 词袋模型 | 86.62% | 0.10 | 0.84 | 0.55 | | 同上 | tyidf | 91.21% | 0.46 | 0.89 | 0.72 | | 随机森林+jieba精确模式 | 词袋模型 | 87.03% | 0.12 | 0.97 | 0.56 | | 同上 | tyidf | 87.18% | 0.13 | 0.98 | 0.56 | | 逻辑回归+jieba精确模式 | 词袋模型 | 90.48% | 0.50 | 0.77 | 0.74 | | 同上 | tyidf | 89.33% | 0.37 | 0.79 | 0.68 | #### 神经网络解决。资源来源于网络分享,仅用于学习交流使用,请勿用于商业,如有侵权请联系我删除!




