

 OneFlow深度学习框架

谷歌研究人员在压缩视觉表示中的最新进展
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
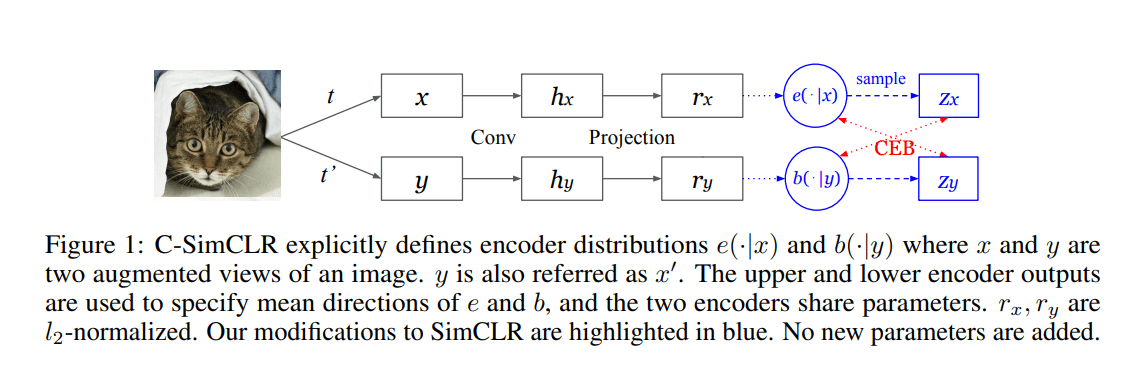
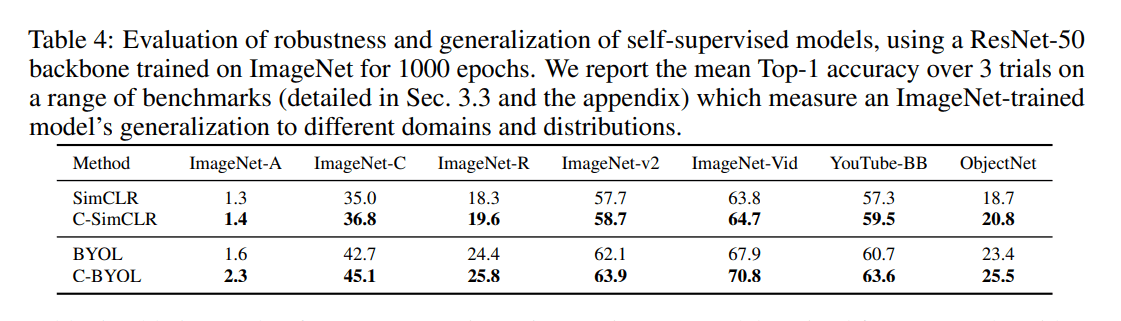
#压缩视觉表示# 近年来,在无人工监督的情况下,用于#SimCLR# (对比学习) 和#BYOL# (发掘自身潜能) 的最先进算法在学习视觉表示方面取得了巨大飞跃。一个#谷歌# 研究团队提出,将显式信息压缩添加到这些方法中可以显着提高性能。研究人员通过使用CEB显式添加信息压缩来修改 SimCLR 和 BYOL,产生 C-SimCLR 和 C-BYOL 变体,这些变体在其视觉表示中展示了更高的准确性和健壮性。论文:https://arxiv.org/abs/2109.12909
相关推荐
整理的计算机视觉/深度学习/机器学习相关方向的论文
整理的计算机视觉/深度学习/机器学习相关方向的论文
【AI视野·今日CV 计算机视觉论文速览 第170期】Mon, 25 Nov 2019
AI视野·今日CS.CV 计算机视觉论文速览 Mon, 25 Nov 2019 第170期 ---多视角三维重建网络数据集BlenderMVS ---点云与图像分割融合PointPainting ---目标检测架构搜索方法 ---合成数据噪声与真实数据噪声研究 ---快速稀疏卷积方法
斯坦福公布3D街景数据集:2500万张图像,8个城市模型 | 下载
安妮 编译整理 量子位 出品 | 公众号 QbitAI 近日,斯坦福大学的研究人员公布了一个数据集,其中包含带有相机姿态的街景数据、8个城市的3D模型和拓展的元数据。这个数据集数据量庞大,街景数据集就包含2500万张图像和1.18亿个匹配的图像对。 数据集可用于学习6DOF相机姿态估计/视觉运动、图像匹配及各种三维估计。比如下面的这个例子: 为了得到这个数据集,斯坦福的
人脸识别国内外相关论文
毕业设计专用,非诚勿扰~毕业设计专用,非诚勿扰~毕业设计专用,非诚勿扰~
谷歌视觉API
谷歌视觉API





