

 CSDN 开源数据库社区

七天玩转Redis | 第二天打卡贴 数据类型以及使用
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
今日学习内容
Java的数据类型
- 基本数据类型:byte、short、int、long、double、float、char、boolean(八种)
- 引用数据类型:类、接口和数组(三种)
redis的数据类型
- String、List、Set、Hash和Zset(五种)
String(最常用):
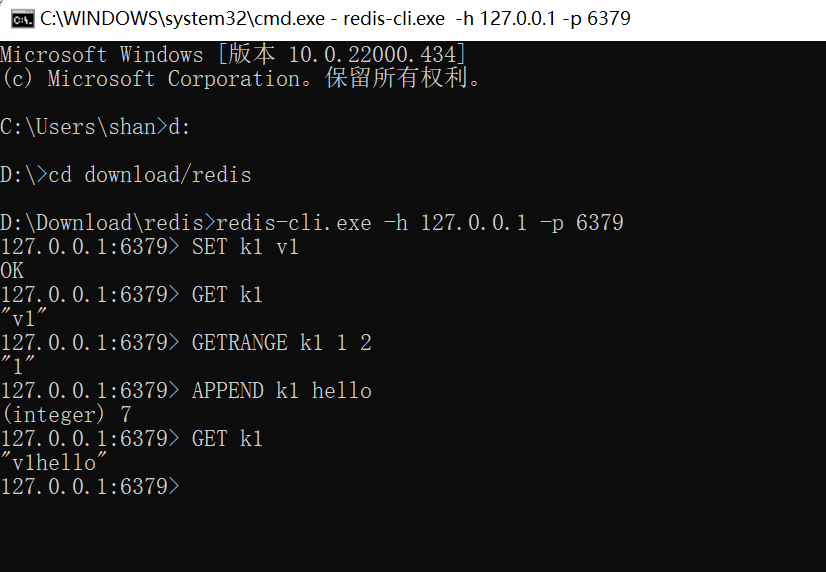
设置指定key的值:
SET key value
- key为索引
- value为对应的值
获取指定key的值
GET key
- key为要获取的值对应的索引
返回key中字符串值的子串
GETRANGE key start end
- key为字符串的索引
- start为截取的起始下标
- end为截取的终止下标
如果你设置的获取子串的范围比较大,已经超出了字符串原本的长度,那么只会返回到字符串的最后一个字符。
获取多个给定key的值
MGET key1 [key2...]
- 在MGET的后面可以追加多个索引,以空格分开
返回key所对应的字符串的长度
STRLEN key
- key为字符串对应的索引
设置一个或多个键值对
MSET key1 value1 [key2 value2 ...]
- key1 value1为要设置的第一个键值对,之后的以空格分隔
MSETNX key1 value1 [key2 value2 ...]
- key1 value1为要设置的第一个键值对,之后的以空格分隔
将key中所存储的数值加一/减一
INCR key//DECR
- key为要加1的数对应的索引
INCRBY key increment//DECRBY
- key为索引
- increment为要增加的值
字符串追加
APPEND key value
- key为索引
- value为要追加的字符串
Hash型:
一个String类型的field(字段)和value(值)的映射表,它的作用是可以用来存储我们定义的数据对象,所以简单来说它是一个key下面存储了多个key-value的情况
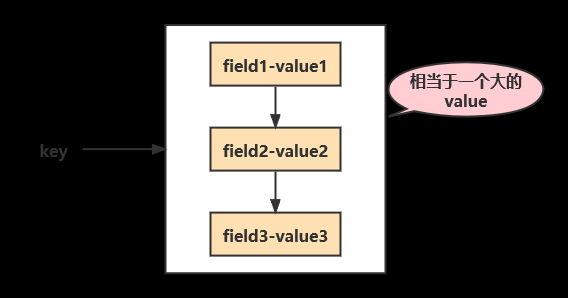
设置一个Hash数据
设置Hash数据所使用的命令不是SET,而是HMSET,你可以理解为H代表Hash的意思,M代表Map的意思,该命令的格式如下:
HMSET key fieId1 value1 [fieId2 value2...]
key为这个Hash数据对应的唯一性索引
field为下面存储的一个键值对的键
value为该键对应的值
获取指定哈希表中所有的字段和值
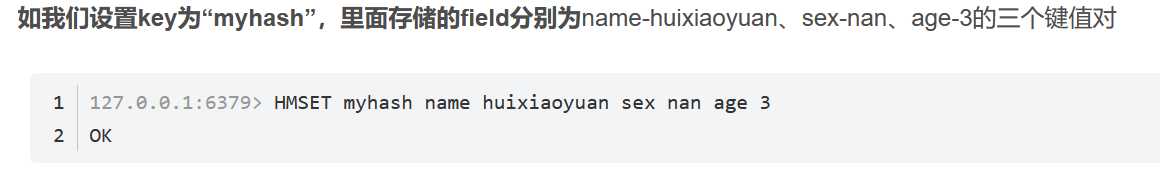
获取存储在哈希表中指定字段的值
HGET key field
- key哈希表的索引
- field获取的值对应的字段
删除一个或多个哈希表字段
HDEL key field1 [field2...]
- key为指定的哈希表的索引
- field为要删除的值对应的字段,如果要删除多个就以空格分开
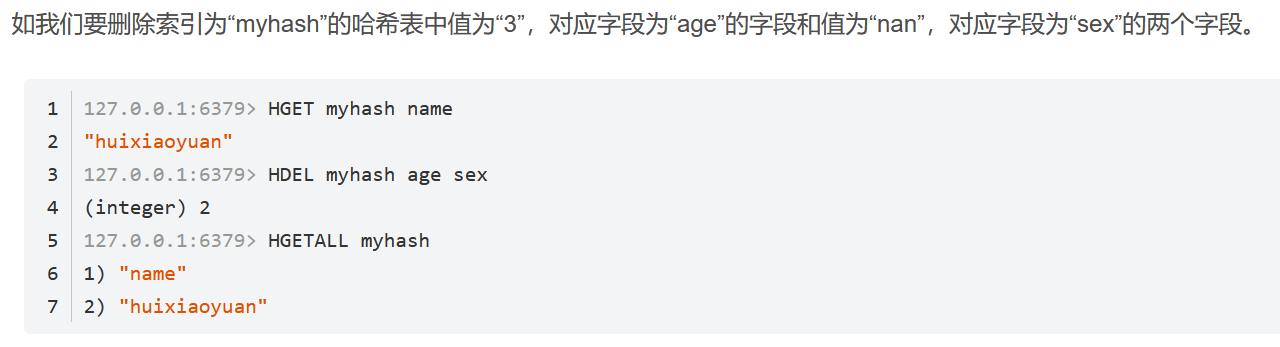
获取哈希表中字段的数量
HLEN key
- key为指定的哈希表的索引
获取哈希表中的所有字段
HKEYS key
- key为指定的哈希表的索引
获取哈希表中所有的值
HVALS key
- key为指定的哈希表的索引
List类型
在Redis中的列表存储的是一个一个的字符串,按照插入的顺序进行排序,在Redis中可以指定是在列表的头部或者尾部插入。所以你也可以把它看作是一个LinkedList结构
Set集合
Redis中的Set集合和Java中的Set集合所表示的含义一样,都是无序集合,且集合中的元素是唯一的,不可重复的。
ZSet集合
ZSet集合与Set集合类似,也是不允许成员重复的,但是需要注意的是Set集合中的成员是无序排练的,而ZSet集合中的成员是有序排列的,原因是ZSet集合中的每一个元素都会关联一个double类型的分数(也可以理解为权重),redis也正是通过分数来为集合中的成员进行从小到大排序的。所以有序集合的成员是虽然唯一的,但是分数(score)却是可以重复的。
————————————————
遇到的问题:暂无
今天的收获:
(链接:https://blog.csdn.net/weixin_44985880/article/details/122509953)
相关推荐
基于MATLAB的复合弹性模量分析,采用混合法则,结合纤维体积分数变化和图形结果。.zip
1.版本:matlab2014a/2019b/2024b 2.附赠案例数据可直接运行。 3.代码特点:参数化编程、参数可方便更改、代码编程思路清晰、注释明细。 4.适用对象:计算机,电子信息工程、数学等专业的大学生课程设计、期末大作业和毕业设计。
基于MATLAB的自适应纯追踪曲线跟踪机器人仿真,采用多路径、自适应速度控制和图形界面可视化。.zip
1.版本:matlab2014a/2019b/2024b 2.附赠案例数据可直接运行。 3.代码特点:参数化编程、参数可方便更改、代码编程思路清晰、注释明细。 4.适用对象:计算机,电子信息工程、数学等专业的大学生课程设计、期末大作业和毕业设计。
【数据库优化】通信行业B/O域查询性能提升:基于分区裁剪与覆盖索引的秒级溯源系统实现
内容概要:本文围绕通信行业中海量话单与信令数据的查询性能问题,系统阐述了从全表扫描到秒级响应的数据库优化路径。文章以运营商 cdr_detail 表为案例,揭示了因使用函数操作索引列(如DATE(call_start_time))和深分页(LIMIT offset, size)导致的全表扫描问题,并提出完整的优化方案:通过时间范围RANGE分区实现分区裁剪、构建msisdn与时间的联合覆盖索引、消除索引列函数运算、采用游标分页替代OFFSET等方式,使查询性能从P95 8.3秒降至290毫秒。同时介绍了执行计划分析(EXPLAIN)在调优中的关键作用,并展望了HTAP架构、向量化执行与AI自治优化器等未来方向。; 适合人群:具备一定数据库基础知识,从事通信行业数据开发、DBA或后端研发的技术人员,尤其是面对大规模时序数据查询性能瓶颈的工程师;; 使用场景及目标:①解决营业厅用户详单查询、网间结算对账、VoNR信令分析等高并发、低延迟查询场景下的性能问题;②掌握如何通过分区策略、索引设计和SQL改写实现从全表扫描到精准索引访问的优化落地; 阅读建议:建议结合实际生产环境中的大表查询案例,对照本文的反例与正例进行执行计划对比分析,并在测试环境中实践分区表创建、覆盖索引构建及游标分页改写,深入理解每项优化技巧的实际效果。
石墨提纯全球市场结构与产业发展趋势分析报告(QYResearch最新研究).docx
石墨提纯全球市场结构与产业发展趋势分析报告(QYResearch最新研究)
政府科技管理者如何提升科技成果转化政策的精准匹配与执行效率?.docx
政府科技管理者如何提升科技成果转化政策的精准匹配与执行效率?




