

 2022AI面试1000题讨论区

阿里计算机视觉算法工程师面试题5道
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
题目来源:七月在线社区学员分享,这边整理输出答案,答案仅供参考,欢迎评论区交流指正。
6本电子书图片放在文末,需要的直接私我领吧。
1、手写交叉熵损失函数
二分类交叉熵
多分类交叉熵
期望风险:机器学习模型关于真实分布(所有样本)的平均损失称为期望风险
经验风险:机器学习模型关于训练集的平均损失称为经验风险,当样本数无穷大∞的时候趋近于期望风险(大数定律)
结构风险:结构风险 = 经验风险 + 正则化项
经验风险是局部的,基于训练集所有样本点损失函数最小化的。
期望风险是全局的,是基于所有样本点的损失函数最小化的。
经验风险函数是现实的,可求的。
期望风险函数是理想化的,不可求的。
3、l1和l2正则化的区别是什么,是什么原因导致的
L1/L2的区别
L1是模型各个参数的绝对值之和。
L2是模型各个参数的平方和的开方值。
L1会趋向于产生少量的特征,而其他的特征都是0。
因为最优的参数值很大概率出现在坐标轴上,这样就会导致某一维的权重为0 ,产生稀疏权重矩阵
L2会选择更多的特征,这些特征都会接近于0。
最优的参数值很小概率出现在坐标轴上,因此每一维的参数都不会是0。当最小化||w||时,就会使每一项趋近于0。
L1的作用是为了矩阵稀疏化。假设的是模型的参数取值满足拉普拉斯分布。
L2的作用是为了使模型更平滑,得到更好的泛化能力。假设的是参数是满足高斯分布。
4、BN的计算流程和优点
BN大致的计算流程?
1)计算样本均值。
2)计算样本方差。
3)样本数据标准化处理。
4)进行平移和缩放处理。引入了γ和β两个参数。来训练γ和β两个参数。引入了这个可学习重构参数γ、β,让我们的网络可以学习恢复出原始网络所要学习的特征分布。
BN的优点?
1)加快训练速度,这样我们就可以使用较大的学习率来训练网络。
2)提高网络的泛化能力。
3)BN层本质上是一个归一化网络层,可以替代局部响应归一化层(LRN层)。
4)可以打乱样本训练顺序(这样就不可能出现同一张照片被多次选择用来训练)论文中提到可以提高1%的精度。
5、模型过拟合解决方法,为什么提前停止可以解决过拟合问题?
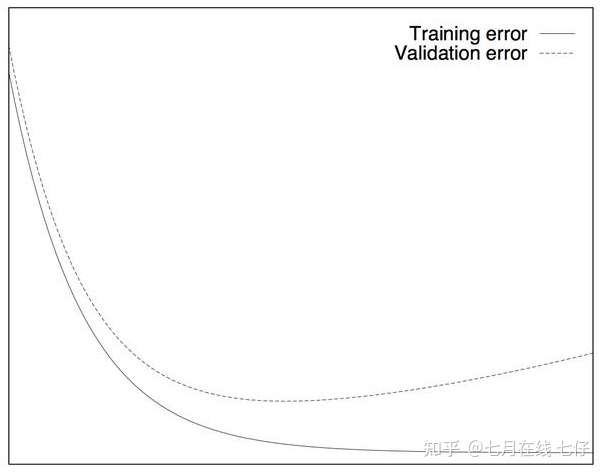
当模型在训练集上表现很好,在验证集上表现很差的时候,则出现了过拟合情况。
降低模型复杂度
增加更多的训练数据:使用更大的数据集训练模型
数据增强
正则化:L1、L2、添加BN层
添加Dropout策略
Early Stopping
早停:在训练中计算模型在验证集上的表现,当模型在验证集上的表现开始下降的时候,停止训练,这样就能避免继续训练导致过拟合的问题。
↓ ↓ ↓以下6本书,电子版,直接送 ↓ ↓ ↓
刚出的《2021年最新大厂AI面试题 Q3版》+《2021年最新大厂AI面试题 Q4版》还没来得及拍照:
相关推荐
阿里滑块算法+阿里滑块识别
在“阿里滑块识别”中,涉及到的技术主要包括计算机视觉、图像处理和深度学习。一、阿里滑块识别的核心技术1.
【必看干货】在我面了10多家大厂(上岸)后,我吐血总结你要是这12道题都不能拿满分,那你就与大厂算法无缘了 ——AI视觉算法工程师
这12题 你敢来应战吗?(个人有精炼的总结,就算不会,也能熟记混过~) 1 简要说明one two stage差别 One-Stage目标检测算法,这类检测算法不需要Region Proposal阶段,可以通过一个Stage直接产生物体的类别概率和位置坐标值,比较典型的算法有YOLO、SSD和CornerNet; Two-Stage目标检测算法 ,这类检测算法将检测问题划分为两个阶段,第一个阶段首先产生候选区域(Region Proposals),包含目标大概的位置信息,然后第二个阶段对候选区域进行分类和位
百度计算机视觉算法工程师面经(research岗,已offer).pdf
这也反映了百度计算机视觉算法工程师的工作需要具备广泛的技术知识和实践经验。
leetcode中文版-Algorithms_Of_Interview:计算机视觉算法工程师面试中手撕代码的算法题总结
leetcode中文版计算机视觉算法工程师面试中手撕代码的算法题总结微软、商汤、旷视、头条、阿里、腾讯、百度、海康威视、第四范式算法岗,其他公司和岗位的不在此之列。开始先大概整理,后面会分类数据结构类
python过阿里X82Y X5SEC滑块UA算法例子2022.6.3
阿里X82Y X5SEC滑块UA算法是阿里云开发的一种特定的安全机制,它结合了滑块验证码和用户代理(User Agent)识别技术。




