

1,472
社区成员
 发帖
 与我相关
 我的任务

 分享
如标题所言,谷歌和k8s,我本次内容将讲述我在k8s学习的过程。自从谷歌开源k8后,各个企业纷纷开始应用到自己的业务种,我们这些开发得益于谷歌也开始获得更高的受益,接下来时自己联系部署k8s时的一写笔记===k8s如美女一样让我着迷,但是又得不到他的亲睐
1 k8s的由来
k8s是由谷歌的Borg系统经GO语言重写并捐献给CNCF基金会开源的
2 k8s的重要作用
k8s 是一个优秀的开源的容器编排框架工具,他可以自动化应用容器的部署,扩展和操作,并且有极其丰富的
周边生态
3 k8s的优势
1 自动装箱,水平扩展,自我修复
2 服务发现和负载均衡
3 自动发布(默认滚动发布模式)和回滚
4 集中化配置管理和密钥管理
5 存储编排
6 任务批处理运行
....................
1 pod
1 pod是k8s里能够被运行的最小的逻辑单元(原子单元)
2 1个pod中可以运行多个容器,容器之间共享UTS+NET+IPC名称空间
3 一个pod里运行多个容器又叫做边车(SideCar)模式
2 POD 控制器
1 pod控制器是pod启动的一组模版,用来保证在k8s中启动的pod始终按照预期运行(副本数,生命周期,
健康状态检查...)
2 k8s内提供了众多的pod控制器,常用的有以下几种
Deployment *****
工作在ReplicaSet之上,用于管理无状态应用,目前来说最好的控制器。支持滚动更新和回
滚功能,还提供声明式配
DaemonSet *****
DaemonSet类型的控制器可以保证集群中的每一台(或指定)节点上都运行一个副本,一
般适用于日志收集、节点监控等场 景。也就是说,如果一个pod提供的功能是节点级别
的(每个节点都需要且只需要一个),那么这类Pod就适合使用DaemonSet 类型的控制器
创建。
DameonSet控制器的特点:
每当向集群中添加一个节点时,指定的pod副本也将添加到该节点
当节点从集群中移除时,pod也就被垃圾回收了
ReplicaSet ****
代用户创建指定数量的pod副本数量,确保pod副本数量符合预期状态,并且支持滚动式自动
扩容和缩容功能
Job:只要完成就立即退出,不需要重启或重建。
Cronjob:周期性任务控制,不需要持续后台运行
StatefulSet:管理有状态应用的
1 Name
1 由于k8s内部,使用"资源"来定义每一种逻辑概念,故每种"资源"都有应该有自己的"name"
2 "资源"有api版本(apiVersion),类别(bind),元数据(metadata),定义清单(spec),状态
(status)等
3 "name"通常定义在"元数据"资源信息里
2 NameSpace
1 随着项目的增多,人员增加,集群规模的扩大,需要一种能够隔离k8s内部各种"资源"的方法,这就是
NameSpace
2 名称空间可以理解为k8s内部的虚拟集群组,不同空间内部"资源"名称可以相同,同一名称空间内部同
总"资源" "名称"不能相同
3 k8s默认存在的名称空间有:default,kube-system,kube-public
4 查询k8s里的特定"资源"要带上相应的名称空间
5 合理的使用名称空间使得集群管理员能够更好的对交付到k8s中的服务进行分类和浏览
1 Label
1 标签是k8s的特色管理方式,便于分类管理资源对象
2 一个标签可以对应多个资源,一个资源也可以有多个标签,他们是多对多的关系
3 一个资源可以通过标签的形式实现不同维度的管理
4 标签的组成方式:key=value(value值长度不能超过63个字节,以字母,数字开头)
5 与标签类似的还有"注解"(annotations),他的长度没有限制
2 Label选择器
1 给资源打标签后可以通过标签选择器过滤指定的标签
2 许多资源(如 matchLabels,matchExpressions)支持内嵌标签选择器字段
3 标签选择器的类型有两个:
1 基于等值关系(等于,不等于)
2 基于集合关系(属于,不属于,存在)
1 Service
1 在k8s中,虽然每个Pod都会被分配一个单独的IP地址,但这个IP会随着Pod的销毁而消失,Service就
是解决这个问题的核心概念
2 一个Service可以看作是一组提供相同服务的Pod的对外访问接口
3 Service作用于哪些Pod是通过标签选择器来定义的
2 Ingress
1 Ingerss是k8s集群里工作在OSI网络模型第七层的应用对外暴露的接口
2 Service 是能进行L4流量调度(IP+port),Ingress可以调度不同业务域,不同URL路径的业务流量
1 Etcd 是通过键值对的方式存储k8s集群的网络配置信息和k8s集群内各种元数据信息
2 Etcd是一个独立的服务组件,并不隶属于K8S集群。生产环境当中etcd应该以集群方式运行,以确保服务
的可用性。
3 Etcd不仅仅用于提供键值数据存储,而且还为其提供了监听(
watch)机制,用于监听和推送变更。在K8S
集群系统中,当Etcd中数据发生变化 时,etcd会快速地通知kube-apiServer,并由其通过watch
API向客户端输出。
1 kube-apiserver服务
1 提供基于HTTP/HTTPS 的集群管理的REST API(包括鉴权,数据校验及集群状态变更)。
2 负责其他模块之间的数据交互,所有的请求都需要经过这个接口进行通信,主要负责接收、校验并响应
所有的REST请求,结果状态被持久存储 在etcd当中,所有资源增删改查的唯一入口。
3 提供了完备的集群安全机制
2 Controller Manager
1 由一系列控制器组成,主要包括包括replication controller、endpoints controller、
namespace controller、 serviceaccounts controller等,
2 通过apiserver监控整个集群的状态,并确保集群处于预期的工作状态(Namespace创建和生命周期、
Node垃圾回收 Pod扩展等)
3 调度器(Schedule)
1 通过调度算法为待调度Pod列表的每个Pod从Node列表中选择一个最适合的Node,并将信息写入etcd
中
2 Schedule预选策略(predict)
即遍历所有目标Node,筛选出符合要求的候选节点,kubernetes内置了多种预选策略(xxx
Predicates)供用户选择
3 chedule优选策略(priorities)
LeastRequestedPriority 优先从备选节点列表中选择资源消耗最小的节点(CPU+内
存)
CalculateNodeLabelPriority 优先选择含有指定Label的节点
BalancedResourceAllocation 优先从备选节点列表中选择各项资源使用率最均衡的节点。
1 kubelet
1 kubelet主要功能就是定时获取到节点上pod的期望状态(运行什么容器,运行副本数,网络活着存储怎
么配置等等)并调用对应的容器平台接 达到这个状态
2 定时汇报当前节点的状态给apiserver,以供调度的时候使用
3 镜像和容器的清理工作,保证节点上的镜像和容器不会占满磁盘空间,退出的容器不会占用太多资源
2 Kube-proxy
1 k8s在每个节点上运行网络代理,service资源的载体
2 建立pod网络和集群网络的关系(ClusterIP-->PodIP)
3 负责建立和删除及更新调度规则,通知apiserver自己的更新或从apiserver处获取其他kube-
proxy的调度规则变化来更新自己的
4 常用的三种流量调度方式
userspace (已废弃)
Iptables (频临废弃)
Ipvs (强烈推荐)
1 服务发现插件 coredns
2 CNI网络插件 flannel/calico
3 服务暴露插件 traefik
4 GUI管理插件 Dashboard
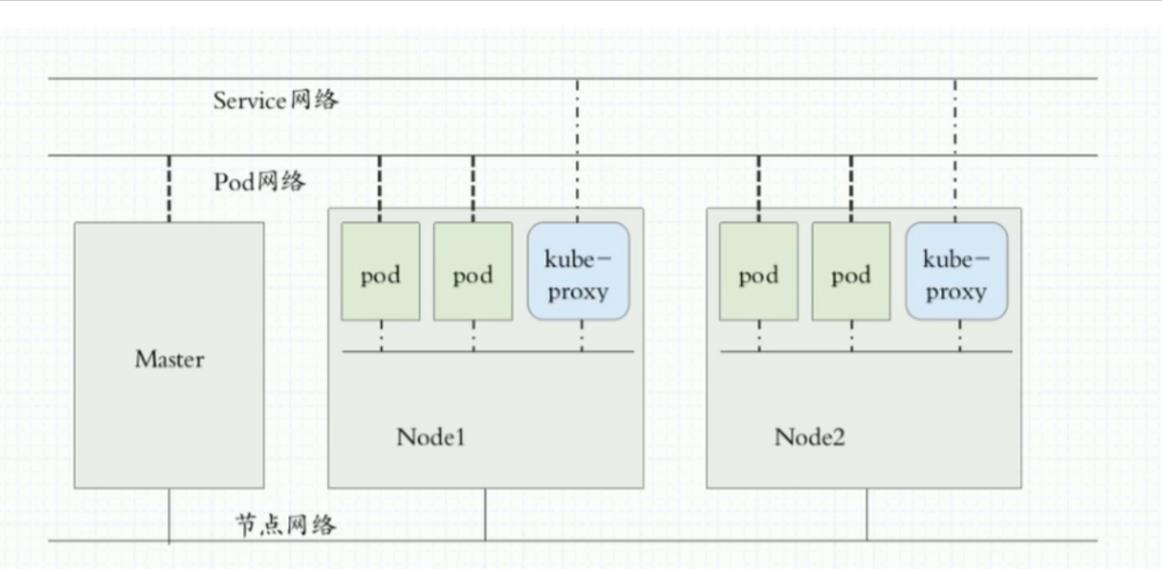
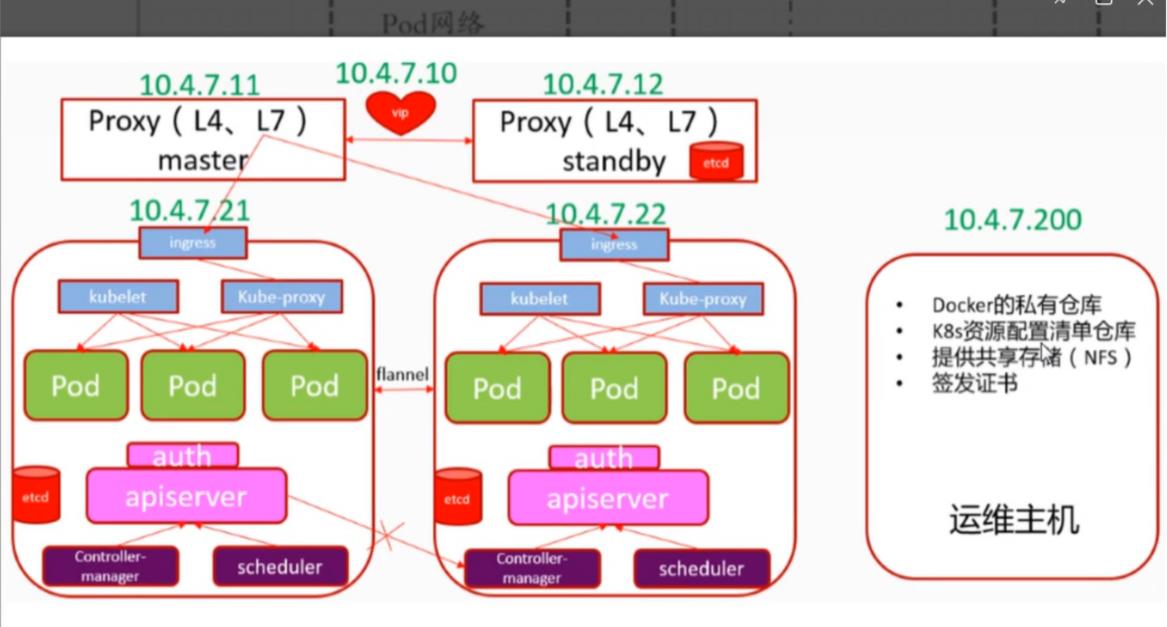
1 节点网络IP: node1: 10.4.7.21,node2: 10.4.7.22
2 serviceIP段: 192.168.0.16
3 PodIP段: node1: 172.7.21.0/24,node2:172.7.22.0/24
注意:
生产中PodIP段一定要看起来一眼都能知道他在哪个node节点上运行,方便维护
注意
etcd采用投票的方式实现高可用机制,所以生产中一定要保证奇数个etcd节点
工作流程(以常规的 Deployment 创建过程):
1 Kubectl 以 Deployment 的 YAML 文件或命令行操作创建一个 Deployment。
2 Kubectl 会把请求发给 API Server。API Server 接收到请求之后,经过一定的验证(验证信息
是从 Kubectl 的 kubeconfig 里面提交上来的)会把这些信息会存入 etcd。
3 etcd 存储完 Deployment 的信息之后,Controller Manager 里的 Deployment
Controller 会 get 到这个信息,并创建对应的 ReplicaSet。
4 Controller Manager 中的 ReplicaSet Controller watch 到这个信息之后,会创建对应的
Pod 资源。
5 Scheduler 会对每个集群的节点进行打分操作以选择最合适的节点,并把这个节点的信息绑定到
Pod 资源上。
6 这时候 node 节点上运行的 Kubelet 通过请求 API Server 会得到创建对应 Pod 的任务,
Kubelet 会把 Pod 启动需要的 volume 等依赖提前挂载起来。
7 之后 Docker 或 Containerd 等 runtime 会去拉起对应的容器,这个流程相当于把一个
Deployment 真正创建起来了。
8 Kube-Proxy 这个组件主要负责当前节点上的网络路由等配置,有两种部署模式:
iptables 模式:使用 iptables 分发的路由规则
IPVS 模式:使用内核的 IPVS 路由功能
1 Minikube k8s官网提供的单节点微型k8s,仅供学习,预览
2 二进制安装部署(安装麻烦,方便后期维护,生产手选)
3 使用kubeadmin进行部署(k8s的部署工具,跑在k8s中),相对简单,推荐老手使用

文章很有学识
写的很好,我爱看


很好,我爱看

写的很好,下次接着写

# 666

很好,我爱看


