

 南通大学-Python程序设计

2022(秋)实验三:爬虫图片
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
1 实验目的
- 理解抓取网页的含义和URL基本构成;
- 掌握类和函数及模块的设计与实现;
- 掌握网络爬虫原理。
2 实验内容
本实验将利用python程序抓取网络图片,完成可以批量下载一个网站的照片。所谓网页抓取,就是把URL地址中指定的网络资源从网络流中读取出来,保存到本地。
3 实验知识点
- Python基本语法;
- 网络爬虫基本原理;
- 解析HTML页面及URL;
- 爬取Web页面;
- 使用正则表达式提取关键信息对内容进行过滤。
4 实验时长
8学时。
5 实验环境
- python3;
- Spyder。
6 实验过程
6.1 原理探究
1、网络爬虫
即Web Spider,网络蜘蛛是通过网页的链接地址来寻找网页的。从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页都抓取完为止。
网络爬虫的基本操作是抓取网页。
2、浏览网页过程
抓取网页的过程其实和读者平时使用浏览器浏览网页的道理是一样的。打开网页的过程其实就是浏览器作为一个浏览的“客户端”,向服务器端发送了 一次请求,把服务器端的文件“抓”到本地,再进行解释、展现。浏览器的功能是将获取到的HTML代码进行解析,然后将原始的代码转变成我们直接看到的网站页面。
URL的格式由三部分组成:
- 第一部分是协议(或称为服务方式)。
- 第二部分是存有该资源的主机IP地址(有时也包括端口号)。
- 第三部分是主机资源的具体地址,如目录和文件名等。
第一部分和第二部分用“://”符号隔开,
第二部分和第三部分用“/”符号隔开。
第一部分和第二部分是不可缺少的,第三部分有时可以省略。
爬虫最主要的处理对象就是URL,它根据URL地址取得所需要的文件内容,然后对它 进行进一步的处理。
因此,准确地理解URL对理解网络爬虫至关重要。
3、利用urllib2通过指定的URL抓取网页内容
在Python中,我们使用urllib2这个组件来抓取网页。
urllib2是Python的一个获取URLs(Uniform Resource Locators)的组件。
它以urlopen函数的形式提供了一个非常简单的接口。
4、HTTP的异常处理问题
当urlopen不能够处理一个response时,产生urlError。
不过通常的Python APIs异常如ValueError,TypeError等也会同时产生。
HTTPError是urlError的子类,通常在特定HTTP URLs中产生。
5、Timeout 设置(超时设置)
在Python2.6前,urllib2 的 API 并没有暴露 Timeout 的设置,要设置 Timeout 值,只能更改 Socket 的全局 Timeout 值。在 Python 2.6 以后,超时可以通过 urllib2.urlopen() 的 timeout 参数直接设置。
6.2 项目结构
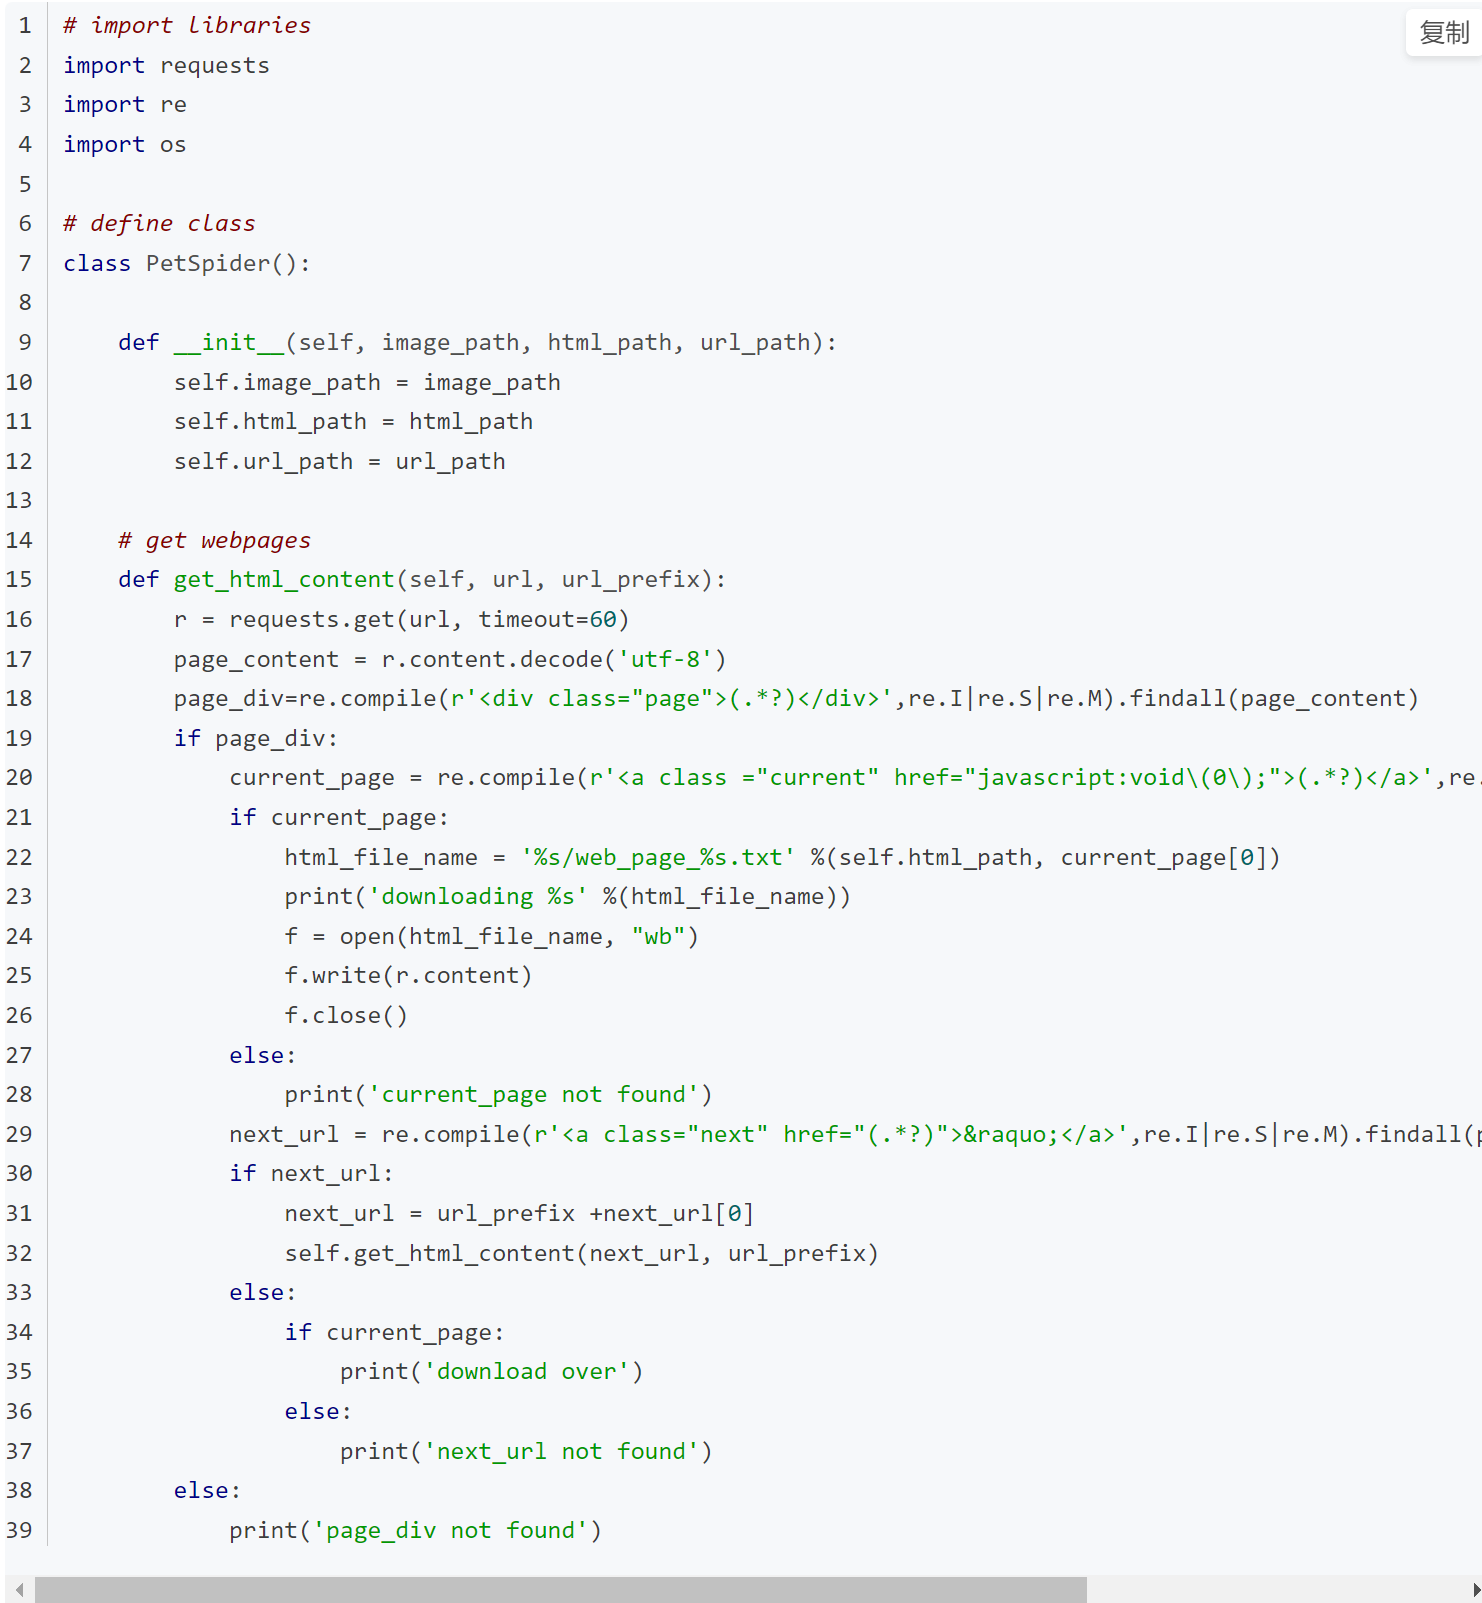
项目包含两个文件,pet_spider.py和main_file.py。其中pet_spider.py文件定义了类PetSpider,包含3个方法分别是get_html_content下载网页源代码、get_urls获得网页图片urls、 download_images下载图片。main_file.py文件定义了主函数main,用于调用PetSpider类。
6.3 根据给定的网址来获取网页源代码
根据给定的网址来获取网页详细信息,得到的html就是网页的源代码。
get_html_content函数主要功能是递归下载网页源代码。注意将byte类型转换成string类型,其中re.findall的含义是返回string中所有与pattern(正则表达式)相匹配的全部字串,返回形式为数组。
新建pet_spider.py。
首先实现获取网页源代码的函数:
6.4 从网页源代码中过滤所有图片urls
获取网页源代码后,从网页源代码中匹配过滤图片的urls,制作进度条,从文件中读出网页图片内容,最后将所有urls写入文件。
继续向pet_spider.py文件中添加如下代码:
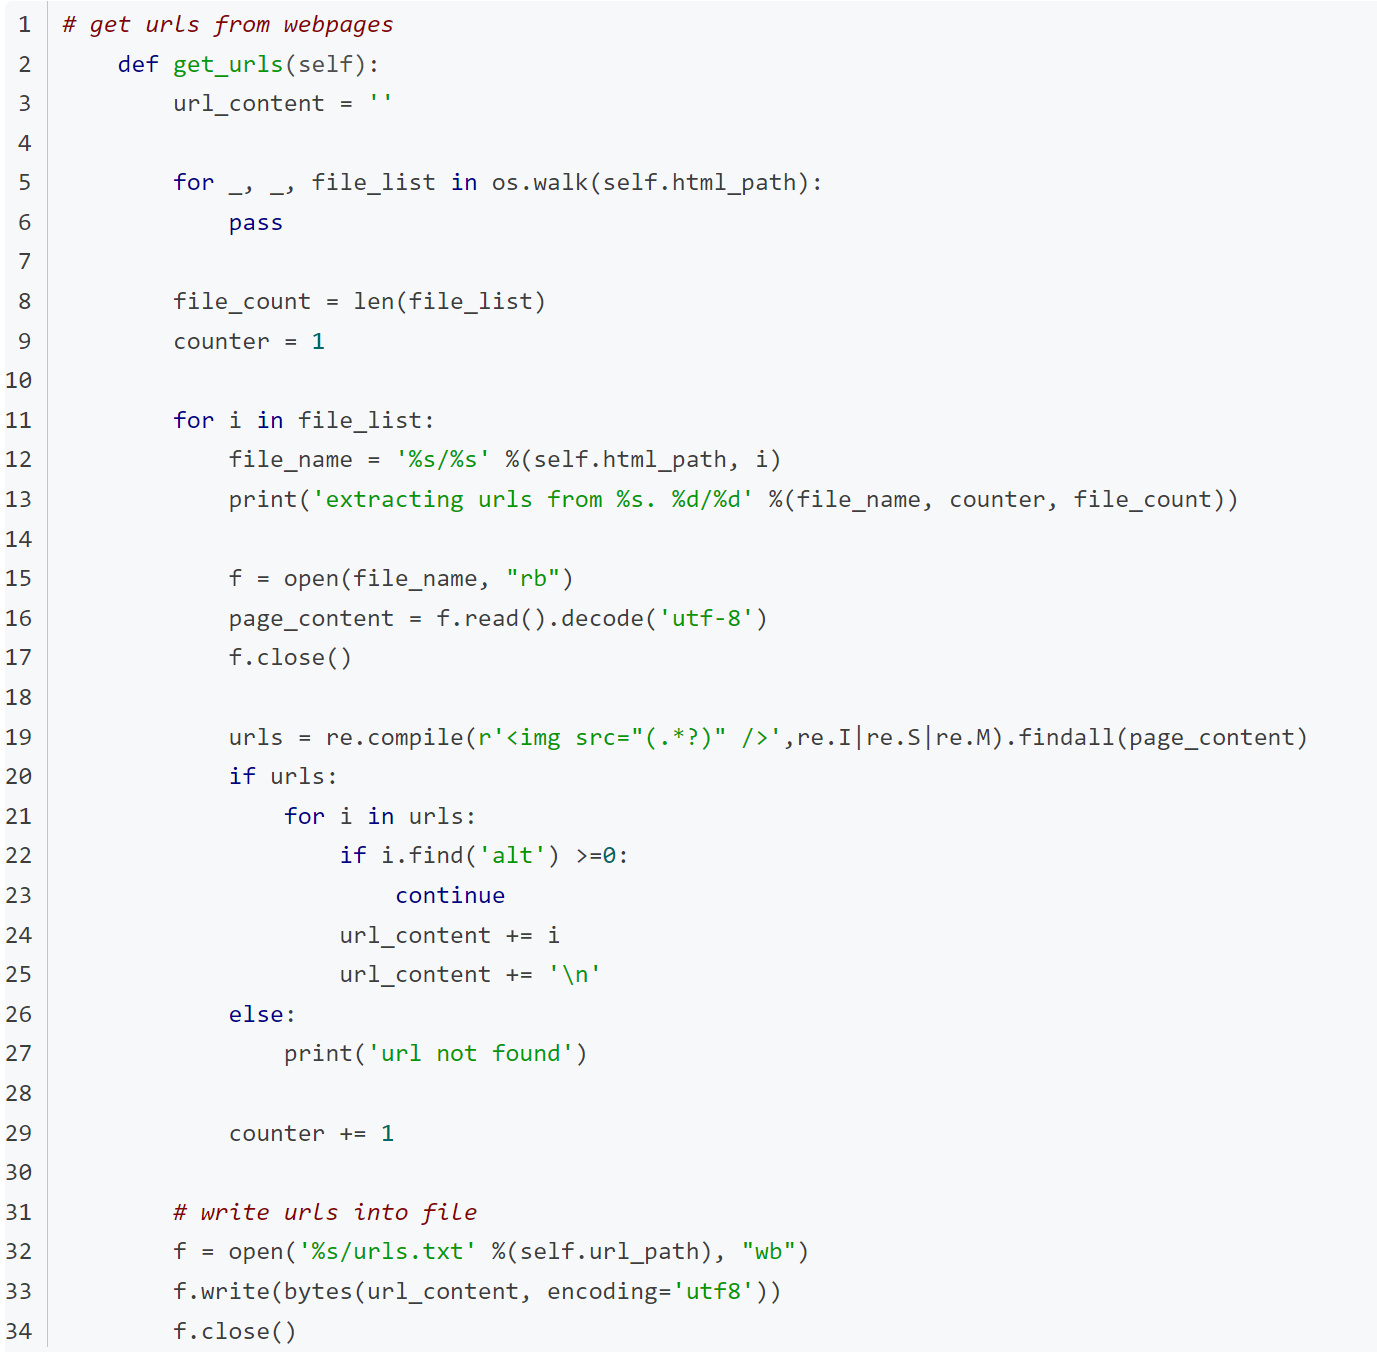
现将所有图片url过滤出来。
6.5 将图片下载保存在本地
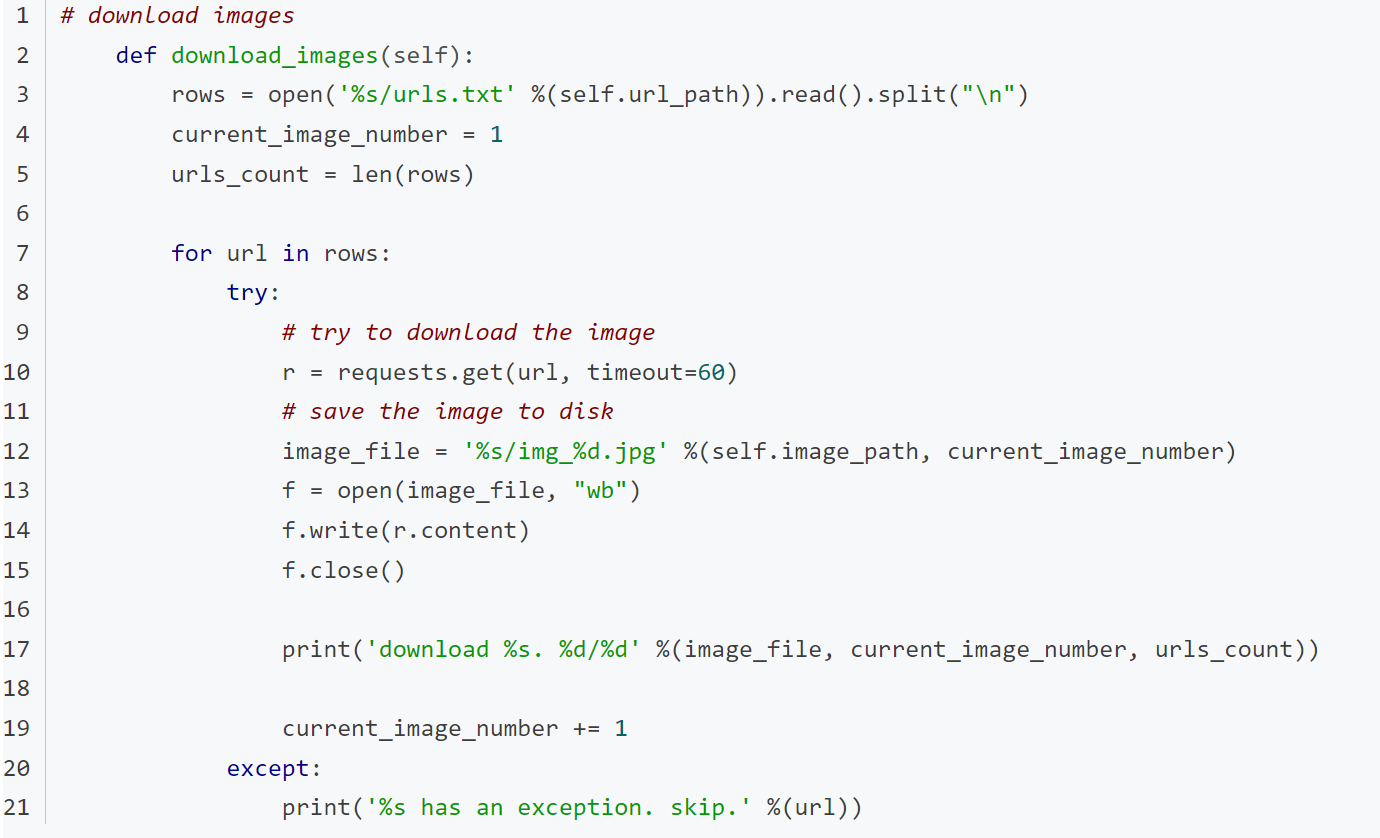
将图片下载到本地,首先将urls字符串保存到列表中,遍历列表中的urls,将下载的图片保存在文件中。
继续向pet_spider.py文件中添加如下代码:
6.6 主函数
新建main_file.py文件。代码如下:
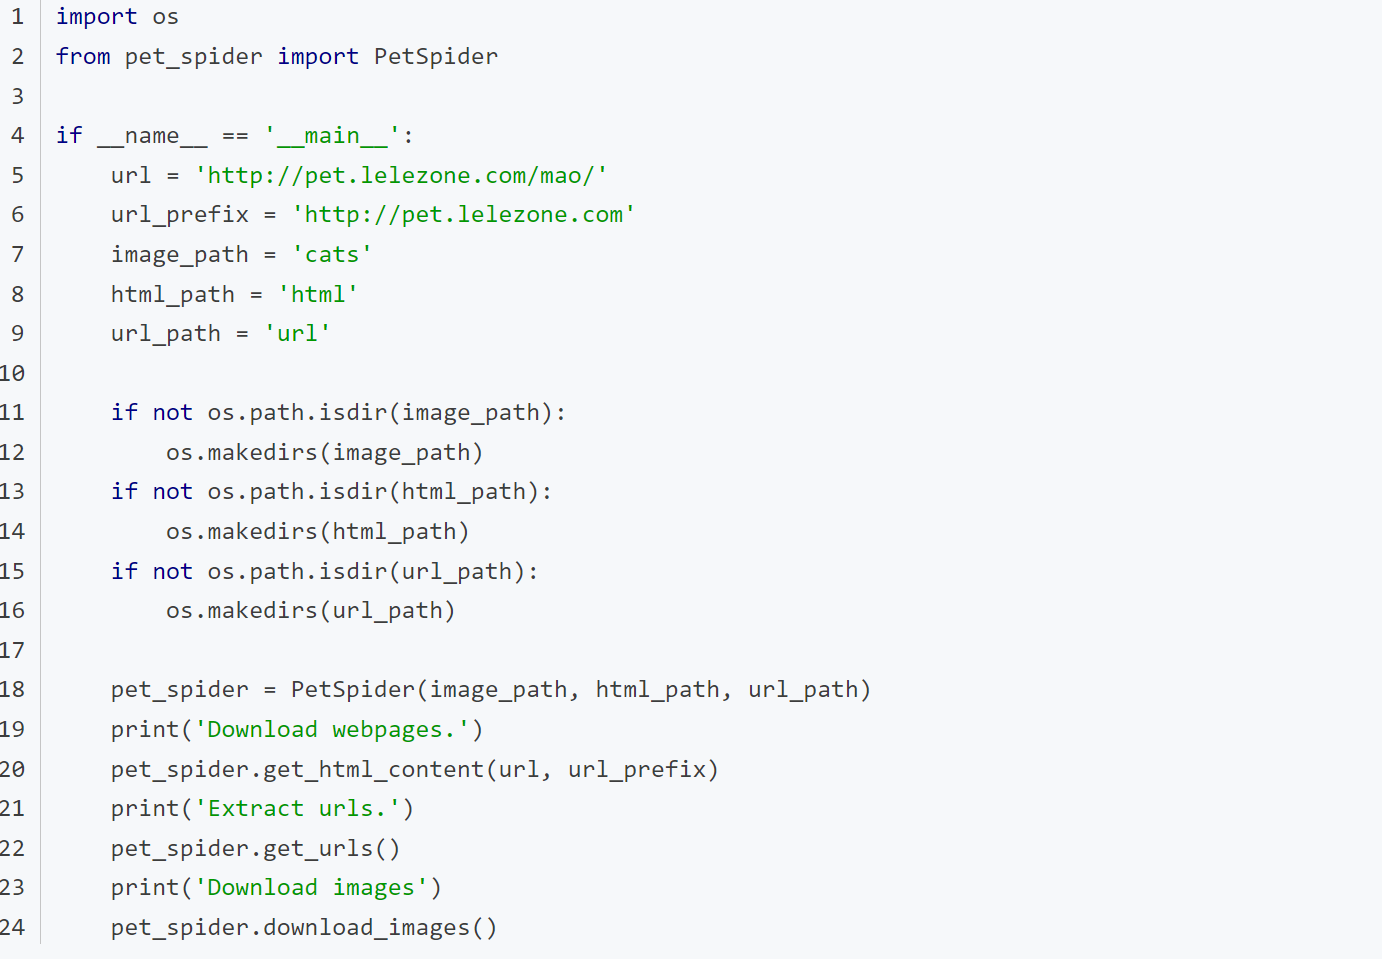
最后运行主函数实现图片爬虫。
相关推荐
基于Python专业网络爬虫的设计与实现
"基于Python专业网络爬虫的设计与实现"本文主要探讨了如何利用Python进行专业网络爬虫的设计与实现,以解决传统搜索引擎存在的返回结果不精确等问题。网络爬虫,通常被称为网页蜘蛛或网络机器人,
基于Java实现的HTTP解析器网络爬虫项目解析
网络爬虫,也称为网络蜘蛛、网络机器人,是一种自动化抓取互联网信息的脚本程序。它们根据设定的规则,访问网络上的网页,提取数据,最终形成结构化的数据集合。网络爬虫技术广泛应用于搜索引擎、数据挖掘、市场分析、学术研究等领域。在众多的HTTP解析器中,Java开发者们通常会优先选择一些成熟且稳定的库。这些库因其强大的功能、良好的性能和社区支持而受到青睐。本节将对几个流行的Java HTTP解析器进行比较分析。
抓取图片(网络爬虫)
网络爬虫可以理解为一种在网页间自动游走,收集所需信息的工具。以下是对这一主题的详细解释:首先,我们要了解网络爬虫的基本工作原理。爬虫通常由以下几个主要部分组成:URL管理器、下载器和解析器。
《Python网络爬虫》实验报告六.docx
三、结论在本实验中,我们学习了使用 Python 语言来实现网络爬虫的功能,并抓取学习强国下学习金句的内容。
C#网络爬虫程序源码
网络爬虫,又称网页蜘蛛或网络机器人,是互联网上的一种自动化程序,能够按照一定的规则遍历网站,收集网页内容,通常用于数据分析、搜索引擎索引等用途。




