

 南通大学-Python程序设计












2022(秋)实验三:爬虫图片
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
1 实验目的
- 理解抓取网页的含义和URL基本构成;
- 掌握类和函数及模块的设计与实现;
- 掌握网络爬虫原理。
2 实验内容
本实验将利用python程序抓取网络图片,完成可以批量下载一个网站的照片。所谓网页抓取,就是把URL地址中指定的网络资源从网络流中读取出来,保存到本地。
3 实验知识点
- Python基本语法;
- 网络爬虫基本原理;
- 解析HTML页面及URL;
- 爬取Web页面;
- 使用正则表达式提取关键信息对内容进行过滤。
4 实验时长
8学时。
5 实验环境
- python3;
- Spyder。
6 实验过程
6.1 原理探究
1、网络爬虫
即Web Spider,网络蜘蛛是通过网页的链接地址来寻找网页的。从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页都抓取完为止。
网络爬虫的基本操作是抓取网页。
2、浏览网页过程
抓取网页的过程其实和读者平时使用浏览器浏览网页的道理是一样的。打开网页的过程其实就是浏览器作为一个浏览的“客户端”,向服务器端发送了 一次请求,把服务器端的文件“抓”到本地,再进行解释、展现。浏览器的功能是将获取到的HTML代码进行解析,然后将原始的代码转变成我们直接看到的网站页面。
URL的格式由三部分组成:
- 第一部分是协议(或称为服务方式)。
- 第二部分是存有该资源的主机IP地址(有时也包括端口号)。
- 第三部分是主机资源的具体地址,如目录和文件名等。
第一部分和第二部分用“://”符号隔开,
第二部分和第三部分用“/”符号隔开。
第一部分和第二部分是不可缺少的,第三部分有时可以省略。
爬虫最主要的处理对象就是URL,它根据URL地址取得所需要的文件内容,然后对它 进行进一步的处理。
因此,准确地理解URL对理解网络爬虫至关重要。
3、利用urllib2通过指定的URL抓取网页内容
在Python中,我们使用urllib2这个组件来抓取网页。
urllib2是Python的一个获取URLs(Uniform Resource Locators)的组件。
它以urlopen函数的形式提供了一个非常简单的接口。
4、HTTP的异常处理问题
当urlopen不能够处理一个response时,产生urlError。
不过通常的Python APIs异常如ValueError,TypeError等也会同时产生。
HTTPError是urlError的子类,通常在特定HTTP URLs中产生。
6.2 项目代码
代码提供的网站没了,就随便写了一个爬虫,看看就好,问题很多,不提供测试网站
import requests
import re
import time

class sinffer():

    def __init__(self,url,pic_path,download_url,re_func,download_format,get_augment=None):
        self.url = url
        self.pic_path = pic_path
        self.dtu = download_url
        self.pic_list = set()
        self.re_func = re_func
        self.download_format = download_format
        self.s = requests.session()
        self.get_augment = get_augment
        self.download_url_list = set()

    def Get_Pic_CT(self):
        round = 5
        r = self.s.get(self.url)
        syntax = re.compile(self.re_func,re.I|re.S|re.M)
        list_pics_tmp = syntax.findall(r.text)
        self.pic_list.update(set(list_pics_tmp))
        if self.get_augment != None:
            while round !=1 :
                time.sleep(0.5)
                r = self.s.get(self.url+self.get_augment+str(round))
                print(self.url+self.get_augment+str(round))
                list_pics_tmp = syntax.findall(r.text)
                self.pic_list.update(set(list_pics_tmp))
                round = round - 1

    def get_url_of_pic(self):
        syntax_download = re.compile(self.download_format,re.I|re.S|re.M)
        for i in self.pic_list:
            try:
                download_url = self.dtu + i
                r = syntax_download.findall(self.s.get(download_url).text)
                if len(r) != 0:
                    self.download_url_list.add(r[0])
                time.sleep(0.5)
            except :
                print('some Thing Wrong when download %s,skip'%i)
    def download_image(self):
        time.sleep(1)
        n = 1
        for i in self.download_url_list:
            try:
                with open('%s/%s.%s'%(self.pic_path,str(n),i[-3:]),'wb') as f:
                    r = self.s.get(i).content
                    f.write(r)
                    f.close()
                n = n+1
            except:
                print('some Thing Wrong when download %s,skip'%i)
#src=""
if __name__=='__main__':

    url = '' #不提供
    pic_path = 'pic'
    download_url = '' #不提供
    re_fun = r'' #不提供
    download_format = r'' #不提供
    get_augment = '' #不提供
    t = sinffer(url, pic_path, download_url,re_fun,download_format,get_augment=get_augment)
    t.Get_Pic_CT()
    t.get_url_of_pic()
    t.download_image()
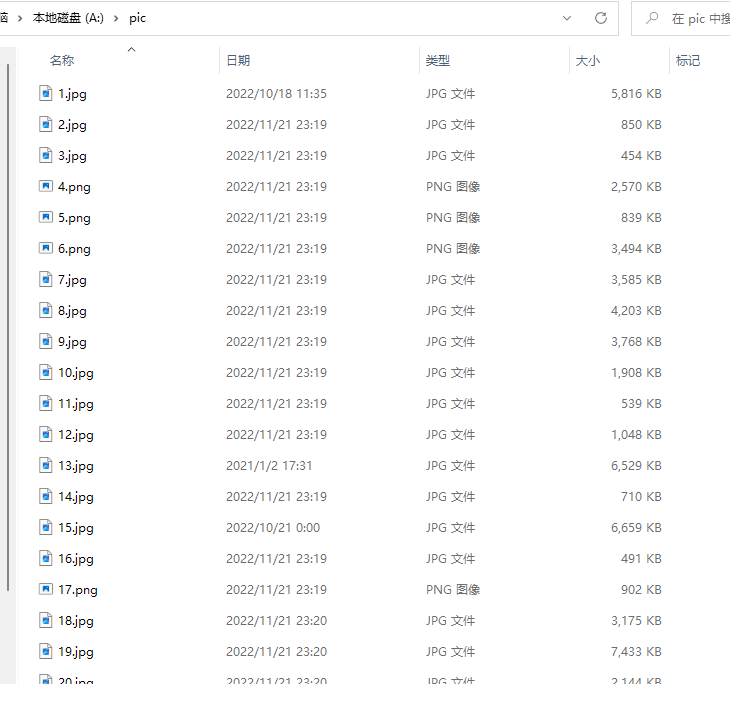
结果如下,仅作参考
相关推荐
基于Python专业网络爬虫的设计与实现
】网络爬虫,又称网页蜘蛛、网络机器人。随着计算机技术的高速发展,互联网中 的信息量越来越大,搜索引擎应运而生。传统的搜索引擎会有返回结果不精确等局限性。 为了解决传统搜索引擎的局限性,专用型网络爬虫在互联网中越来越常见。同时,专用型 网络爬虫具有专用性,可以根据制定的规则和特征,最后只体现和筛选出有用的信息。
基于Java实现的HTTP解析器网络爬虫项目解析
网络爬虫,也称为网络蜘蛛、网络机器人,是一种自动化抓取互联网信息的脚本程序。它们根据设定的规则,访问网络上的网页,提取数据,最终形成结构化的数据集合。网络爬虫技术广泛应用于搜索引擎、数据挖掘、市场分析、学术研究等领域。在众多的HTTP解析器中,Java开发者们通常会优先选择一些成熟且稳定的库。这些库因其强大的功能、良好的性能和社区支持而受到青睐。本节将对几个流行的Java HTTP解析器进行比较分析。
抓取图片(网络爬虫)
能够大量的抓取图片,算法也比较容易理解,能很快的改成自己的。
《Python网络爬虫》实验报告六.docx
《Python网络爬虫》实验报告六.docx
C#网络爬虫程序源码
网上找的一个C#写的网络爬虫程序源码,支持多线程,上传上来方便自己查看,有需要的朋友可以直接拿去参考,呵呵~~~谢谢作者。




