

 广工软件工程课程学习

个人项目作业-论文查重(作业补交)
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
1.作业信息
simHash算法共有5个步骤:分词、hash、加权、合并、降维
- 关键函数
main.py里有四个函数:- 1.def getWords(text) —— 分词
- 2.def getSimh(s) —— hash、加权、合并、降维
- 3.def getSimilarity(simh1, simh2) —— 计算海明距离和相似度
- 4/def main_project() —— 主函数入口
- 5.def test() —— 测试接口
simHash算法:首先文本的内容经过splitWords函数进行分词操作,之后getSimh函数计算分词过后文本的hash值,并进行
加权、合并和降维操作,最后通过调用getSimilarity函数,其中以getSimh处理过后的hash值作为传参,得到海明距离,从而
计算出相似度。
simHash算法的独特之处在于,相较于其他传统的hash算法,simHash算法计算出两个文本之间的hash值差距比较小,这样能够
更加精确的计算出文本之间的相似度。
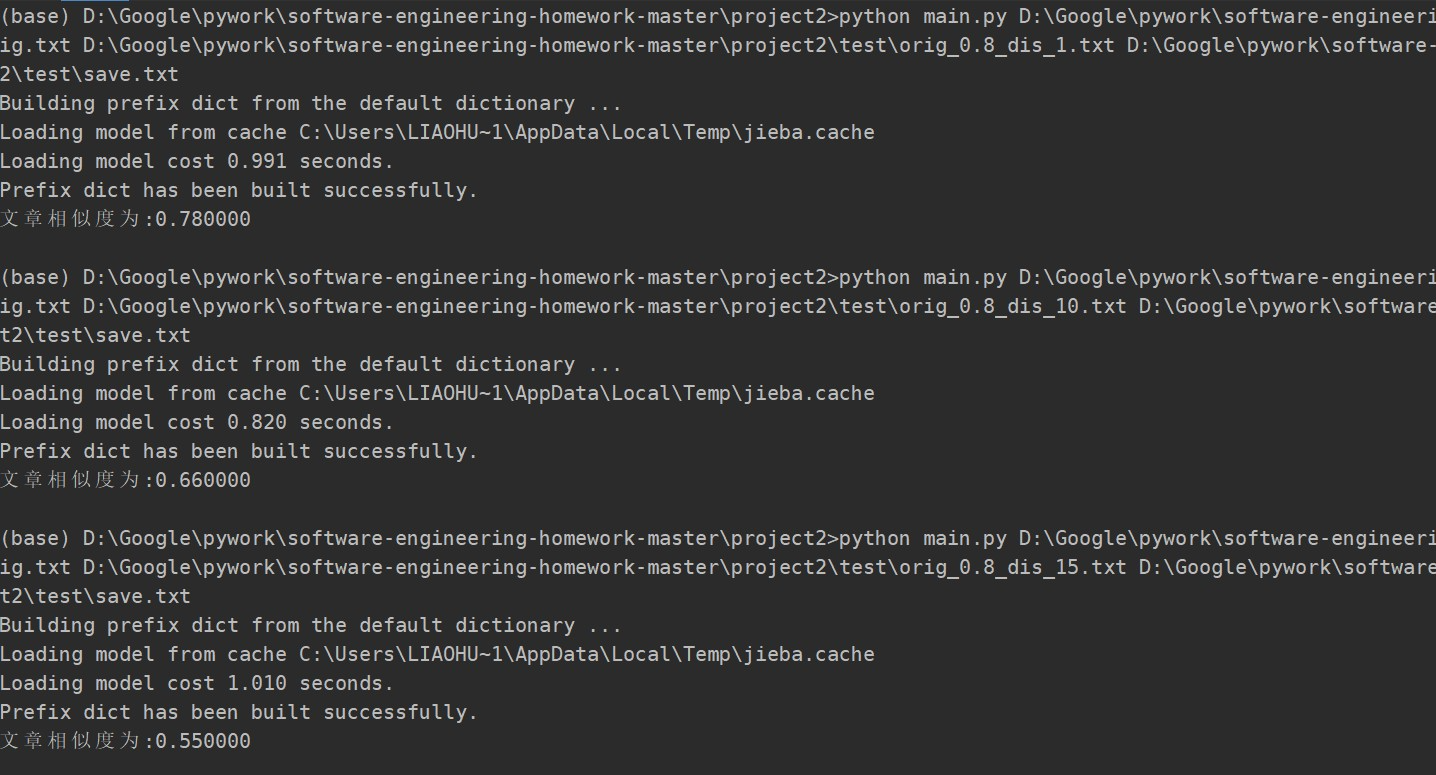
- 命令行测试
格式:python main.py [原文文件] [抄袭版论文的文件] [答案文件]
4. 计算模块接口部分的性能改进
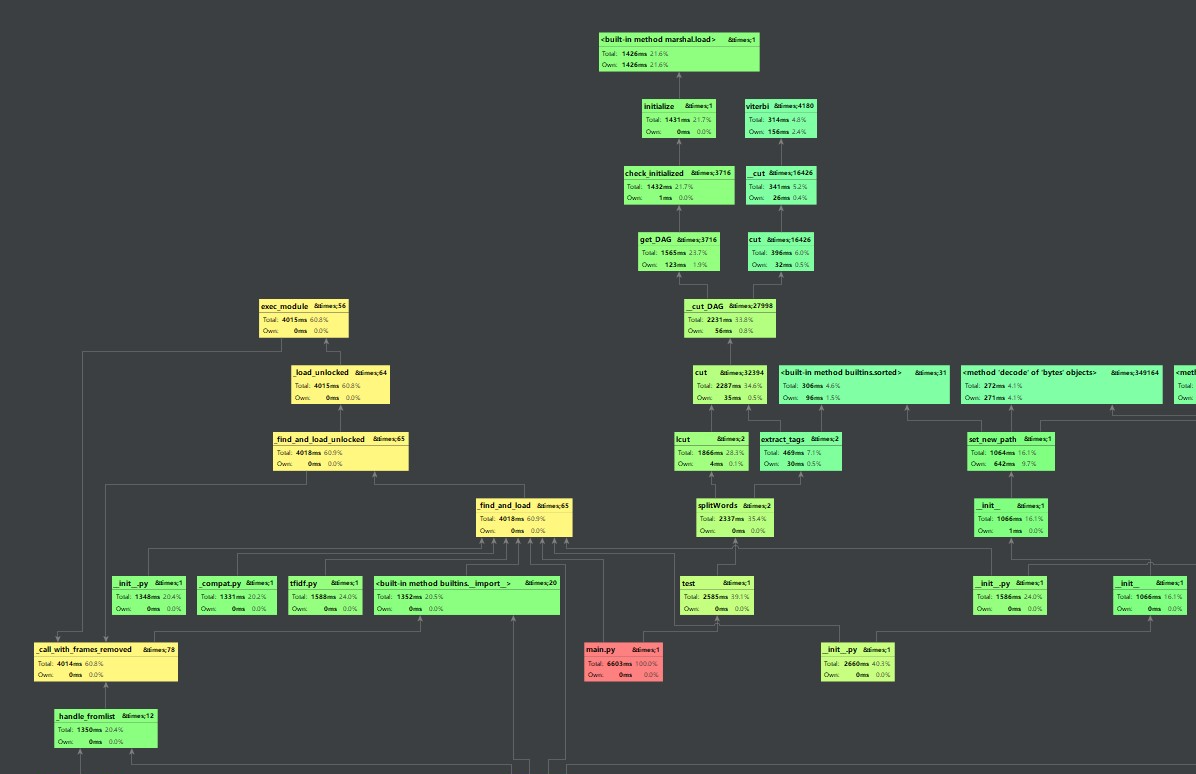
- 性能分析
使用profile方法进行性能分析
- 性能改进
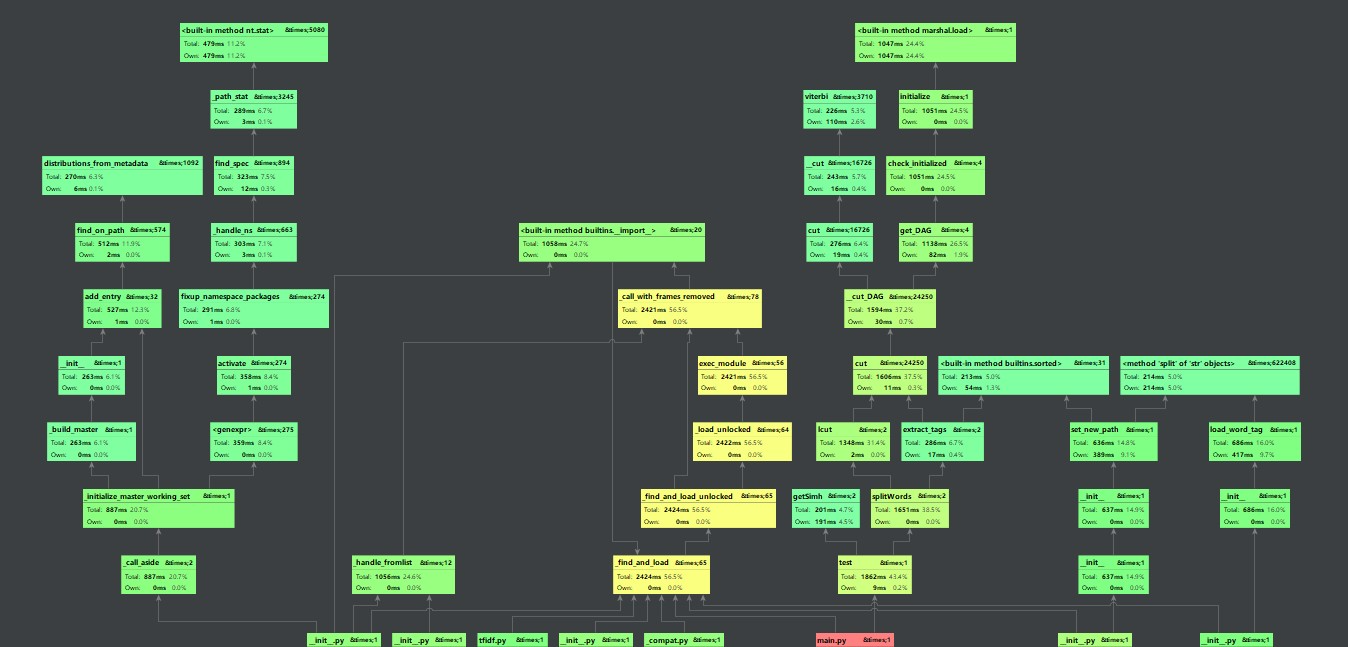
其中getWords函数耗时最多,则用正则表达式匹配过滤对其改进
原始代码:
def getWords(text):
    with open(text, 'r', encoding='UTF-8') as f1:
        f2 = f1.read()   f1.close()
    length = len(list(jieba.lcut(f2)))
    s = jieba.analyse.extract_tags(f2, topK=length)
改进代码:
def getWords(text):
    with open(text, 'r', encoding='UTF-8') as f1:

        f2 = f1.read()
    pattern = re.compile(u"[^a-zA-Z0-9\u4e00-\u9fa5]")
    s = pattern.sub("", f2)
    f1.close()
    length = len(list(jieba.lcut(s)))
    string = jieba.analyse.extract_tags(s, topK=length)
先用正则表达式匹配过滤,再用jieba.lcut来处理,提高效率。从结果可知,改进后的算法较之前的算法提升了几百ms。
5. 单元测试
构建一个test()函数用来专门测试,然后构建一个test.py文件,定义一个testSimHash测试类,测试的方法提供至少10个,具体的代码如下所示:
- test()函数代码
def test():
    path1 = input("请输入论文原文的路径:")
    path2 = input("请输入抄袭论文的路径:")
    path3 = 'save.txt'
    simhash1 = getSimh(splitWords(path1))
    simhash2 = getSimh(splitWords(path2))
    s1 = getSimilarity(simhash1, simhash2)
    s2 = round(s1, 2)
    print('文章相似度为:%f' % s2)
    with open(path3, 'a', encoding='utf-8')as f:
        f.write(path2 + '与原文的相似度为:')
        f.write(json.dumps(s2, ensure_ascii=False) + '\n')
    return s2
- testSimHash类代码
 class testSimHash(unittest.TestCase):
   def test_1(self):
       self.assertEqual(test(), 0.70)

   def test_2(self):
       self.assertEqual(test(), 0.71)

   def test_3(self):
       self.assertEqual(test(), 0.79)

   def test_4(self):
       self.assertEqual(test(), 0.65)

   def test_5(self):
       self.assertEqual(test(), 0.55)

   def test_6(self):
       self.assertEqual(test(), 0.30)

   def test_7(self):
       self.assertEqual(test(), 0.35)

   def test_8(self):
       self.assertEqual(test(), 0.85)

   def test_9(self):
       self.assertEqual(test(), 0.77)

   def test_10(self):
       self.assertEqual(test(), 0.89)
- 测试结果
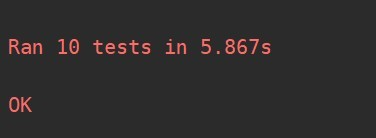
- 代码测试覆盖率
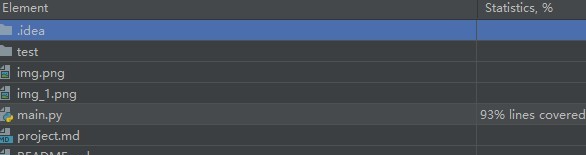
6. 异常处理
- 在命令行以“python main.py [原文文件] [抄袭版论文的文件] [答案文件]”的格式运行程序不会出错,但在pycharm中运行报错。
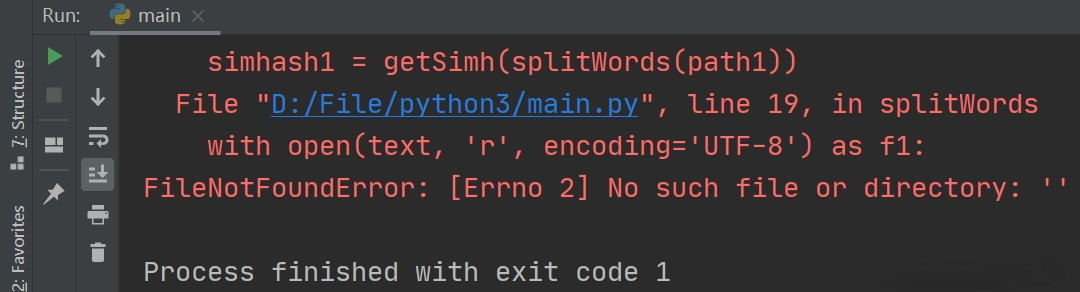
原因:在读取指定文件时,文件路径不存在,程序出现异常。
解决方法:用input()语句接收输入,一段时间后未输入则跳出,并引入os.path.exists()方法用于检验文件是否存在,若不存在则做出响应并且结束程序。
代码修改如下:
def test():
    path1 = ','.join(sys.argv[1:2])
    path2 = ','.join(sys.argv[2:3])
    path3 = ','.join(sys.argv[3:])
+    if not os.path.exists(path1):
+       print("论文原文不存在!")
+       exit()
+   if not os.path.exists(path2):
+       print("抄袭论文不存在!")
+       exit()
    simhash1 = getSimh(splitWords(path1))
    simhash2 = getSimh(splitWords(path2))
    s1 = getSimilarity(simhash1, simhash2)
    s2 = round(s1, 2)
    print('文章相似度为:%f' % s2)
    with open(path3, 'a', encoding='utf-8')as f:
        f.write(path2 + '与原文的相似度为:')
        f.write(json.dumps(s2, ensure_ascii=False) + '\n')
    return s2
修改后程序正常运行:

6. PSP
| PSP2.1 | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | 30 | 10 |
| Estimate | 估计这个任务需要多少时间 | 2220 | 2060 |
| Development | 开发 | 1200 | 1000 |
| Analysis | 需求分析 (包括学习新技术) | 240 | 360 |
| Design Spec | 生成设计文档 | 60 | 30 |
| Design Review | 设计复审 | 30 | 50 |
| Coding Standard | 代码规范 (为目前的开发制定合适的规范) | 30 | 30 |
| Design | 具体设计 | 60 | 30 |
| Coding | 具体编码 | 200 | 240 |
| Code Review | 代码复审 | 60 | 30 |
| Test | 测试(自我测试,修改代码,提交修改) | 120 | 80 |
| Reporting | 报告 | 90 | 90 |
| Test Repor | 测试报告 | 60 | 80 |
| Size Measurement | 计算工作量 | 10 | 10 |
| Postmortem & Process Improvement Plan | 事后总结, 并提出过程改进计划 | 60 | 30 |
| 合计 | 2220 | 2060 |
相关推荐
JAVA论文查重
在IT行业中,尤其是在学术界,论文查重是一个重要的环节,旨在确保研究成果的原创性和学术诚信。本项目聚焦于“JAVA论文查重”,采用余弦相似性算法来实现这一功能。
降低论文查重,来自知乎大神(转载)
#### 六、后期优化技巧在后期修改论文时,应避免仅仅删除标红的句子或词语,而应该考虑整段删除并重新构建新的内容。此外,还可以通过增加个人原创内容的方式进一步降低查重率。
论文查重工具
**学术诚信**:使用查重工具不仅是确保论文质量,更是维护学术诚信的重要手段。抄袭不仅会损害个人学术声誉,还可能受到学术机构的严厉处罚。8.
论文查重软件
针对标题“论文查重软件”和描述中提到的免费毕业论文查重工具,我们来详细探讨一下这个领域的相关知识点。1.
论文查重以及修改软件.zip
标题中的“论文查重以及修改软件.zip”指出这是一个包含用于检查和修改论文的软件工具的压缩包。在学术界,论文查重是非常重要的一个环节,它可以帮助作者确保自己的作品不包含抄袭的内容。




