

 中国高校计算机教学社区

【Python】2023.2.3_第四天打卡——矩阵相乘(读取+相乘+打印)、自行车停放(list、链表)、class实现学生成绩小系统
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
1.矩阵相乘

问题分析
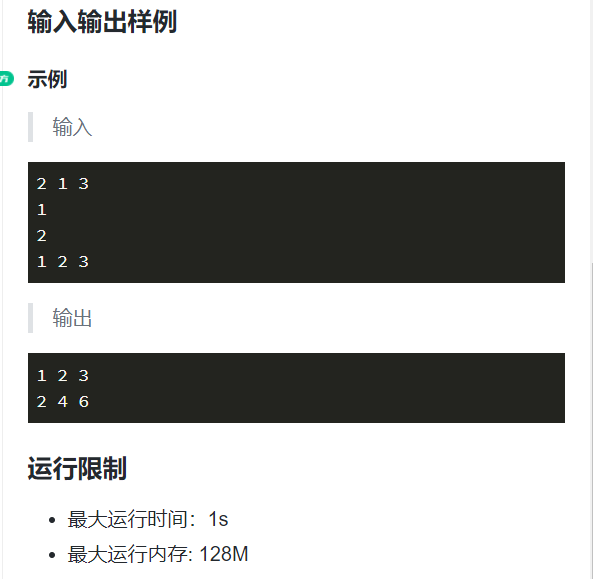
题目很简单,就是让我们用Python实现矩阵相乘的读取、相乘和打印。
我的思路
首先实现读取n,m,k为了实现n*m和m*k,然后存空矩阵A、B以及相乘后的矩阵的框架C,接着分别用for循环+append去读取A和B,然后两个矩阵相乘,最后再用两个for循环逐个打印。,然后读取A和B,然后再相乘,最后再打印。
我的题解
n,m,k=map(int,input().split())
A=[]
B=[]
C=[[0]*k for i in range(n) ]
for i in range(n):  A.append(list(map(int,input().split())))
for i in range(m):  B.append(list(map(int,input().split())))
for i in range(n):
    for l in range(k):  # B[0]为其第一行,len(B[0])是求B的列数
        for j in range(m):
            C[i][l]+=A[i][j]*B[j][l]
for i in range(n):
    for j in range(k):
        print(C[i][j],end=' ')
    print()
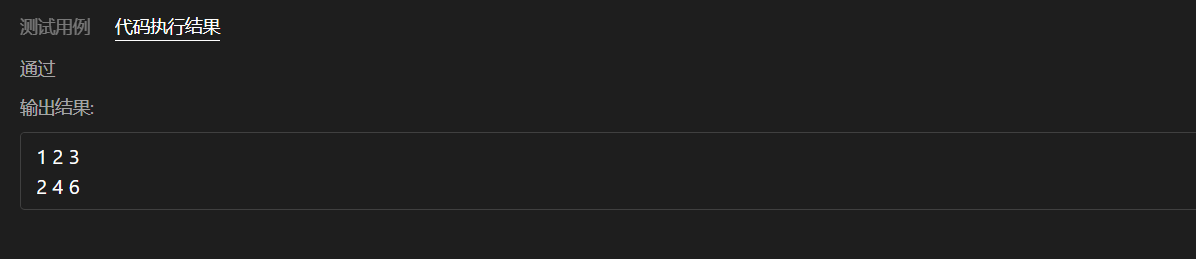
运行结果
2.自行车停放(list、链表)
问题描述
有n辆自行车依次来到停车棚,除了第一辆自行车外,每辆自行车都会恰好停放在已经在停车棚里的某辆自行车的左边或右边。(e.g.停车棚里已经有3辆自行车,从左到右编号为:3,5,1。现在编号为2的第4辆自行车要停在5号自行车的左边,所以现在停车棚里的自行车编号是:3,2,5,1)。给定n辆自行车的停放情况,按顺序输出最后停车棚里的自行车编号。
输入格式
第一行一个整数n。
第二行一个整数x。表示第一辆自行车的编号。
以下n-1行,每行3个整数x,y,z。
z=0时,表示编号为x的自行车恰停放在编号为y的自行车的左边
z=1时,表示编号为x的自行车恰停放在编号为y的自行车的右边
输出格式
从左到右输出停车棚里的自行车编号
样例输入
4
3
1 3 1
2 1 0
5 2 1
样例输出
3 2 5 1
我的思路
list列表、手写链表
我的题解
1.list列表
n=int(input())
x=int(input())
bicycles = []                           # 定义一个空列表
bicycles.append(x)                      #将第一辆车放进去
for i in range(n-1):                    #实现n-1行
    x,y,z=map(int,input().split())      #实现n-1行的每行都输入3个整数
    if z==0:    bicycles.insert(bicycles.index(y),x)     #z=0时,表示编号为x的自行车恰停放在编号为y的自行车的左边
    else:       bicycles.insert(bicycles.index(y)+1,x)   #z=1时,表示编号为x的自行车恰停放在编号为y的自行车的右边
for i in bicycles:
    print(i,end=' ')
2.手写链表
#链表代码
class Node():
    def __init__(self,data):        #定义结点
        self.data=data
        self.next=None
class SingleLinkList():             #初始化链表
    def __init__(self,node=None):
        self._head=node
    def left_insert(self,x,y):
        pre=self._head
        while pre.next.data !=x:
            pre=pre.next
        node=Node(y)
        node.next=pre.next
        pre.next=node
    def right_insert(self,x,y):
        pre=self._head
        while pre.data !=x:
            pre=pre.next
        node=Node(y)
        node.next=pre.next
        pre.next=node
    def print_list(self):
        cur=self._head
        while cur!=None:
            print(cur.data,end=' ')
            cur=cur.next


n=int(input())
a=int(input())
node=Node(a)
li=SingleLinkList(node)
for i in range(n-1):
    x,y,z=map(int,input().split())
    if z==0:
        li.left_insert(y,x)
    else:
        li.right_insert(y,x)
li.print_list()
运行结果
#list的运行结果:
4
3
1 3 1
2 1 0
5 2 1
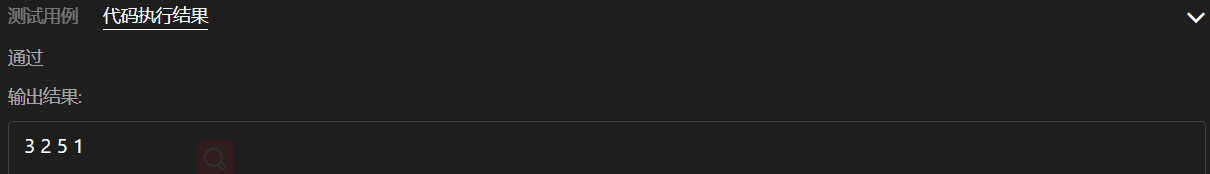
3 2 5 1
进程已结束,退出代码0
手写链表的运行结果
3、class实现学生成绩小系统
题目描述
定义一个学生类 要求: 1. 属性包括学生姓名、学号,以及语数英三科的成绩 2. 能够设置学生某科目的成绩 3. 能够打印出该学生的所有科目成绩
我的思路
见代码备注
我的题解
class Student:
    def __init__(self,student_name,student_id):    #属性包括学生姓名、学号,以及语数英三科的成绩
        self.student_name=student_name
        self.student_id=student_id
        self.grades={"语文":0,"数学":0,"英语":0}      #建立一个字典,由于每一个值的初始值都是0,就不需要从参数获取(也就是无需在self后加参数),可以直接定义一个变量
    def set_grade(self,course,grade):               #设置学生某科目的成绩
        if course in self.grades:                   #判断设置的科目是否在字典里面
            self.grades[course]=grade               #如果在字典里面,则这个字典的值等于调用时放的参数grade的值,即完成成绩的设置
    def print_grades(self):
        print(f"学生{self.student_name}:(学号:{self.student_id})的成绩为:")
        for course in self.grades:
            print(f"{course}:{self.grades[course]}")

#测试
chen = Student("小陈", "100618")
chen.set_grade("语文", 92)
chen.set_grade("数学", 94)
chen.print_grades()
zeng = Student("小曾", "100622")
print()
zeng.set_grade("数学", 95)
print(zeng.grades)
运行结果
学生小陈:(学号:100618)的成绩为:
语文:92
数学:94
英语:0

{'语文': 0, '数学': 95, '英语': 0}

进程已结束,退出代码0
相关推荐
RTX 2080 Ti 22G本地部署Qwen3.6-35B实现Token自由
大模型推理的核心瓶颈并非算力峰值,而是显存带宽与KV Cache管理效率;FP16权重加载、全量注意力计算和静态图调度会迅速耗尽消费级GPU资源。通过INT4量化权重、FP8 KV Cache压缩、PagedAttention分页管理和Selective Activation检查点等关键技术,可在低功耗硬件上实现高吞吐稳定推理。这类优化显著降低大模型本地化门槛,支撑私有知识库问答、代码补全、RAG增强等典型AI工程场景。本文聚焦RTX 2080 Ti 22G与Qwen3.6-35B-A3B的深度适配实践,揭
树莓派3B+运行Volumio 3.x深度调优指南
Volumio是一款面向高保真音频的嵌入式Linux播放系统,其核心依赖于实时音频子系统(ALSA)、内核调度策略与硬件抽象层(Device Tree)的精准协同。在树莓派3B+这类ARMv7架构的老平台中,官方arm64镜像存在架构错配、驱动初始化失败及DAX/THP等现代内核特性不兼容问题,导致CPU占用飙升、播放卡顿与本底噪声恶化。技术价值在于通过降级alsa-ucm-conf、重写config.txt内存分配、锁定CPU亲和性、禁用透明大页及重建I2S设备树覆盖层,实现音频路径全链路确定性调度。典型
Windows下ComfyUI+AMD显卡DirectML部署全指南
DirectML是微软为Windows平台提供的原生AI加速API,专为在不依赖CUDA或Linux环境的前提下调用GPU计算能力而设计。其核心原理是深度集成于DirectX 12图形栈,实现零拷贝内存访问与WDDM驱动级调度,技术价值在于让AMD Radeon RX 6000/7000系列及锐龙核显在Windows原生环境中稳定释放AI算力。典型应用场景包括本地化AI绘画工作流、批量提示词图像生成、LoRA微调等轻量级AIGC任务。本文聚焦ComfyUI与DirectML的深度适配实践,覆盖Python
Cherry-Studio-CN-2.1.6-win-x64-setup.exe
Cherry-Studio-CN-2.1.6-win-x64-setup.exe
【高速电路设计】基于协议的板级布局指南:差分信号完整性与电源热管理协同优化方案
内容概要:本文档详细介绍了规格补充学习,并在实际项目中配合仿真工具与实测手段进行验证。




