

 Python学习社区

哪位大神帮帮忙,看一看python爬虫小白的问题???
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
哪位大神帮帮忙,看一看python爬虫小白的问题???
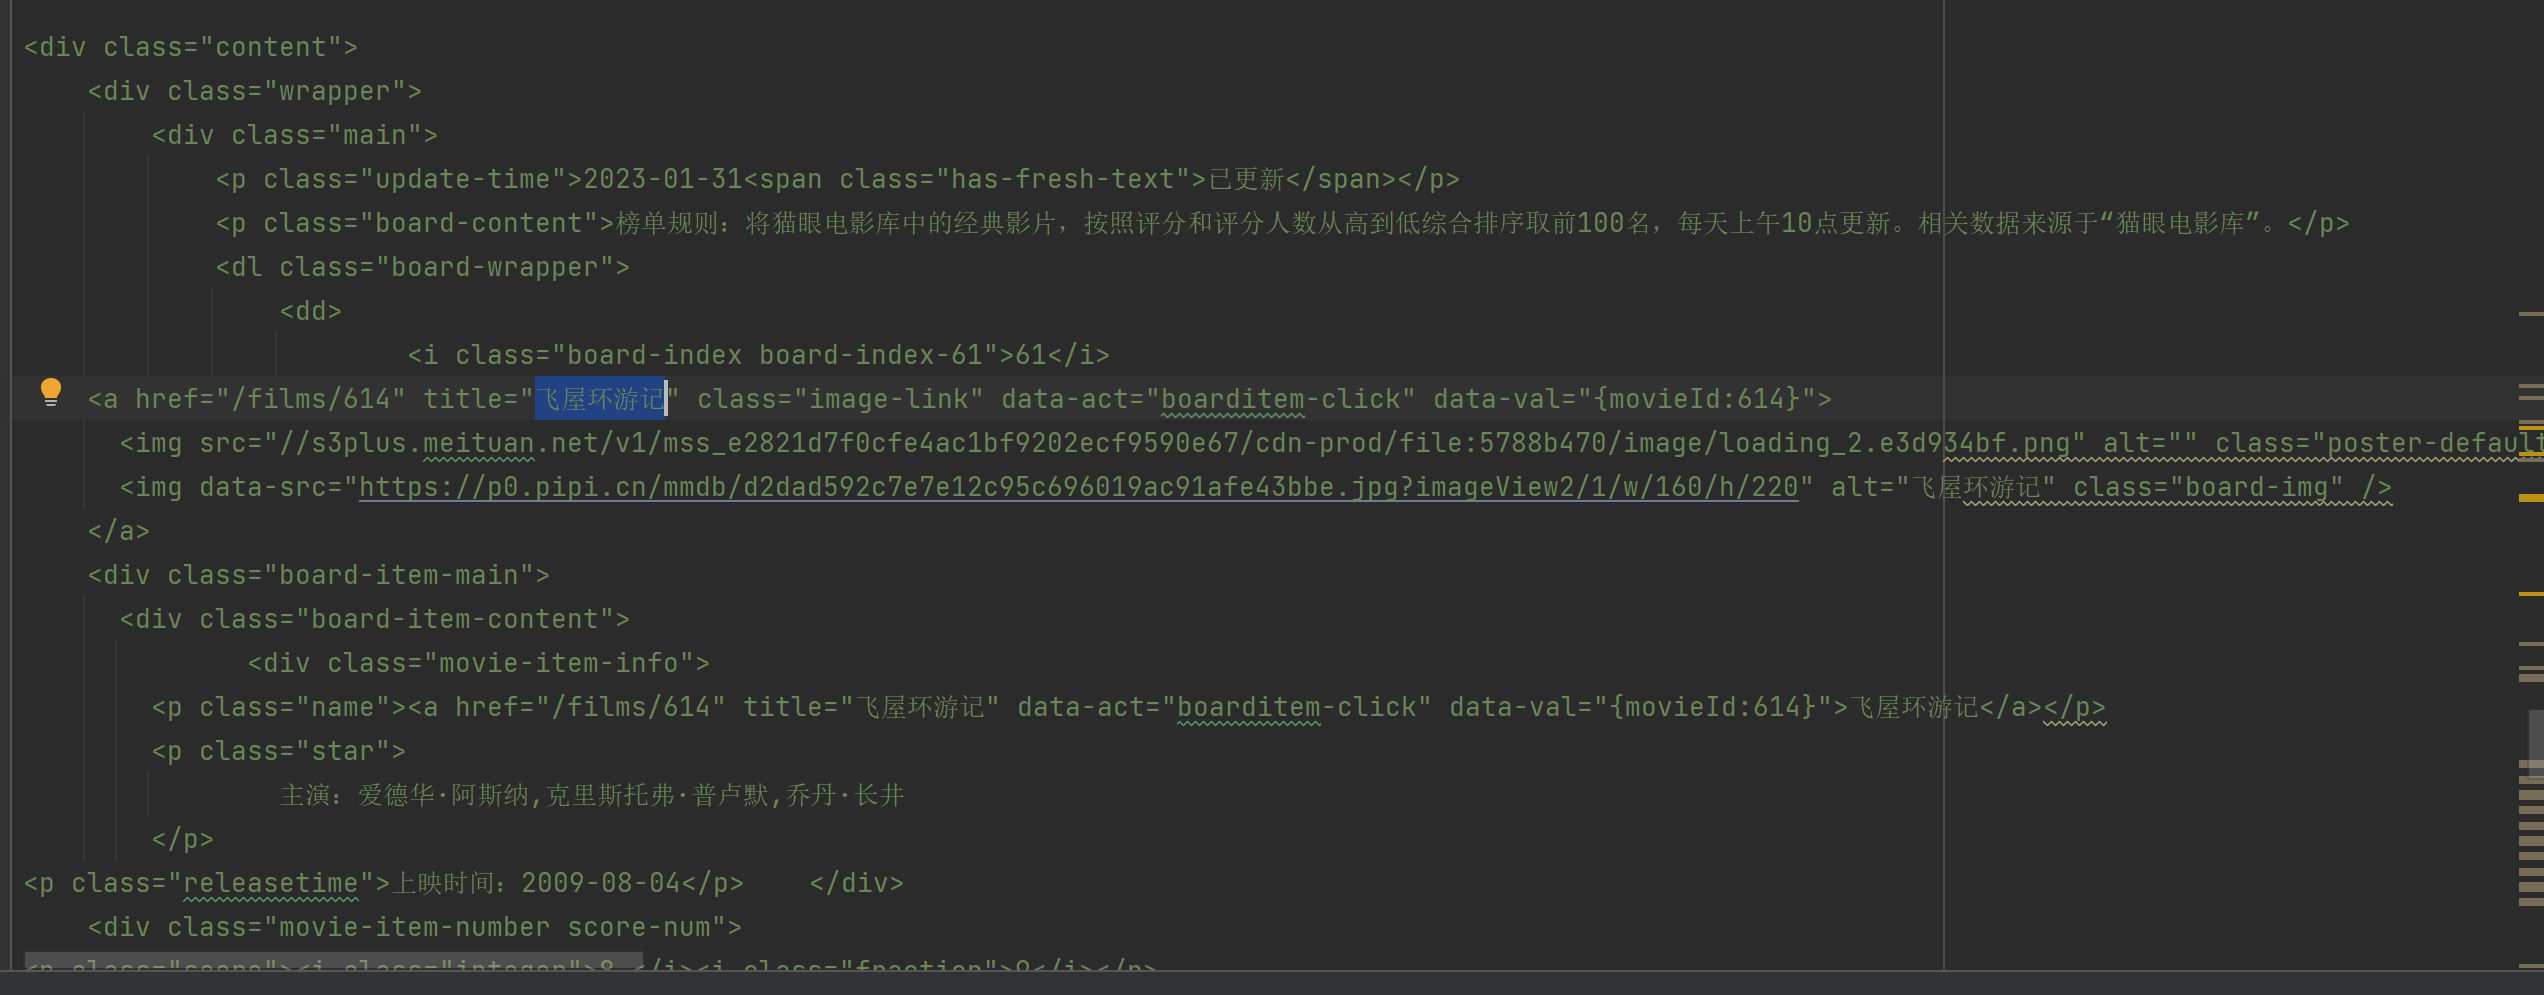
从这样的HTML文档中抓取电影名字
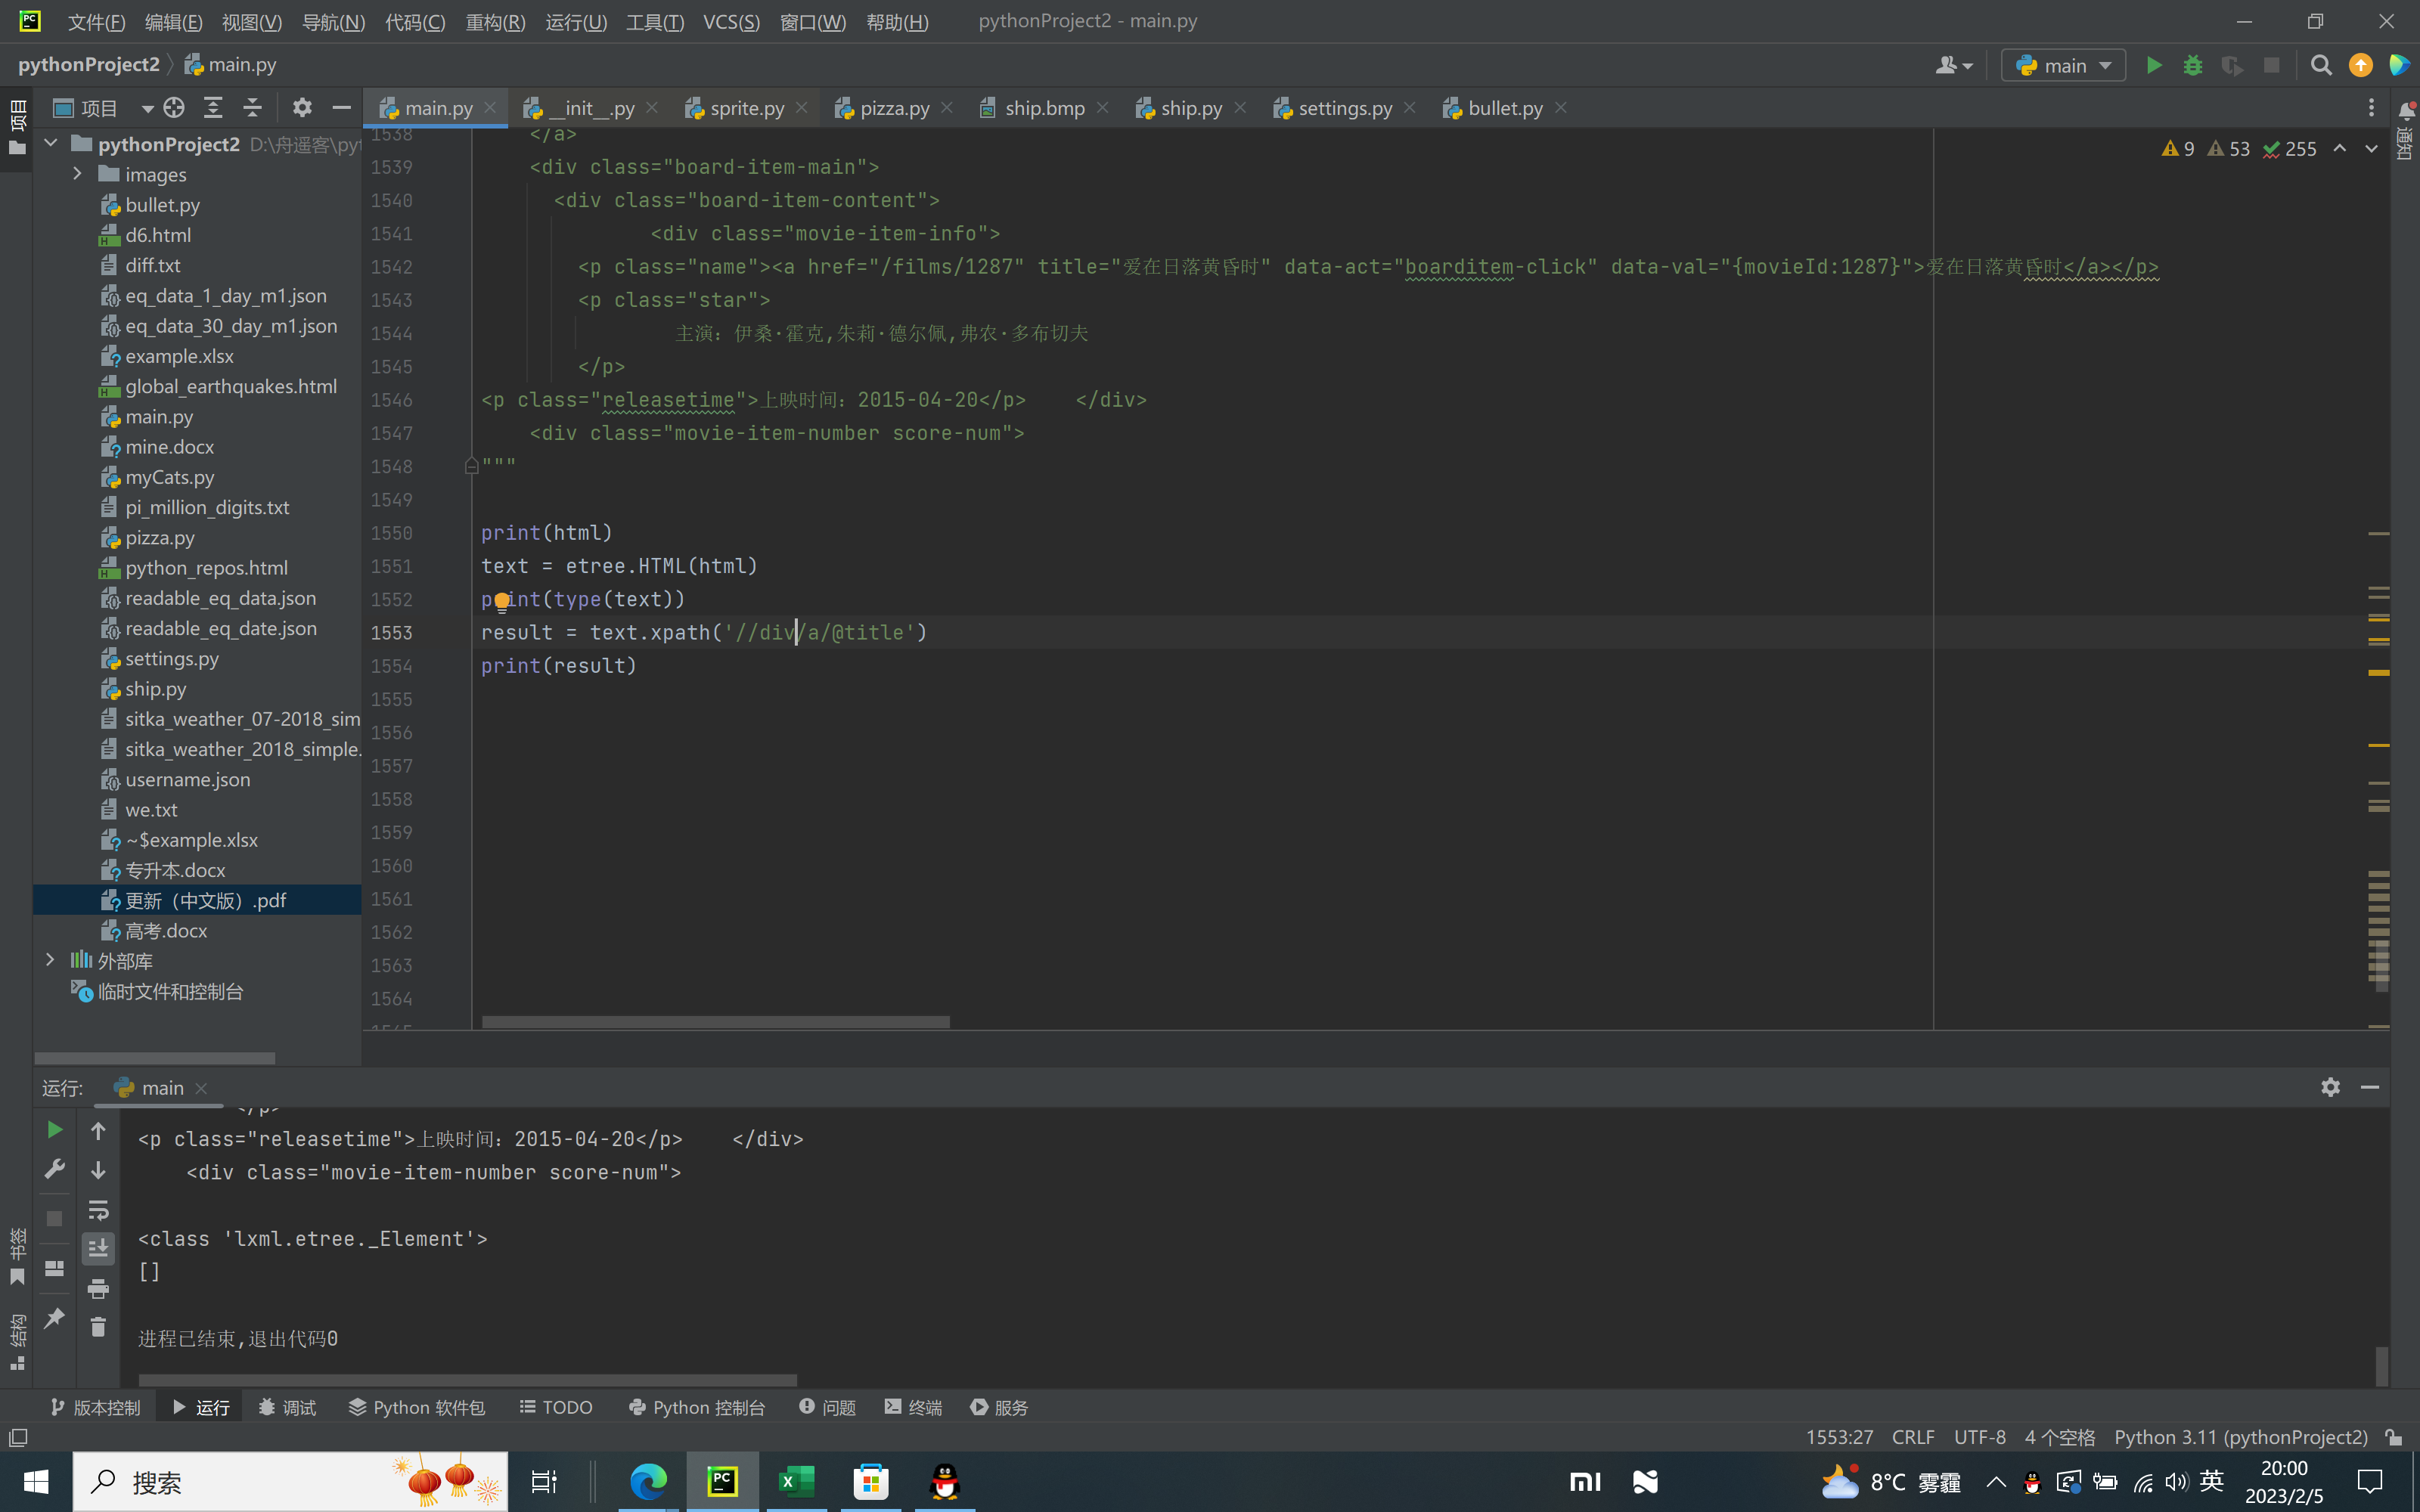
使用lmxl库时,匹配以下格式:
result = text.xpath('//div/a/@title')
结果是抓取不到数据
更改抓取格式,如下:
result = text.xpath('//div//a/@title')
就可以成功抓取
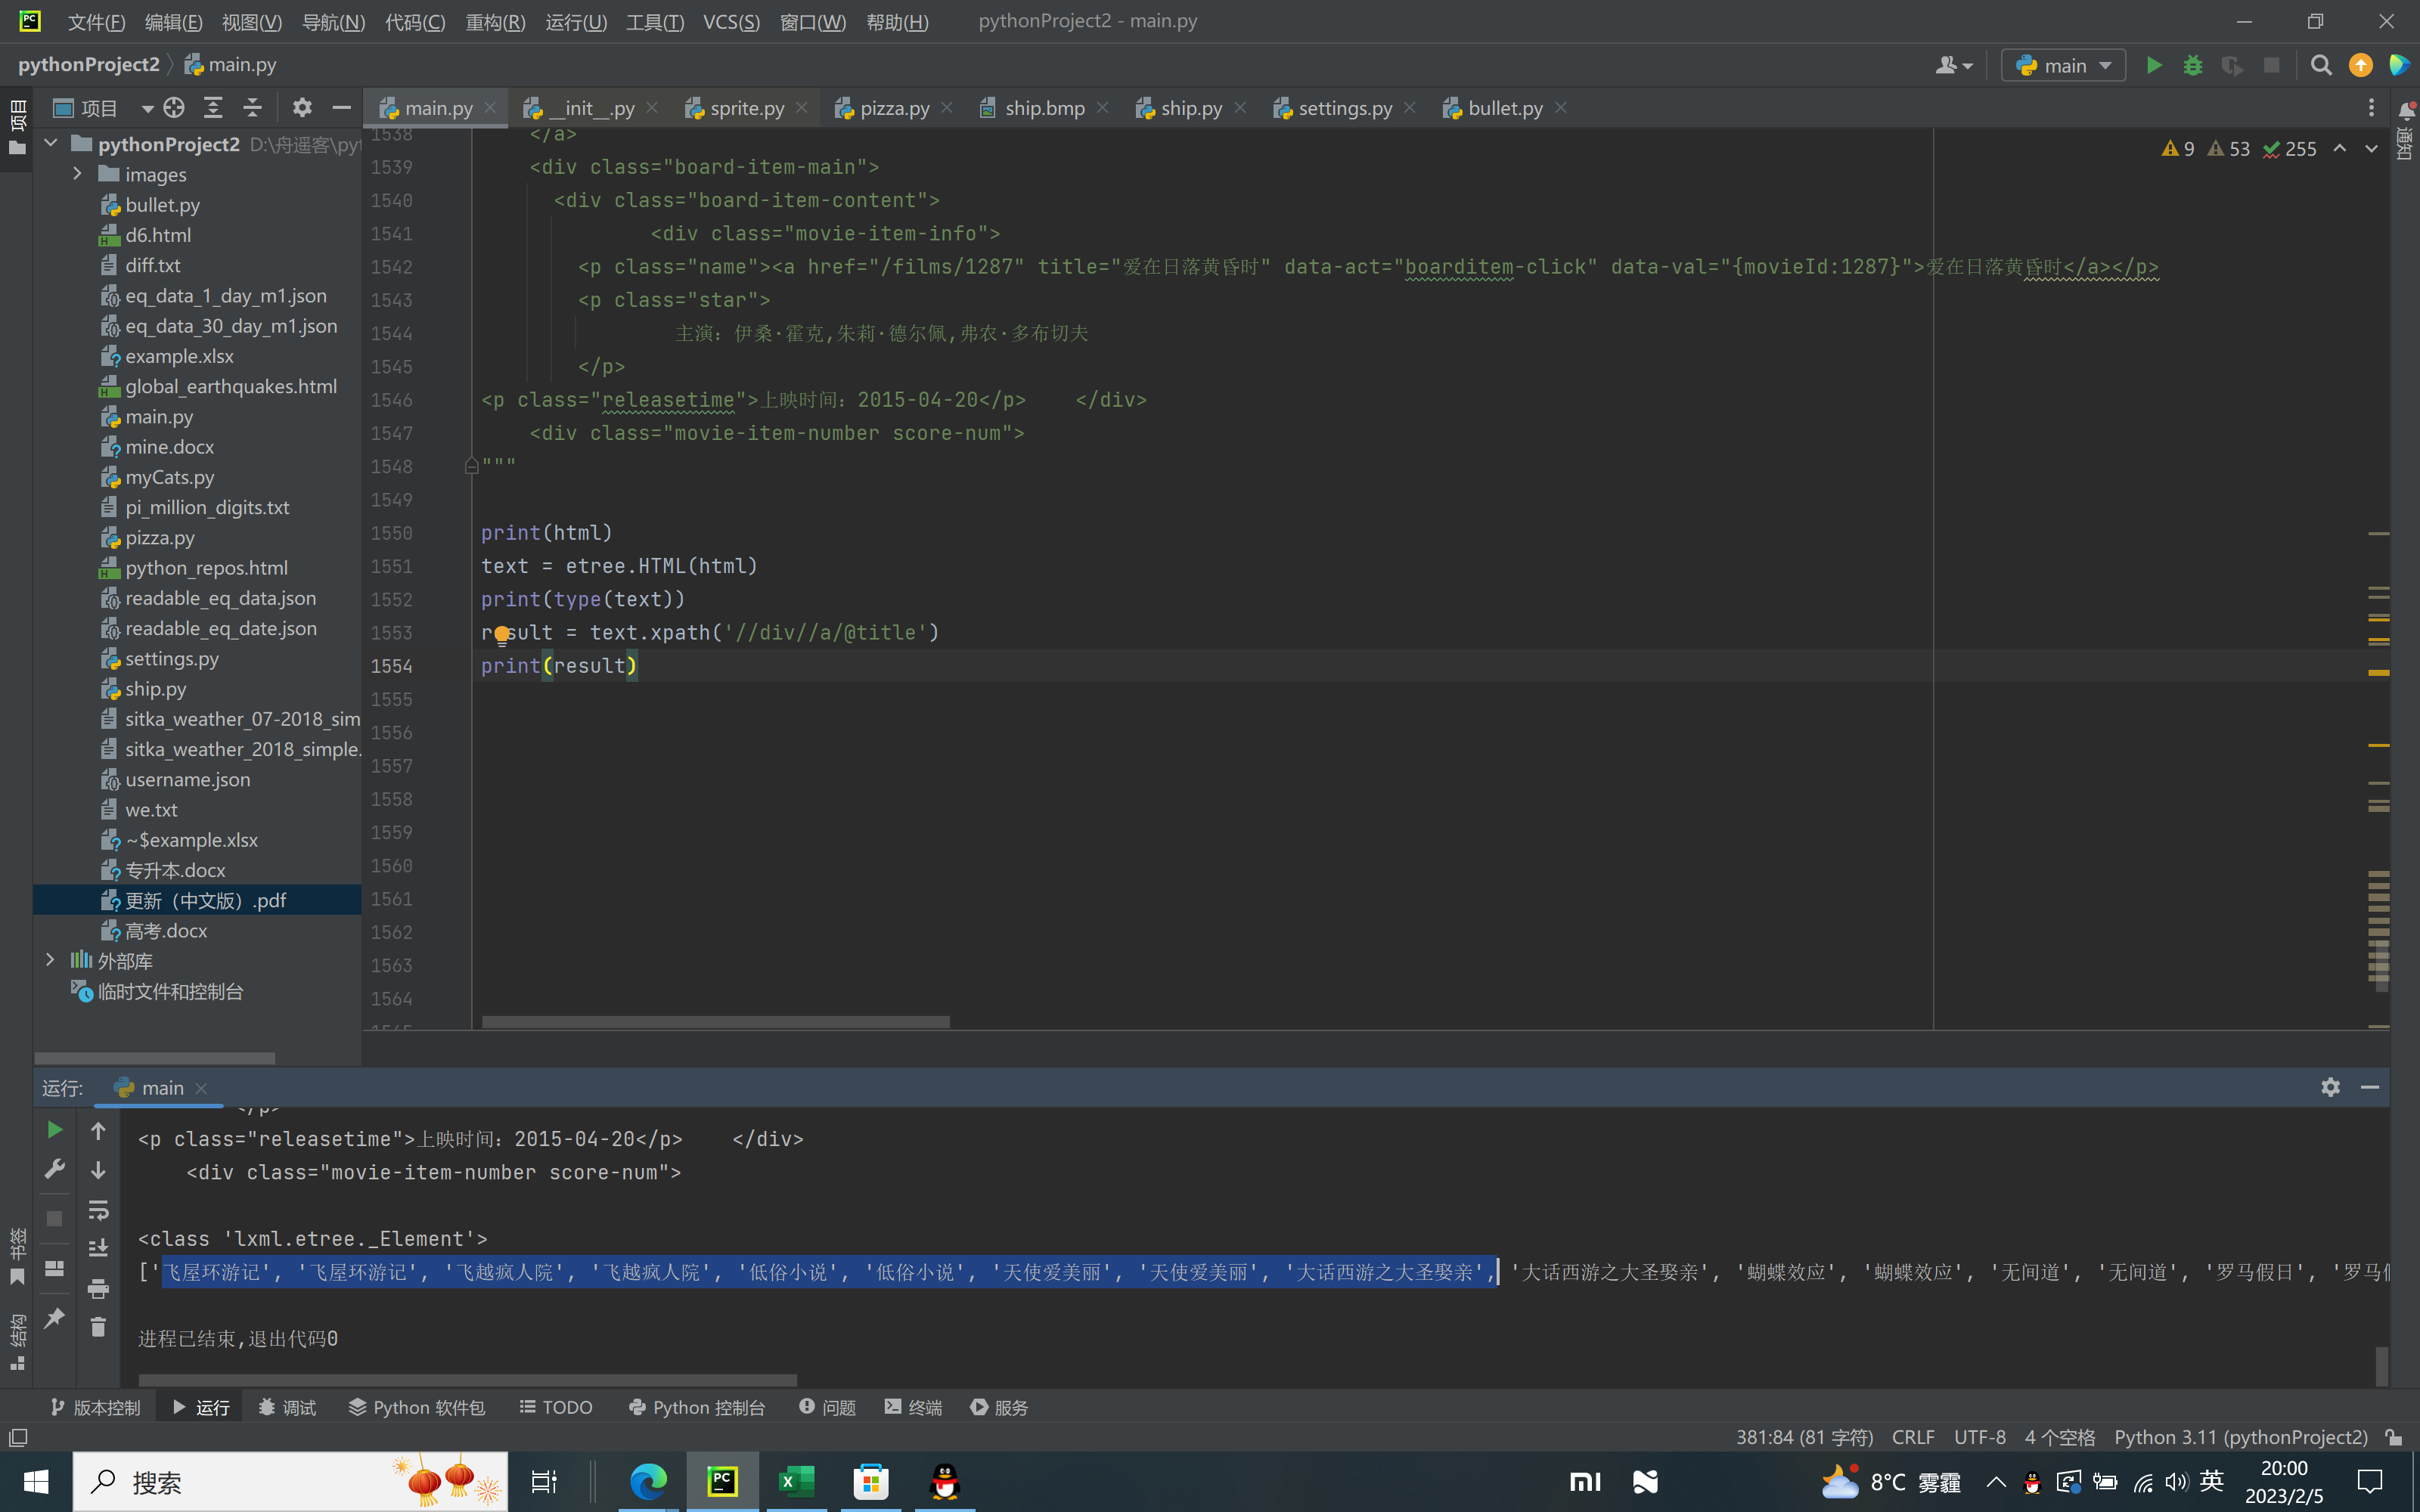
这是怎么一回事!!!!
a不是div的子节点吗?
为什么要用子孙节点才能抓取???
为什么要用子孙节点才能抓取???
为什么要用子孙节点才能抓取???
相关推荐
基于Python专业网络爬虫的设计与实现
"基于Python专业网络爬虫的设计与实现"本文主要探讨了如何利用Python进行专业网络爬虫的设计与实现,以解决传统搜索引擎存在的返回结果不精确等问题。网络爬虫,通常被称为网页蜘蛛或网络机器人,
基于python的网络爬虫设计
【基于Python的网络爬虫设计】在网络大数据时代,获取网络数据变得至关重要,网络爬虫作为高效的数据抓取工具,被广泛应用。Python因其简洁易懂的语法和强大的库支持,成为开发网络爬虫的首选语言。
基于Python的网络爬虫技术
"基于Python的网络爬虫技术"Python是一种强大的编程语言,尤其在处理网络数据方面,它提供了丰富的库和框架来支持网络爬虫的开发。网络爬虫,也称为网络蜘蛛或网络机器人,用于自动地遍历互联网,
解析Python网络爬虫_复习大纲.docx
网络爬虫,又称网页蜘蛛、网络机器人,是一种按照一定的规则,自动请求万维网网站并提取网络数据的程序或脚本。2. 请简述通用爬虫和聚焦爬虫的区别。
Python网络爬虫的设计与实现研究
摘要:随着互联网技术的快速发展,网络爬虫作为获取互联网信息的重要工具,其在数据分析、数据挖掘、自然语言处理等领域的应用越来越广泛。本文首先对网络爬虫的基本原理进行了介绍,然后详细阐述了基于Python的网络爬虫设计与实现过程,包括爬虫架构的选择、网页抓取、数据解析、数据存储等方面。URL管理器负责维护一个待爬取的URL队列,网页下载器负责从URL队列中取出URL并下载对应的网页内容,网页解析器负责对下载的网页内容进行解析和提取所需信息,数据输出器负责将提取的信息以指定格式输出。关键词:Python;




