

 基础知识小馆

【Python】使用bs4的
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
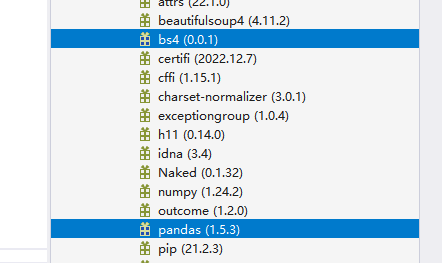
1、安装两个插件
pip install bs4
2、简单读取和解析html
#!/usr/bin/python3
# -*- coding: utf-8 -*-
# 2023-02-23

import requests
from bs4 import BeautifulSoup

# 获取C占首页【热点】资讯
url = 'https://www.csdn.net/?spm=1001.2100.3001.4476'
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/110.0.0.0 Safari/537.36 Edg/110.0.1587.50'
}

response = requests.get(url, headers=headers)
html = response.text

# 解析HTML代码
soup = BeautifulSoup(html, 'html.parser')

# 找到标题区域
article_tags = soup.select('.headswiper-item')

# 提取每篇文章的标题和链接
results = []
for tag in article_tags:
    title_tags = tag.select('.headswiper-item > a')
    if title_tags:
        title = title_tags[0].get_text().strip()
        link = title_tags[0]['href']
        results.append((title, link))

for item in results:
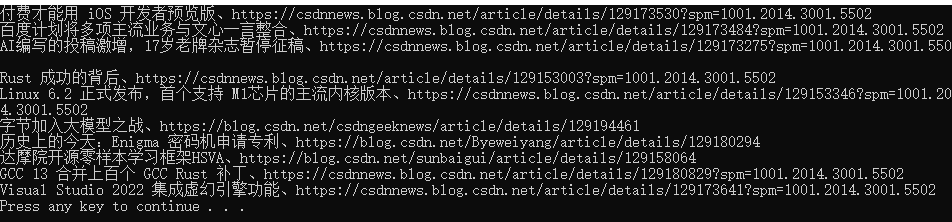
    print(f'{list(item)[0]}、{list(item)[1]}')
相关推荐
Python BS4库的安装与使用详解
主要介绍了Python BS4库的安装与使用详解,小编觉得挺不错的,现在分享给大家,也给大家做个参考。一起跟随小编过来看看吧
Python爬虫BS4库的解析器正确使用方法
bs4库之所以能快速的定位我们想要的元素,是因为他能够用一种方式将html文件解析了一遍 ,不同的解析器有不同的效果。下文将一一进行介绍。 bs4解析器的选择 网络爬虫的最终目的就是过滤选取网络信息,最重要的部分可以说是解析器。解析器的优劣决定了爬虫的速度和效率。bs4库除了支持我们上文用过的‘html.parser’解析器外,还支持很多第三方的解析器,下面我们来对他们进行对比分析。 bs4库官方推荐我们使用的是lxml解析器,原因是它具有更高的效率,所以我们也将采用lxml解析器。 PS注意:很多人学Python过程中会遇到各种烦恼问题,没有人解答容易放弃。为此小编建了个Python全栈免费
Python爬虫使用bs4方法实现数据解析
聚焦爬虫: 爬取页面中指定的页面内容。 编码流程: 1.指定url 2.发起请求 3.获取响应数据 4.数据解析 5.持久化存储 数据解析分类: 1.bs4 2.正则 3.xpath (***) 数据解析原理概述: 解析的局部的文本内容都会在标签之间或者标签对应的属性中进行存储 1.进行指定标签的定位 2.标签或者标签对应的属性中存储的数据值进行提取(解析) bs4进行数据解析数据解析的原理: 1.标签定位 2.提取标签、标签属性中存储的数据值 bs4数据解析的原理: 1.实例化一个BeautifulSoup对象,并且将页面源码数据加载到该对象中 2.通
浅谈Python中的bs4基础
今天小编就为大家分享一篇关于Python中的bs4基础,小编觉得内容挺不错的,现在分享给大家,具有很好的参考价值,需要的朋友一起跟随小编来看看吧
Python爬虫bs4库使用指南[代码]
本文详细介绍了Python中BeautifulSoup4(bs4)库的使用方法,包括安装、解析器的选择、HTML文件的处理方式以及文档树的遍历和搜索技巧。文章首先介绍了bs4的安装方法,包括使用阿里国内源进行安装。接着,详细讲解了如何使用不同的解析器(如Python标准库、lxml、htm5lib等)来解析HTML文件,并比较了它们的优缺点。然后,文章深入探讨了bs4对HTML文件的处理方式,将HTML文档转换为树形结构,并介绍了四种主要的Python对象类型:Tag、NavigableString、BeautifulSoup和Comment。此外,文章还详细讲解了如何遍历和搜索文档树,包括使用find_all和find方法,以及CSS选择器的使用。最后,文章通过实例代码展示了如何获取和修改标签内容,为Python爬虫开发者提供了全面的bs4库使用指南。





