

 2023年北航敏捷软件工程

结对编程项目—最长英语单词链
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
结对编程项目—最长英语单词链
目录
- 结对编程项目—最长英语单词链
- 1.项目地址
- 2.PSP表格记录预估花费时间
- 3.看教科书和其它资料中关于 Information Hiding,Interface Design,Loose Coupling 的章节,说明你们在结对编程中是如何利用这些方法对接口进行设计的
- 3.1.Information Hiding
- 3.2.Interface Design
- 3.3.Loose Coupling
- 4.计算模块接口的设计与实现过程
- 4.1 代码组织
- 4.2 模块实现
- 5.编译器编译通过无警告的截图
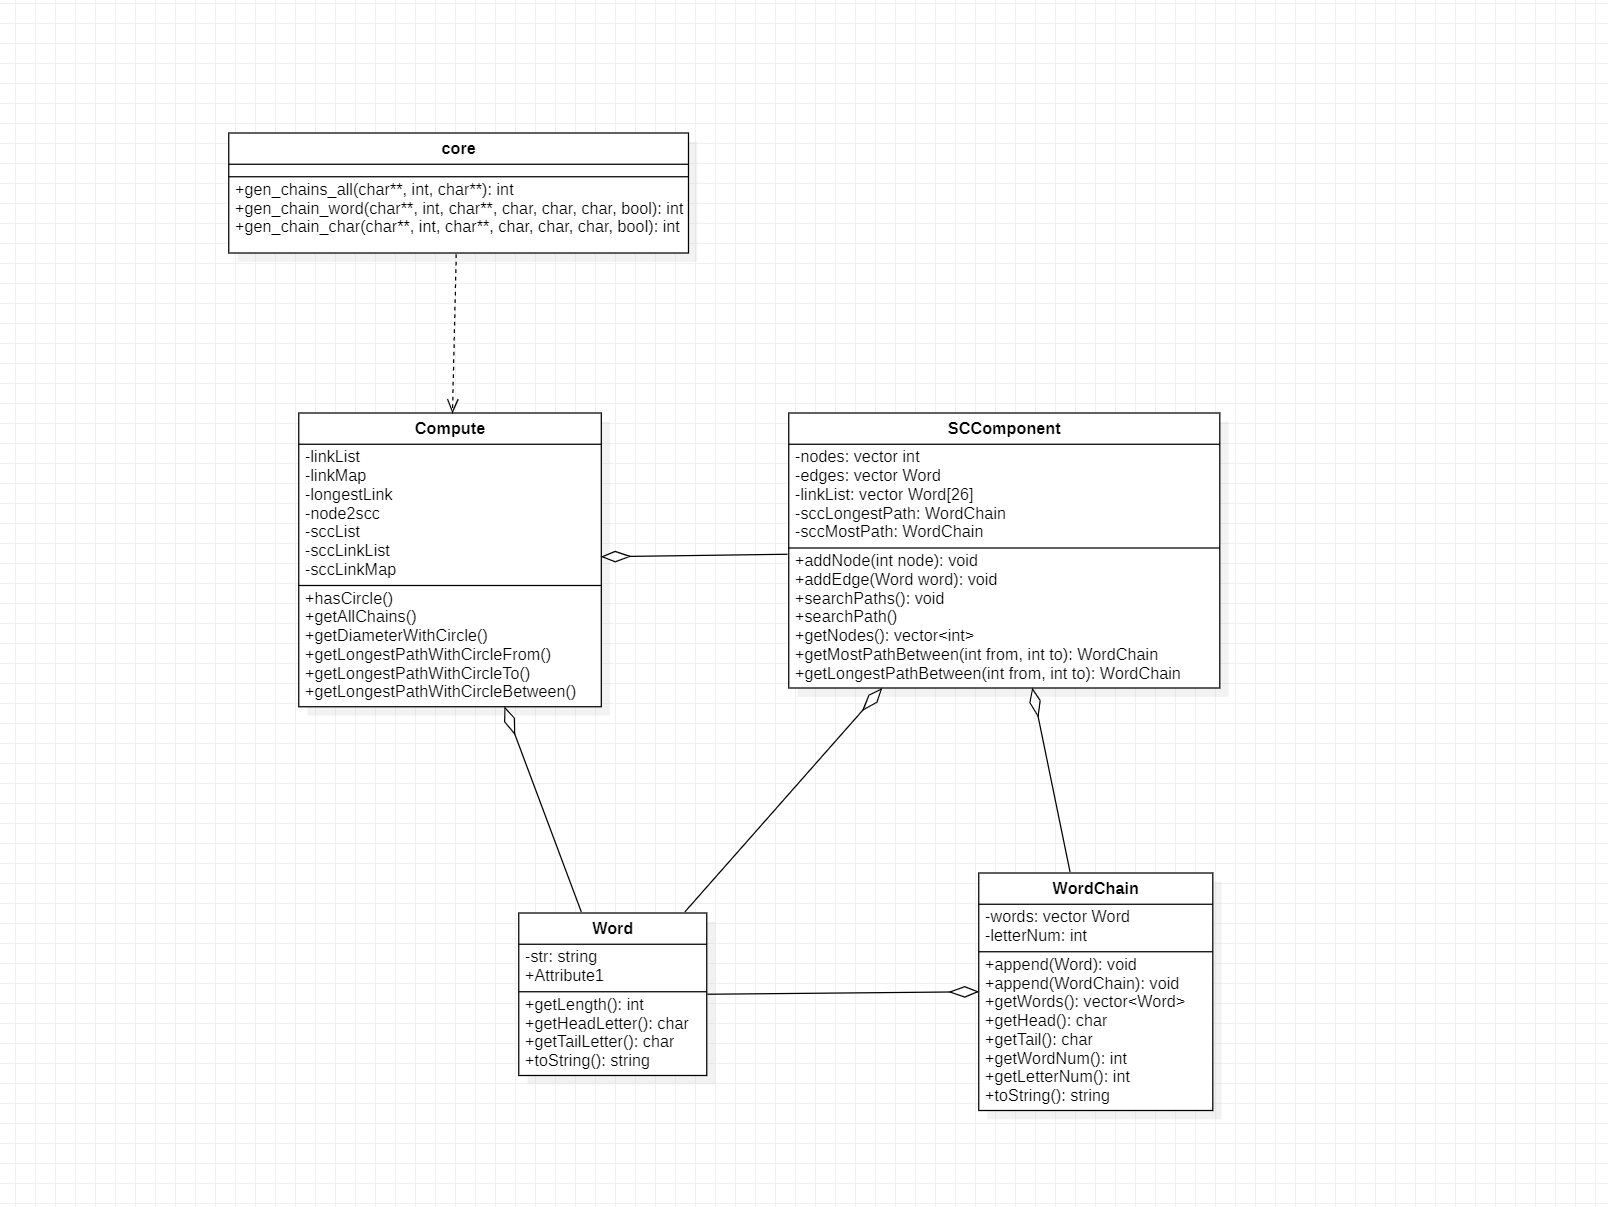
- 6.UML类图显示计算模块部分各个实体之间的关系
- 7.计算模块接口部分性能改进
- 8.阅读 Design by Contract,Code Contract 的内容,并描述这些做法的优缺点,说明你是如何把它们融入结对作业中的
- 8.1.Design by Contract
- 8.2.Code Contract
- 9.计算模块部分单元测试展示
- 10.计算模块部分异常处理说明
- 10.1.输入单词存在非法环
- 10.2.输入单词数量len <= 0
- 10.3.传入的head、tail、reject字母不合规
- 11.界面模块的详细设计过程
- 12.界面模块与计算模块的对接
- 13.描述结对的过程
- 14.结对编程的优点和缺点
- 15.PSP表格记录实际花费时间
- 16.附加题:界面模块,测试模块和核心模块的松耦合
1.项目地址
- 教学班级:周四上午班
- 项目地址:https://gitee.com/buluo1204/lewc
2.PSP表格记录预估花费时间
| PSP2.1 | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | 30 | 30 |
| · Estimate | · 估计这个任务需要多少时间 | 30 | 30 |
| Development | 开发 | 1590 | 1880 |
| · Analysis | · 需求分析 (包括学习新技术) | 120 | 180 |
| · Design Spec | · 生成设计文档 | 60 | 60 |
| · Design Review | · 设计复审 (和同事审核设计文档) | 60 | 30 |
| · Coding Standard | · 代码规范 (为目前的开发制定合适的规范) | 30 | 30 |
| · Design | · 具体设计 | 120 | 180 |
| · Coding | · 具体编码 | 600 | 800 |
| · Code Review | · 代码复审 | 300 | 200 |
| · Test | · 测试(自我测试,修改代码,提交修改) | 300 | 400 |
| Reporting | 报告 | 300 | 270 |
| · Test Report | · 测试报告 | 120 | 180 |
| · Size Measurement | · 计算工作量 | 60 | 30 |
| · Postmortem & Process Improvement Plan | · 事后总结, 并提出过程改进计划 | 120 | 60 |
| 合计 | 1920 | 2180 |
3.看教科书和其它资料中关于 Information Hiding,Interface Design,Loose Coupling 的章节,说明你们在结对编程中是如何利用这些方法对接口进行设计的
3.1.Information Hiding
Information Hiding就是面向对象编程中的封装,通过将类的部分属性私有化,并对外提供具有一定规则的可以被外界访问属性的方法,如此外部只能通过设定好的规则对对象的属性进行操作。可以减少耦合、保护对象数据的安全。
在本次的设计中,core模块中的WordChain类中采用private关键字将属性words、headMap、tailMap隐藏,并对外提供append()方法来向words中添加单词同时将修改headMap和tailMap,contains(char c)方法来判断单词链中是否已经出现以c开头或结束的单词。这部分的属性是程序运行的关键部分,其中属性不能由调用者修改,而是通过内部的规则来修改headMap和tailMap,防止外部修改导致程序出错。
class WordChain {
private:
    vector<Word> words;
    bool headMap[26];
    bool tailMap[26];
    int letterNum = 0;
public:
    WordChain();
    WordChain(const vector<string>& words);
    void insertHead(Word word);
    void append(Word word);
    void append(WordChain wordChain);
    vector<Word> getWords();
    WordChain *add(Word word);
    char getHead();
    char getTail();
    bool contains(char c);
    int getWordNum();
    int getLetterNum() const;
    string toString();
};
3.2.Interface Design
本次的设计中core.dll模块的API接口采用本来是如下的三个接口,但由于项目开始时只考虑到自己书写方便,没有考虑到与其他小组的交换问题,导致接口的普适性非常低,无法与其他小组进行交换活动。
std::vector<std::string> getAllChains(const std::set<std::string>& words);
WordChain getMaxWordChain(const std::set<std::string>& words, char h, char t, char j, bool allowCircle);
WordChain getMaxLetterChain(const std::set<std::string>& words, char h, char t, char j, bool allowCircle);
后来,为了与其他小组进行更好的交换行动,又在上面的三个接口外面封装了一层,变成了课程组推荐的接口。
int gen_chains_all(char* words[], int len, char* result[]);
int gen_chain_word(char* words[], int len, char* result[], char head, char tail, char reject, bool enable_loop);
int gen_chain_char(char* words[], int len, char* result[], char head, char tail, char reject, bool enable_loop);
等到真正与其他小组进行交换的时候才意识到一个好的接口带来的模块易用性的改变。对于原来的接口而言,需要引入vector.h、string.h和WordChain.h三个头文件,其中WordChain.h还是自己定义的。这样在调用core.dll的时候不仅需要core.h也需要WordChain.h,造成使用上的不便。
3.3.Loose Coupling
“高内聚、松耦合”是一个非常重要的通用的设计思想,以有效提高代码的可读性和可维护性。 在调用方和被调用方约定好接口和数据交互之后,双方在遵守接口的协议的条件下,可以修改内部的实现方法而不需要改变接口和数据的交互。
在本次的设计中,通过将核心计算模块与其他模块解耦,将核心计算模块分离出来。其他模块负责参数处理与单词读入处理,然后调用核心计算模块core.dll的接口调用对应的功能,同时不需要关注核心计算模块的实现细节。核心模块只需要负责计算并按照接口约定将结果返回。
core.dll模块接口约定如下:
int gen_chains_all(char* words[], int len, char* result[]);
int gen_chain_word(char* words[], int len, char* result[], char head, char tail, char reject, bool enable_loop);
int gen_chain_char(char* words[], int len, char* result[], char head, char tail, char reject, bool enable_loop);
4.计算模块接口的设计与实现过程
4.1 代码组织
core接口模块:用于封装调用Compute类计算方法的接口。为了便于与其他组交换,我们使用了课程组建议的3个接口。int gen_chains_all(char* words[], int len, char* result[]):用于找出words中len个单词所能构成的所有单词链,保存在result里,返回找到的单词链数量;int gen_chain_word(char* words[], int len, char* result[], char head, char tail, char reject, bool enable_loop):用于找出words中len个单词所能构成的单词最多的单词链,保存在result里,返回单词数量;int gen_chain_char(char* words[], int len, char* result[], char head, char tail, char reject, bool enable_loop):用于找出words中len个单词所能构成的字符最多的单词链,保存在result里,返回单词数量;
Compute类:核心计算模块,是一个以字母为节点,单词Word为边的图,包含若干SCComponent。用于检测单词环、查找最长单词链等核心功能。bool hasCircle():检查是否有单词链成环;vector<string> getAllChains():获得所有单词链(每个单词链一个string);WordChain getDiameterWithCircle(int lengthType):获得最长的单词链,参数可选择单词数最多或长度最大;WordChain getLongestPathWithCirCleTo(char tail, int lengthType):获得最长的单词链,指定结尾字母为tail,参数可选择单词数最多或长度最大;WordChain getLongestPathWithCirCleFrom(char head, int lengthType):获得最长的单词链,指定开头字母为head,参数可选择单词数最多或长度最大;WordChain getLongestPathWithCirCleBetween(char head, char tail, int lengthType):获得最长的单词链,指定开头字母为head,结尾单词为tail,参数可选择单词数最多或长度最大;
SCComponent类:字母强连通分量类。用于计算强连通分量中任意两字母间最长单词序列。void addNode(int node):添加一个节点(字母)进入SCC;void addEdge(Word word):添加一个边(单词)进入SCC;void searchPaths():计算任意两节点间的最长路径;vector<int> getNodes():获取所有节点;WordChain getMostPathBetween(int from, int to):获取from和to之间的单词最多的单词链;WordChain getLongestPathBetween(int from, int to):获取from和to之间的 字符最多的单词链;
Word与WordChain类:单词和单词序列,用以封装数据结构。注意单词序列并非单词链,只有长度大于1的单词序列才是单词链。
4.2 模块实现
模块的实现关键在于Compute类与SCComponent 类。
Compute类
对于hasCircle()与getAllChain(),我们使用了简单的DFS算法实现。
对于寻找最长单词链的函数实现,我们的优化经历了3个阶段:
使用DFS搜索符合条件的最长单词链:这样做时间复杂度过高,被舍弃;
设计了无环的动态规划算法与有环的动态规划算法:
对于无环的情况:首先将所有字母拓扑排序,然后依次按以下方式更新以字母$i$结尾的最长单词链长度
$$
dp[i]\leftarrow \max_j{dp[j]+e_{ji}}
$$
对于有环的情况首先使用Tarjan算法找出所有强连通分量。接下来,我们先在强连通分量内部使用DFS搜索任意两点间的最长路径。然后对所有强连通分量进行拓扑排序,按照顺序对每个强连通分量中的节点$i$按以下规则进行动态规划:首先,更新以字母$i$结尾,并且不包含$i$所在强连通分量其它字母的最长单词序列长度$dp_{in}[i]$,表示从其它SCC进入此SCC的最长单词序列:
$$
dp_{in}[i]\leftarrow \max_j{dp_{out}[j]+e_{ji}}(scc[i]\neq scc[j])
$$
然后,更新以字母$i$结尾,并且包含$i$所在强连通分量其它字母的最长单词序列长度$dp_{out}[i]$,表示从此SCC离开时的最长单词序列:
$$
dp_{out}[i]\leftarrow \max_j{dp_{in}[j]+\max{p_{ji}}}(scc[i]= scc[j])
$$
对应的$rec_{in}$与 $rec_{out}$以相同的逻辑进行更新。统一使用有环的动态规划算法:由于仅包含一个单词的自环,如alpha,不算成环的单词链,然而从算法的角度来讲,这种情况需要使用有环的算法,所以我们对有无环的情况都统一使用了支持有环的算法。值得注意的是,为了防止在寻找字母最多的单词链时,
wooooooooooooorld这样的单词覆盖了war road这样的单词链,每次试图更新$dp$与$rec$数组时,也检查新产生的链是否合法且比当前最优结果要好,如果是,即使不更新$dp$与$rec$数组,也更新最优结果。
SCComponent类
SCCompoennt类主要负责给出其中两节点的最长路径,使用DFS从所有节点依次开始遍历SCC,记录沿途的路径。时间复杂度为$O(|V_{scc}|\cdot|E_{scc}|)$。
我们认为我们代码的独到之处在于使用的函数能同时处理带环和不带环的情况,对于长度为1的自环也是如此,从而减少了对特殊情况的判断,使得代码更易于维护。并且,从效率的角度来讲,该算法在无环时时间复杂度会退化为$O(|E|)$,与直接使用特判自环的无环动态规划算法相同。
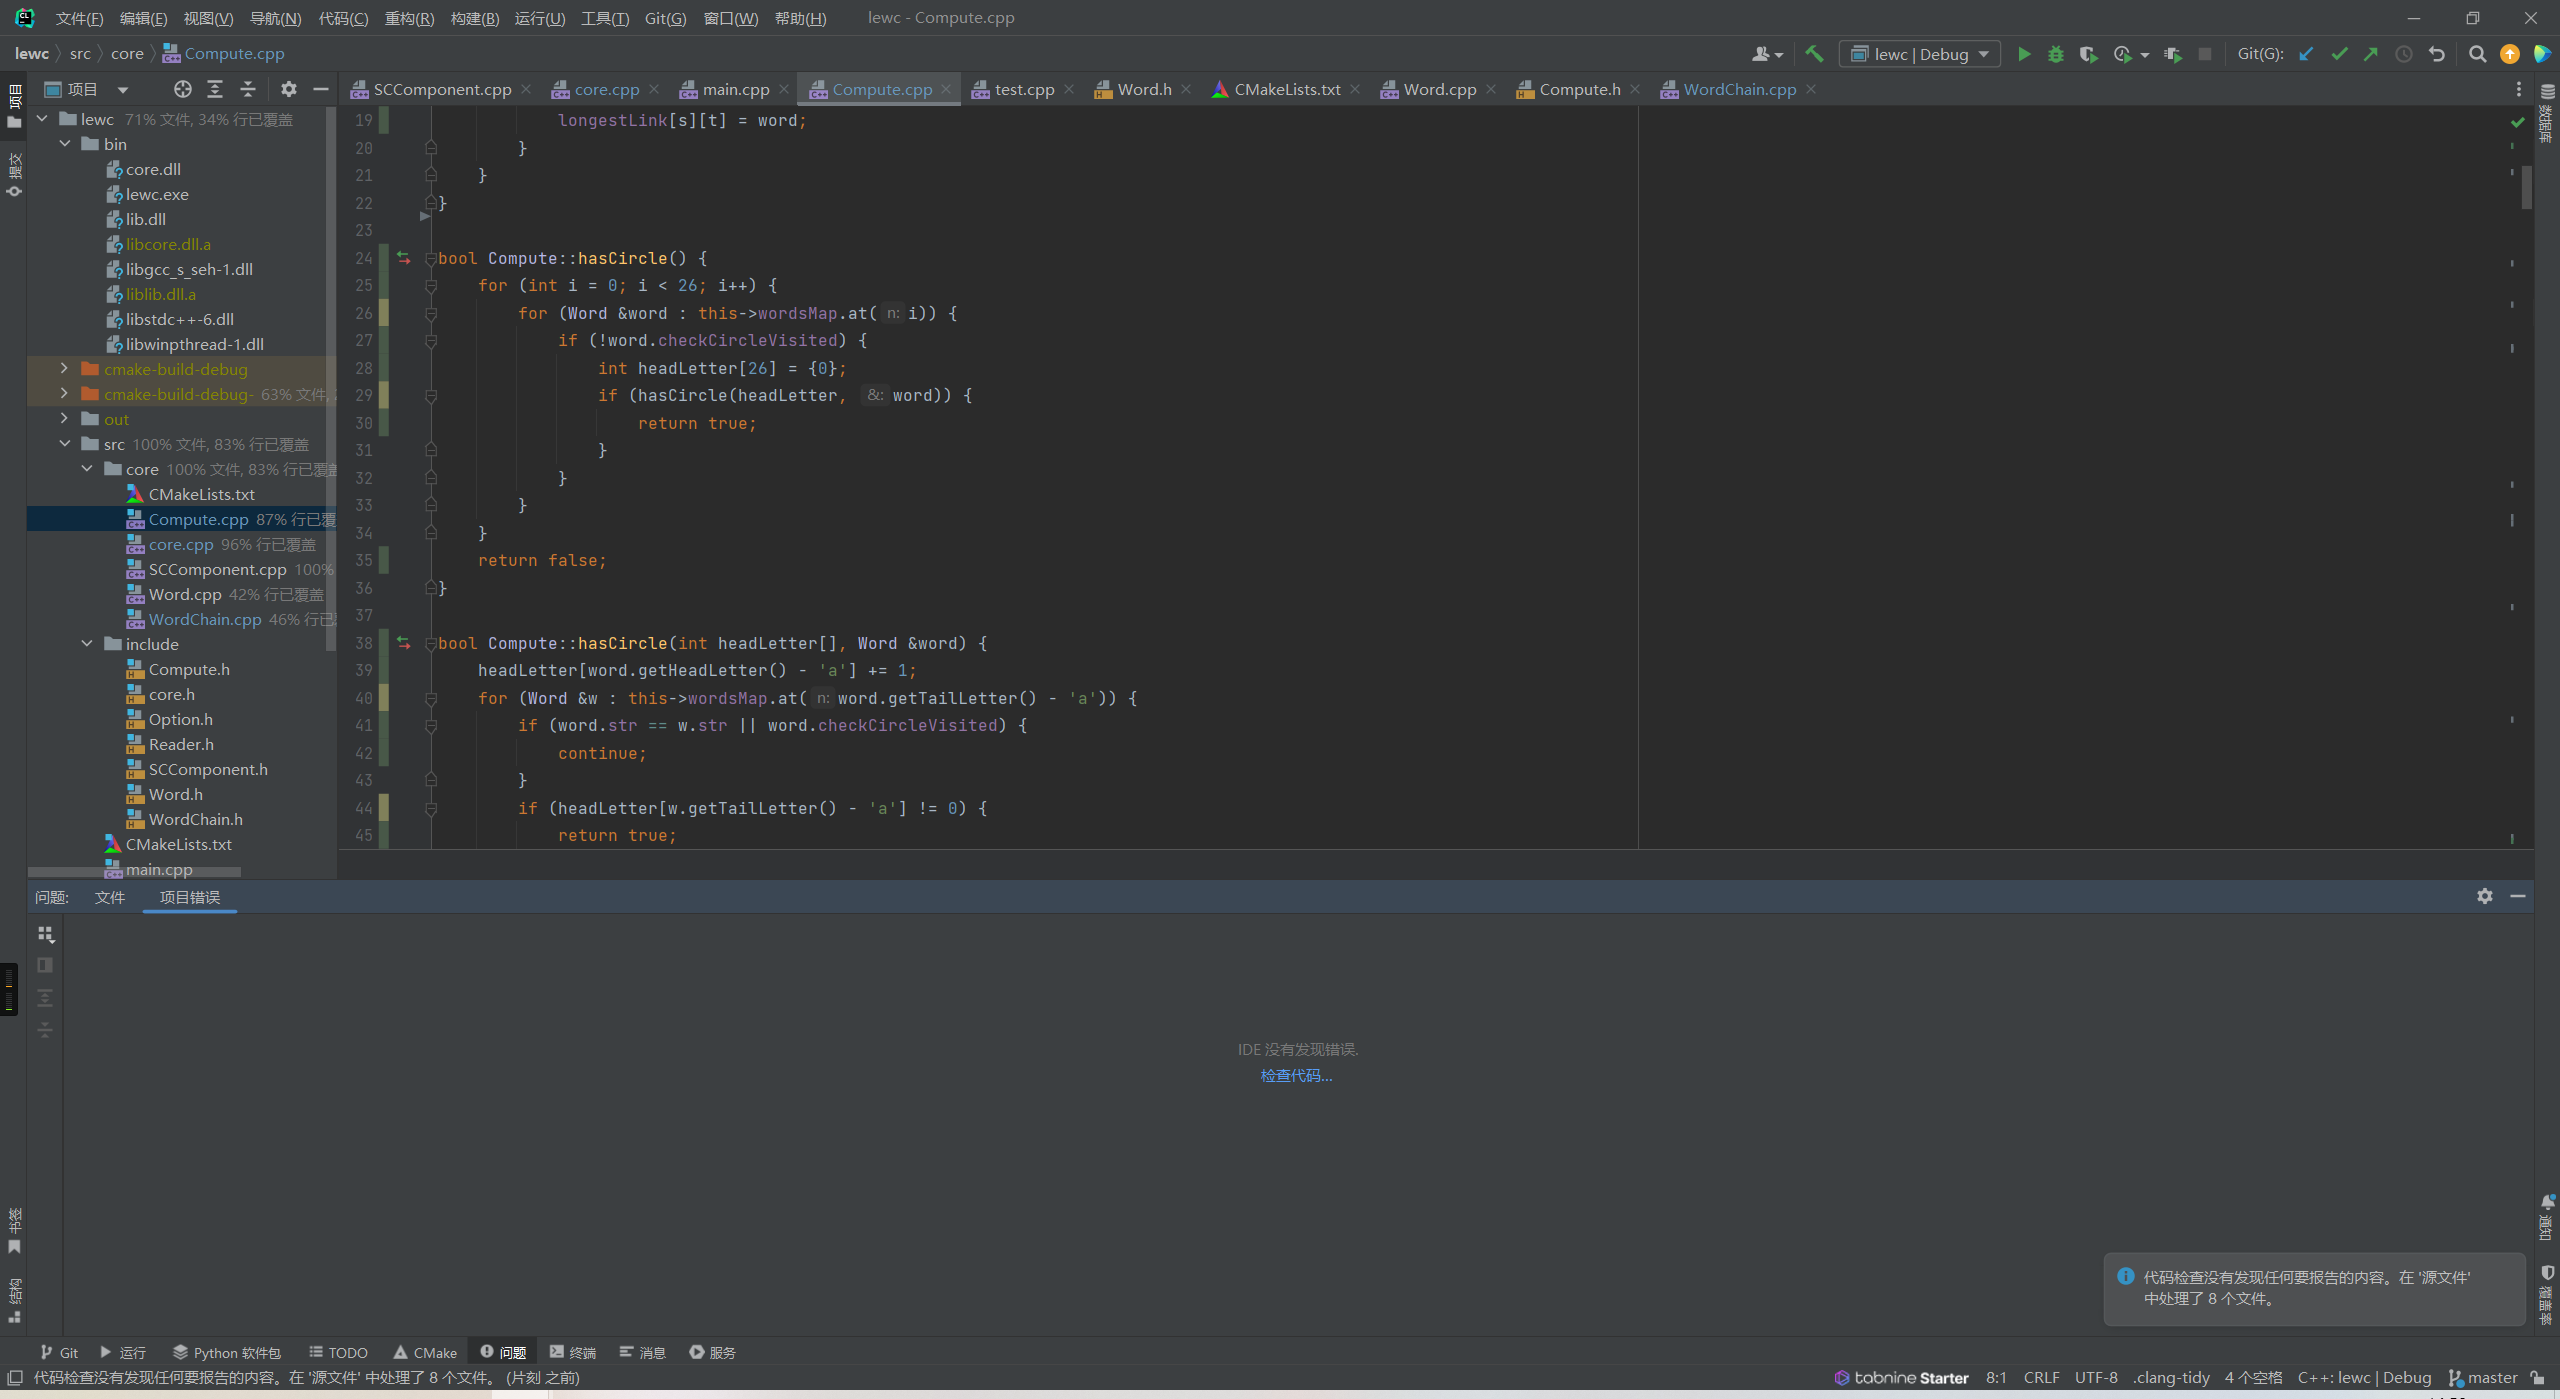
5.编译器编译通过无警告的截图
6.UML类图显示计算模块部分各个实体之间的关系
7.计算模块接口部分性能改进
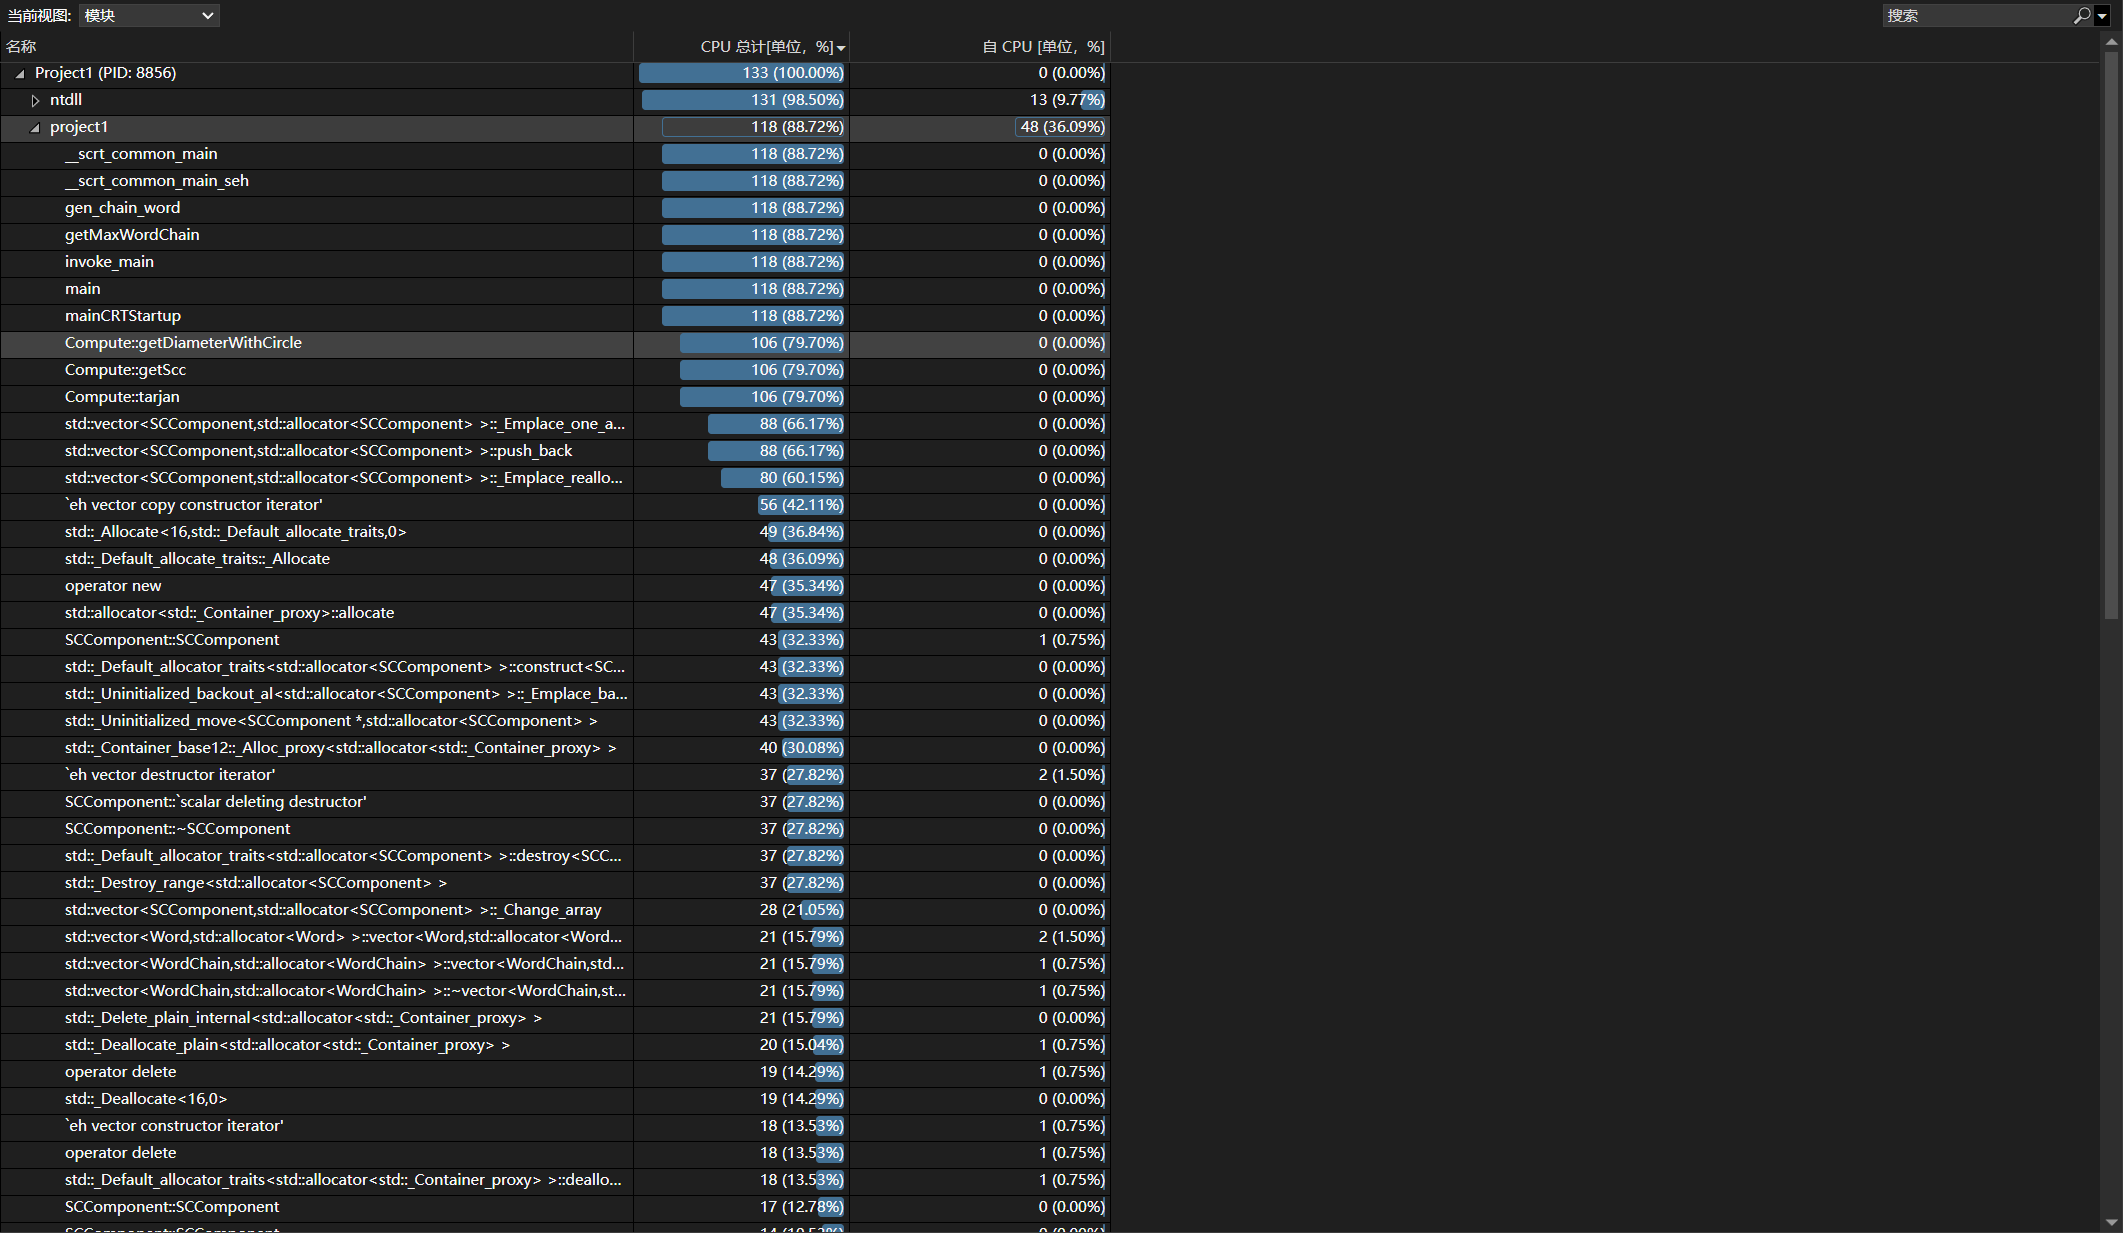
本次设计中使用Visual Studio 2022自带的性能分析工具进行性能分析。
- 测试样例:apple,alpha,dog,hand,element,than,apple,eir,nop,pua,ahead
- 测试参数:lewc.exe -w -r ./test.txt
- core.dll模块调用接口:int _num = gen_chain_word((char **)words, len, _result, 0, 0, 0, true);
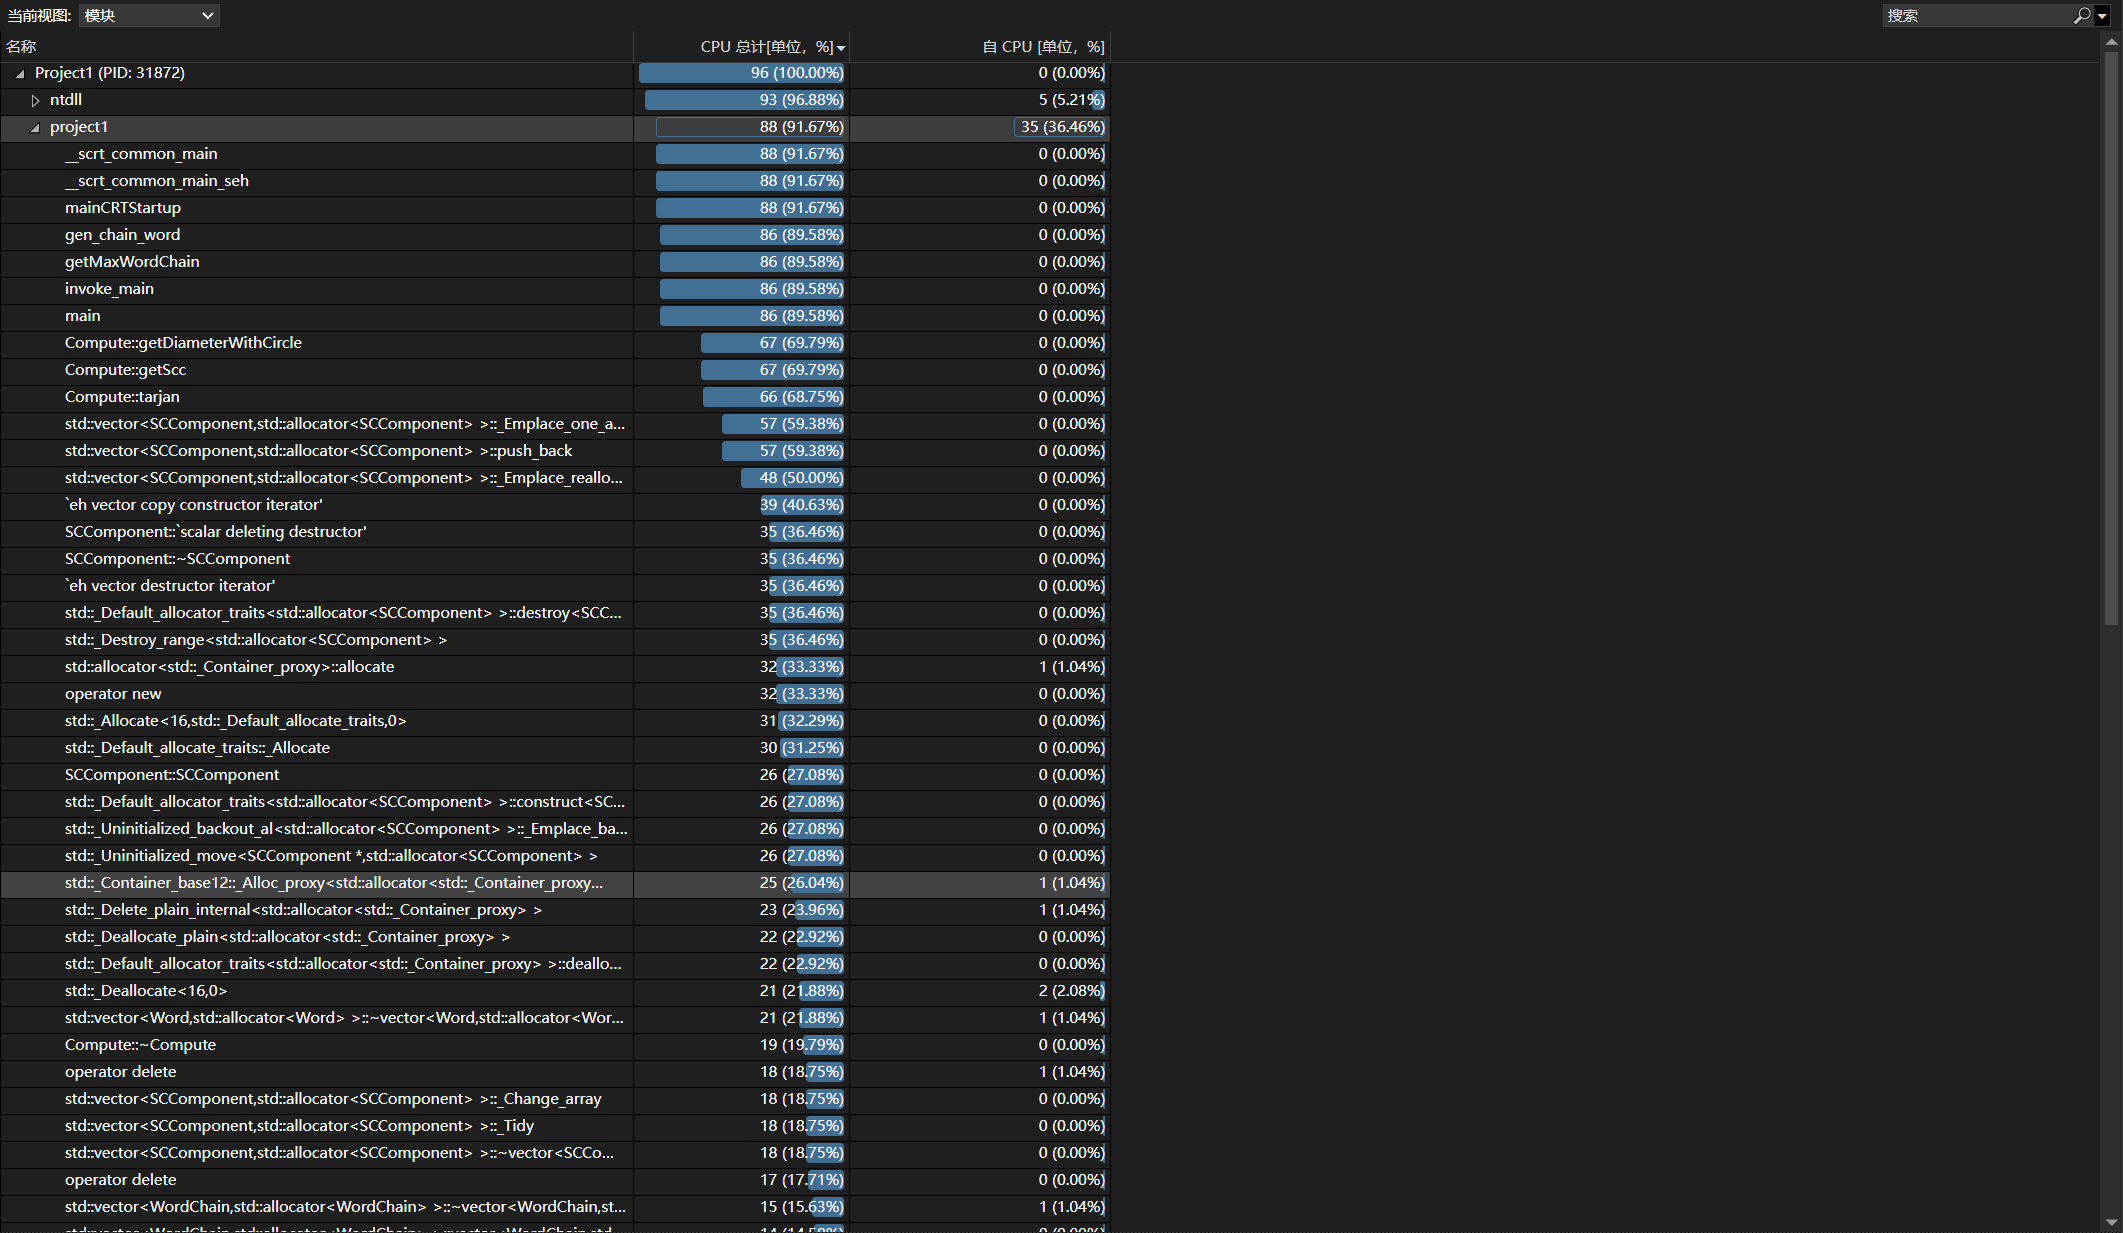
分析结果如下图,由图可见,核心计算模块Compute::getDiameterCircle占用了程序运行的大部分时间,约80%。
该计算模块的功能是寻找允许成环时的最长的单词链。优化前我们使用了DFS搜索了所有合法的单词链,并选出了最长的一个单词链。这种方法的时间复杂度是$O(|V|\cdot|E|)$。我们通过抽取强连通分量的方法,将若干互相可以通过若干单词连接的字母合并为一个强连通分量。接下来,我们先在强连通分量内部使用DFS搜索任意两点间的最长路径,再对所有强连通分量进行拓扑排序。按照排序结果,对每个强连通分量,对其中字母$i$按以下规则进行动态规划:
首先,更新以字母$i$结尾,并且不包含$i$所在强连通分量其它字母的最长单词序列长度$dp_{in}[i]$,表示从其它SCC进入此SCC的最长单词序列:
$$
dp_{in}[i]\leftarrow \max_j{dp_{out}[j]+e_{ji}}(scc[i]\neq scc[j])
$$
然后,更新以字母$i$结尾,并且包含$i$所在强连通分量其它字母的最长单词序列长度$dp_{out}[i]$,表示从此SCC离开时的最长单词序列:
$$
dp_{out}[i]\leftarrow \max_j{dp_{in}[j]+\max{p_{ji}}}(scc[i]= scc[j])
$$
对应的$rec_{in}$与 $rec_{out}$以相同的逻辑进行更新。优化后,最优的情况是无环时,时间复杂度为$O(|E|)$;最坏的情况是只有一个SCC,时间复杂度为$O(|V|\cdot|E|)$,退化为原来的情况。
经过优化后的分析结果如下图,图中显示核心计算模块Compute::getDiameterCircle占用时间已经下降到了70%。
8.阅读 Design by Contract,Code Contract 的内容,并描述这些做法的优缺点,说明你是如何把它们融入结对作业中的
8.1.Design by Contract
Design by Contract是契约式编程,是一种软件设计方法。契约式编程要求软件设计者为软件组件定义正式的,精确的并且可验证的接口。契约式编程强调三个概念:前置条件、后置条件和不变式。
优点:调用者必须提供正确的参数,被调用者必须保证正确的结果和调用者要求的不变性。双方都有必须履行的义务,也有使用的权利,这样就保证了双方代码的质量,提高了软件工程的效率和质量。
缺点:对于程序语言有一定的要求,契约式编程需要一种机制来验证契约的成立与否。此外,契约式编程并未被标准化,因此项目之间的定义和修改各不一样,给代码造成很大混乱。
在本次设计中,我们约定了core.dll的四个API接口的前置条件、后置条件和不变式。不过,为了交流的方便,我们并没有采取形式化的语言表述,只是口头约定。
| 参数 | 意义 |
|---|---|
| words | 传入单词,每一个元素为char*类型 |
| len | 传入单词长度 |
| results | 保存计算结果,调用者需要开辟20000个char*类型的指针,同时需要释放返回值数量的空间 |
| head | 传入单词链首字母,head = 0为不指定 |
| tail | 传入单词链尾字母,tail = 0为不指定 |
| reject | 传入单词链不允许出现的首字母,reject = 0为不指定 |
| enable_loop | 是否允许存在环 |
| 返回值 | result数组长度 |
| 异常 | 1.输入单词存在非法环 2.输入单词数量len <= 0 3.输入的head、tail、reject字母不合规 |
8.2.Code Contract
Code Contract是微软推出的一款代码契约插件,插件采用前置条件、后置条件和对象不变量的形式,对 .NET 编程提供运行时检查、静态检查和文档生成。
Code Contract是Design by Contract具体实现的一款插件,优缺点同Design by Contract。
本次设计中,并未采用这款插件。
9.计算模块部分单元测试展示
我们使用Google的gtest作为单元测试的模板,其中一个测试样例代码如下:
//-w -h h -t g -j a -r无
TEST(core_test, gen_chain_word4) {
    int len = 11;
    const char *words[] = {"apple", "alph", "dog", "hand", "group", "element", "than", "apple", "eir", "nop", "moon"};
    int res_num = 2;
    const char *result[] = {"hand", "dog"};
    char **_result = new char *[SIZE];
    int _num = gen_chain_word((char **)words, len, _result, 'h', 'g', 'a', false);
    EXPECT_EQ(res_num, _num);
    for (int i = 0; i < res_num; i++) {
        EXPECT_STREQ(result[i], _result[i]);
        free(_result[i]);
    }
    free(_result);
}
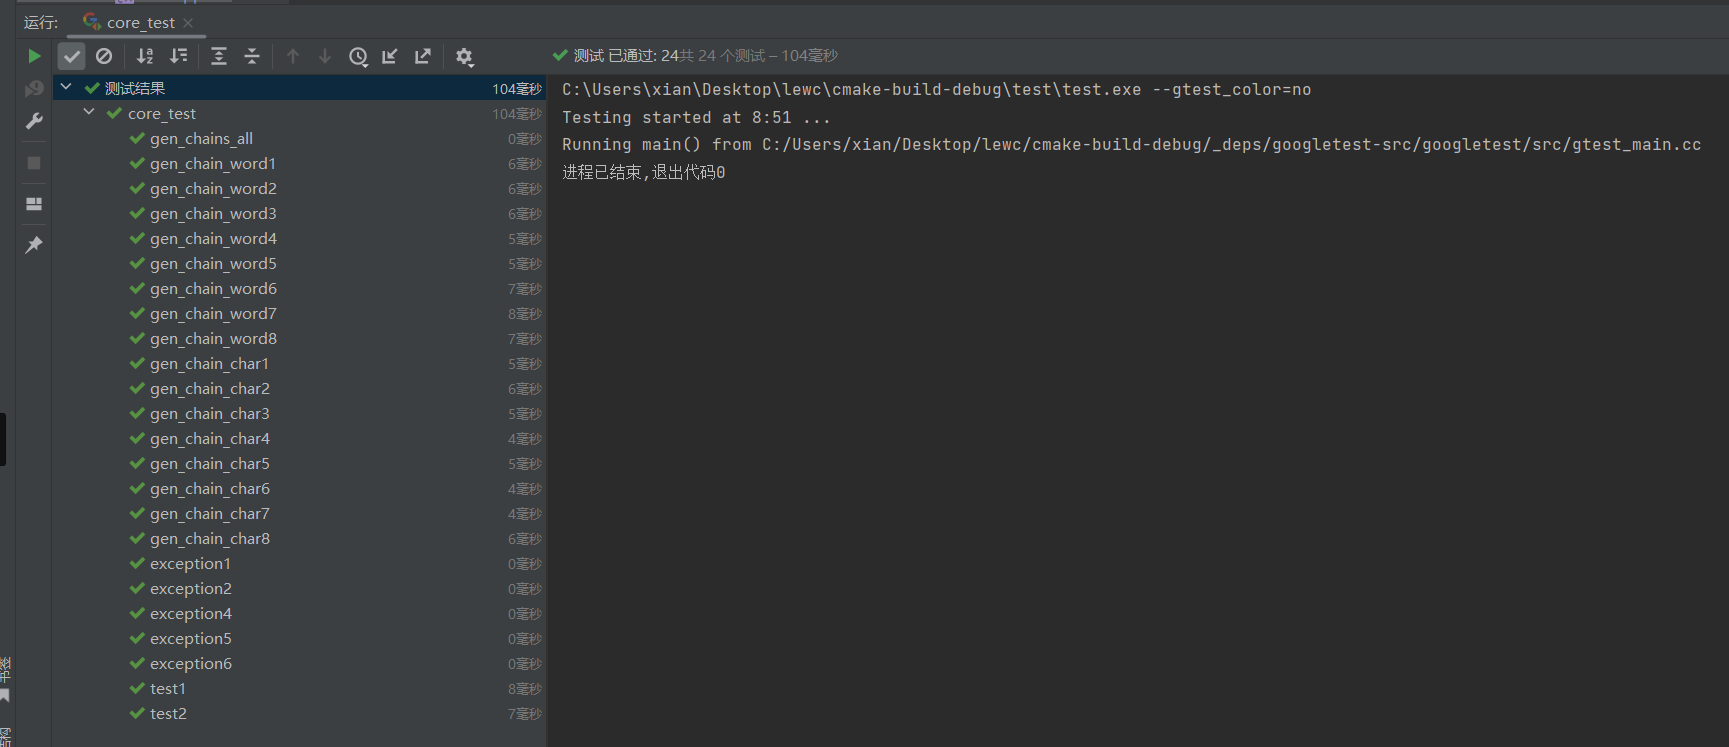
我们针对代码设计了24个测试样例,下图为测试全部通过的截图:
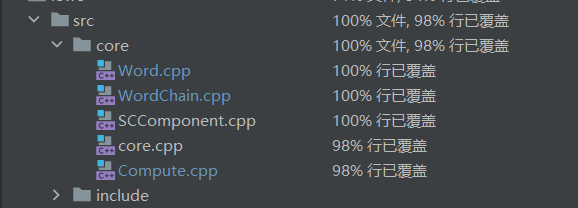
覆盖率结果如图:
10.计算模块部分异常处理说明
10.1.输入单词存在非法环
当输入的单词中存在非法环时,会在经过判断后抛出如下异常:
// allowCircle 为题目中的-r参数
if (!allowCircle && compute.hasCircle()) {
    throw logic_error("The words contain a circle.");
}
其中对单词链中是否存在环的判断是在compute中的hasCircle()中进行的,采用dfs的方法,判断代码如下:
bool Compute::hasCircle() {
    for (int i = 0; i < 26; i++) {
        for (Word &word : this->wordsMap.at(i)) {
            if (!word.checkCircleVisited) {
                int headLetter[26] = {0};
                if (hasCircle(headLetter, word)) {
                    return true;
                }
            }
        }
    }
    return false;
}

bool Compute::hasCircle(int headLetter[], Word &word) {
    headLetter[word.getHeadLetter() - 'a'] += 1;
    for (Word &w : this->wordsMap.at(word.getTailLetter() - 'a')) {
        if (word.str == w.str || word.checkCircleVisited) {
            continue;
        }
        if (headLetter[w.getTailLetter() - 'a'] != 0) {
            return true;
        }
        if (hasCircle(headLetter, w)) {
            return true;
        }
    }
    headLetter[word.getHeadLetter() - 'a'] -= 1;
    word.checkCircleVisited = true;
    return false;
}
针对性的测试样例如下:
TEST(core_test, exception2) {
    int len = 4;
    const char *words[] = {"ab", "bc", "cd", "da"};
    char **_result = new char * [SIZE];
    try {
        gen_chain_word((char **) words, len, _result, 0, 0, 0, false);
    } catch (const std::exception &e) {
        EXPECT_STREQ(e.what(), "The words contain a circle.");
    }
}
10.2.输入单词数量len <= 0
当调用者传入的单词数量len <= 0时,会抛出如下异常:
if (len <= 0) {
    throw logic_error("Please ensure the words length is greater than zero.");
}
针对性的测试样例如下:
TEST(core_test, exception6) {
    int len = 0;
    const char **words = nullptr;
    char **_result = new char * [SIZE];
    try {
        gen_chain_char((char **) words, len, _result, 0, 0, 0, true);
    } catch (const std::exception &e) {
        EXPECT_STREQ(e.what(), "Please ensure the words length is greater than zero.");
    }
}
10.3.传入的head、tail、reject字母不合规
传入的head、tail、reject字母的值必须是0或a-z或A-Z,当出现非以上情况时,抛出异常:
void checkLetter(char head, char tail, char reject) {
    if (!isalpha(head) && head != 0) {
        throw logic_error("The head letter need to be a-z or A-Z.");
    }
    if (!isalpha(tail) && tail != 0) {
        throw logic_error("The tail letter need to be a-z or A-Z.");
    }
    if (!isalpha(reject) && reject != 0) {
        throw logic_error("The reject letter need to be a-z or A-Z.");
    }
}
针对性的测试样例如下:
TEST(core_test, exception3) {
    int len = 4;
    const char *words[] = {"ab", "bc", "cd", "da"};
    char **_result = new char * [SIZE];
    try {
        gen_chain_word((char **) words, len, _result, 12, 0, 0, false);
    } catch (const std::exception &e) {
        EXPECT_STREQ(e.what(), "The head letter need to be a-z or A-Z.");
    }
}
11.界面模块的详细设计过程
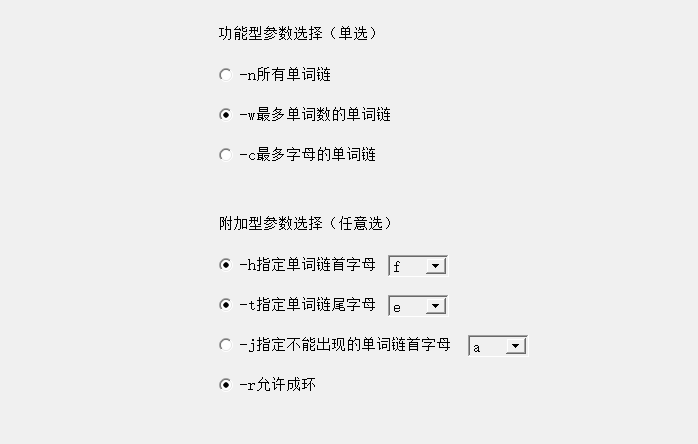
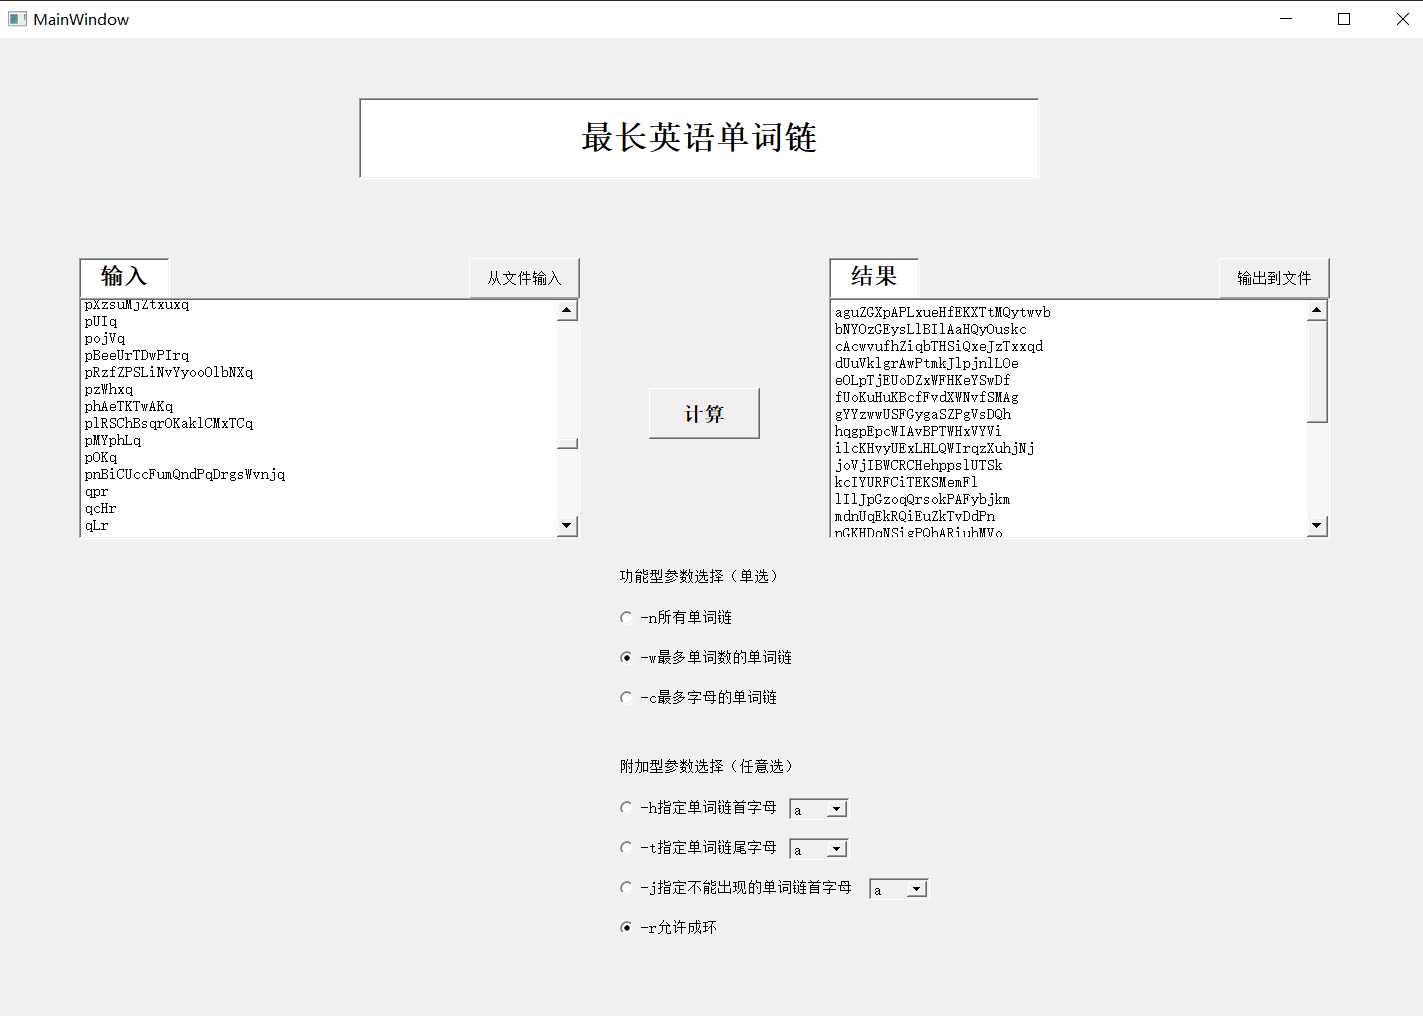
界面模块采用QT5为框架,通过Desinger可视化布置界面。界面模块主要被划分为两个部分,分别是是参数区和输入输出区。
参数区分为功能型参数选择和附加型参数选择。其中功能型参数选择采用的是互斥的radioButton进行选择,保证同时只有一个功能型参数可以被选中。附加型参数区采用的是非互斥的radioButton,可以选择任意数量的附加型参数,其中-h、-t、-j参数后采用comboBox下拉菜单选择对应的字母。
输入区和输出区具有相同的设计,分别包含一个textEdit文本编辑框,和一个pushButton文件IO。pushButton与事件采用管道进行绑定,信号为clicked()。点击按钮后,进行文件选择,从文件输入或输出到文件。从文件输入的结果好显示在输入区的textEdit,计算的结果显示在输出区的textEdit。
connect(ui->pushButton_2, SIGNAL(clicked()), this, SLOT(loadFromFile()));
connect(ui->pushButton_3, SIGNAL(clicked()), this, SLOT(saveToFile()));
最终界面如下图:
12.界面模块与计算模块的对接
GUI通过LoadLibraryA("core.dll")导入core.dll库,将获取到的参数通过约定的API接口调用core.dll。需要注意计算结束的时候释放导入的库和core.dll中申请的空间。
HMODULE core = LoadLibraryA("core.dll");
int ret;
char **result = new char * [1000];
try {
    if (n) {
        ret = gen_chains_all(words, words_len, result);
    } else if (w) {
        ret = gen_chain_word(words, words_len, result, h_char, t_char, j_char, r);
    } else if (c) {
        ret = gen_chain_char(words, words_len, result, h_char, t_char, j_char, r);
    }
} catch (exception &e) {
    QMessageBox::warning(this, "Warning", e.what());
    return;
}
13.描述结对的过程
结对编程采用线上+线下的方式,线上采用的是腾讯会议,线下通常去的地点是H座10楼的wings。
考虑到任务量,仅核心模块是采用结对的方式实现的,其他部分是约定分工个人完成,然后提交pr给另一人审核。
14.结对编程的优点和缺点
优点:
- 结对编程可以快速给出问题的解决方案,能力上可以互补
- 结对编程可以提高代码的质量,有效减少bug
- 结对编程可以降低学习成本,两人可以一边编程,一边进行知识的经验的共享
缺点:
- 学校中难以找到合适的适合结对编程的场所
- 需要结对编程的两人花费更多的精力和时间
15.PSP表格记录实际花费时间
实际花费时间见2中PSP表格,表格记录了预估花费时间和实际花费时间。
16.附加题:界面模块,测试模块和核心模块的松耦合
我们组与另一小组进行了GUI、测试模块与核心模块的互换工作。
另一小组成员:
- 张峻源 19375450
- 秦铭悦 20373843
这次的交换活动主要遇到两个问题。
- 我们的core.dll的接口设计不合理,导致使用时需要进入过多的头文件,不合理原因见上文的3。最新的dev-combine已修改。
- 和其他小组进行交换的时候需要core.dll和core.h,然后使用另一小组的core.h文件重新编译后才能使用,尽管两个小组的API接口都是一样的,但一些头文件细节上的不同都是需要重新编译才能相互运行。
相关推荐
【雷达信号处理】数字下变频(DDC)(Matlab代码实现)
内容概要:本文围绕雷达信号处理中的数字下变频(DDC)技术,详细阐述了其在Matlab环境下的实现方法与工作原理。DDC作为雷达接收机中的核心技术,主要用于将高频中频信号高效转换为低频基带信号,以便于后续的数字信号处理。文章系统介绍了DDC的三大核心步骤:混频实现频谱搬移、低通滤波抑制带外噪声与干扰、以及抽取降低采样率以减轻数据处理负担。文中提供了完整的Matlab代码实例,并通过仿真结果直观展示了信号在时域和频域的变化过程,有效验证了DDC设计的正确性与有效性。该资源对于理解现代雷达与通信系统前端处理机制具有重要价值。; 适合人群:具备一定Matlab编程基础和数字信号处理理论知识的研究生、科研人员及工程技术人员。; 使用场景及目标:①深入学习和掌握数字下变频(DDC)的基本原理、数学模型及其实现流程;②利用Matlab对雷达或通信系统中的中频信号进行仿真处理与性能验证;③为信号检测、参数估计等后续高级处理算法提供高质量的基带信号预处理支持。; 阅读建议:在学习过程中,应结合提供的Matlab代码进行逐行调试与运行,重点观察混频、滤波和抽取每一环节对信号时域波形和频谱分布的影响。建议主动修改信号参数(如载频、带宽)和DDC系统参数(如滤波器截止频率、抽取因子),探究不同参数配置对信号保真度和处理效率的影响,从而深化对DDC技术细节的理解。
基于数据挖掘的京东商城商品推荐系统设计与实现(代码+数据库+LW)
摘 要 随着电商行业竞争加剧,京东商城商品品类激增,用户“信息过载”问题突出——传统货架式展示难以匹配个性化需求,致使用户购物效率低、平台转化率与粘性下滑。在此背景下,依托SpringBoot框架的快速开发特性与MySQL数据库的稳定存储能力,设计实现商品推荐系统,成为解决京东用户体验痛点、提升核心竞争力的关键。研究意义在于以“SpringBoot+MySQL”技术组合打破“人找货”传统模式,转向“货找人”精准服务;核心问题聚焦于借该技术架构整合用户与商品信息,实现个性化推荐功能与系统高效管理的协同落地。 研究以京东用户核心行为与商品关键属性为对象,采用“SpringBoot开发+MySQL存储+模块化开发”综合方法。具体步骤为:先搭建技术架构,基于SpringBoot设计分层开发结构,依托MySQL实现用户与商品信息的稳定存储及交互;再划分功能模块,用户模块涵盖注册登录、个人中心、禅选商品、订单管理等,满足个性化操作需求;管理员模块包含数据看板分析、预测信息管理、禅选商品管理等,支撑推荐效果监控与运营决策;最后构建推荐逻辑,结合用户行为特征与商品属性关联关系,实现商品精准匹配与需求趋势预判。 系统落地应用后核心成果显著:个性化推荐精准度大幅提升,有效减少用户筛选商品的时间成本;系统管理效率升级,管理员借MySQL实现信息高效交互,通过数据看板实时掌握用户偏好与推荐转化动态,预测功能可提前辅助运营决策;用户全流程体验改善,地址同步、客服聊天、收藏管理等功能形成服务闭环,增强用户平台粘性。综上,该系统依托技术优势解决京东“信息过载”与推荐低效问题,实现“个性化推荐+高效管理”双重目标,为商品运营优化提供支撑。模块化设计具备可扩展性,后续可基于现有架构迭代功能,适配更多电商场景。 关键词:个性化推荐,推荐系统,Spring Boot,MySQL
wxhook_产物_20261009
包含 wxhook_产物_20261009.zip 的资源包
海上水面目标检测数据集VOC+YOLO格式12316张10类别.md
亲爱的CSDN用户: 首先感谢你点进这个资源页面。我需要提前说明一个重要情况: **本资源原本已设置为“0积分下载”**,即作者希望完全免费共享。但CSDN平台有时会根据文件的下载热度、文件大小、用户权限等因素,**自动将部分资源的积分调整为非0数值**(如1积分、2积分、5积分等)。这是平台系统的自动行为,而非作者本人的设定。 **因此,如果你当前看到该资源的下载所需积分不是0(例如显示为1、2、3……),请谨慎决定是否下载。** 如果你按照非0积分支付并下载后发现资源内容不符合预期、链接失效,或者实际上该资源本应是免费的,作者无法为此承担积分损失或退还操作。**强烈建议:仅在页面显示为0积分时进行下载。** 另外,本资源描述中**并未直接提供具体的下载地址或外部链接**,因为它本身是一个通过CSDN官方上传通道提交的文件/内容包。如果你看到描述中没有外部网盘地址,这是正常的——资源文件应通过CSDN内置的“下载”按钮获取。若因平台积分显示异常导致你支付了积分,请优先联系CSDN客服咨询积分退还政策,作者没有权限修改平台自动设定的积分值。 感谢你的理解与支持。技术分享本应开放,但受限于平台规则,特此提醒如上。祝学习进步!
毕业设计含文档和代码vb+access工资管理系统(系统+答辩PPT+论文+开题报告+外文翻译)
毕业设计含文档和代码vb+access工资管理系统(系统+答辩PPT+论文+开题报告+外文翻译)




