

 日复一日伐树的熊哥

Phoenix之全局索引(Global Index)使用
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
目录
索引使用
全局索引(Global Indexing)
名词解释:
全局索引,适用于读多写少的业务场景。使用Global indexing在写数据的时候开销很大,因为所有对数据表的更新操作(DELETE, UPSERT VALUES and UPSERT SELECT),都会引起索引表的更新,而索引表是分布在不同的数据节点上的,跨节点的数据传输带来了较大的性能消耗。在读数据的时候Phoenix会选择索引表来降低查询消耗的时间。在默认情况下如果想查询的字段不是索引字段的话索引表不会被使用,也就是说不会带来查询速度的提升。
使用前提(开发、测试、生产环境已准备完毕)
做好hbase安装与phoenix连接的相关配置
使用示例
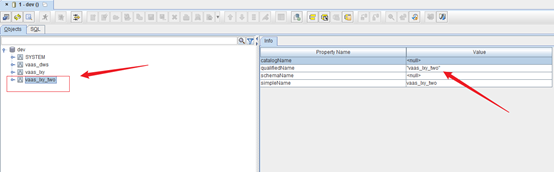
创建phoenix的schema
示例的schema是vaas_lxy_two
create schema if not exists "vaas_lxy_two";
创建phoenix的表
表名:vaas_lxy_tb
列簇:C1
主键:id
压缩算法:Snappy (可选)
create table if not exists "vaas_lxy_two"."vaas_lxy_tb"("id" varchar not null primary key,"C1"."name" varchar,"C1"."sex" varchar)COMPRESSION='Snappy';

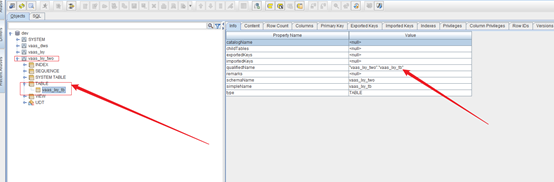
注意:列族只能在非主键列中进行指定。
创建phoenix的全局索引
索引名称:id_index
索引字段:id
包含字段:C1.name;C1.sex
列簇:C1

create index id_index on "vaas_lxy_two"."vaas_lxy_tb"("id") include ("C1"."name","C1"."sex");
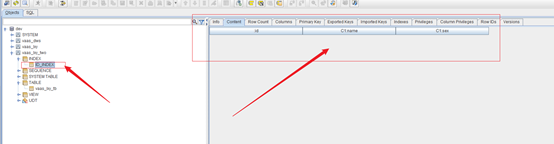
注意:查询涉及到的条件字段和查询字段必须都要在索引字段或者include字段范围内!!!
phoenix插入数据
upsert into "vaas_lxy_two"."vaas_lxy_tb"("id","C1"."name","C1"."sex") values('1','zhangsan','男');
upsert into "vaas_lxy_two"."vaas_lxy_tb"("id","C1"."name","C1"."sex") values('2','李四','男');
upsert into "vaas_lxy_two"."vaas_lxy_tb"("id","C1"."name","C1"."sex") values('3','七妹','女');
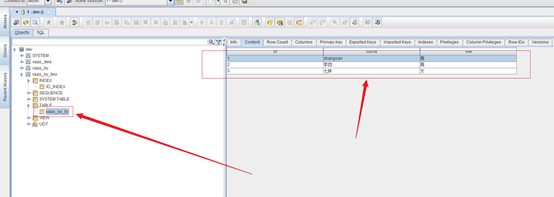
数据表数据:
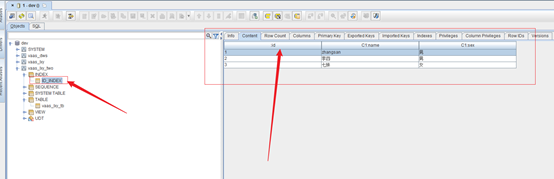
索引表数据:
Phoenix更新数据
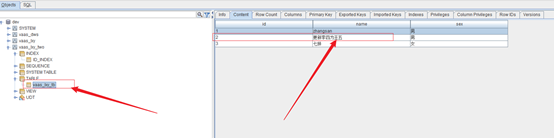
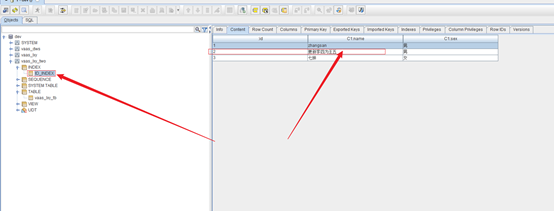
upsert into "vaas_lxy_two"."vaas_lxy_tb"("id","C1"."name","C1"."sex") values('2','更新李四为王五','男');
数据表数据:
索引表数据:
相关推荐
HBase SQL Phoenix
Secondary Indexing in Phoenix 博文链接:https://57832638.iteye.com/blog/2013579
phoenix介绍.docx
在HBase中,只有一个单一的按照字典序排序的rowKey索引,当使用rowKey来进行数据查询的时候速度较快,但是如果不使用rowKey来查询的话就会使用filter来对全表进行扫描,很大程度上降低了检索性能。而Phoenix提供了二级索引技术来应对这种使用rowKey之外的条件进行检索的场景。
云HBaseSQL及分析PhoenixSpark.pdf
在2018年1月的数据库直播大讲堂峰会HBase专场,瑾谦/沐远关于云HBaseSQL及分析的PPT
藏经阁-云HBaseSQL及分析.pdf
藏经阁-云HBaseSQL及分析.pdf
利用Phoenix为HBase创建二级索引
为什么需要Secondary Index对于HBase而言,如果想精确地定位到某行记录,唯一的办法是通过rowkey来查询。如果不通过rowkey来查找数据,就必须逐行地比较每一列的值,即全表扫瞄。对于较大的表,全表扫瞄的代价是不可接受的。但是,很多情况下,需要从多个角度查询数据。




