

 OpenMMLab

【7班】语义分割与MMSegmentation 理论课笔记
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
目录
- 0. 写在前面
- 1. 语义分割的基础
- 1.1 什么是语义分割
- 1.2 语义分割的应用
- 1.3 图像分割任务的不同层次
- 2. 深度学习时代演进历程
- 2.1 语义分割的基本思路
- 2.1.1 按颜色分割
- 2.1.2 逐像素分类
- 2.1.3 重复区域优化
- 2.1.4 全连接卷积化
- 2.2 深度学习下的语义分割模型
- 2.2.1 2016 全卷积网络(FCN)
- 双线性插值
- 转置卷积
- FCN 的流程
- 基于多层次特征的上采样
- 2.2.2 2015 UNet
- 2.2.3 上下文信息
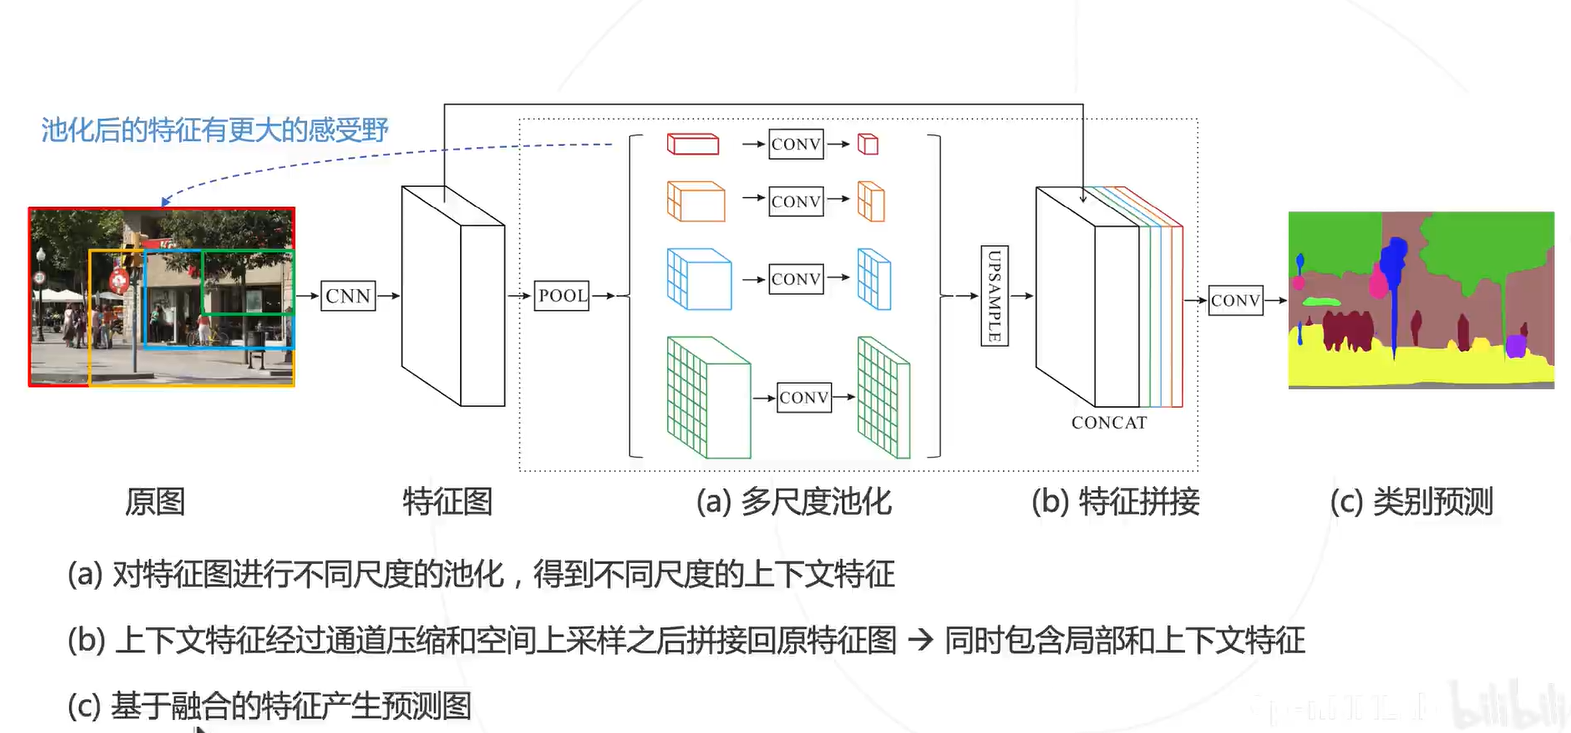
- 2.2.4 2016 PSPNet
- 流程
- 2.2.5 空洞卷积和 DeepLab 模型
- 空洞卷积
- DeepLab
- 条件随机场(CRF)
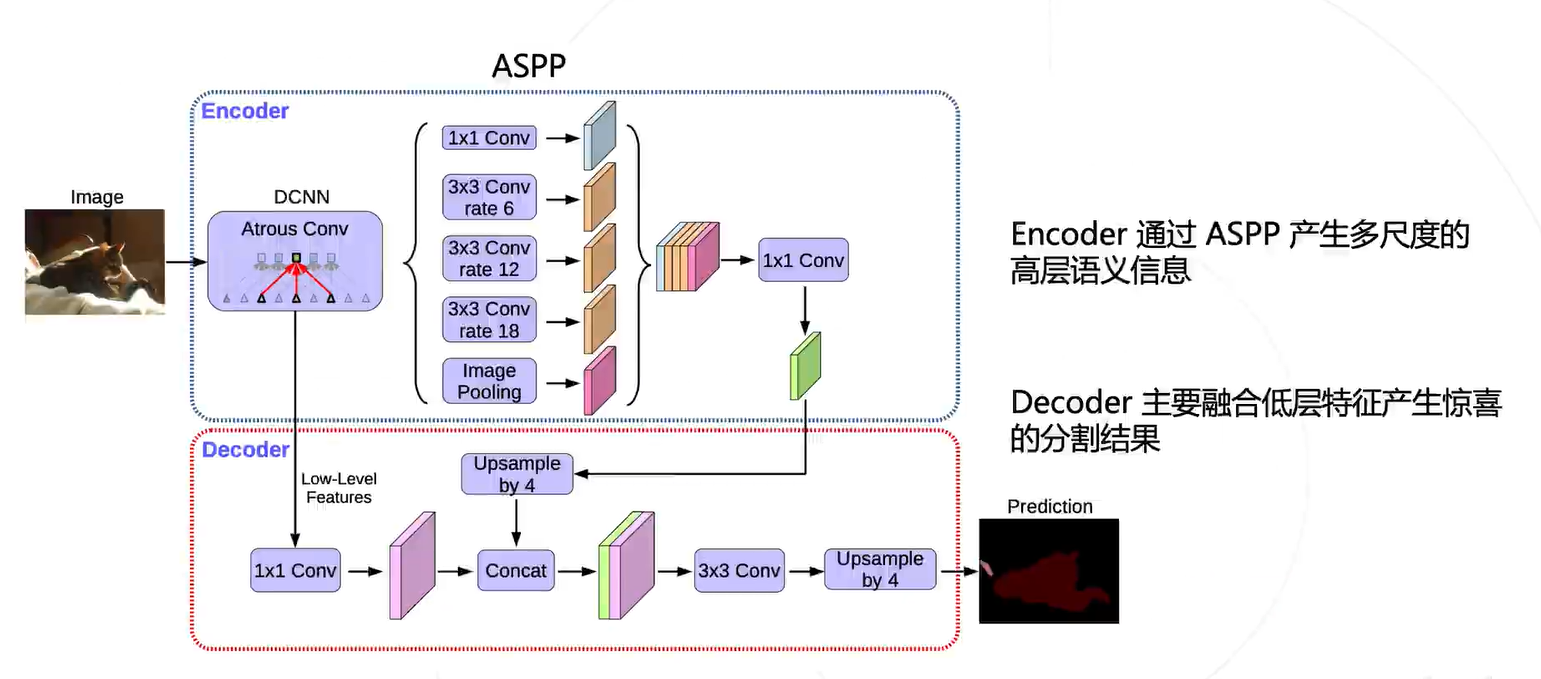
- 空间金字塔池化(ASPP)
- DeepLab v3+
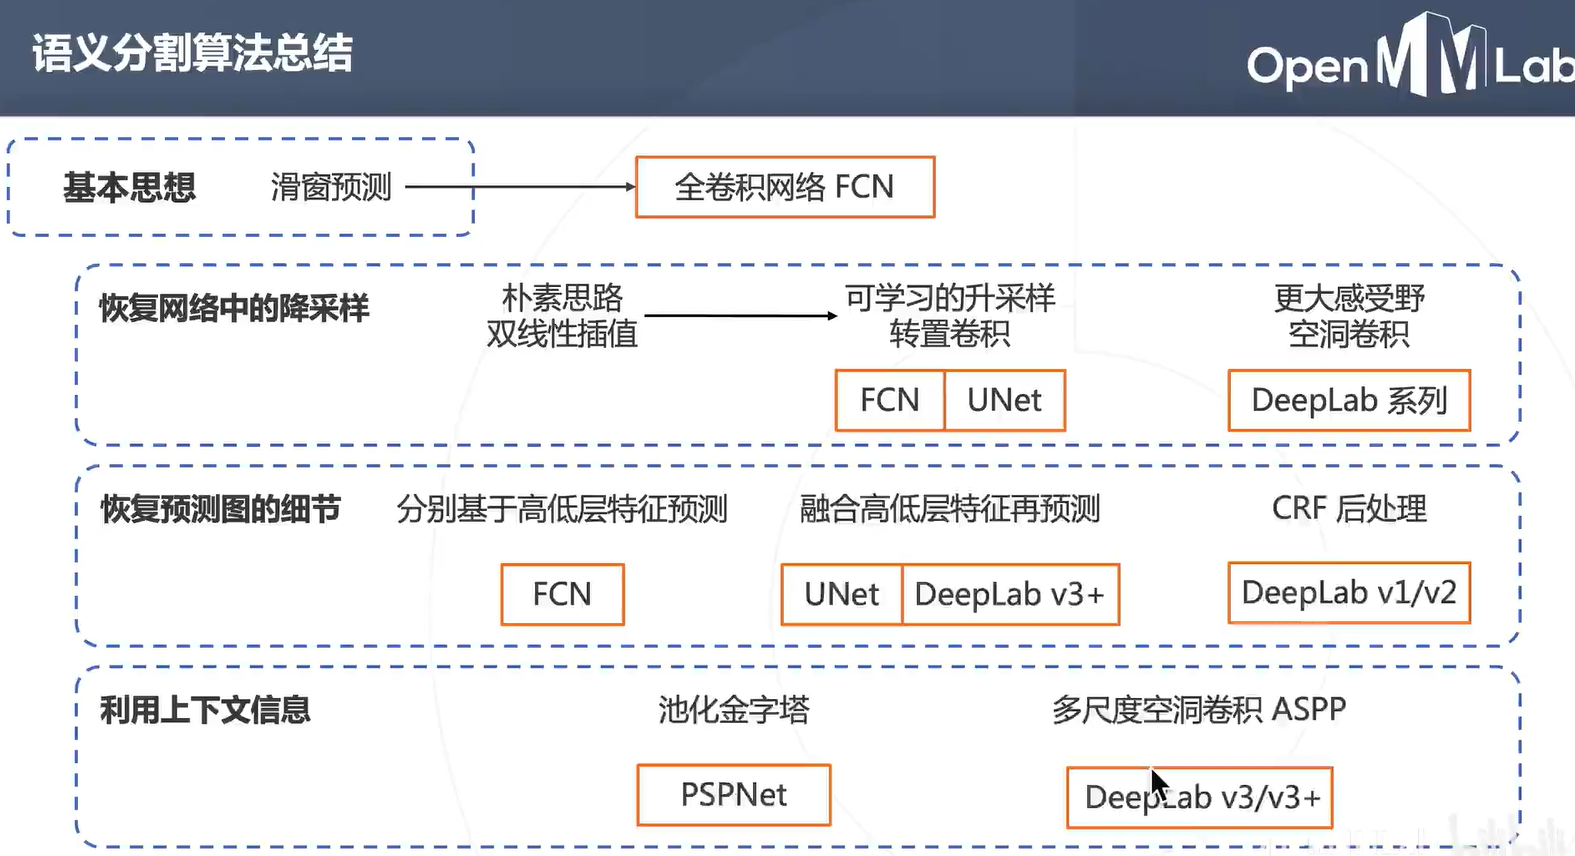
- 2.2.5 小结
- 2.3 前沿的语义分割算法
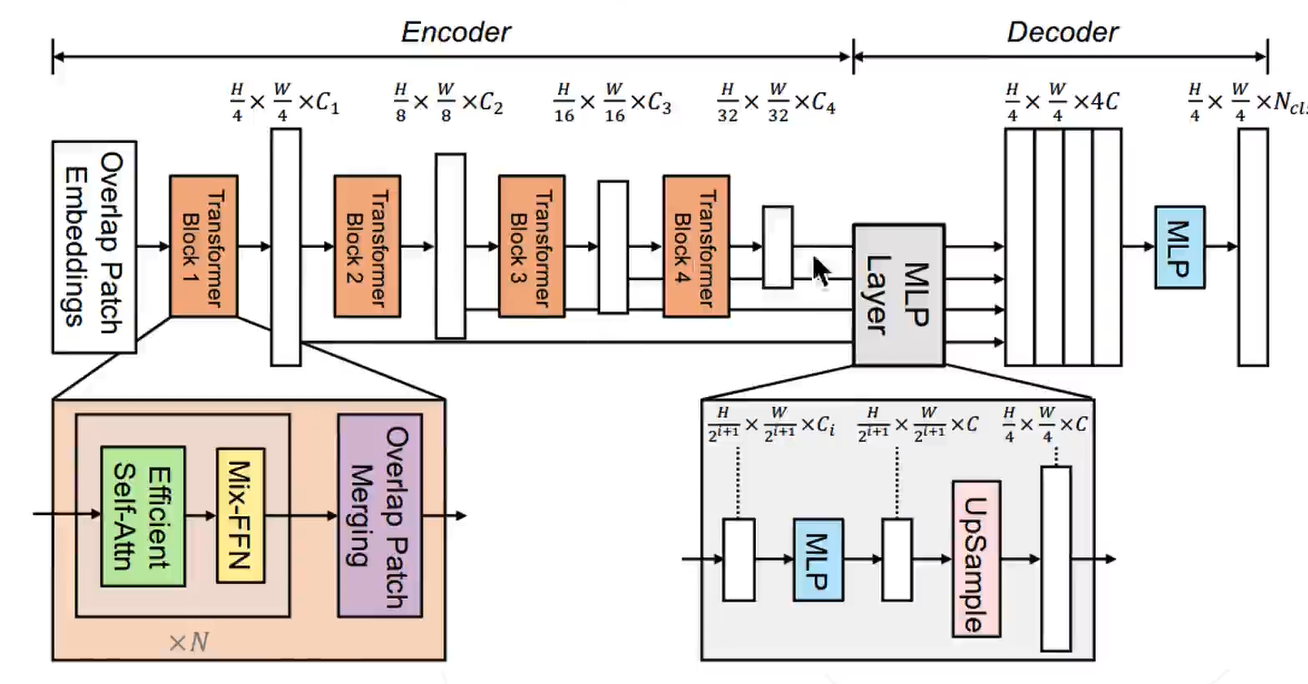
- 2.3.1 SegFormer
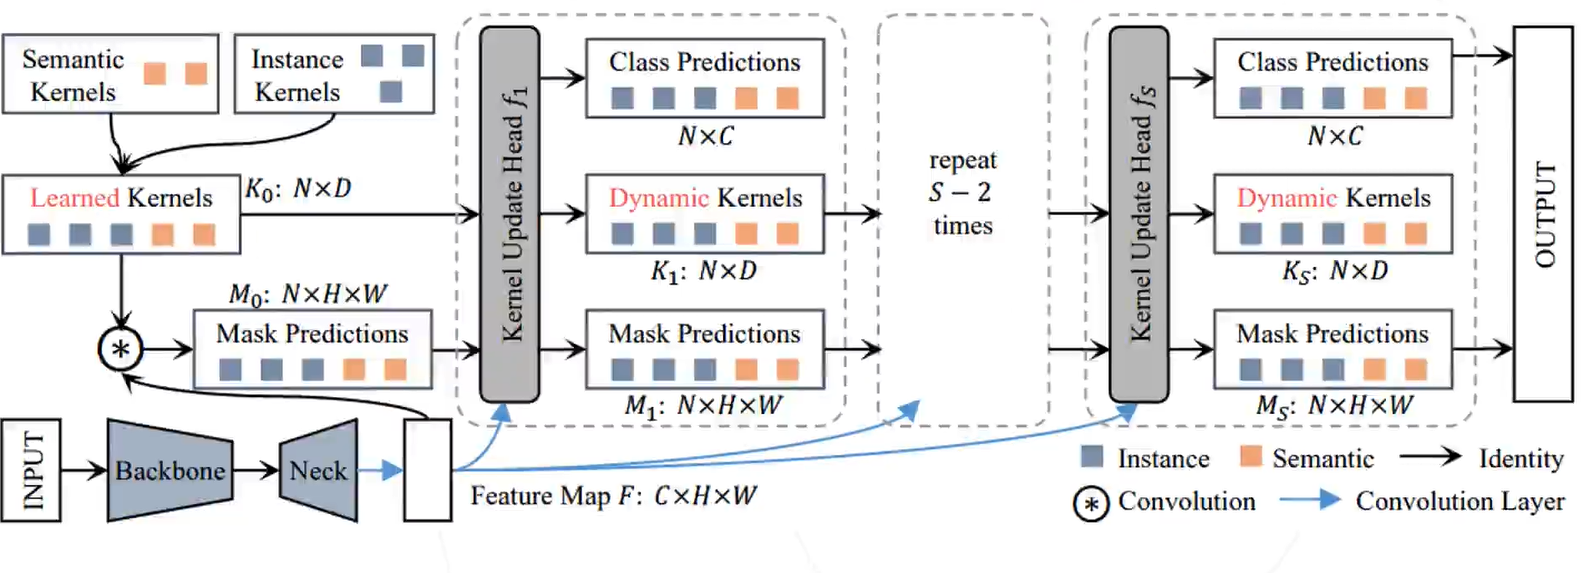
- 2.3.2 K-Net
- 2.3.3 MaskFormer
- 2.3.4 Mask2Former
- 2.3.5 2023 Segment Anything(SAM)
- 3. 语义分割模型的评价方法
- 3.1 基于交并集的评估指标
- 4. 思考
0. 写在前面
本节课主要由子豪大佬带来得语义分割基础知识和 MMSegmentation 算法库的介绍。
MMSegmentation算法库
MMSegmentation官方文档
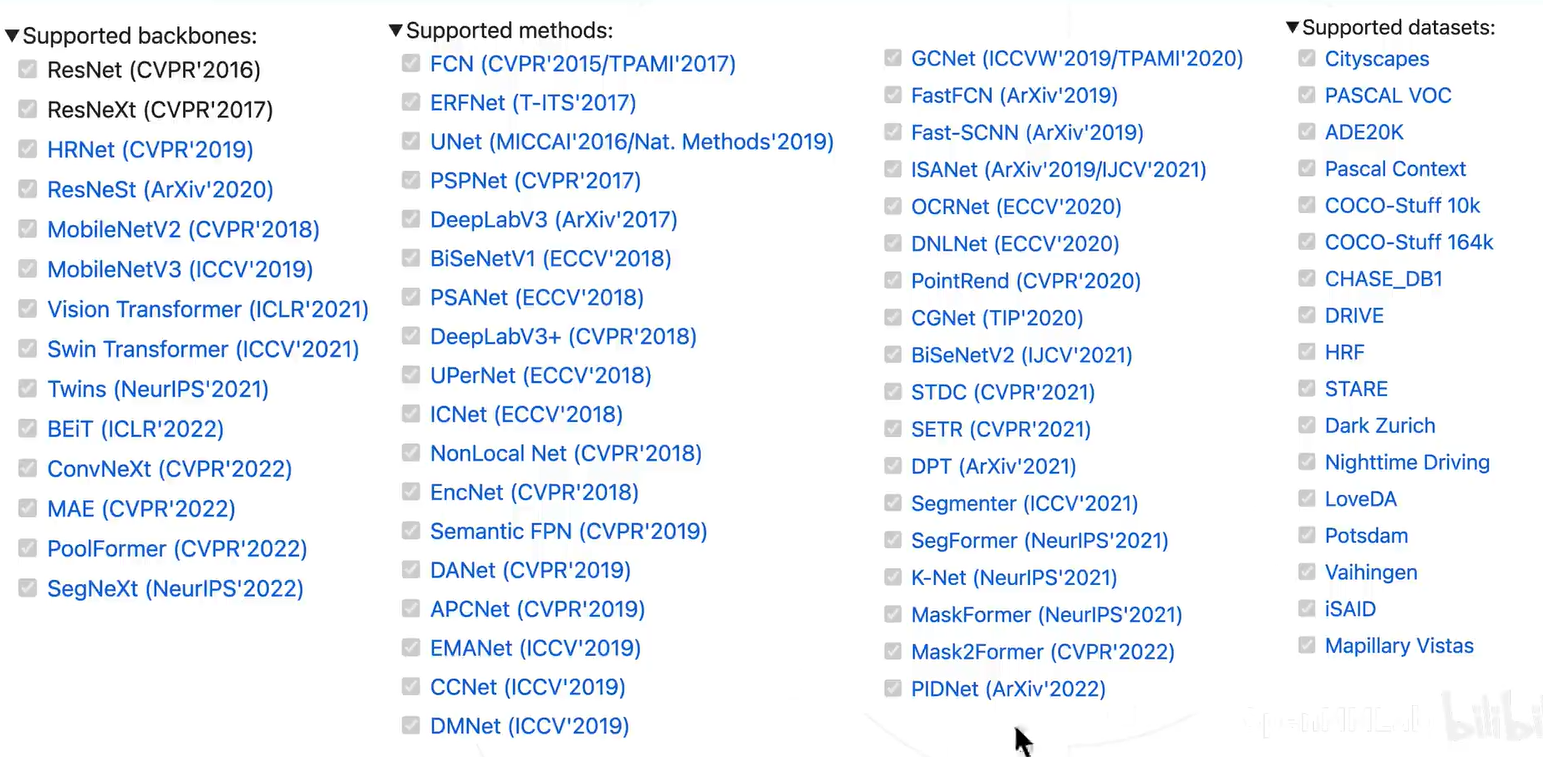
算法库支持的算法和数据集:
1. 语义分割的基础
1.1 什么是语义分割
即将图像按照不同的类别分割成不同的区域,相当于对每个像素进行分类。
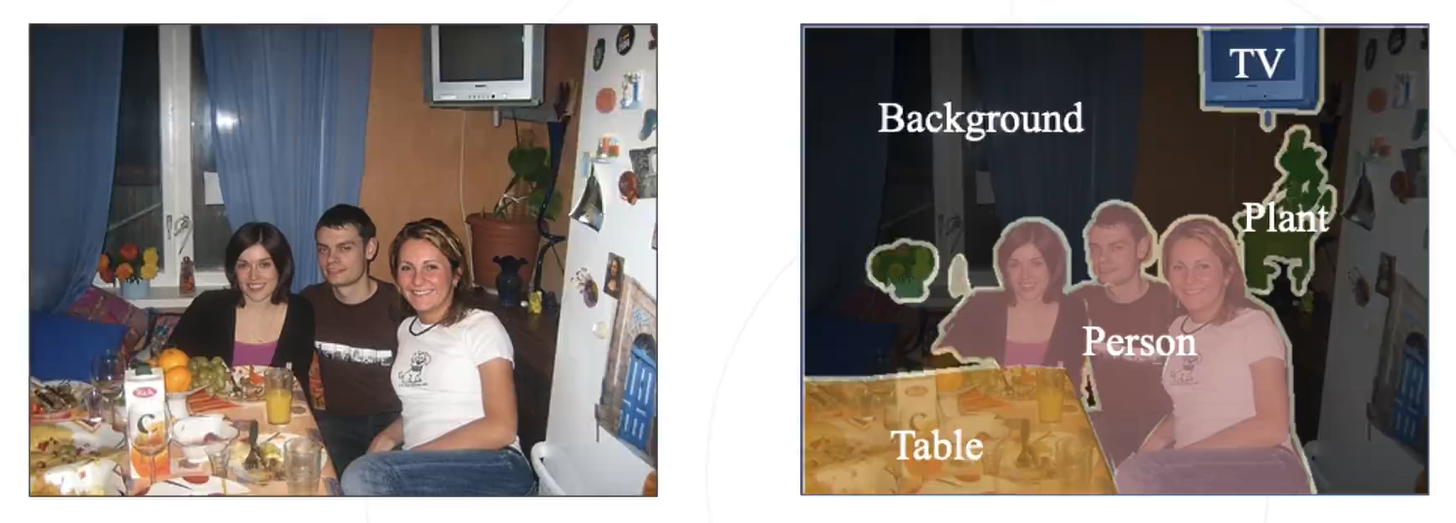
1.2 语义分割的应用
- 无人驾驶:感知汽车周围的环境:车辆、行人等等
- 人像分割:换背景、扣人像等等
- 智能遥感:分析地表农作物、水域、道路、农田分布、船舶等等
- 医疗影像分析:X光、CT等等肿瘤分析
根据个人经验,这种底层的视觉任务更加适用于那些微观照片
1.3 图像分割任务的不同层次
- 语义分割:只分类像素
- 实力分割:考虑相邻之间的物体
- 全景分割:考虑背景
三者的难度越来越高。
2. 深度学习时代演进历程
2.1 语义分割的基本思路
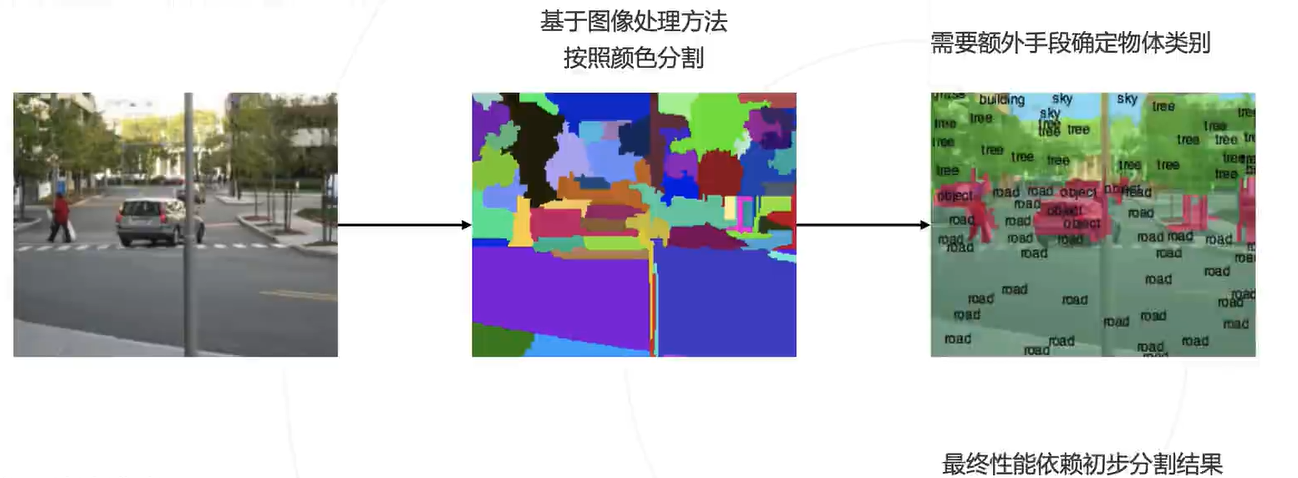
2.1.1 按颜色分割
先验知识:物体内部的颜色相近,边界的颜色变化
通过上面的先验知识就可以进行聚类,之前看过一篇 04 年的论文,差不多就是这个套路(只不过还有并查集等结构的引入),按颜色以及图结构进行语义分割:Efficient Graph-Based Image Segmentation
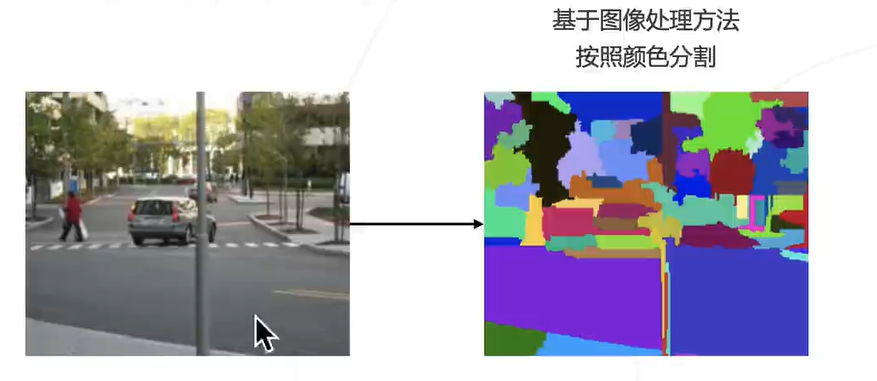
存在问题:
1. 先验知识不完全准确
2. 不同物体内部颜色可能相近,物体内也可能包含多个颜色
2.1.2 逐像素分类
由于卷积神经网络的兴起给图像分类注入了新的血液,但之前都没有应用在图像分割领域。因此,最初的应用方式就是这种逐像素的分类,具体步骤如下:
- 提取一个卷积窗口图像
- 把这个图像输入卷积神经网络中预测一个类别,该类别作为提取的图像的中心点坐标的类别
- 返回 1 ,继续滑动窗口进行预测下个像素
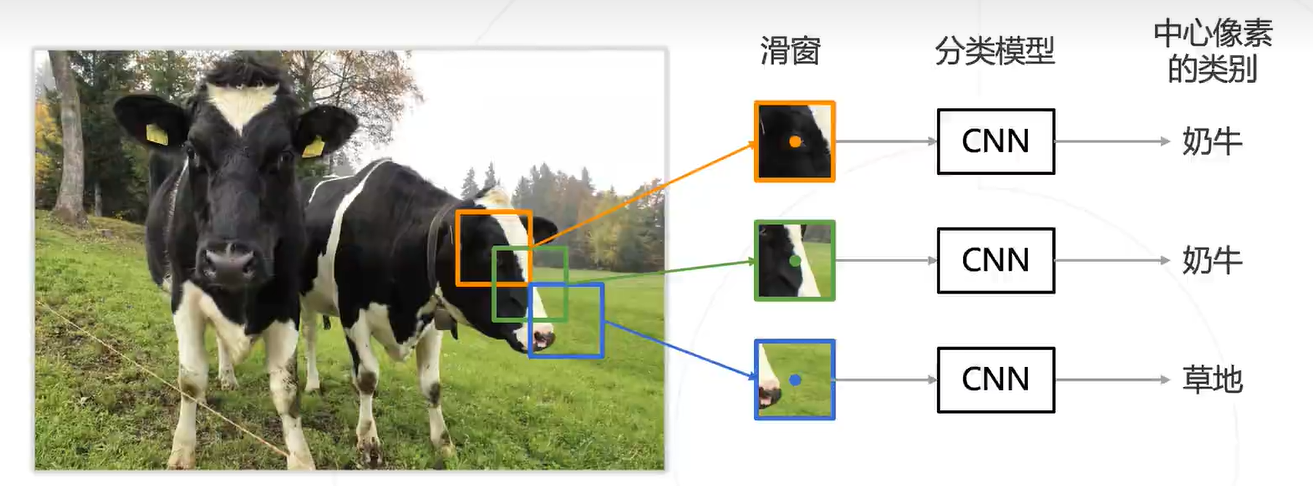
优点:可以充分利用起 CNN 模型
缺点:存在大量重复计算的重叠区域
2.1.3 重复区域优化
这一块个人感觉视频中没讲太清楚,所以借用了上一期的内容:
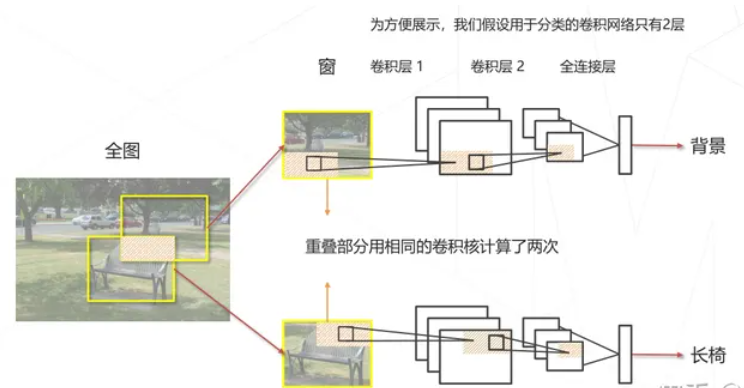
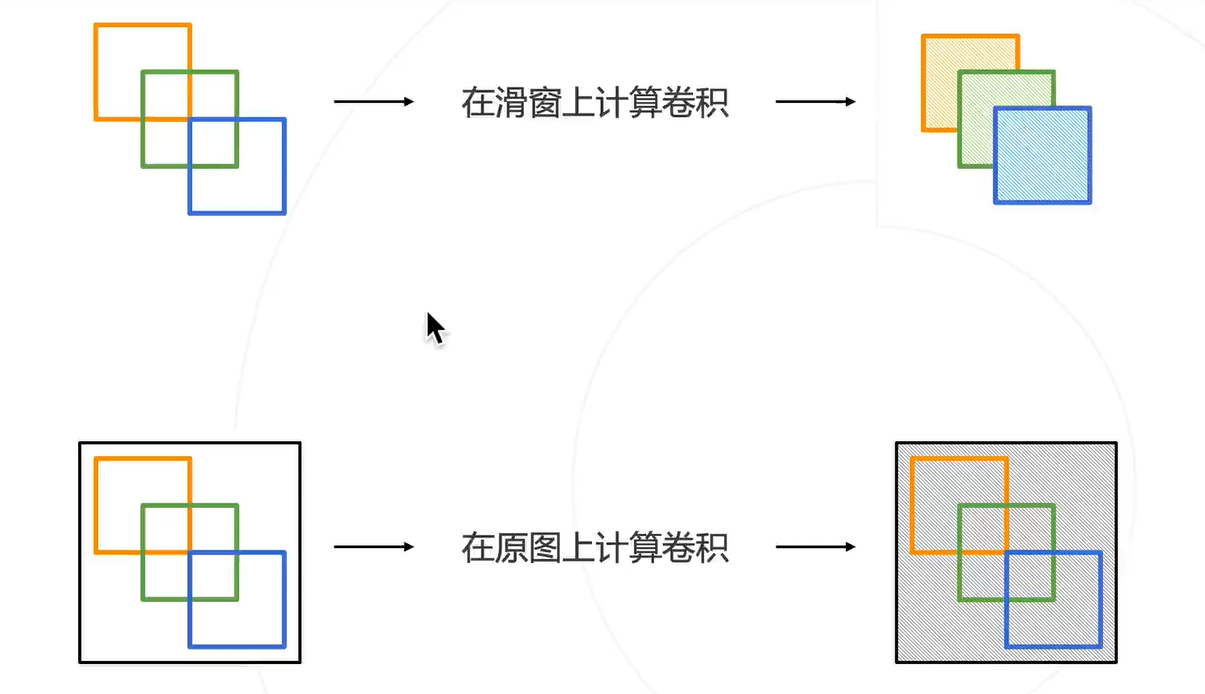
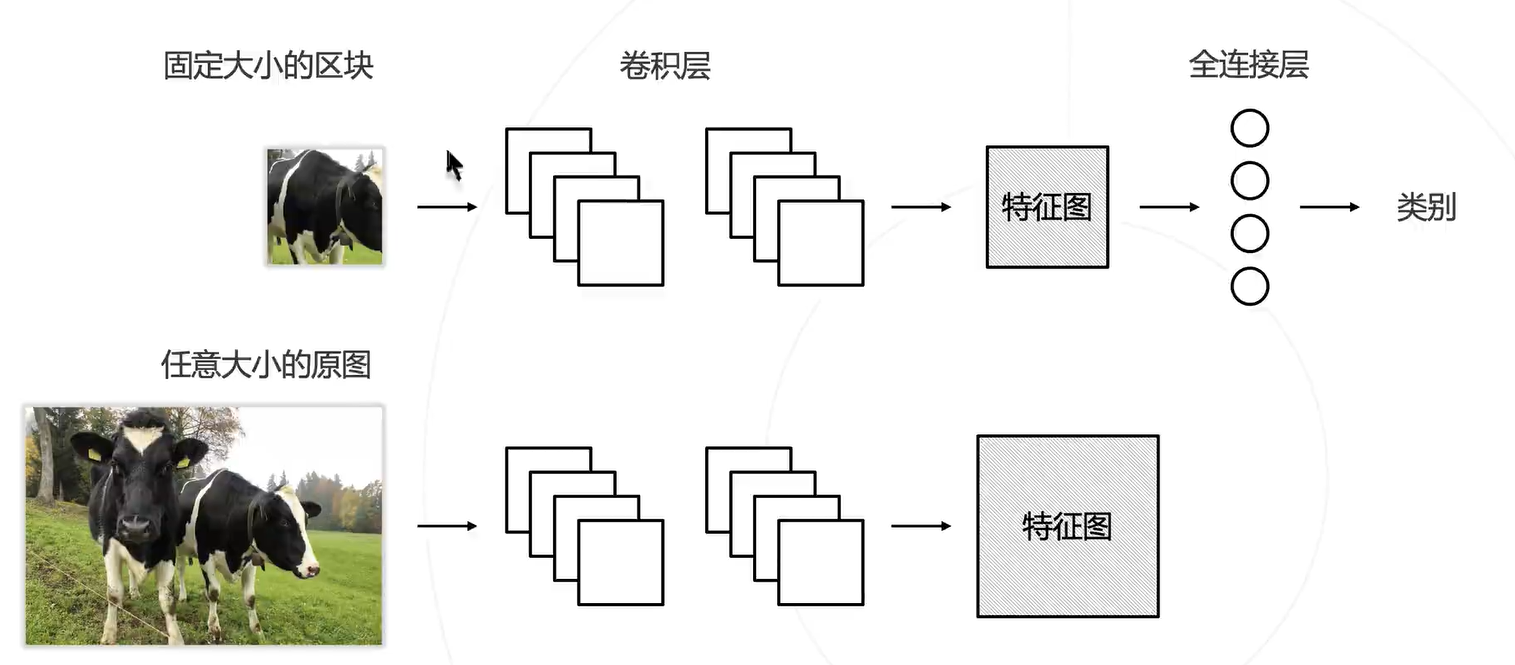
简单地讲,就是两个相邻的滑窗中间的重叠区域卷积后表现为相同的特征,因此这一块是可以被优化地。
在滑窗上计算卷积等价于在原图中计算卷积,因此可以在原图先计算一次卷积,然后复用这个结果。就相当于,先滑窗再卷积变成先卷积再滑窗,这样就少了很多重复计算了。
2.1.4 全连接卷积化
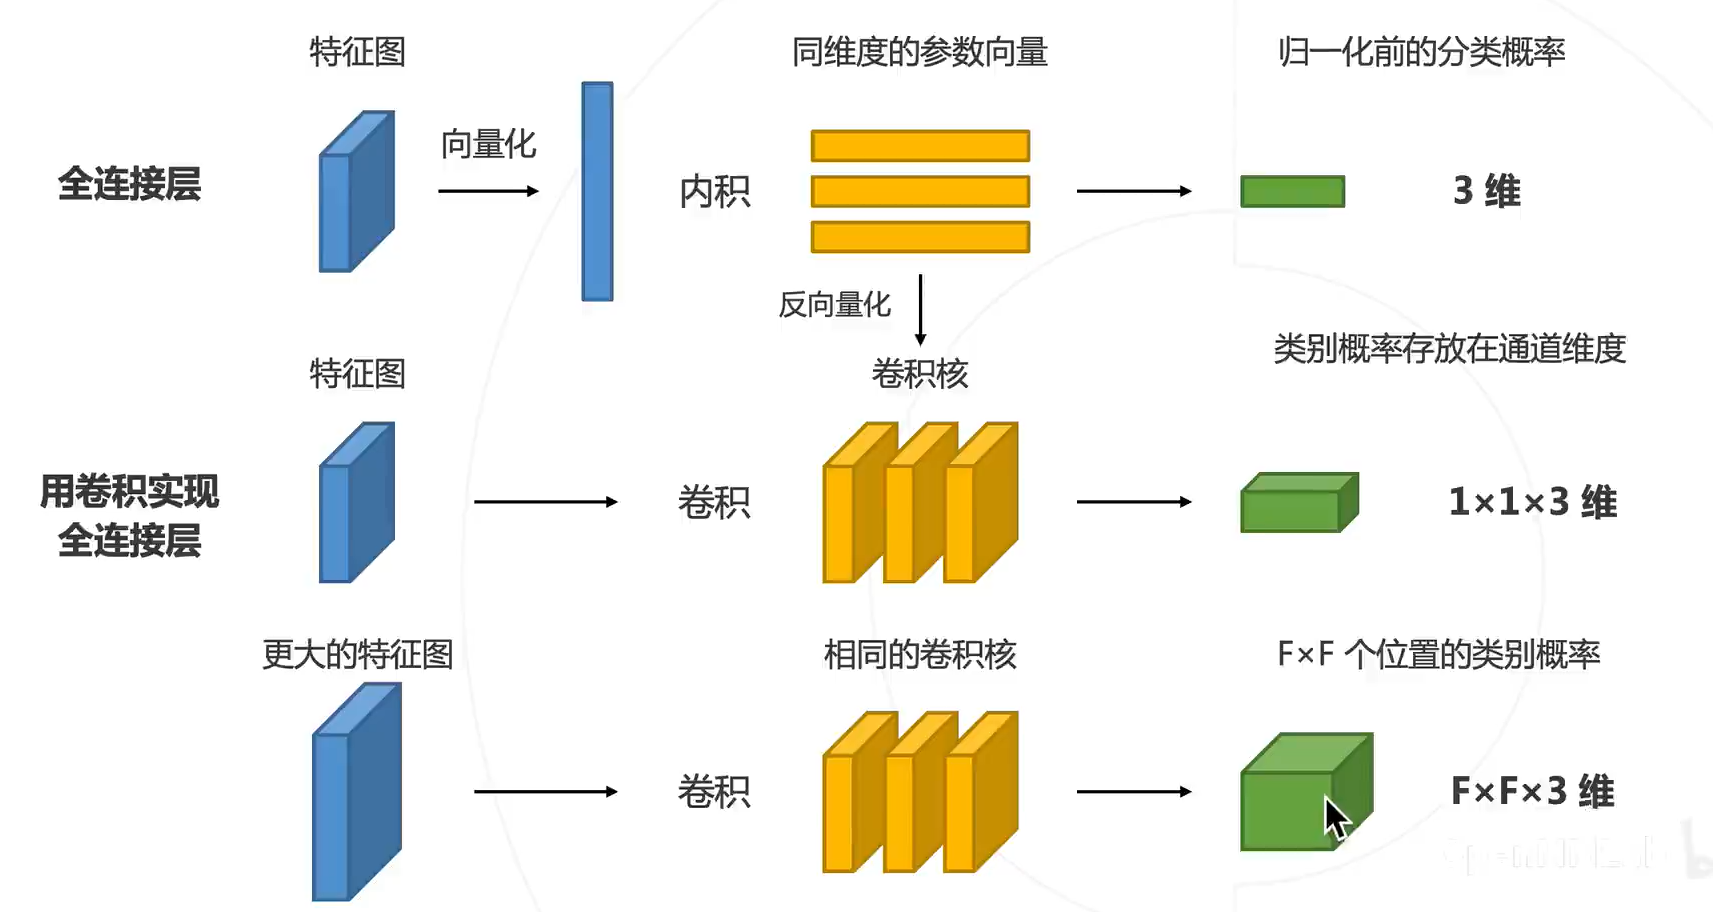
之前知道 1×1 的卷积核等价于全连接,子豪大佬这里说了来源,原来是 VGG 中提出的。感觉关键在反向量化那步。
2.2 深度学习下的语义分割模型
2.2.1 2016 全卷积网络(FCN)
2015 CVPR Best Paper
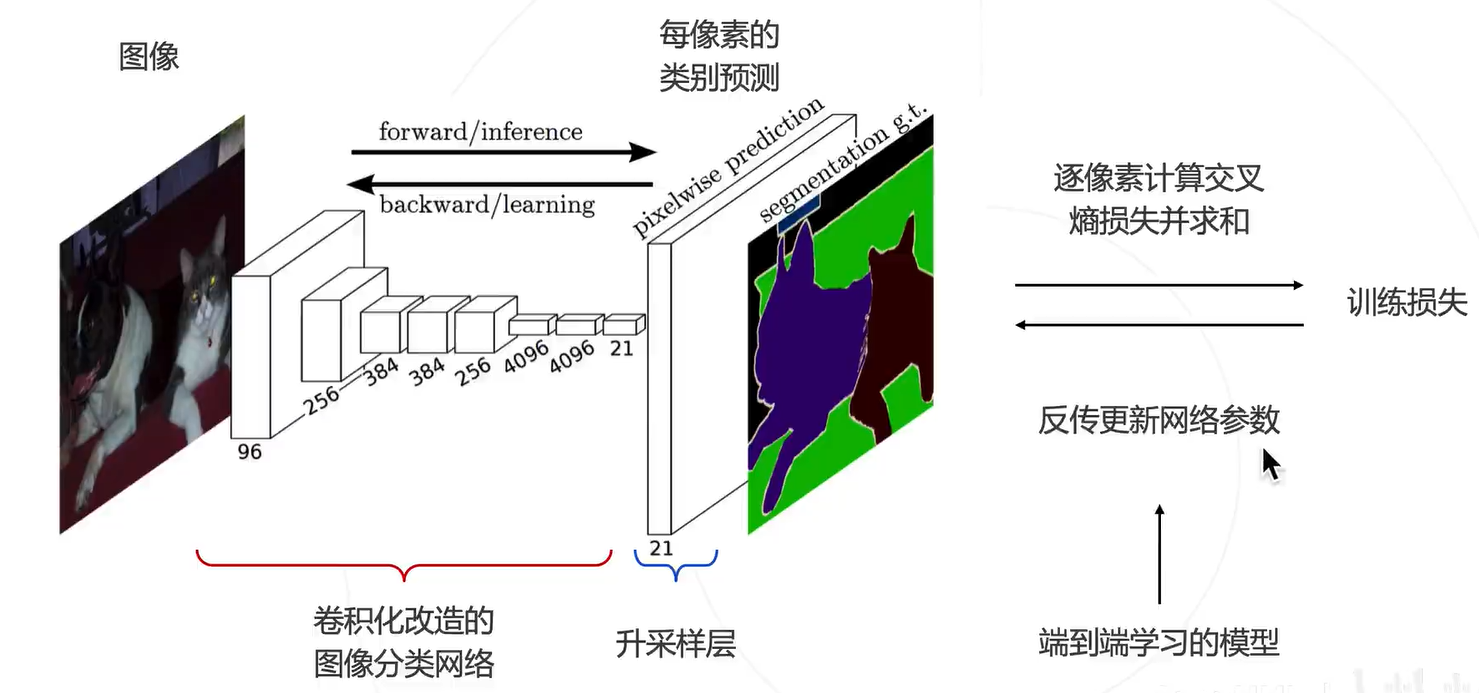
通过全连接卷积化,就把原来的图像分类的网络改成用于图像分割的网络,得到一张图片的概率图。
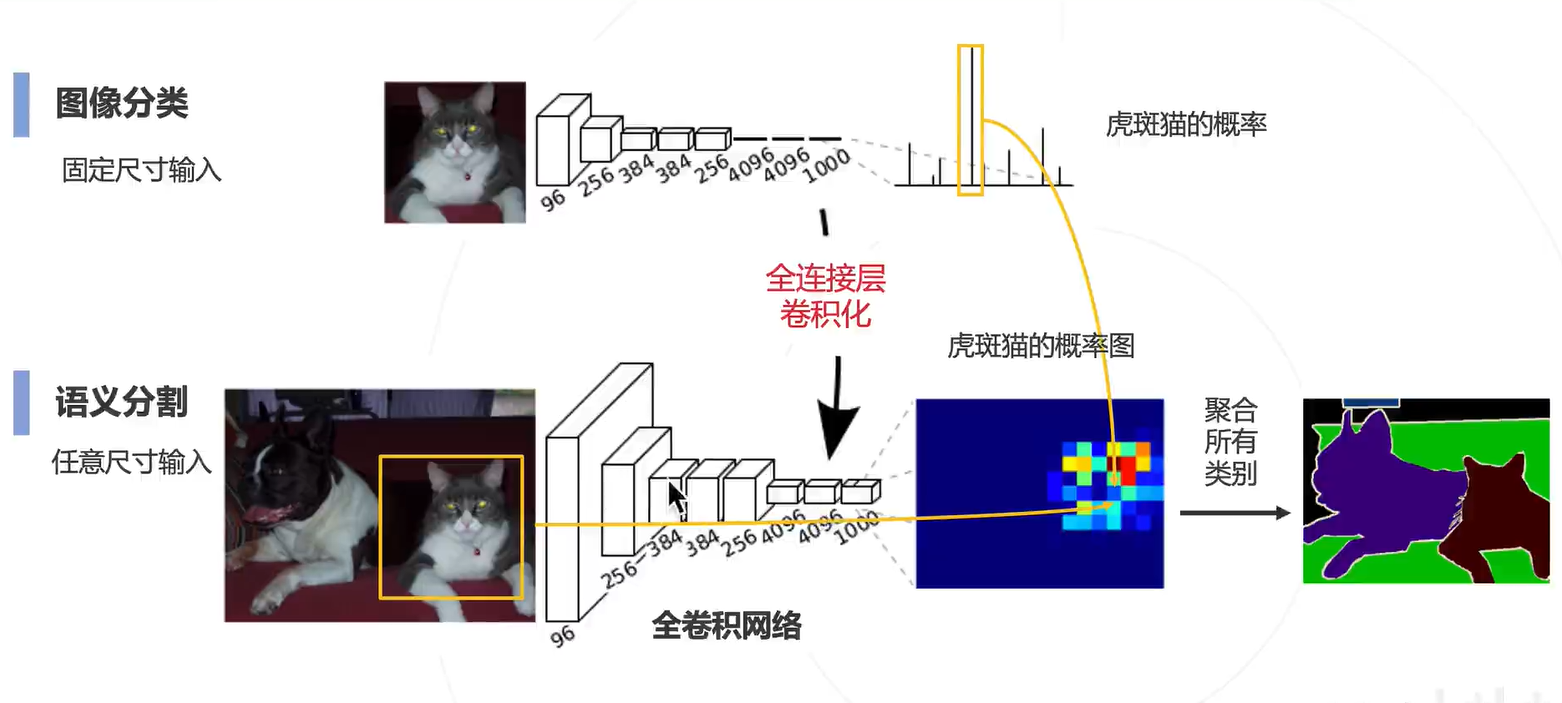
这里比较关键的一个问题就是如何把预测的图换源到原来图片特征图呢?技术:预测图升采样。恢复为原图的分辨率(小 Featur map --> 大 Feature map)
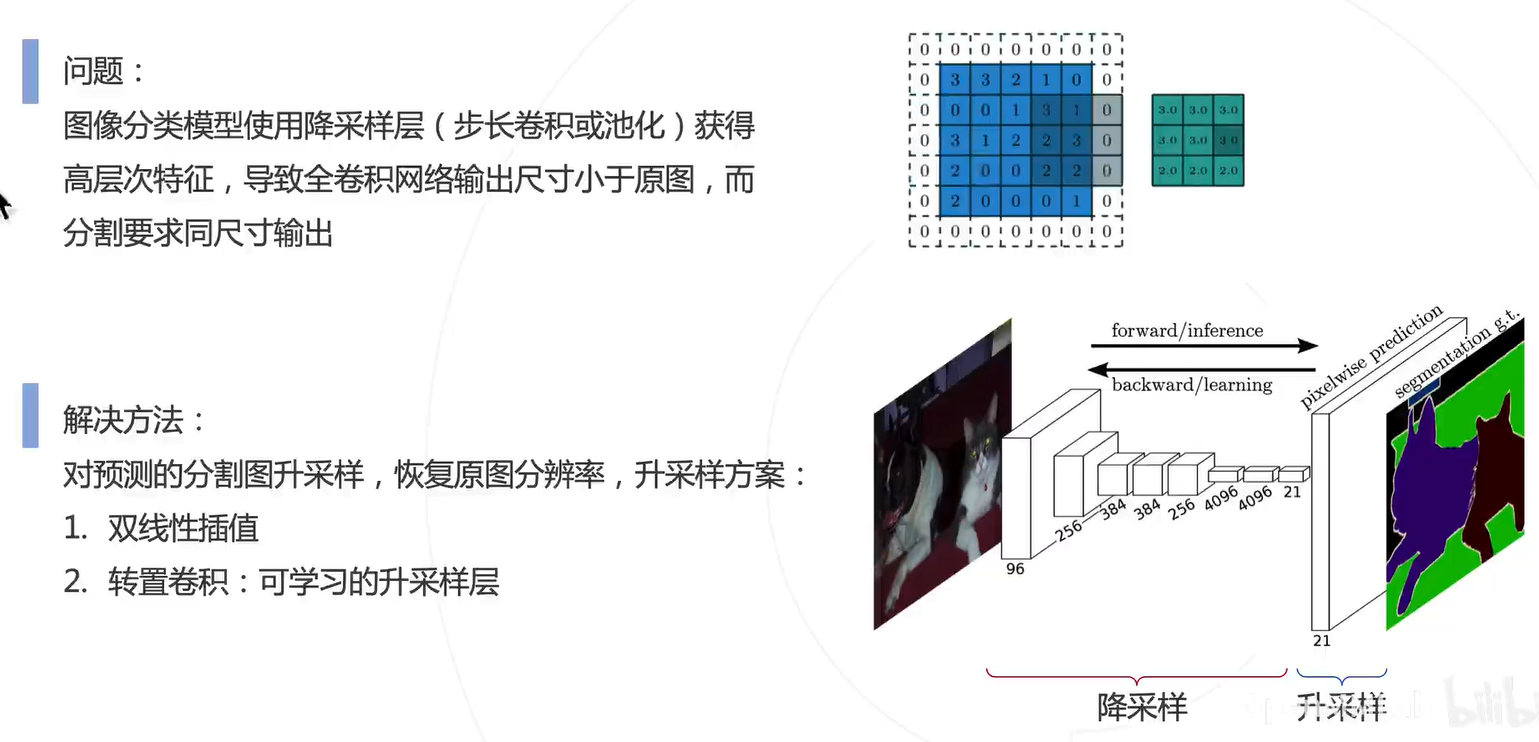
做法:1. 双线性插值;2. 转置卷积
双线性插值
一阶线性插值可以采用拉格朗日插值,二阶的相当于在基础上多做一次,只不过第二阶的输入是一阶的输出。
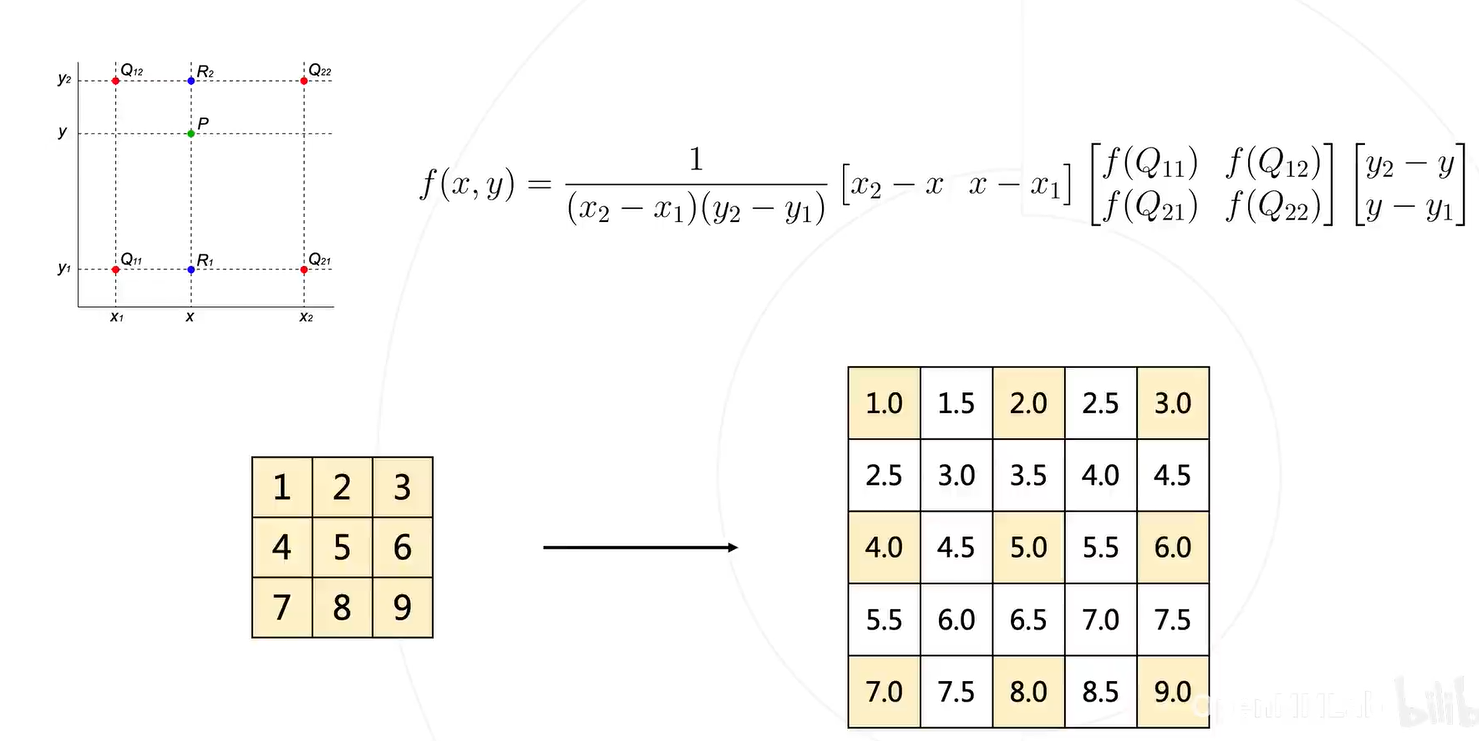
同样地,这种做法可以用卷积替代:
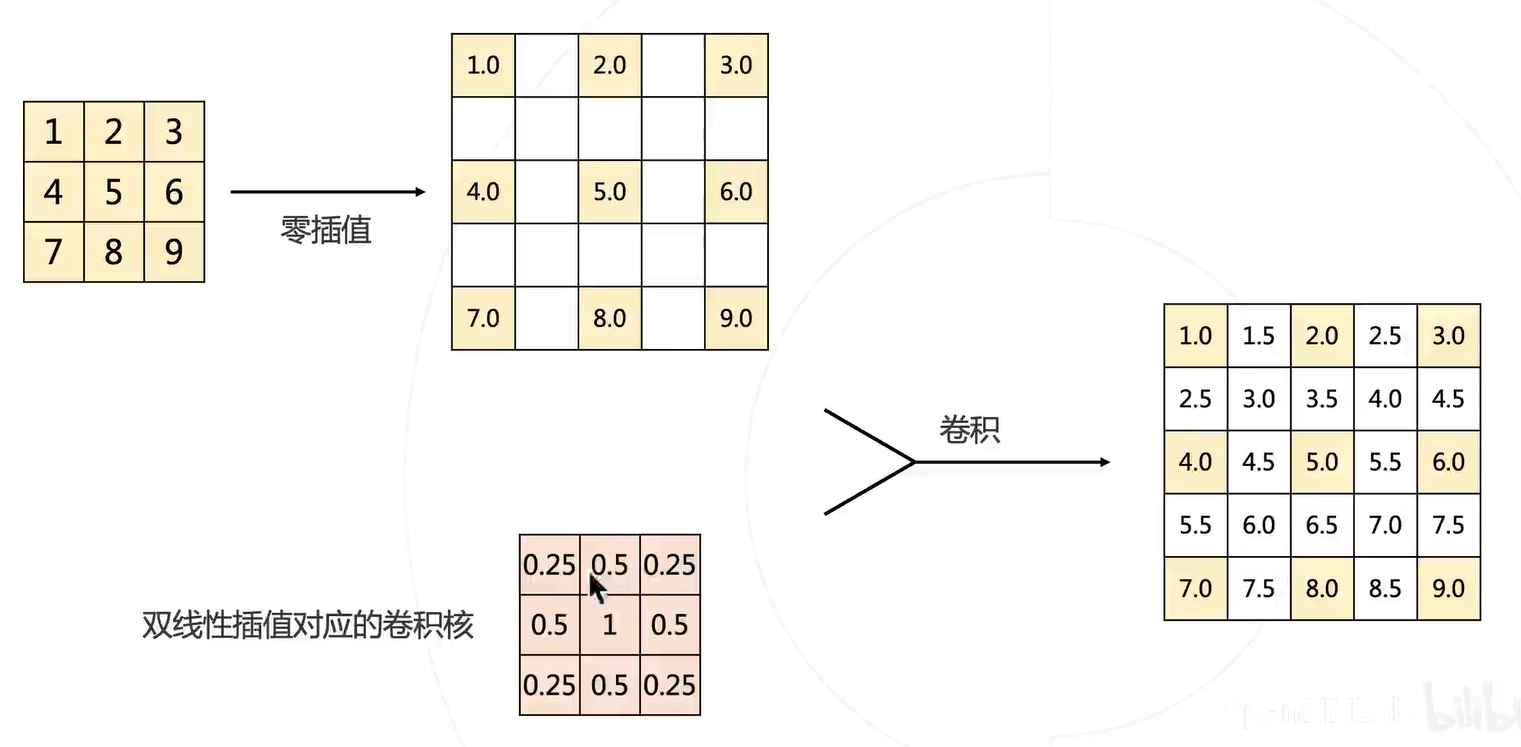
优点:这样的卷积是预定义好的,和那些 Sobel 滤波算法类似,不用学习。
转置卷积
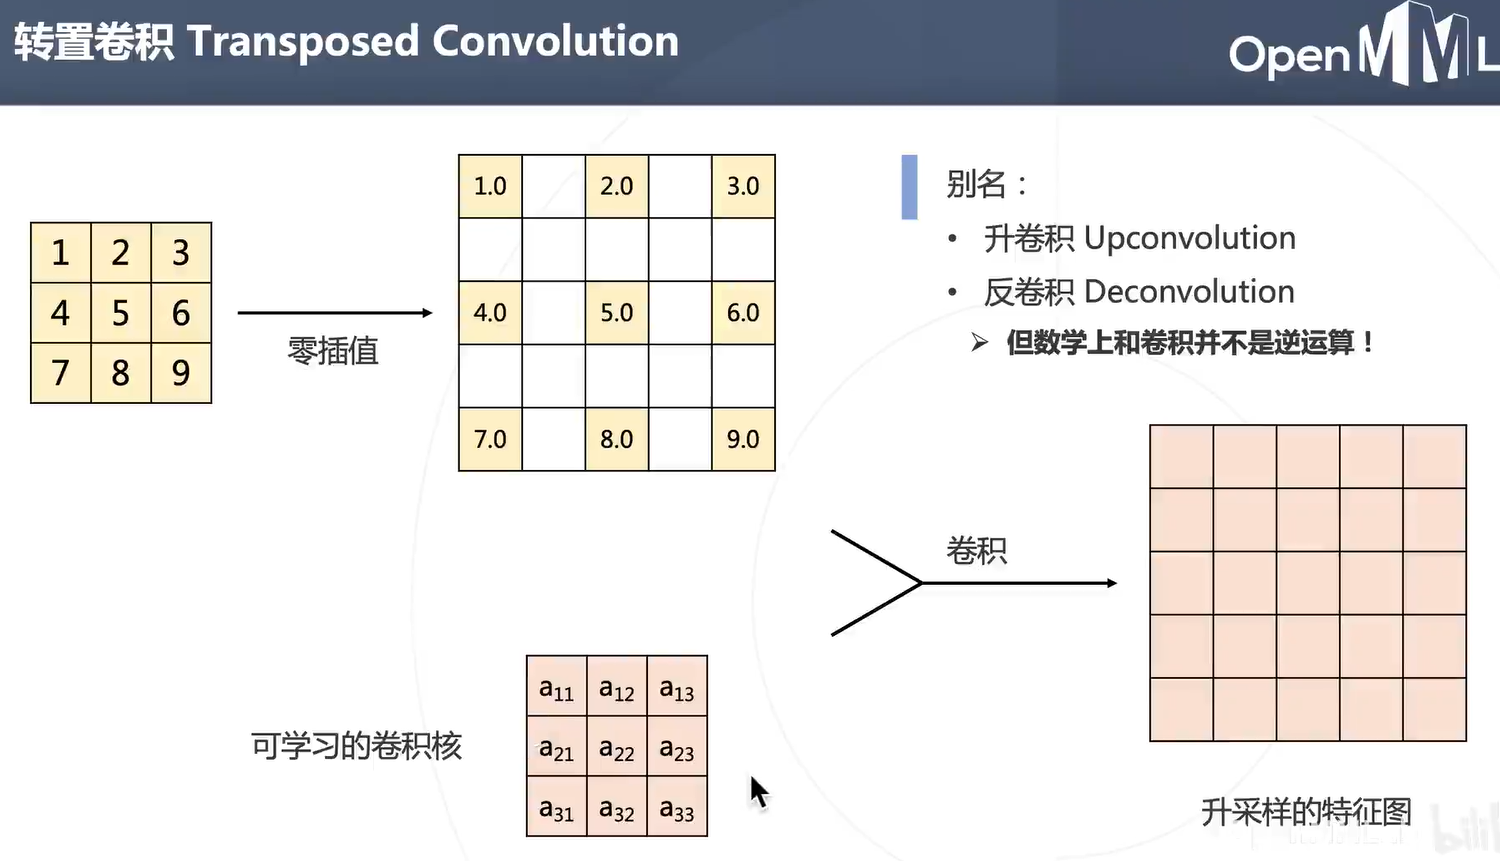
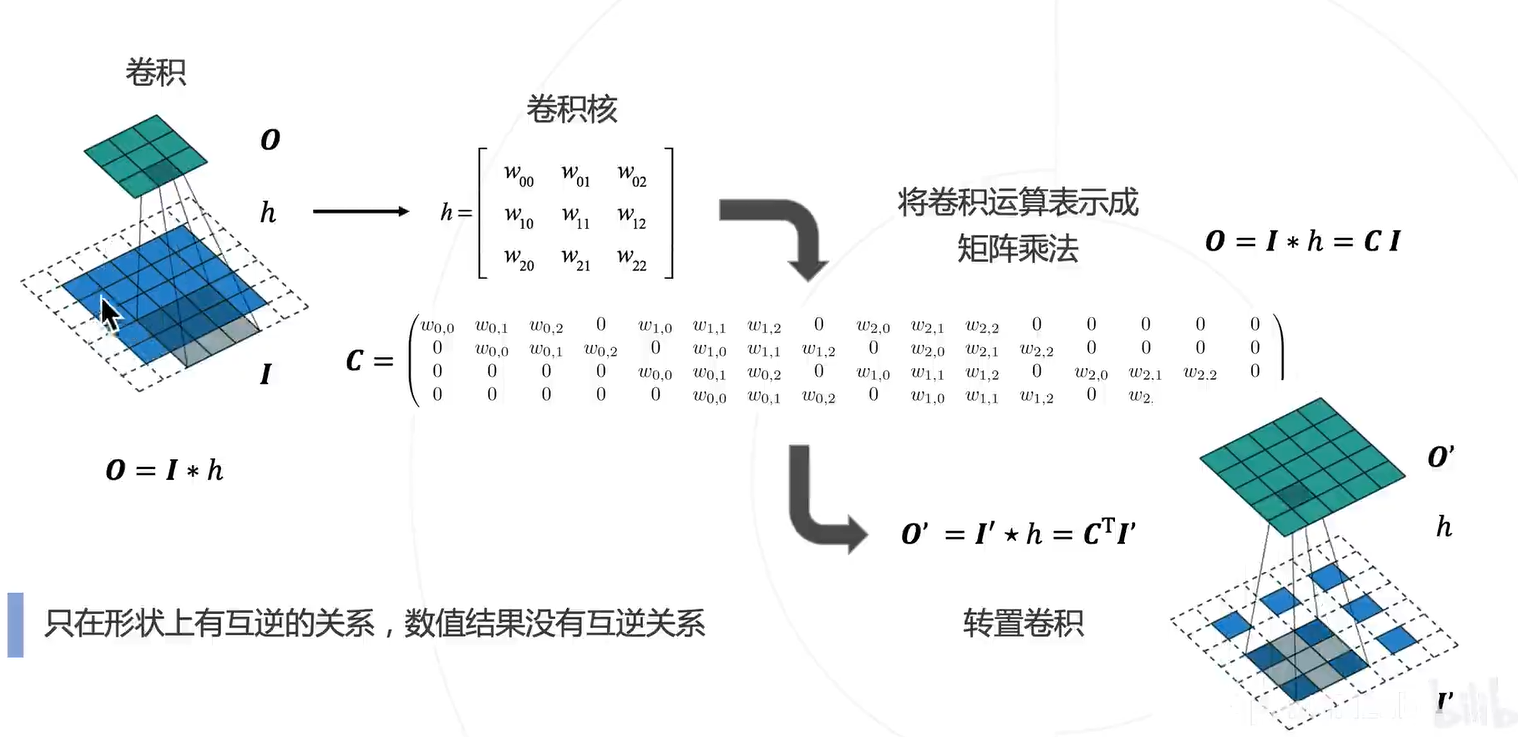
优点:可学习
FCN 的流程
和图像分类的区别就是中间升采样的部分,以及计算交叉熵的特征数会比图像分类网络多得多。
基于多层次特征的上采样
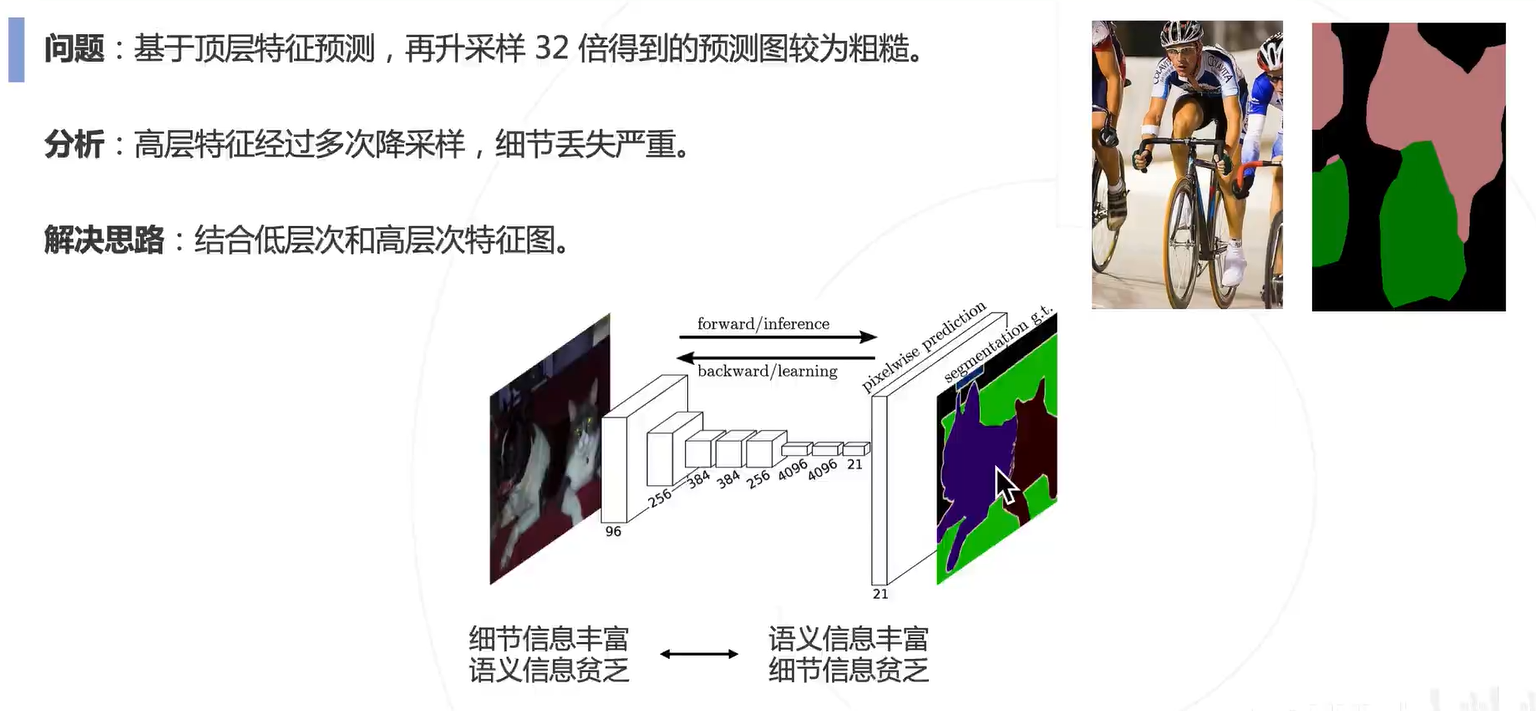
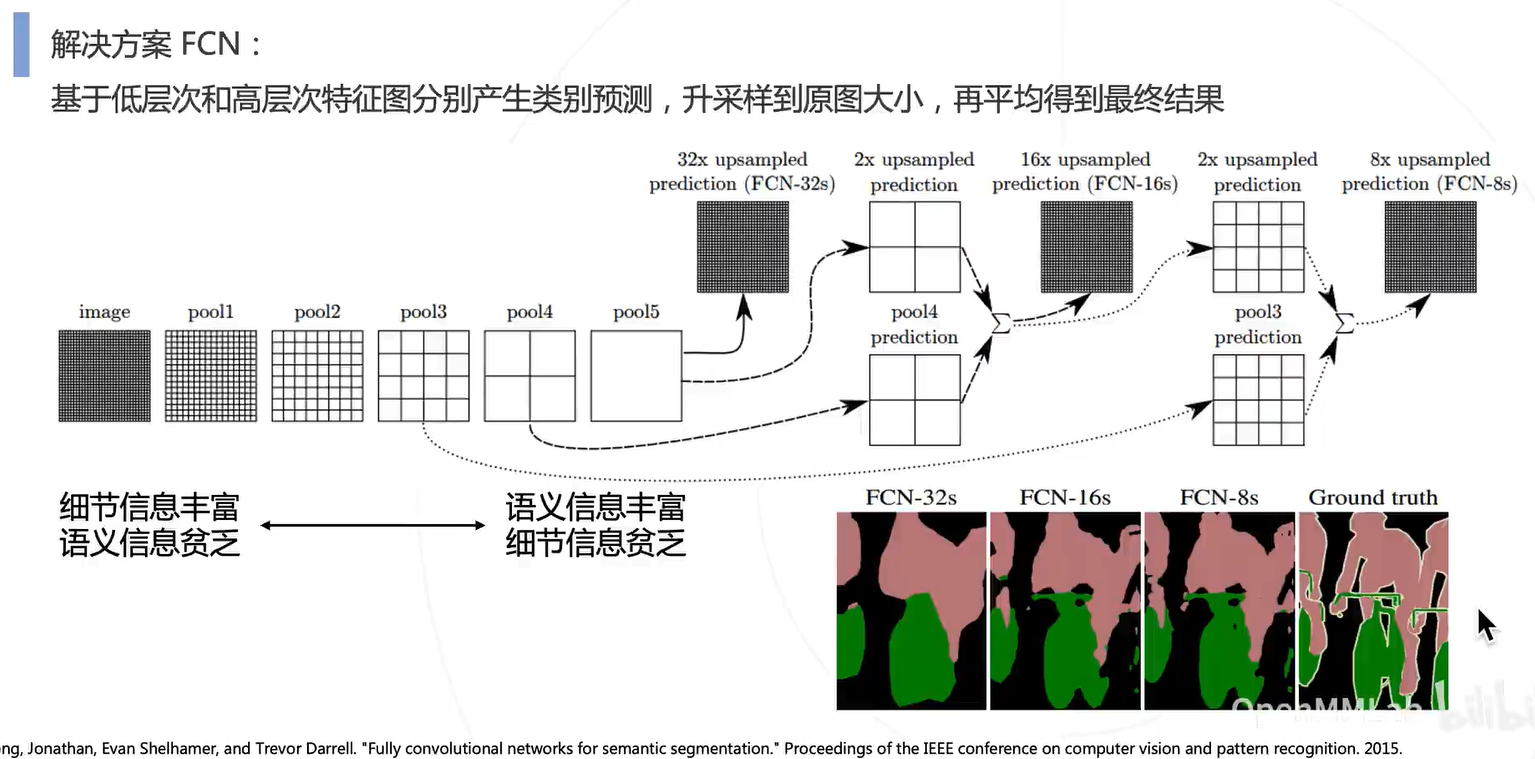
深层次的细粒度信息比较贫乏,而语义信息比较丰富;浅层则相反。因此结合深层和浅层的特征来还原语义分割图。
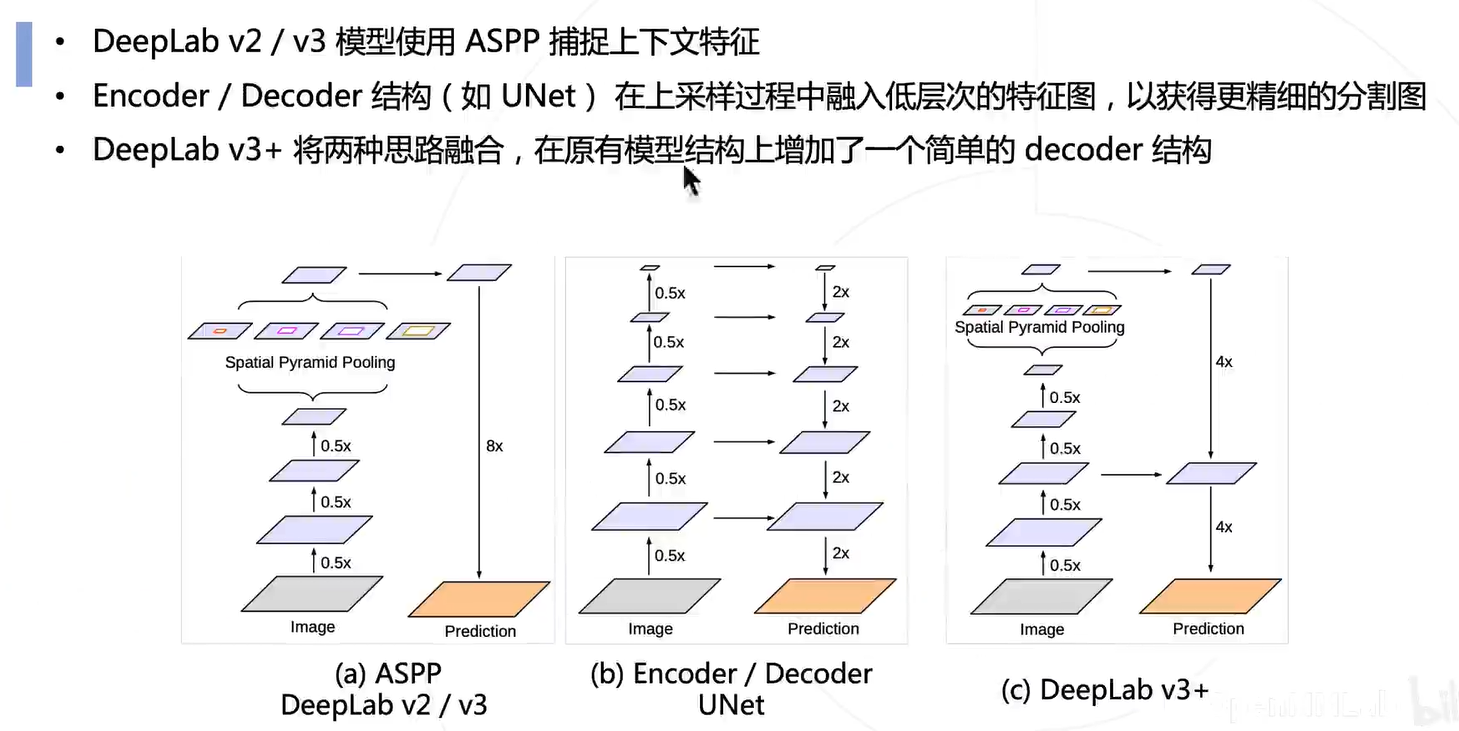
2.2.2 2015 UNet
2.2.3 上下文信息
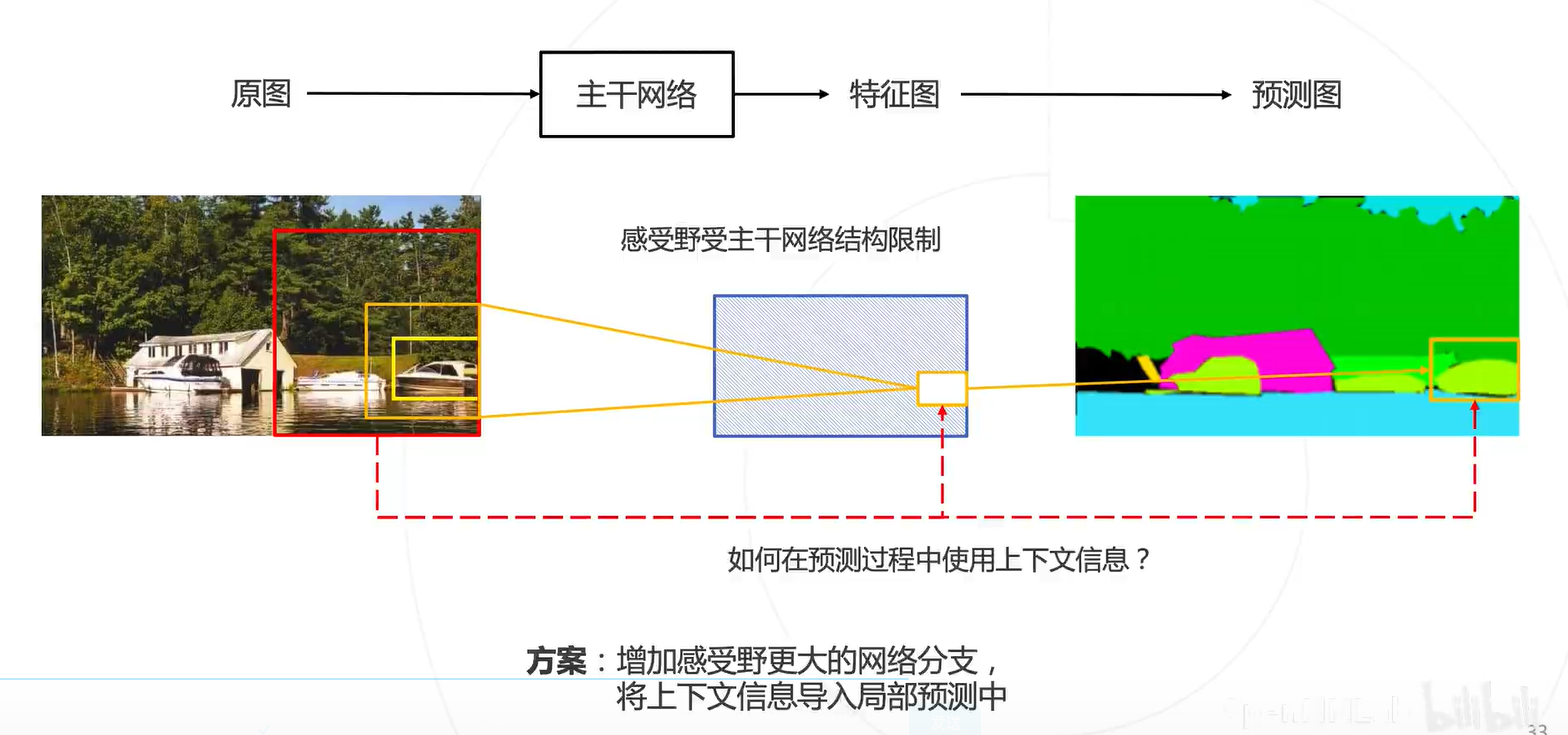
图像周围的内容就是上下文信息,可以帮助模型进行更准确的判断。所以模型就要有更大的感受野,结合上下文信息。
2.2.4 2016 PSPNet
流程
多尺度融合+上采样
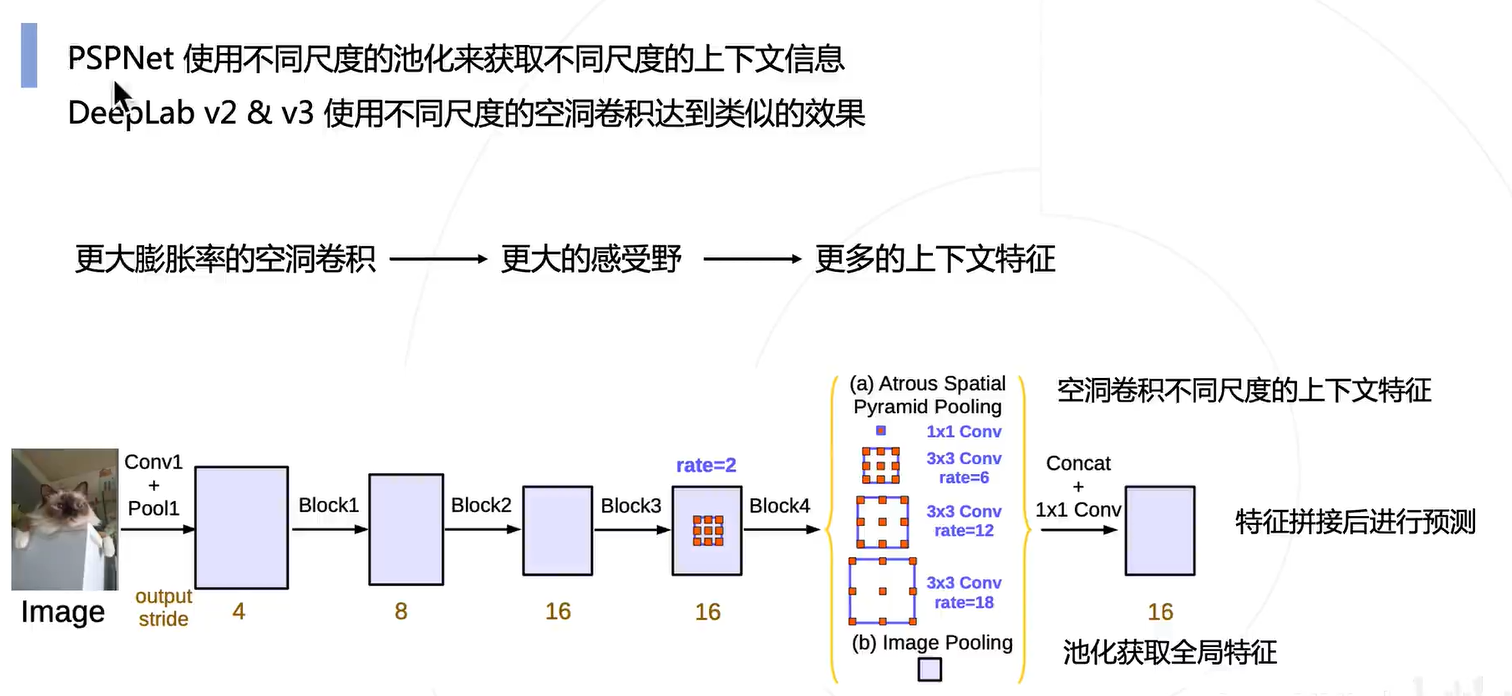
2.2.5 空洞卷积和 DeepLab 模型
DeepLab 系列进一步把多尺度融合的思路发扬光大,并引入了空洞卷积增加卷积的感受野。
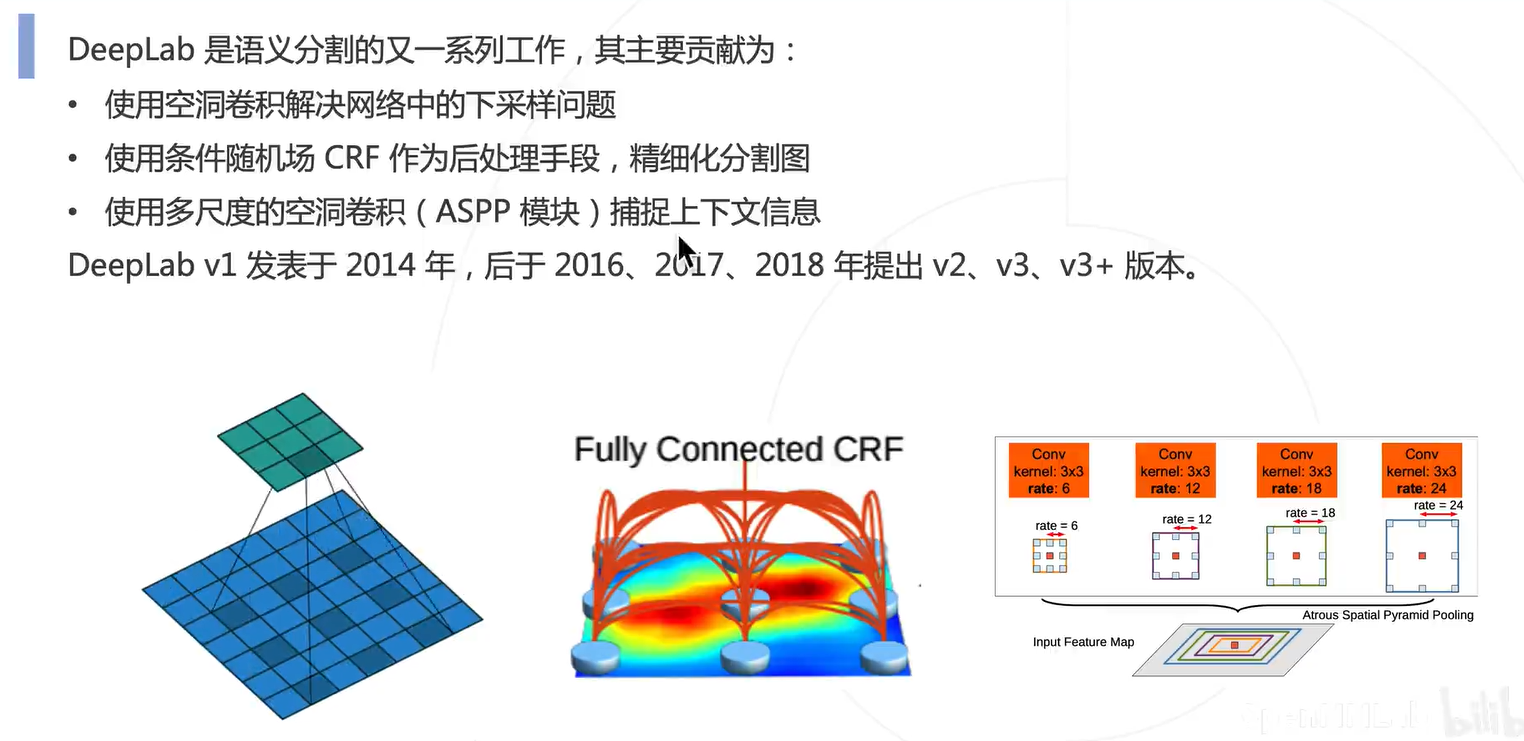
关键点:
- 空洞卷积(下采样)
- 条件随机场(CRF)
- 多尺度空洞卷积(ASPP)
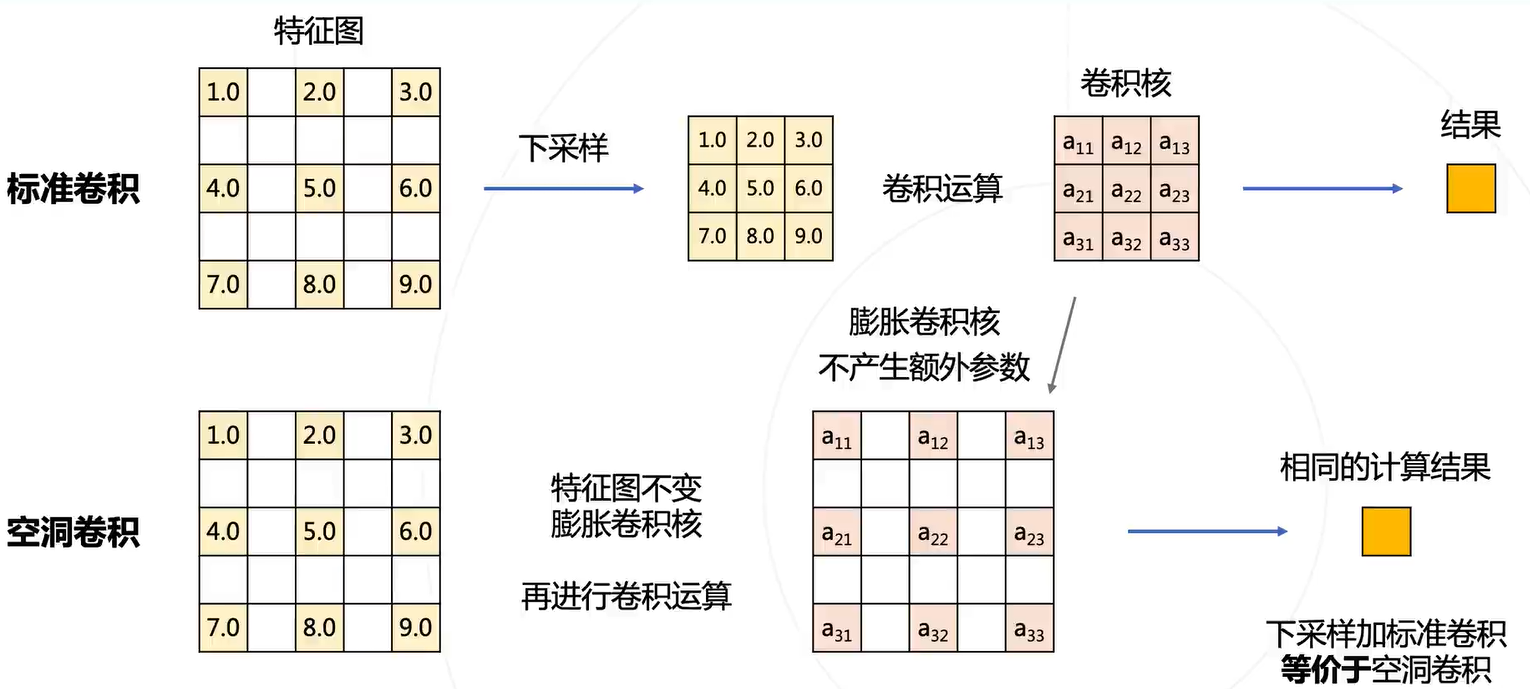
空洞卷积
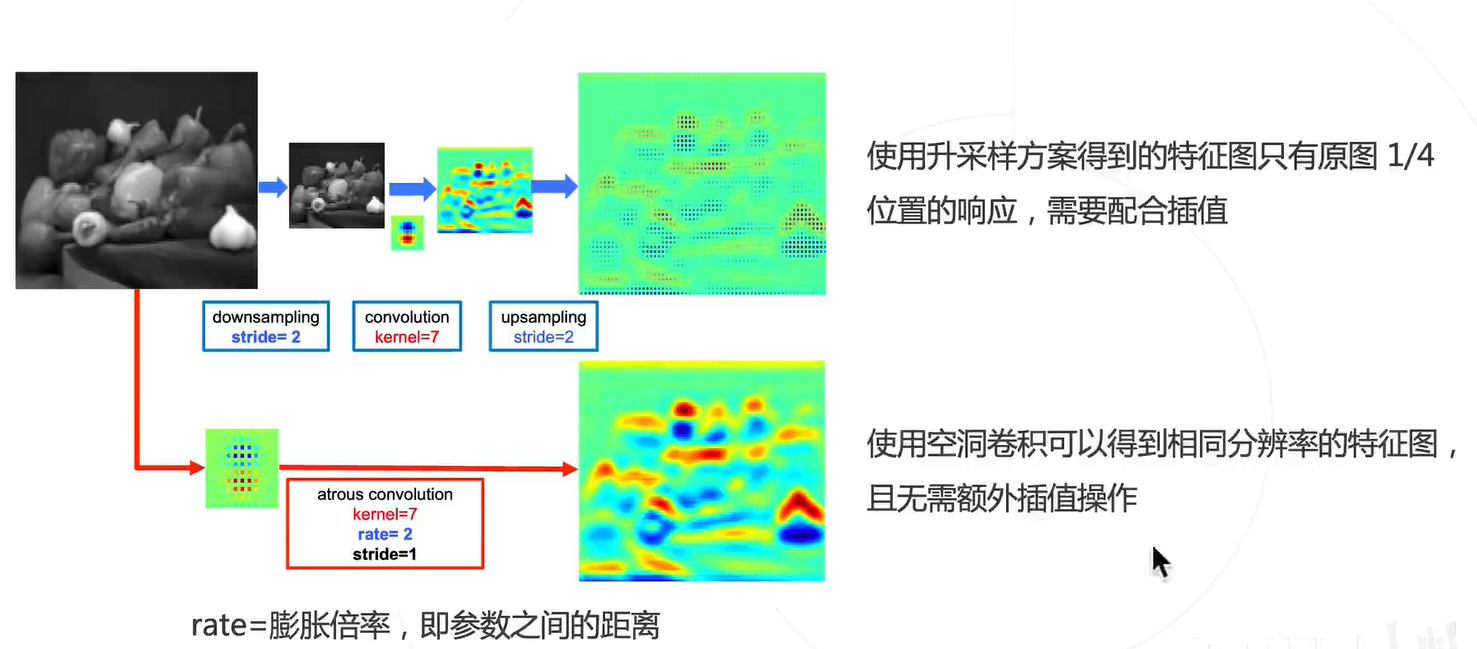
在不增加参数的情况下,增加感受野
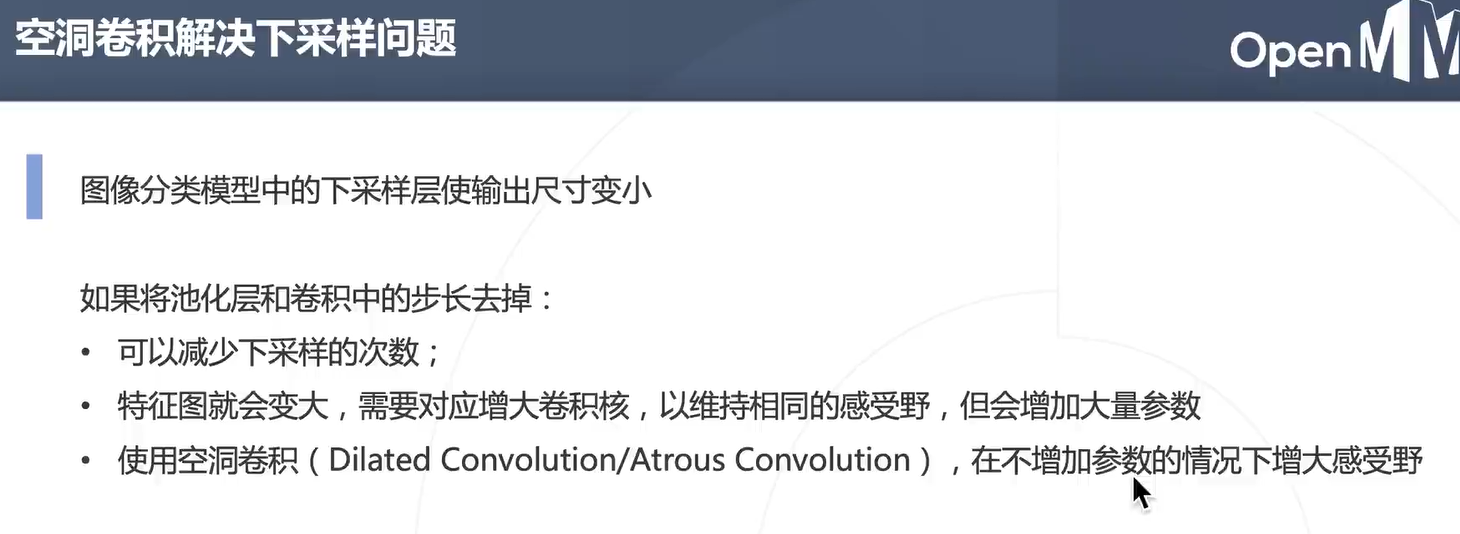
空洞卷积=下采样+标准卷积
DeepLab
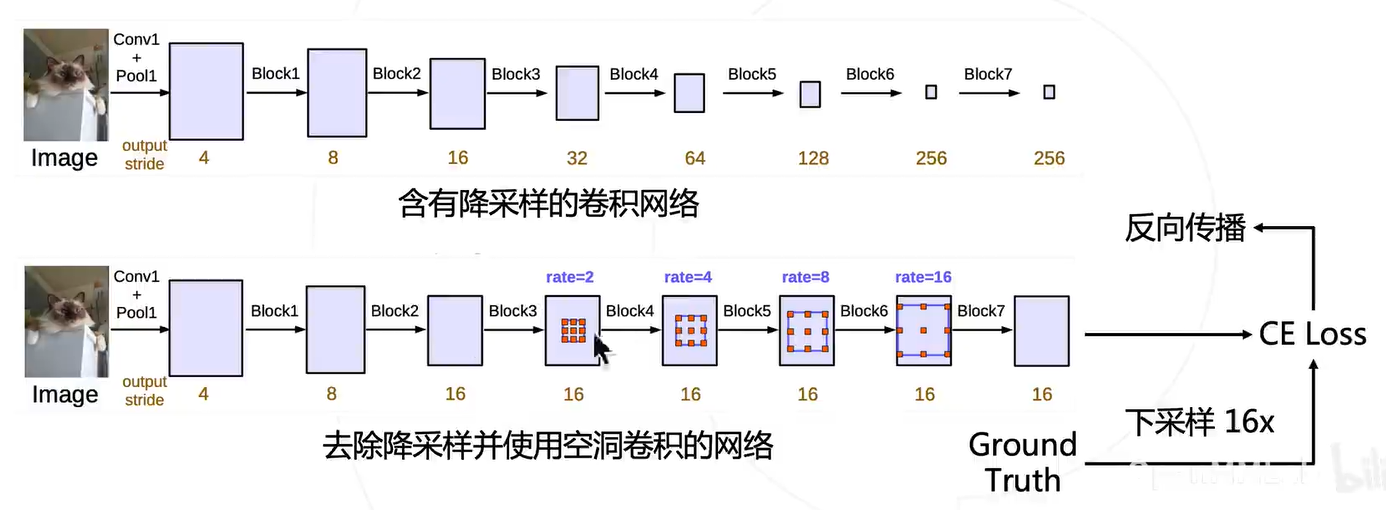
它在图像分类网络做以下修改:
- 去除后半部分的下采样
- 后续的卷积采用膨胀卷积,逐步增加膨胀率维持原来的感受野
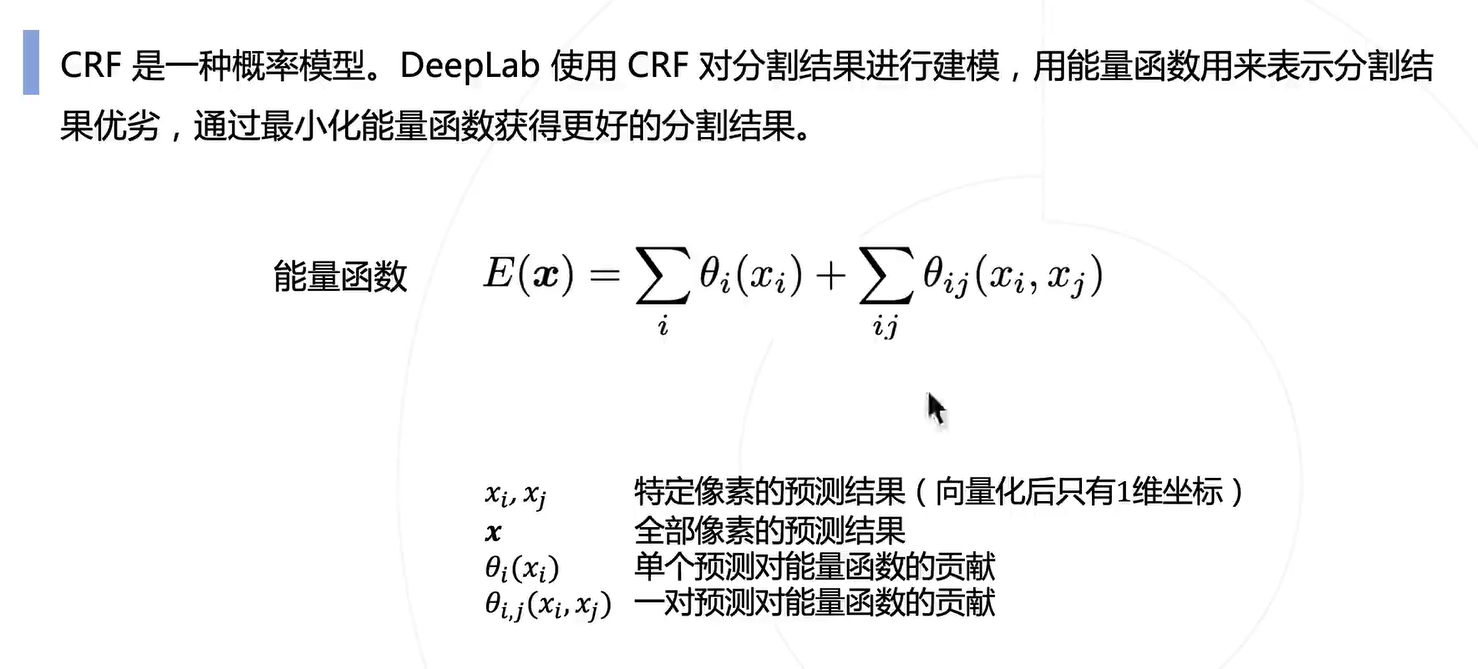
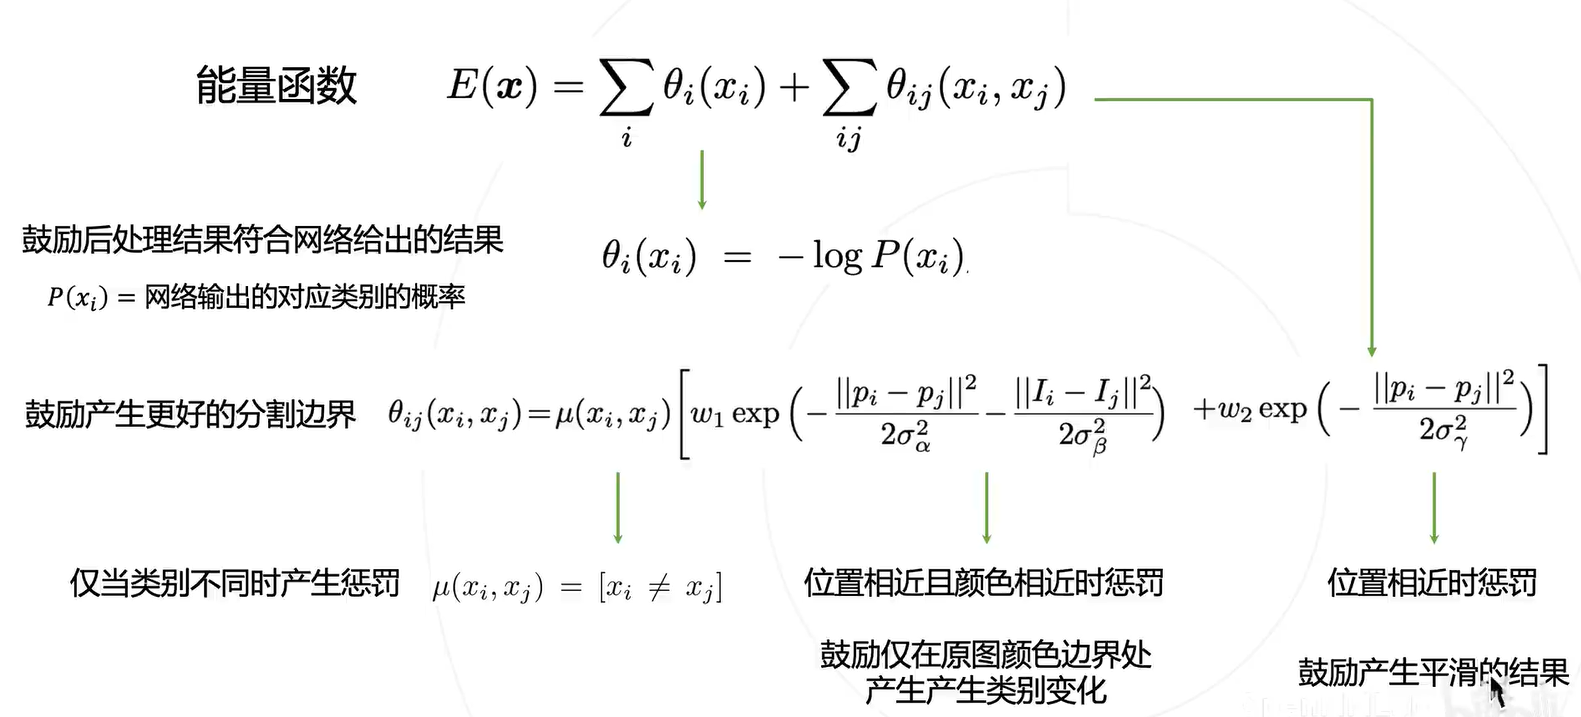
条件随机场(CRF)
结合原图颜色信息,对输出的特征进行边界精准化
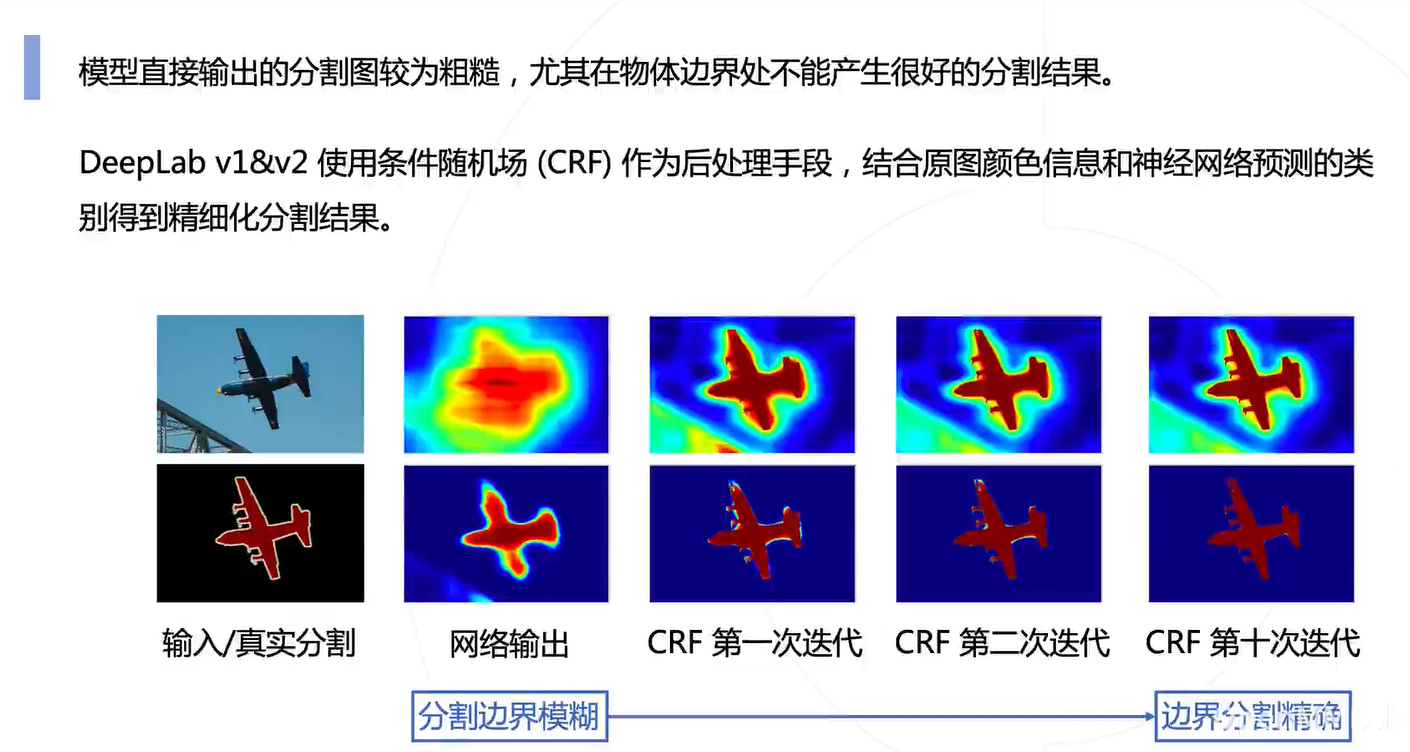
具体的做法就是在边界处加一个惩罚(物体内部尽量不要变,边界处颜色尽量要变,可以看出也有本文开头提到逐颜色预测的那个先验的味道):
空间金字塔池化(ASPP)
借鉴了 PSPNet 的思路
DeepLab v3+
2.2.5 小结
2.3 前沿的语义分割算法
2.3.1 SegFormer
Transformer block + 多尺度融合
2.3.2 K-Net
统一语义分割、实力分割、全景分割的模型
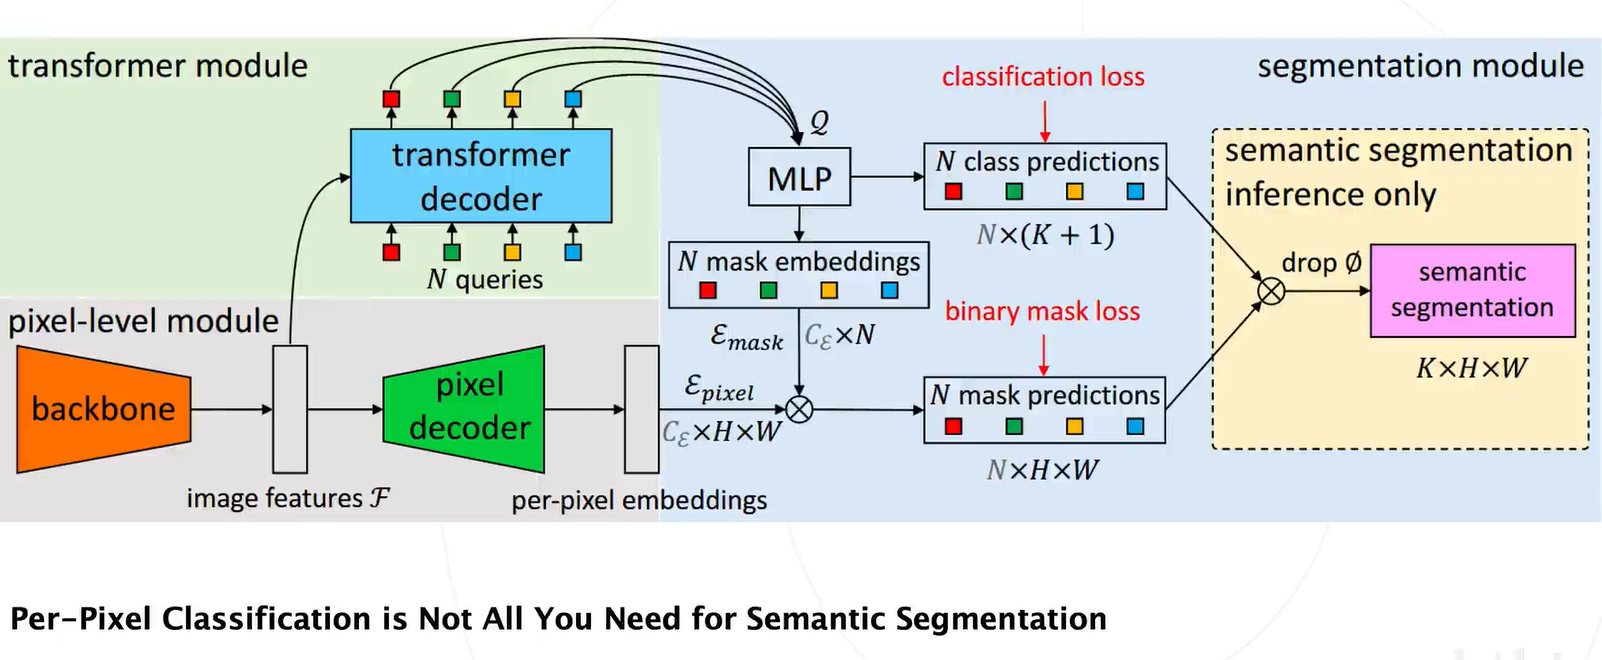
2.3.3 MaskFormer
作者提出实例级别的分类就足够了,并不用逐像素分类
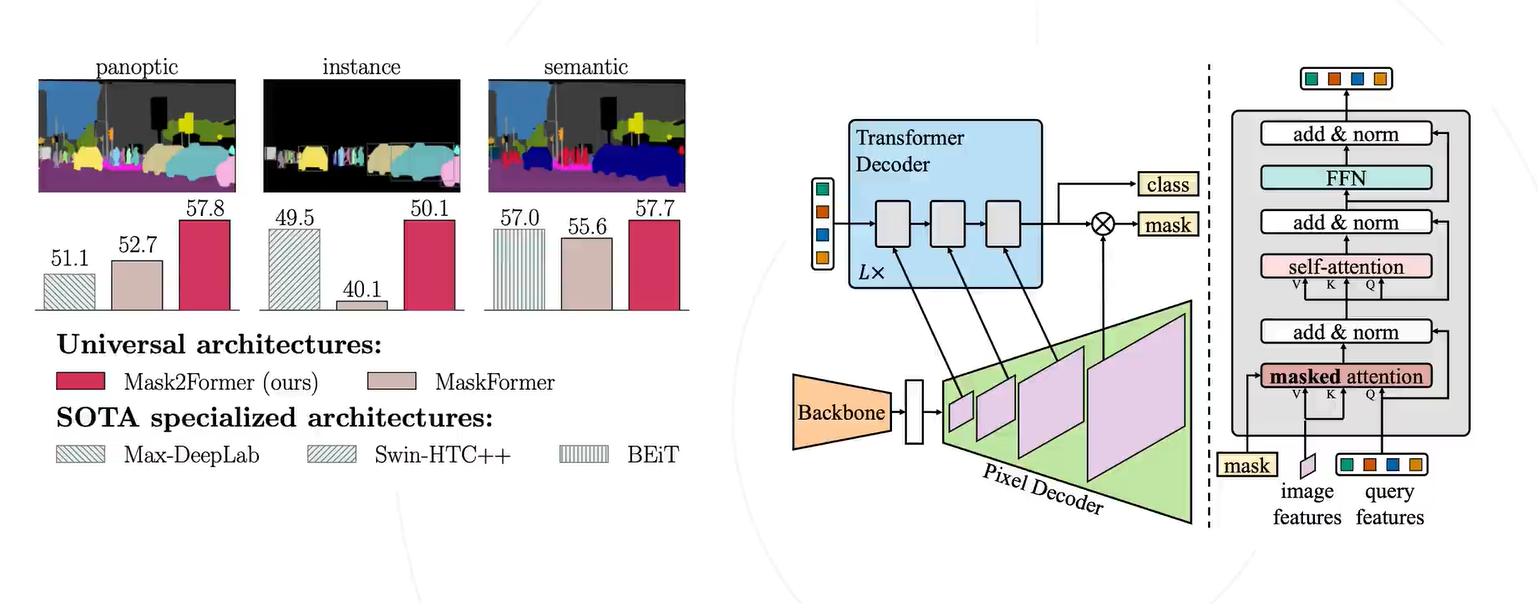
2.3.4 Mask2Former
在 Transformer 块中用到了交叉注意力机制,作者这边说是 mask attention
2.3.5 2023 Segment Anything(SAM)
这是一种视觉大模型,任意一张图片都可以分割,并且这种分割是带语义的。
3. 语义分割模型的评价方法
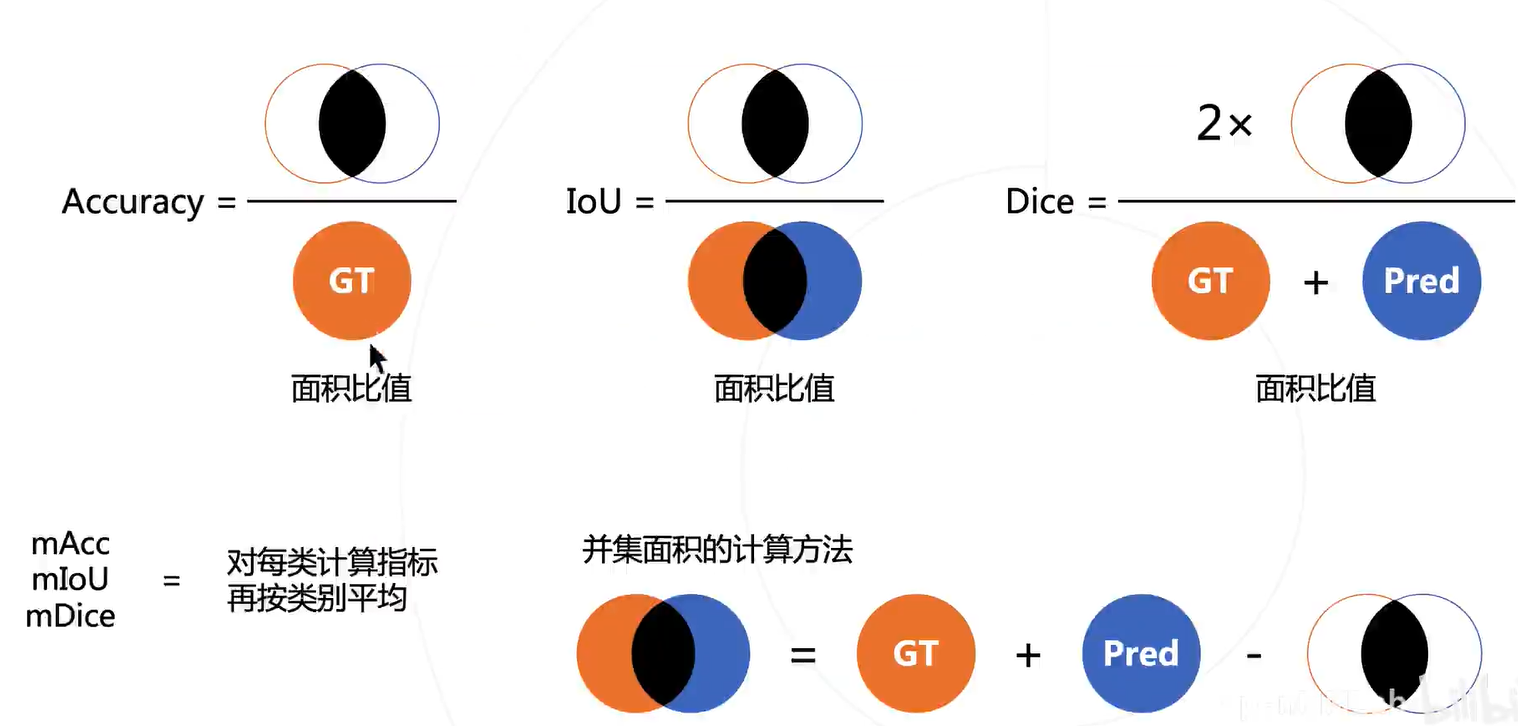
3.1 基于交并集的评估指标
4. 思考
个人觉得语义分割是最底层的任务,因为它已经是深入到对像素的分类,有个小疑惑,不知道类似矢量图那种图片有没有办法做分割?分割的图片如果不是RGB的可以做吗?其他颜色空间的图片是否有支持的模型?
相关推荐
mmsegmentation教程
mmsegmentation教程
mmsegmentation download zip
mmsegmentation download zip
mmsegmentation中文文档
MMSegmentation是openmmlab项目下开源的图像语义分割框架,目前支持pytorch,由于其拥有pipeline加速,完善的数据增强体系,完善的模型库,作为大数据语义分割训练及测试的代码框架是再好不过了。
MMSegmentation 是一个基于 PyTorch 的语义分割开源工具箱 它是 OpenMMLab 项目的一部分
主要特性 统一的基准平台 我们将各种各样的语义分割算法集成到了一个统一的工具箱,进行基准测试。 模块化设计 MMSegmentation 将分割框架解耦成不同的模块组件,通过组合不同的模块组件,用户可以便捷地构建自定义的分割模型。 丰富的即插即用的算法和模型 MMSegmentation 支持了众多主流的和最新的检测算法,例如 PSPNet,DeepLabV3,PSANet,DeepLabV3+ 等. 速度快 训练速度比其他语义分割代码库更快或者相当。
Python库 | mmsegmentation-0.7.0-py3-none-any.whl
python库,解压后可用。 资源全名:mmsegmentation-0.7.0-py3-none-any.whl




