

 南通大学-Python程序设计

2023(春)Python程序设计作业5:Pandas基础技能及综合应用
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
作业要求
- [基础要求] 基于Jupyter Notebook 完成以下实验一、实验二、实验三;
- [重点要求] 修改以下示例代码,以测试不同知识点。在博客上写出你:
- 修改的代码、
- 修改的愿意(意图)
- 代码运行的结果
- 你的结论
实验一:Series对象的应用
实验要求:
- 定义一个Series对象,包含5个整数数据;
- 访问、修改Series对象中的数据;
- 打印Series对象;
- 对Series对象进行计算,如求和、求平均值等。
实验源码:
-
import pandas as pd -
import matplotlib.pyplot as plt -
# 实验一 -
s = pd.Series([10, 20, 30, 40, 50]) -
# s = pd.Series(['abbb', 20, 30, 40, 50]) -
print(s[0]) -
print(s) -
# print(s[-1]) -
print(s[0: 5]) -
s[0] = 11 -
print(s[0]) -
print('求和', s.sum()) -
print('求平均', s.mean()) -
print('求最大值', s.max()) -
print('求最小值', s.min())
代码执行结果:

代码修改及意图:(1)对Series对象生成的数组填充不同类型的数据,观察其是否能存储不同类型的数据;
(2)打印s[-1],观察它与Python中的列表的区别;
(3)对生成的数组进行求和、求平均、求最大值和最小值。
结论:有Series对象生成的数组,它与Python中的列表相似和不同支持,首先是Series对象生成的数组不支持反向索引,及无法使用s[-1]来获取数组中的最后一个元素;它与列表一样,均可以使用切片的方式来获得数组片段;Series对象生成的数组有许多内置函数,来进行数据处理。
实验二:DataFrame对象的应用
实验要求:
- 定义一个DataFrame对象,包含3个列,每列分别为整数、浮点数和字符串类型;
- 访问、修改DataFrame对象中的数据;
- 对DataFrame对象进行计算,如求和、求平均值等。
实验源码:
-
import pandas as pd -
import matplotlib.pyplot as plt -
data = { -
'int_col': [1, 2, 3, 4, 5], -
'float_col': [1.2, 1.3, 1.4, 1.5, 1.6], -
'str_col': ['a', 'b', 'c', 'd', 'e'] -
} -
df = pd.DataFrame(data) -
print(df) -
df.loc[0, 'int_col'] = 3 -
print(df) -
print(df.sum()) -
print(df.mean(numeric_only=True))
代码执行结果:
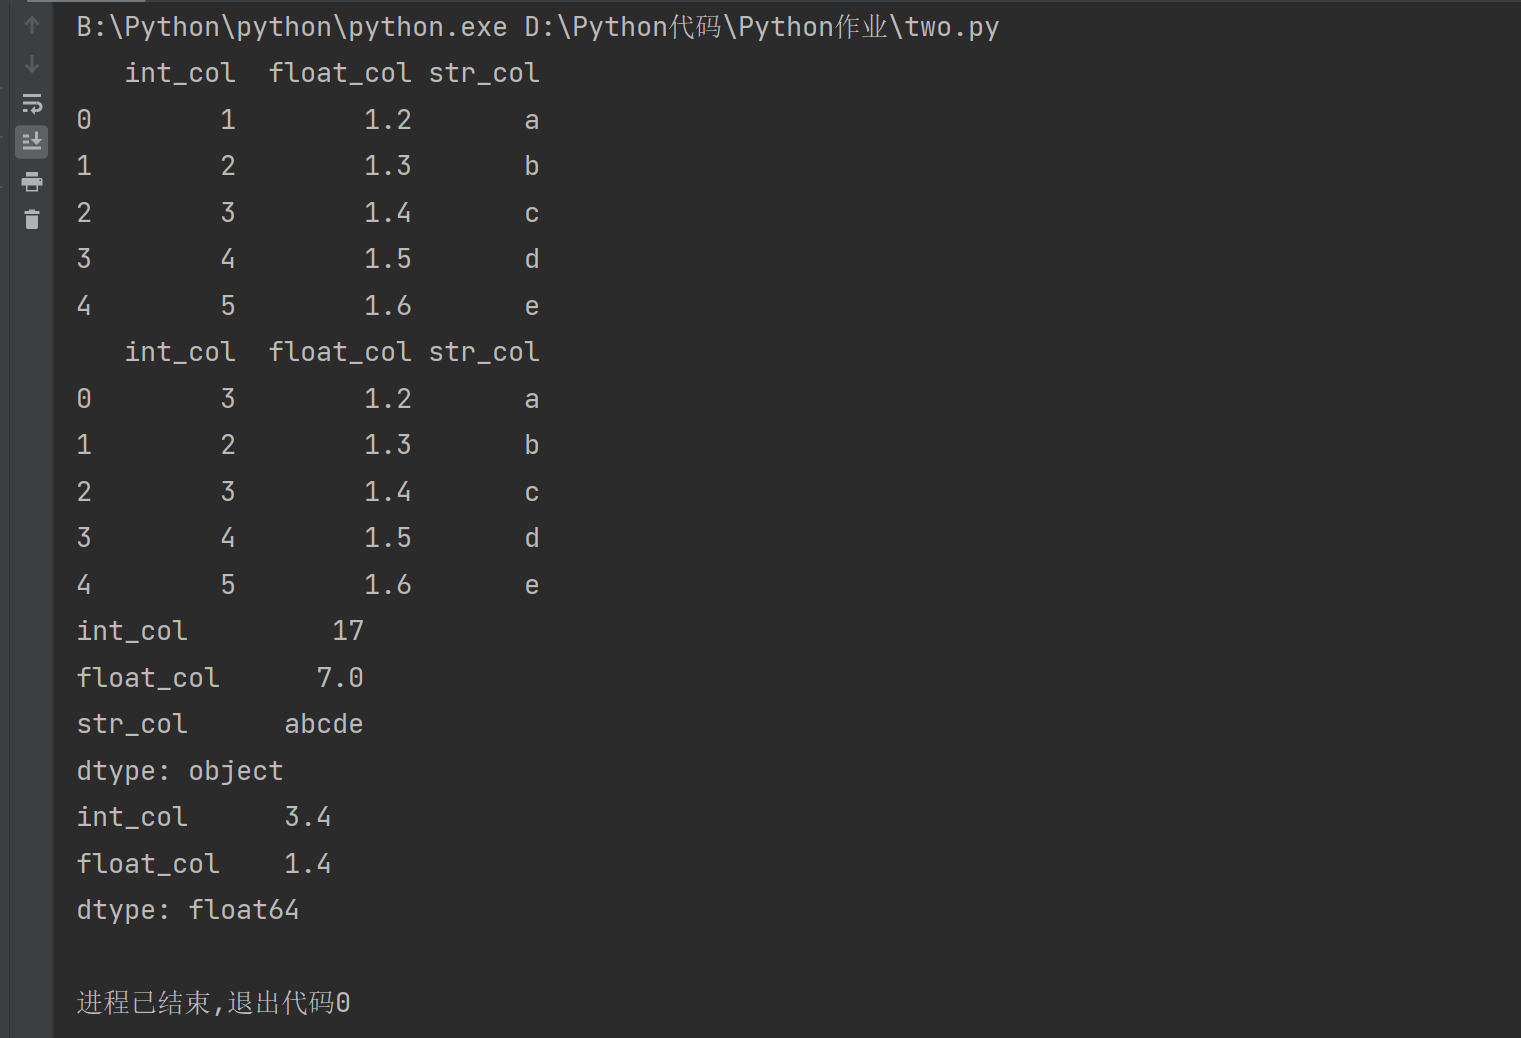
代码修改及其意图:(1)在求平均值时,将代码修改为 print(df.mean(numeric_only=True)) ,因为df.mean()方法只能求数值型数据的平均值,不能求字符串或者 其他非数值型数据的平均值,所以要使用 numeric_only = True 来使它只求数据数值型的列的平局值。
结论:pandas中的DataFrame() 方法可以将字典(列表)生成矩阵的形式,从而能够使对数据的操作更加方便。有DataFrame()生成的数据结构,每一行和每一 列都有相应的行和列的名称,可以通过同时使用行和列的名称来获取相应的数据。在使用该数据结果求行(列)平均值时,一定要保证该行(列)中的所有 元素均为数值型数据。
实验三:综合实例
实验要求:
- 定义一个包含省会城市、人口、GDP、城市面积的DataFrame对象;
- 计算各种排名,如人口最多的城市、GDP最高的城市等;
- 使用Pandas绘图,可视化上述实验结果。
实验源码:
-
import pandas as pd -
import matplotlib.pyplot as plt -
data = { -
'city': ['beijing', 'shanghai', 'guangzhou', 'shenzhen'], -
'population': [2171, 2424, 1500, 1303], -
'gdp': [20000, 30000, 19002, 19990], -
'area': [16410, 6340, 7434, 1996] -
} -
df = pd.DataFrame(data) -
print(df) -
pop_rank = df['population'].rank(ascending=False) -
gdp_rank = df['gdp'].rank(ascending=False) -
area_rank = df['area'].rank(ascending=False) -
print(pop_rank) -
print(gdp_rank) -
print(area_rank) -
ax = df.plot(kind='bar', x='city', y=['population', 'gdp', 'area'], title='China Capital Cities') -
plt.show()
代码执行结果:
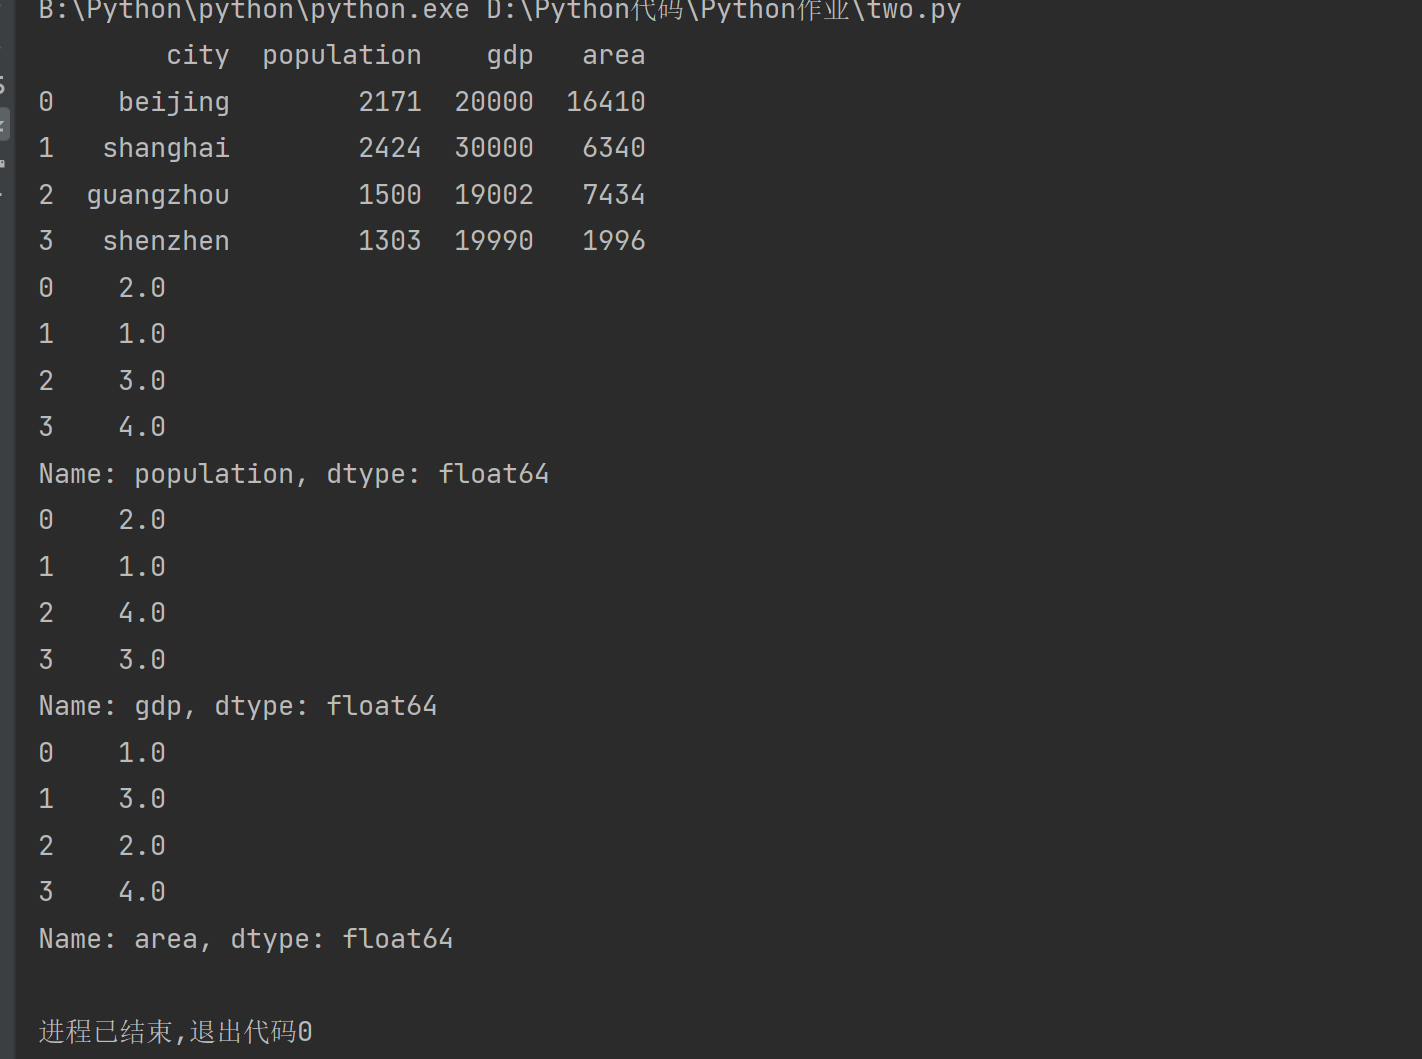
代码修改及其意图:我将data字典中城市的名称由中文全部改为了字母拼音,为了使城市的名称能够展示在数据统计图的 X 轴上,必须得使用英文字母。
结论:pandas库可以很方便的对矩阵中的每一列(行)中的数据进行按照升序(降序)来排列;matplotlib库能够将pandas库中生成的矩阵的每一列进行数据统计,并生成相应的数据统计图。
相关推荐
2022-2023秋季学期Python程序设计大作业.zip
Python程序设计是现代计算机科学教育中的重要组成部分,尤其在2022-2023秋季学期的大作业中,它被选为强化学习和复习巩固的工具。
python-3综合程序设计2023最新英文版
【Python 3 综合程序设计】是一本2023年最新出版的英文版指南,专注于Python 3编程的全面学习。
记录并保存2023年春学习python时的作业和小练习.zip
在“大作业”中,可能会涉及到上述一个或多个知识点的综合运用,通过实际项目来巩固和提升Python技能。
Python程序设计应用基础实验(2023.春季).zip
这个"Python程序设计应用基础实验(2023.春季).zip"文件很可能包含了针对初学者的Python编程教学材料,旨在帮助学生掌握Python的基础知识和实际应用。
吉林大学人工智能学院2023级程序设计导论课程(python)期末大作业
通过本课程的学习,学生不仅能够掌握Python的基本语法,还能够了解到如何将这些基础应用到更高级的程序设计和人工智能项目中。本课程的期末大作业,是一个检验学生学习成果的重要环节。




