2023(春)Python程序设计作业5:Pandas基础技能及综合应用

软工211陈思好 2023-春-学生 2023-06-21 21:50:27

实验一:Series对象的应用

实验要求:

  • 定义一个Series对象,包含5个整数数据;
  • 访问、修改Series对象中的数据;
  • 打印Series对象;
  • 对Series对象进行计算,如求和、求平均值等。

代码实现:

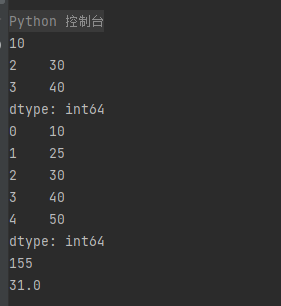
  1.  

    
    import pandas as pd
    # 定义一个Series对象
    s = pd.Series([10, 20, 30, 40, 50])
    # 访问Series对象中的数据
    print(s[0]) # 输出第一个元素
    print(s[2:4]) # 输出第3个到第4个元素
     
    # 修改Series对象中的数据
    s[1] = 25
    # 打印Series对象
    print(s)
     
    # 对Series对象进行计算
    print(s.sum()) # 求和
    print(s.mean()) # 求平均值


结果: 

实验二:DataFrame对象的应用

实验要求:

  • 定义一个DataFrame对象,包含3个列,每列分别为整数、浮点数和字符串类型;
  • 访问、修改DataFrame对象中的数据;
  • 对DataFrame对象进行计算,如求和、求平均值等。

示例代码:

import pandas as pd
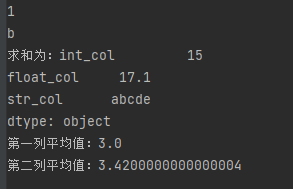
data = {'int_col': [1, 2, 3, 4, 5], 'float_col': [1.2, 2.3, 3.4, 4.5, 5.6], 'str_col': ['a', 'b', 'c', 'd', 'e']}
df = pd.DataFrame(data)
print(df['int_col'][0])#数据定位
print(df.loc[1, 'str_col'])
df.loc[2, 'float_col'] = 3.5#数据修改
print("求和为:",end='')
print(df.sum())
print("第一列平均值:",end='')
print(df['int_col'].mean())
print("第二列平均值:",end='')
print(df['float_col'].mean())

结果: 


实验三:综合实例

实验要求:

  • 定义一个包含省会城市、人口、GDP、城市面积的DataFrame对象;
  • 计算各种排名,如人口最多的城市、GDP最高的城市等;
  • 使用Pandas绘图,可视化上述实验结果。

示例代码:


  1.  
     
    import pandas as pd
    import matplotlib.pyplot as plt
    from pylab import mpl
    # 设置显示中文字体
    mpl.rcParams["font.sans-serif"] = ["SimHei"]
    mpl.rcParams["axes.unicode_minus"] = False
    # 定义一个包含省会城市、人口、GDP、城市面积的DataFrame对象
    data = {'city': ['北京', '上海', '广州', '深圳'], 'population': [2171, 2424, 1500, 1303],
            'gdp': [30320, 32679, 20353, 22458], 'area': [16410, 6340, 7434, 1996]}
    df = pd.DataFrame(data)
    # 计算各种排名
    pop_rank = df['population'].rank(ascending=False)
    gdp_rank = df['gdp'].rank(ascending=False)
    area_rank = df['area'].rank(ascending=False)
    # 将排名添加到DataFrame对象中
    df['pop_rank'] = pop_rank
    df['gdp_rank'] = gdp_rank
    df['area_rank'] = area_rank
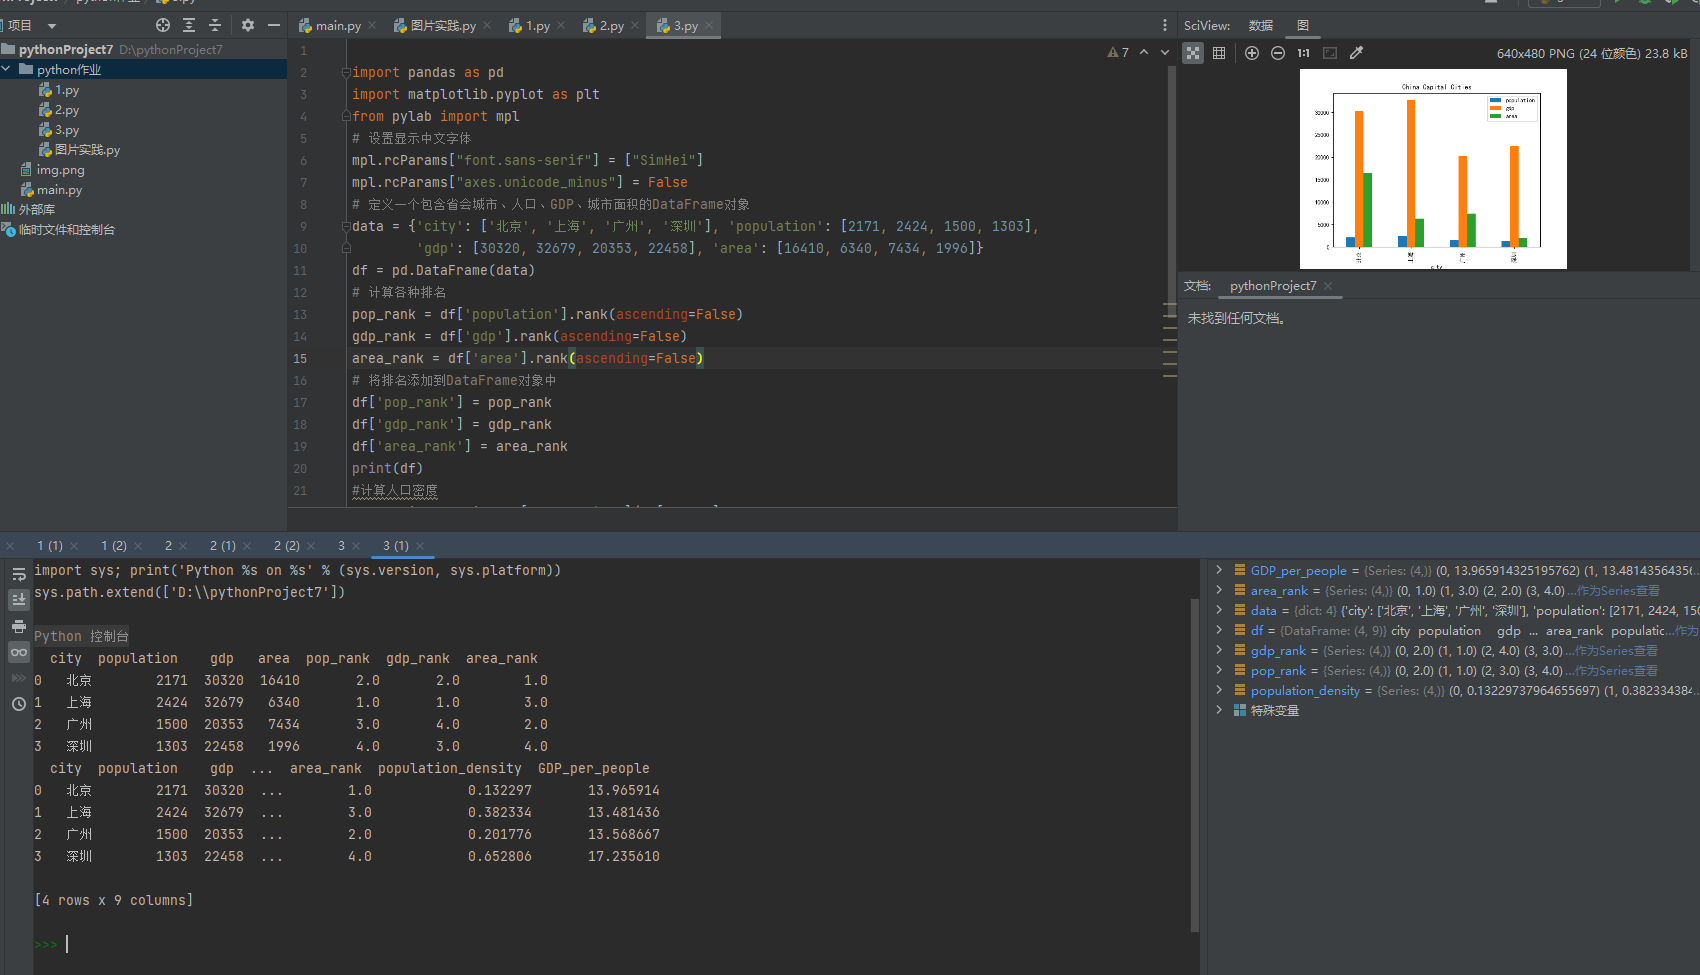
    print(df)
    #计算人口密度
    population_density=df['population']/df['area']
    #城市人均GDP
    GDP_per_people=df['gdp']/df['population']
    #数据添加在表格中
    df['population_density']=population_density
    df['GDP_per_people']=GDP_per_people
    print(df)
    # 使用Pandas绘图,可视化实验结果
    df.plot(kind='bar', x='city', y=['population', 'gdp', 'area'], title='China Capital Cities')
    plt.show()

    结果:


...全文
833 1 打赏 收藏 举报
写回复
用AI写文章
1 条回复
切换为时间正序
请发表友善的回复…
发表回复
韩雨韩 2023-08-03
  • 打赏
  • 举报
回复

大佬nb

内容概要:本文研究了一种周期感知LightGBM预测与NSGA-Ⅱ优化耦合的建筑群能源系统协同调度方法,旨在提升建筑群能源系统的低碳经济性和运行效率。该方法首先利用周期感知的LightGBM模型对建筑群的能源负荷与可再生能源出力进行高精度时序预测,充分挖掘数据中的周期性规律,显著提高预测准确性;随后,结合多目标优化算法NSGA-Ⅱ,构建协同调度模型,综合考虑经济成本、碳排放和能源利用率等多个目标,求解得到一组帕累托最优调度方案,实现多目标间的均衡优化。研究通过Python编程实现了完整的预测与优化流程,并在实际场景中验证了所提方法在降低系统运行成本和减少碳排放方面的有效性。; 适合人群:具备一定Python编程基础,从事电力系统、能源管理、智能优化或机器学习相关领域的研究人员与工程技术人员,尤其适合关注多目标优化与时间序列预测融合应用的硕士、博士研究生及科研工作者。; 使用场景及目标:①应用于建筑群、园区等多主体能源系统的协同调度与低碳优化;②实现对光伏、负荷等具有强周期性特征的时间序列数据进行精准预测;③解决能源调度中经济性、环保性等多目标相互冲突的优化问题,获得兼顾各方需求的调度策略。; 阅读建议:此资源以实际代码实现为核心,建议读者在学习过程中结合Python代码,重点理解周期特征提取、LightGBM模型构建、NSGA-Ⅱ算法应用及多目标优化结果分析等关键环节,并尝试在不同场景下复现和调整参数,以深化对方法原理与工程应用的理解。
内容概要:本文围绕“考虑储能和可再生能源消纳责任制的售电公司购售电策略”展开研究,采用遗传算法构建优化模型,旨在帮助售电公司在电力市场化环境下制定科学合理的购售电决策。研究综合考虑了储能系统的运行特性、可再生能源出力的不确定性以及国家对可再生能源消纳的强制性考核要求,构建了一个融合经济性、合规性与风险控制的多目标优化框架。通过Python编程实现算法求解,对不同场景下的购电组合、储能调度策略及收益情况进行仿真分析,验证了所提模型在提升售电公司经济效益和履行社会责任方面的有效性与实用性,为其在复杂市场环境中的运营决策提供了理论支持和技术工具。; 适合人群:具备一定电力系统基础知识和Python编程能力,从事电力市场、能源管理或优化算法研究的研发人员、高校研究生及行业分析师。; 使用场景及目标:①为售电公司设计满足可再生能源消纳考核要求的购售电策略;②研究储能系统在电力市场交易中的经济调度与价值实现;③学习遗传算法在复杂多目标能源优化问题中的建模与实现方法。; 阅读建议:此资源以复现科研论文为目标,强调算法实现与策略分析的结合,建议读者在学习过程中重点关注目标函数的设计、约束条件的处理以及遗传算法参数的调优,并动手运行代码以加深对模型收敛性与策略有效性的理解。

162

社区成员

发帖
与我相关
我的任务

社区描述
软件工程老师
python 高校 江苏省·南通市
社区管理员
  • juking@ntu
加入社区
  • 近7日
  • 近30日
  • 至今
社区公告
暂无公告

试试用AI创作助手写篇文章吧