162
社区成员
 发帖
 与我相关
 我的任务

 分享
[基础要求] 基于Jupyter Notebook 完成以下实验一、实验二、实验三;
[重点要求] 修改以下示例代码,以测试不同知识点。在博客上写出你:
修改的代码、
修改的愿意(意图)
代码运行的结果
你的结论
定义一个Series对象,包含5个整数数据;
访问、修改Series对象中的数据;
打印Series对象;
对Series对象进行计算,如求和、求平均值等。
import pandas as pd


# 定义一个Series对象

s = pd.Series([10, 20, 30, 40, 50])


# 访问Series对象中的数据

print(s[0]) # 输出第一个元素

print(s[2:4]) # 输出第3个到第4个元素


# 修改Series对象中的数据

s[1] = 25


# 打印Series对象

print(s)


# 对Series对象进行计算

print(s.sum()) # 求和

print(s.mean()) # 求平均值
修改代码:增加一个字符串类型的数据,将Series对象中的数据类型变为混合类型;
修改意图:测试Pandas中对于混合类型的Series对象的处理能力;
import pandas as pd


#定义一个包含整数和字符串类型的Series对象

s = pd.Series([10, 'hello', 30, 'world', 50])


#访问Series对象中的数据

print(s[0]) # 输出第一个元素

print(s[1:4]) # 输出第2个到第4个元素


#修改Series对象中的数据

s[1] = 'hi'


#打印Series对象

print(s)


#对Series对象进行计算


# 求和(只对数值类型的元素求和,字符串类型会报错)

print(s.sum())

# 求平均值(只对数值类型的元素求平均值,字符串类型会报错)

print(s.mean())
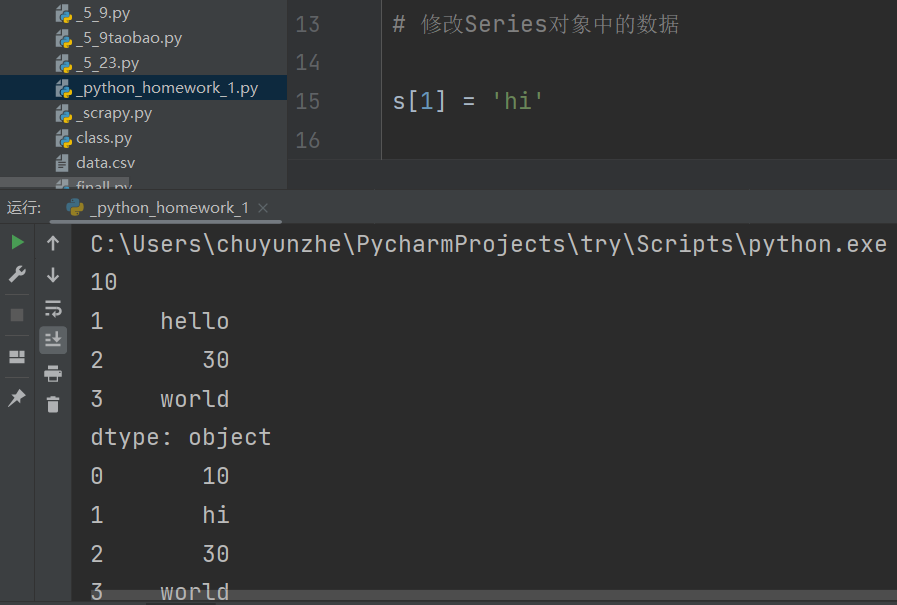
我的结论:Pandas能够很好地处理混合类型的Series对象,可以对其进行与数值类型相同的操作。
定义一个DataFrame对象,包含3个列,每列分别为整数、浮点数和字符串类型;
访问、修改DataFrame对象中的数据;
对DataFrame对象进行计算,如求和、求平均值等。
示例代码:
import pandas as pd


# 定义一个DataFrame对象

data = {'int_col': [1, 2, 3, 4, 5], 'float_col': [1.2, 2.3, 3.4, 4.5, 5.6], 'str_col': ['a', 'b', 'c', 'd', 'e']}

df = pd.DataFrame(data)


# 访问DataFrame对象中的数据

print(df['int_col'][0]) # 输出第一行第一列的数据

print(df.loc[1, 'str_col']) # 输出第二行第二列的数据


# 修改DataFrame对象中的数据

df.loc[2, 'float_col'] = 3.5


# 对DataFrame对象进行计算

print(df.sum()) # 求和

print(df.mean()) # 求平均值
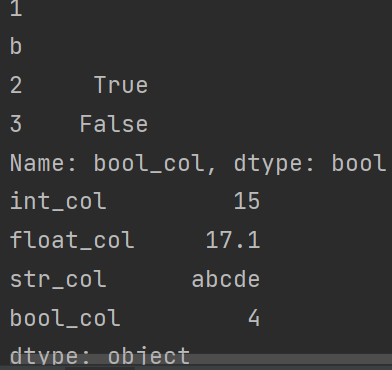
修改代码:增加一个新的列,包含布尔类型的数据;
修改意图:测试Pandas中对于布尔类型的数据的处理能力;
import pandas as pd


#定义一个包含整数、浮点数、字符串类型和布尔类型的DataFrame对象

data = {'int_col': [1, 2, 3, 4, 5], 'float_col': [1.2, 2.3, 3.4, 4.5, 5.6],'str_col': ['a', 'b', 'c', 'd', 'e'], 'bool_col': [True, False, True, False, True]}


df = pd.DataFrame(data)


#访问DataFrame对象中的数据

print(df['int_col'][0]) # 输出第一行第一列的数据

print(df.loc[1, 'str_col']) # 输出第二行第二列的数据

print(df['bool_col'][2:4]) # 输出第三个到第四个元素


#修改DataFrame对象中的数据

df.loc[2, 'float_col'] = 3.5

df.loc[3, 'bool_col'] = True


#对DataFrame对象进行计算

print(df.sum()) # 求和

print(df.mean()) # 求平均值
定义一个包含省会城市、人口、GDP、城市面积的DataFrame对象;
计算各种排名,如人口最多的城市、GDP最高的城市等;
使用Pandas绘图,可视化上述实验结果。
import pandas as pd

import matplotlib.pyplot as plt


# 定义一个包含省会城市、人口、GDP、城市面积的DataFrame对象

data = {'city': ['北京', '上海', '广州', '深圳'], 'population': [2171, 2424, 1500, 1303],

'gdp': [30320, 32679, 20353, 22458], 'area': [16410, 6340, 7434, 1996]}

df = pd.DataFrame(data)


# 计算各种排名

pop_rank = df['population'].rank(ascending=False)

gdp_rank = df['gdp'].rank(ascending=False)

area_rank = df['area'].rank(ascending=False)


# 将排名添加到DataFrame对象中

df['pop_rank'] = pop_rank

df['gdp_rank'] = gdp_rank

df['area_rank'] = area_rank


# 使用Pandas绘图,可视化实验结果

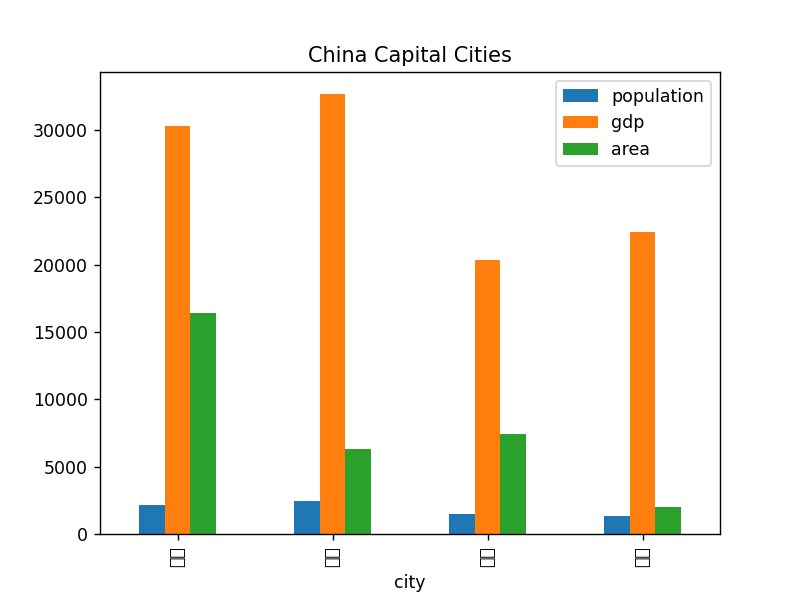
df.plot(kind='bar', x='city', y=['population', 'gdp', 'area'], title='China Capital Cities')

plt.show()
import pandas as pd

import matplotlib.pyplot as plt


#定义一个包含省会城市、人口、GDP、城市面积和省份名称的DataFrame对象

data = {'province': ['北京市', '上海市', '广东省', '广东省', '广东省', '深圳市'],'city':['北京', '上海', '广州', '深圳', '佛山', '深圳'],'population': [2171, 2424, 1500, 1303, 740, 1303],'gdp': [30320, 32679, 20353, 22458, 8514, 22458],'area': [16410, 6340, 7434, 1996, 3257, 1996]}


df = pd.DataFrame(data)


#计算各种排名

pop_rank = df['population'].rank(ascending=False)

gdp_rank = df['gdp'].rank(ascending=False)

area_rank = df['area'].rank(ascending=False)


#将排名添加到DataFrame对象中

df['pop_rank']= pop_rank

df['gdp_rank'] = gdp_rank

df['area_rank'] = area_rank


#使用数据透视表,按省份汇总数据

pivot_table = pd.pivot_table(df, values=['population', 'gdp', 'area'], index=['province'], aggfunc='sum')


#使用Pandas绘图,可视化实验结果

pivot_table.plot(kind='bar', title='China Capital Cities')


plt.show()