2023(春)Python程序设计作业5:Pandas基础技能及综合应用

软工211-439-钱哲玮 2023-春-学生 2023-06-28 20:16:21

作业要求

  1.    [基础要求]  基于Jupyter Notebook 完成以下实验一、实验二、实验三;
  2.    [重点要求]  修改以下示例代码,以测试不同知识点。在博客上写出你:
  •  修改的代码、
  •  修改的愿意(意图)
  •  代码运行的结果
  •  你的结论

实验一:Series对象的应用

实验要求:

  • 定义一个Series对象,包含5个整数数据;
  • 访问、修改Series对象中的数据;
  • 打印Series对象;
  • 对Series对象进行计算,如求和、求平均值等。

实验源码:

  1. import pandas as pd
  2. import matplotlib.pyplot as plt
  3.  
  4. # 实验一
  5.  
  6. s = pd.Series([10, 20, 30, 40, 50])
  7. # s = pd.Series(['abbb', 20, 30, 40, 50])
  8. print(s[0])
  9. print(s)
  10. # print(s[-1])
  11. print(s[0: 5])
  12. s[0] = 11
  13. print(s[0])
  14.  
  15. print('求和', s.sum())
  16. print('求平均', s.mean())
  17. print('求最大值', s.max())
  18. print('求最小值', s.min())

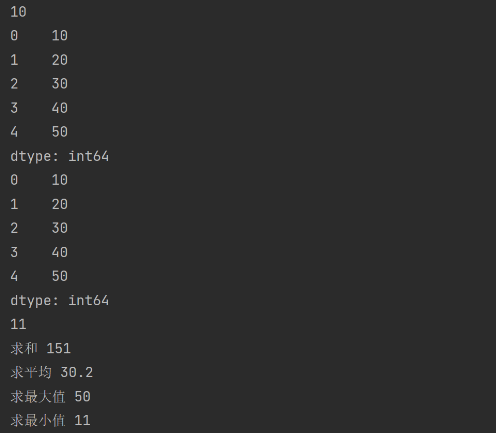
 代码执行结果: 


代码修改及意图:(1)对Series对象生成的数组填充不同类型的数据,观察其是否能存储不同类型的数据;

                             (2)打印s[-1],观察它与Python中的列表的区别;

                             (3)对生成的数组进行求和、求平均、求最大值和最小值。

结论:有Series对象生成的数组,它与Python中的列表相似和不同支持,首先是Series对象生成的数组不支持反向索引,及无法使用s[-1]来获取数组中的最后一个元素;它与列表一样,均可以使用切片的方式来获得数组片段;Series对象生成的数组有许多内置函数,来进行数据处理。

实验二:DataFrame对象的应用

实验要求:

  • 定义一个DataFrame对象,包含3个列,每列分别为整数、浮点数和字符串类型;
  • 访问、修改DataFrame对象中的数据;
  • 对DataFrame对象进行计算,如求和、求平均值等。

 实验源码:


  1. import pandas as pd
  2. import matplotlib.pyplot as plt
  3. data = {
  4.     'int_col': [1, 2, 3, 4, 5],
  5.     'float_col': [1.2, 1.3, 1.4, 1.5, 1.6],
  6.     'str_col': ['a', 'b', 'c', 'd', 'e']
  7. }
  8. df = pd.DataFrame(data)
  9. print(df)
  10. df.loc[0, 'int_col'] = 3
  11. print(df)
  12. print(df.sum())
  13. print(df.mean(numeric_only=True))

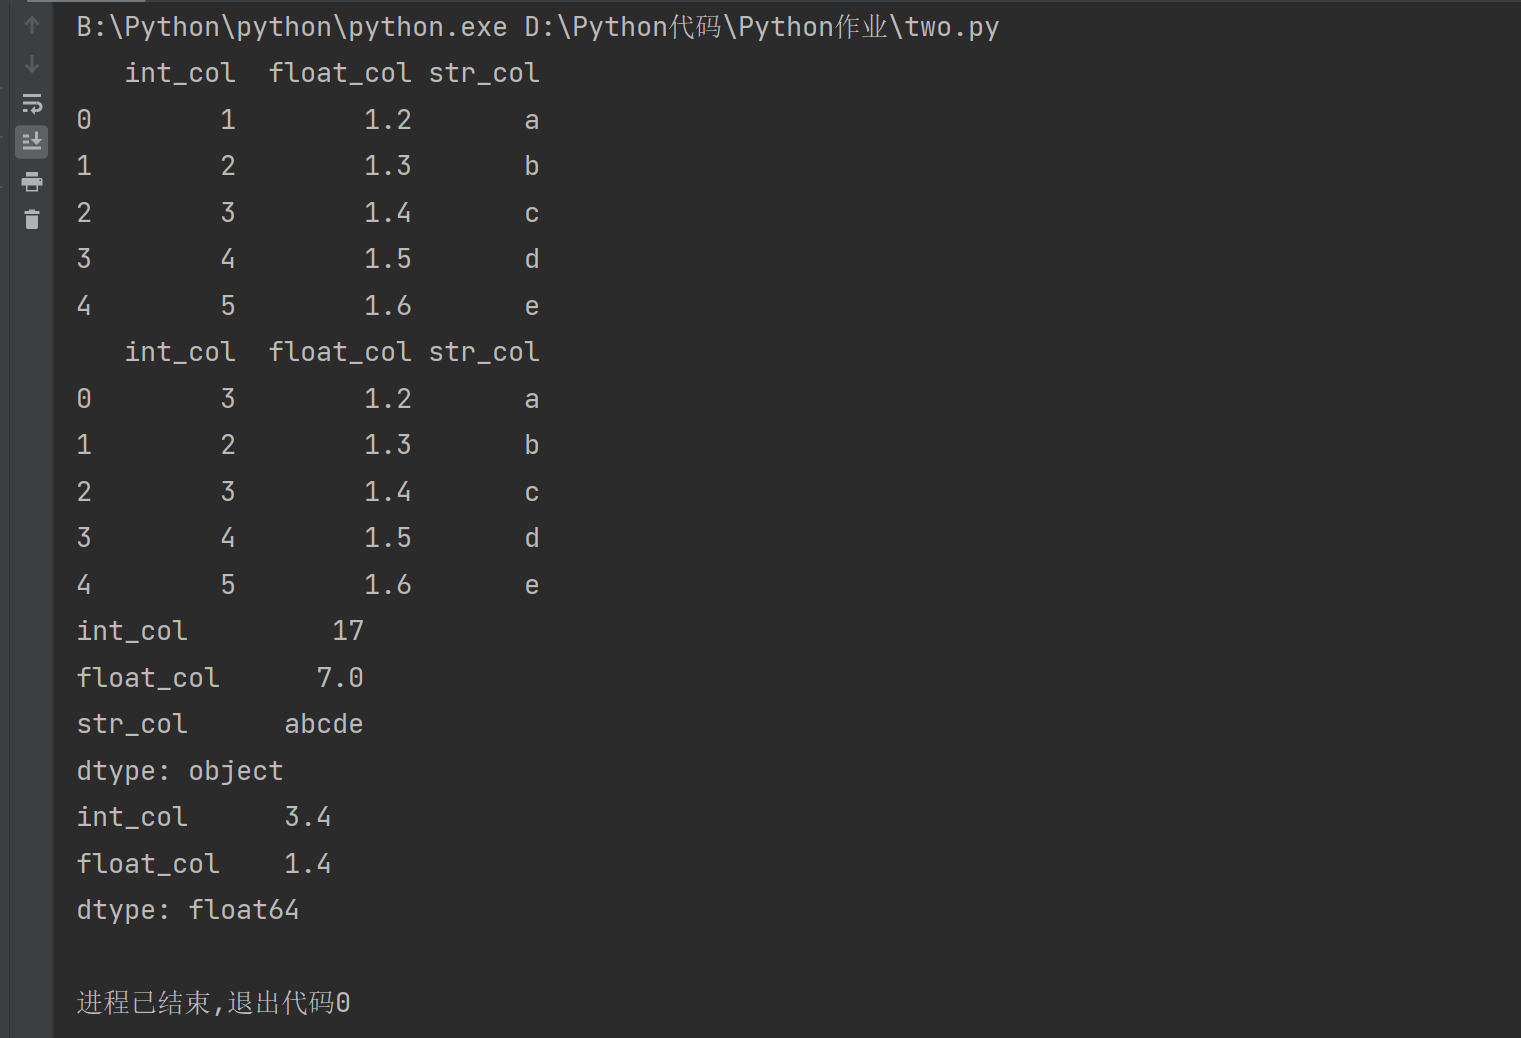
 代码执行结果:

 代码修改及其意图:(1)在求平均值时,将代码修改为  print(df.mean(numeric_only=True))  ,因为df.mean()方法只能求数值型数据的平均值,不能求字符串或者其他非数值型数据的平均值,所以要使用 numeric_only = True 来使它只求数据数值型的列的平局值。

结论:pandas中的DataFrame() 方法可以将字典(列表)生成矩阵的形式,从而能够使对数据的操作更加方便。有DataFrame()生成的数据结构,每一行和每一                 列都有相应的行和列的名称,可以通过同时使用行和列的名称来获取相应的数据。在使用该数据结果求行(列)平均值时,一定要保证该行(列)中的所有                 元素均为数值型数据。

实验三:综合实例

实验要求:

  • 定义一个包含省会城市、人口、GDP、城市面积的DataFrame对象;
  • 计算各种排名,如人口最多的城市、GDP最高的城市等;
  • 使用Pandas绘图,可视化上述实验结果。

实验源码:


  1. import pandas as pd

  2. import matplotlib.pyplot as plt

  3. data = {

  4. 'city': ['beijing', 'shanghai', 'guangzhou', 'shenzhen'],

  5. 'population': [2171, 2424, 1500, 1303],

  6. 'gdp': [20000, 30000, 19002, 19990],

  7. 'area': [16410, 6340, 7434, 1996]

  8. }

  9. df = pd.DataFrame(data)

  10. print(df)

  11. pop_rank = df['population'].rank(ascending=False)

  12. gdp_rank = df['gdp'].rank(ascending=False)

  13. area_rank = df['area'].rank(ascending=False)

  14. print(pop_rank)

  15. print(gdp_rank)

  16. print(area_rank)

  17. ax = df.plot(kind='bar', x='city', y=['population', 'gdp', 'area'], title='China Capital Cities')

  18. plt.show()

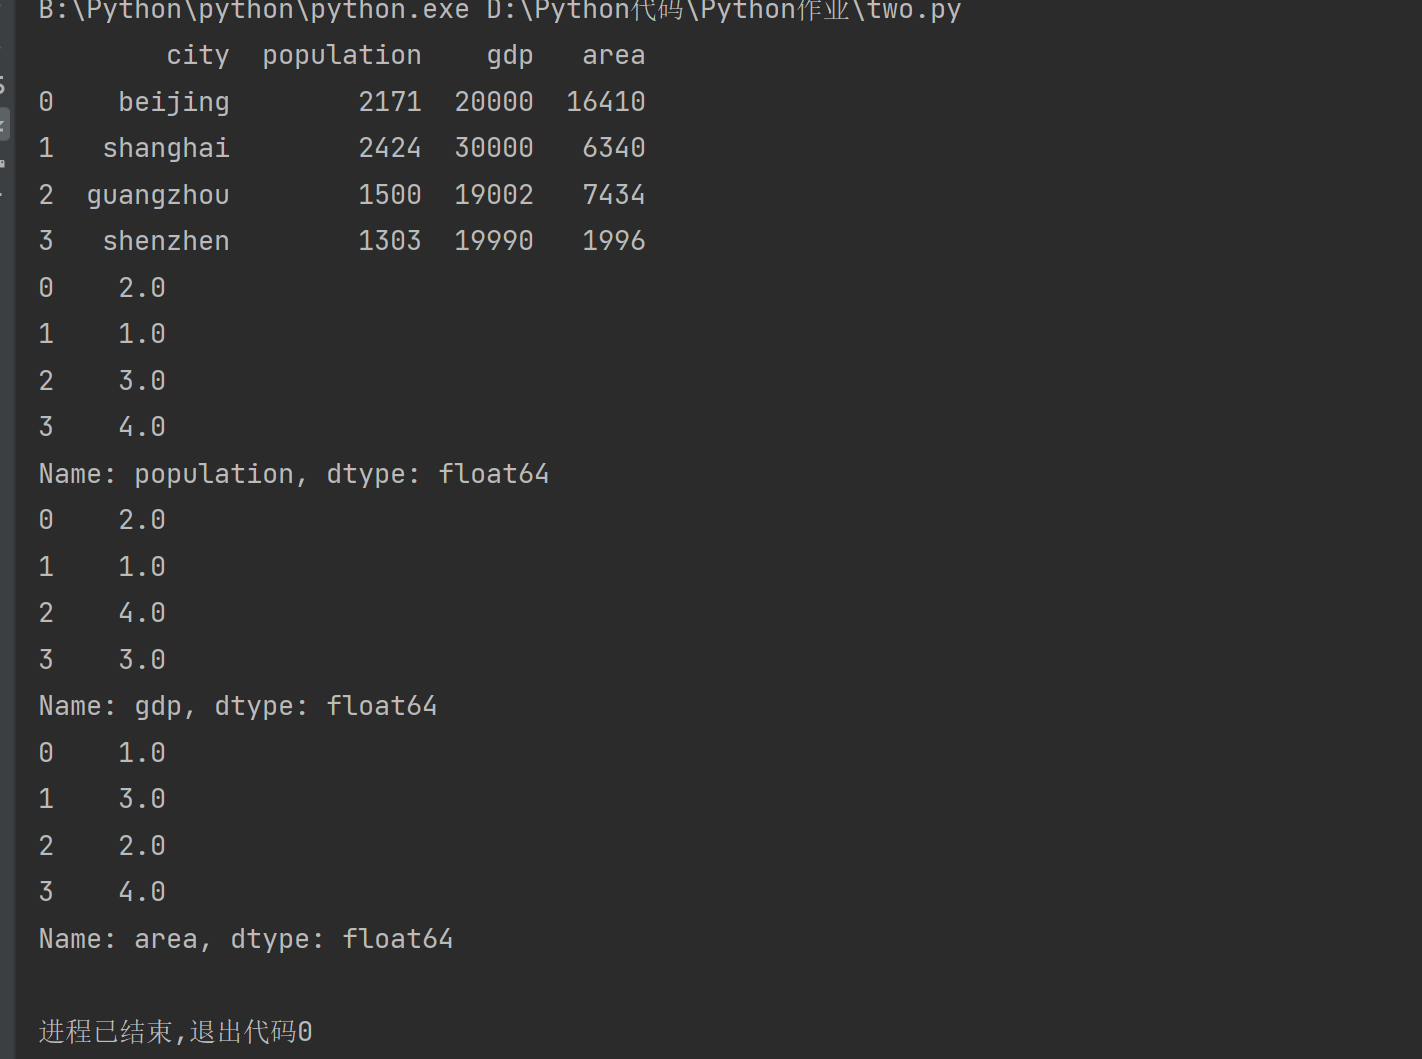
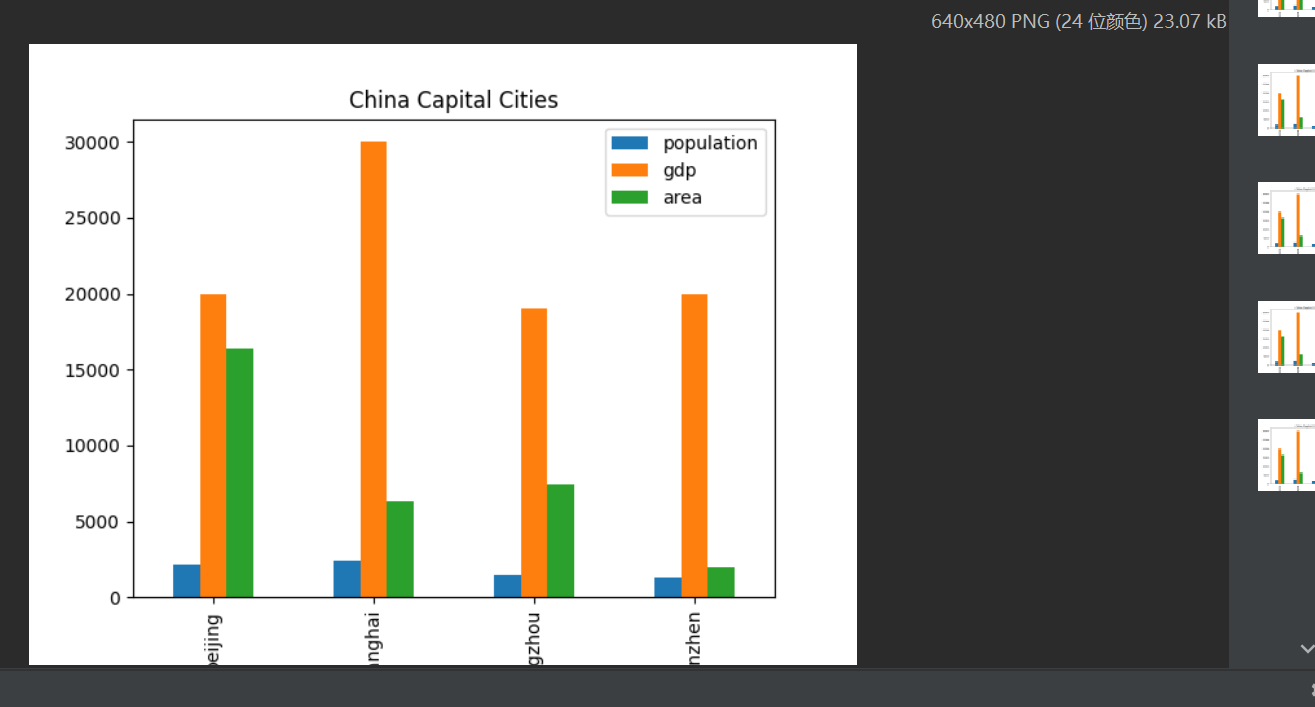
代码执行结果:


 代码修改及其意图:我将data字典中城市的名称由中文全部改为了字母拼音,为了使城市的名称能够展示在数据统计图的 X 轴上,必须得使用英文字母。

结论:pandas库可以很方便的对矩阵中的每一列(行)中的数据进行按照升序(降序)来排列;matplotlib库能够将pandas库中生成的矩阵的每一列进行数据统计,并生成相应的数据统计图。


...全文
782 回复 打赏 收藏 转发到动态 举报
写回复
用AI写文章
回复
切换为时间正序
请发表友善的回复…
发表回复
随着文化消费升级与演出市场发展,剧场票务面临售卖效率低、防伪弱、会员价值挖掘不足等问题:固定售价无法反映供需变化,抢票并发导致超卖与重复下单,纸质票核销效率低且易伪造。本文设计并实现了剧场演出票务与会员运营管理系统。 系统采用Java 17与Spring Boot 3.x构建后端,Vue 3构建管理端,微信小程序作为购票入口,MySQL 8.0为主数据库,Redis承担座位锁、缓存与防重功能,并通过微信支付完成在线支付,实现演出发布、在线选座购票、电子票核销、会员积分、周边商城与数据统计的全流程数字化管理。系统采用前后端分离分层架构,划分为演出管理、选座购票、票务核销、会员运营、数据统计五大模块,支持多剧场多场次统一管理。 本文提出三项创新:一是动态票价与座位分区定价机制(DPM),根据上座率、距开演时间动态调整票价,实测热门场次平均票价提升约12%;二是选座并发防护与票务防重机制(SCP),通过座位级Redis分布式锁、条件更新与票码唯一约束三重防护,实测200并发选座零超卖、票码零重复;三是会员画像与演出精准推荐机制(MIR),基于购票历史、观演偏好与积分构建画像,结合协同过滤实现精准推荐,实测推荐点击率提升18%。 测试表明:200并发抢购热门场次座位零超卖、票码零重复,电子票核销平均38ms,防重拦截率100%,高峰并发下平均响应400ms以内。本文为剧场运营提供覆盖票务销售-核销-会员运营-数据决策全链路的一体化方案,为座位管理、票务安全与会员精细化运营提供可复用技术范式。 【课程报告内容】 摘要 第1章 绪论 第2章 相关技术与理论 第3章 系统需求分析 第4章 系统总体设计 第5章 系统详细设计与实现 第6章 系统测试与分析 第7章 总结与展望 参考文献 附件-实现指南

162

社区成员

发帖
与我相关
我的任务

社区描述
软件工程老师
python 高校 江苏省·南通市
社区管理员
  • juking@ntu
加入社区
  • 近7日
  • 近30日
  • 至今
社区公告
暂无公告

试试用AI创作助手写篇文章吧