


118
社区成员
 发帖
 与我相关
 我的任务

 分享
->github链接
| PSP2.1 | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | 30 | 30 |
| ·Estimate | · 估计这个任务需要多少时间 | 40 | 50 |
| Development | 开发 | 1320 | 1500 |
| ·Analysis | · 需求分析 (包括学习新技术) | 300 | 600 |
| ·Design Spec | · 生成设计文档 | 60 | 60 |
| ·Design Review | · 设计复审 | 60 | 60 |
| ·Coding Standard | · 代码规范 (为目前的开发制定合适的规范) | 120 | 60 |
| ·Design | · 具体设计 | 180 | 120 |
| ·Coding | · 具体编码 | 240 | 300 |
| ·Code Review | · 代码复审 | 120 | 60 |
| ·Test | · 测试(自我测试,修改代码,提交修改) | 240 | 180 |
| Reporting | 报告 | 120 | 135 |
| · Test Repor | · 测试报告 | 60 | 60 |
| · Size Measurement | · 计算工作量 | 30 | 30 |
| · Postmortem & Process Improvement Plan | · 事后总结, 并提出过程改进计划 | 30 | 45 |
| · 合计 | 1480 | 1675 |
1.我将这次任务的步骤分为如下几步:分配规划、设计代码结构、编写代码、实现代码、测试代码、总结经验;
2.通过观看bilibili上爬虫相关视频来学习如何爬取弹幕,在csdn上查找关于爬虫的学习资料,获取爬虫所需要用到的库;
3.用到的技术栈:request库、wordcloud词云生成图、imageio美化词云图、jieba分割词汇、正则表达式等
vidio_url = []
for page in range(1,11):
    if page == 1:
        url = f'https://search.bilibili.com/all?keyword=日本核污染水排海'
    else:
        url = f'https://search.bilibili.com/all?vt=68973445&keyword=日本核污染水排海&page={page}'
    headers = {

        'cookie': 'buvid3=30DF780B-DB30-4457-8407-57454C01A4BB167619infoc; LIVE_BUVID=AUTO8116337025491960; CURRENT_BLACKGAP=0; buvid4=939D7768-05E0-DA38-347F-0A408C52706E20214-022012117-UfWrDUDTDzRnSe15sJpOBg%3D%3D; i-wanna-go-back=-1; buvid_fp_plain=undefined; DedeUserID=508665675; DedeUserID__ckMd5=306a3867bf584887; is-2022-channel=1; _uuid=D10F108D45-CF25-E5DF-C1AF-6D21557DF61369937infoc; b_nut=100; rpdid=|(u))kkYu|Y|0J\'uYY)l)|muR; CURRENT_PID=3a138c60-c872-11ed-b370-055fa69d96f2; nostalgia_conf=-1; hit-dyn-v2=1; b_ut=5; FEED_LIVE_VERSION=V8; header_theme_version=CLOSE; hit-new-style-dyn=1; CURRENT_QUALITY=80; home_feed_column=5; browser_resolution=1536-719; fingerprint=9222aabb0803066dd86685cc1b82fd17; buvid_fp=9222aabb0803066dd86685cc1b82fd17; SESSDATA=71b38caf%2C1709995578%2Cc0de4%2A92CjC3KxZ1gYUjb-WuLf5mwMRNXzrrUgT2BFEK_2fE5QXnRBsweogXULEA7jykGjGk21cSVndyLTBqRjRWX1VpLWVjU3p5OXJpMFlFZ1gxSUVhOE5XVmRwVkJDeXhRLUVKM25CN0diaHE1RHNvT0F6ZC1HUmJGRmVncTA1RHNHbWRiZHk2MDNJNjh3IIEC; bili_jct=e0af9ab0bb8547aae5b1d25fc2042c02; CURRENT_FNVAL=4048; bili_ticket_expires=1694852185; bili_ticket=eyJhbGciOiJIUzI1NiIsImtpZCI6InMwMyIsInR5cCI6IkpXVCJ9.eyJleHAiOjE2OTQ4NTIxODUsImlhdCI6MTY5NDU5Mjk4NSwicGx0IjotMX0.WHYoH5JCYRnbxV_bb6y1Up5jimYVZokc0hu-AtdVbNY; sid=78ujxx8x; PVID=1; bp_video_offset_508665675=841041354928685060; b_lsid=A212E10110_18A93A3EFAF',
        'origin': 'https://www.bilibili.com',
        'referer': 'https://www.bilibili.com/video/BV1Ym4y1K7rg/?spm_id_from=333.337.search-card.all.click&vd_source=68065e2e75db185c5be3ff7a9d355ed7',
        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/92.0.4515.131 Safari/537.36 SLBrowser/8.0.1.4031 SLBChan/103'

    }

    response = requests.get(url = url,headers = headers)
    response.encoding = 'utf-8'

    text_list = re.findall('bvid:"(.*?)"',response.text)
    vidio_url += text_list
bv_url = []
for index in vidio_url:
    url = 'https://www.ibilibili.com/video/'+index
    bv_url.append(url)
dm_url = []
for url in bv_url:
    response = requests.get(url = url)
    response.encoding = 'utf-8'
    new_url = re.findall('<a href="(.*?)"  class="btn btn-default" target="_blank">弹幕</a>', response.text)
    dm_url += new_url
counts={}
for url in dm_url:
    response = requests.get(url=url)
    response.encoding = 'utf-8'
    dm_list = re.findall('</d><d p=".*?">(.*?)</d>', response.text)
    for index in dm_list:
        with open('dm.txt', mode='a', encoding='utf-8') as f:
            f.write(index)
            f.write('\n')
import jieba
import wordcloud
import imageio
img = imageio.imread('词云背景图.png')
#制作词云图
f = open(r'dm.txt',encoding = 'utf-8')
text = f.read()
#print(text)
text_list = jieba.lcut(text)

string = ''.join(text_list)
print(string)

wc = wordcloud.WordCloud(
    width=600,
    height=400,
    background_color='white',
    font_path='msyh.ttc',
    scale=11,
    mask=img,
    stopwords={'的','了'}
)

wc.generate(string)
wc.to_file('out.png')
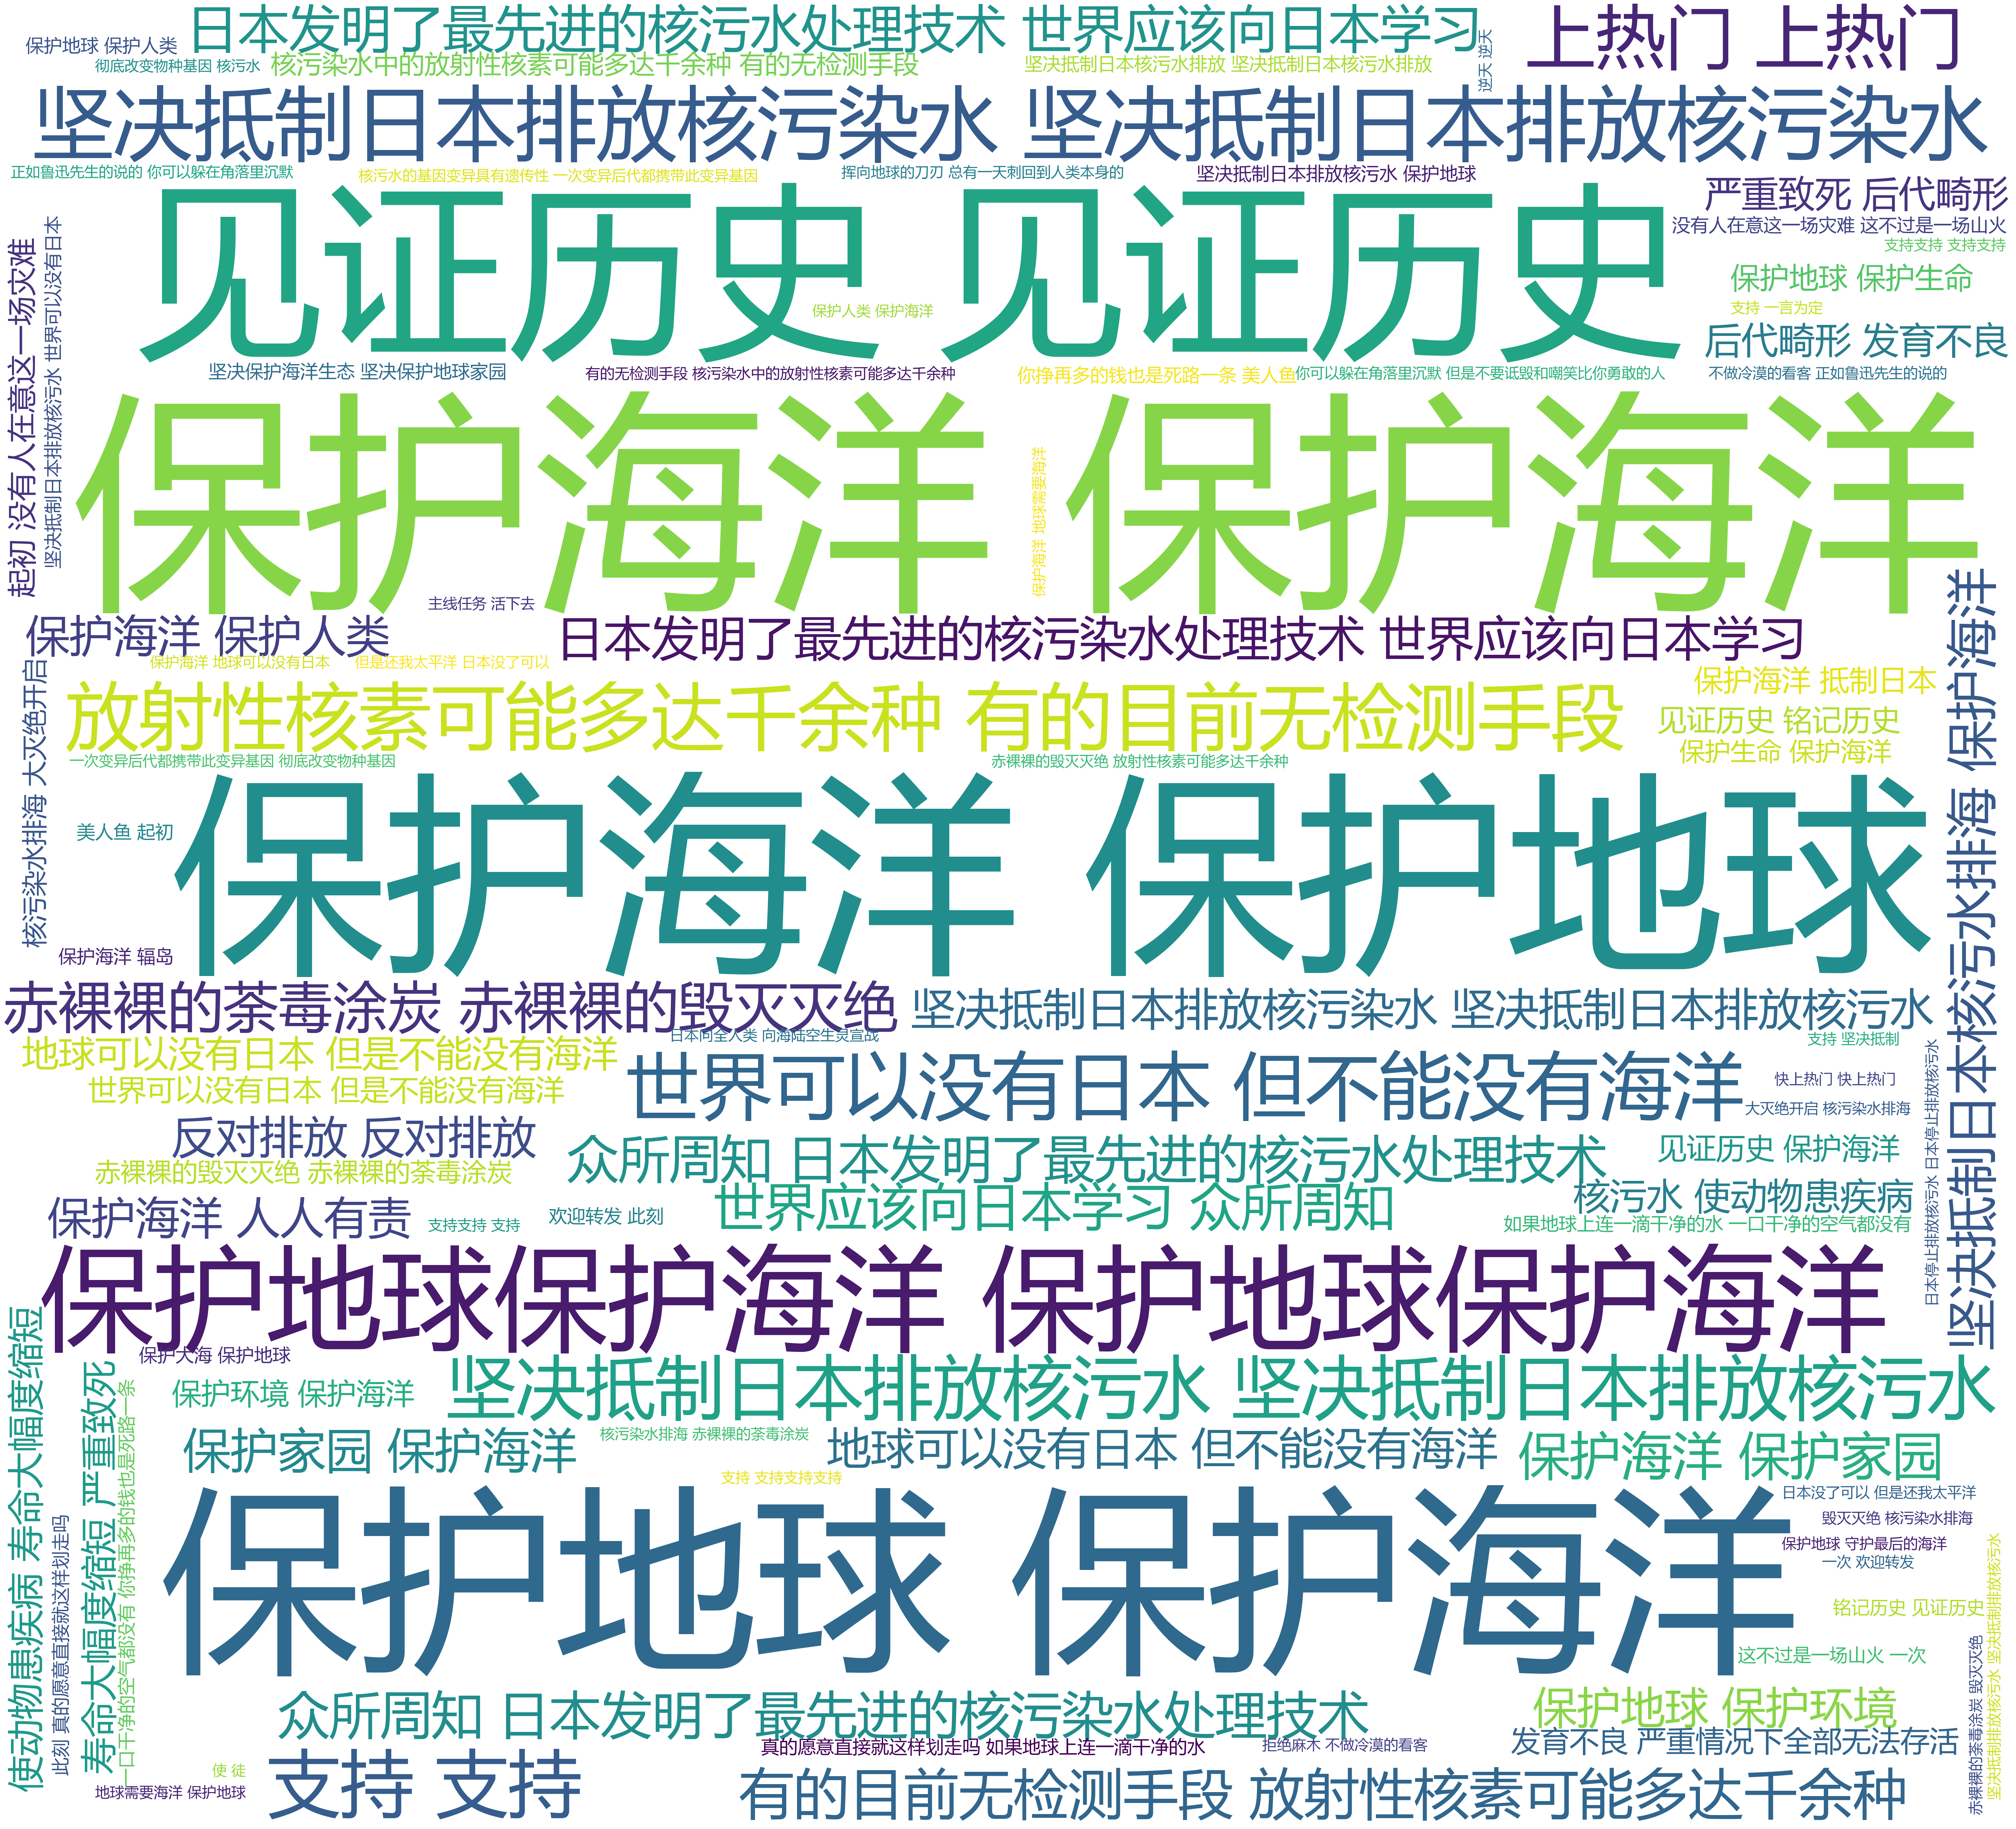
结论:出现次数最多的弹幕为:保护海洋、见证历史、坚决抵制日本核废水排海等,由此得出结论,绝大多数的网友认为这是一件历史级别的,反人类行为的事件
判断方式:通过观察词云图
1.选修没选到python ,写python几乎全靠看b站视频,需要赶紧加强python熟练度;
2.最大的收获当然是学会了如何爬b站的弹幕,感觉可以用来爬一些感兴趣的方向;
3.任务完成度勉勉强强,还有很多能改进的地方


