

 OpenMMLab

书生浦语大模型单卡低成本微调XTuner(四)
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
XTuner 大模型单卡低成本微调实战
Finetune简介
- 增量预训练微调
- 指令跟随微调
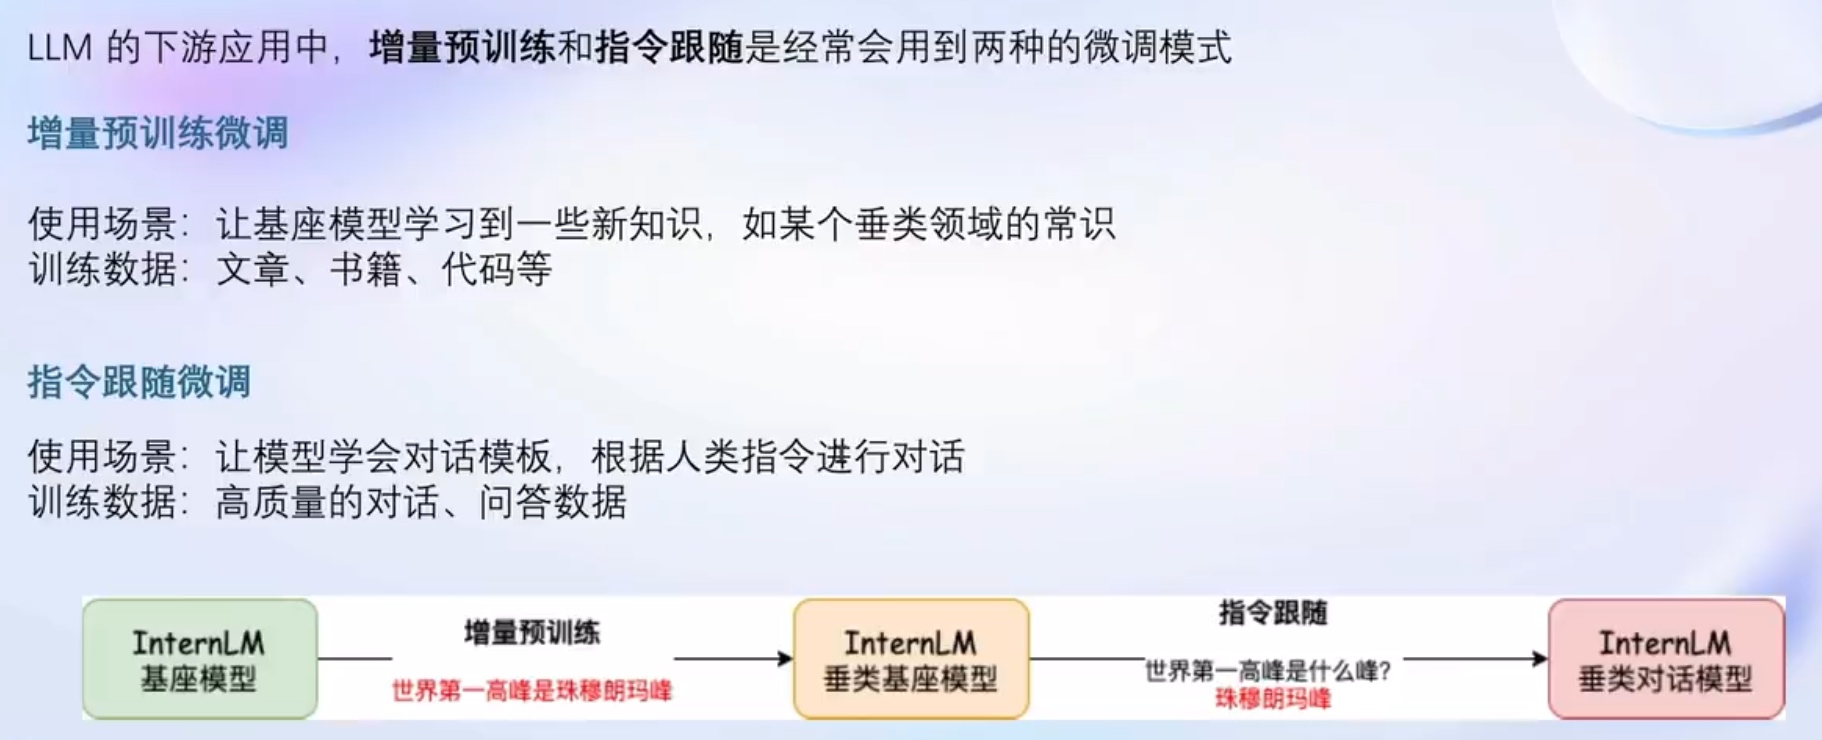
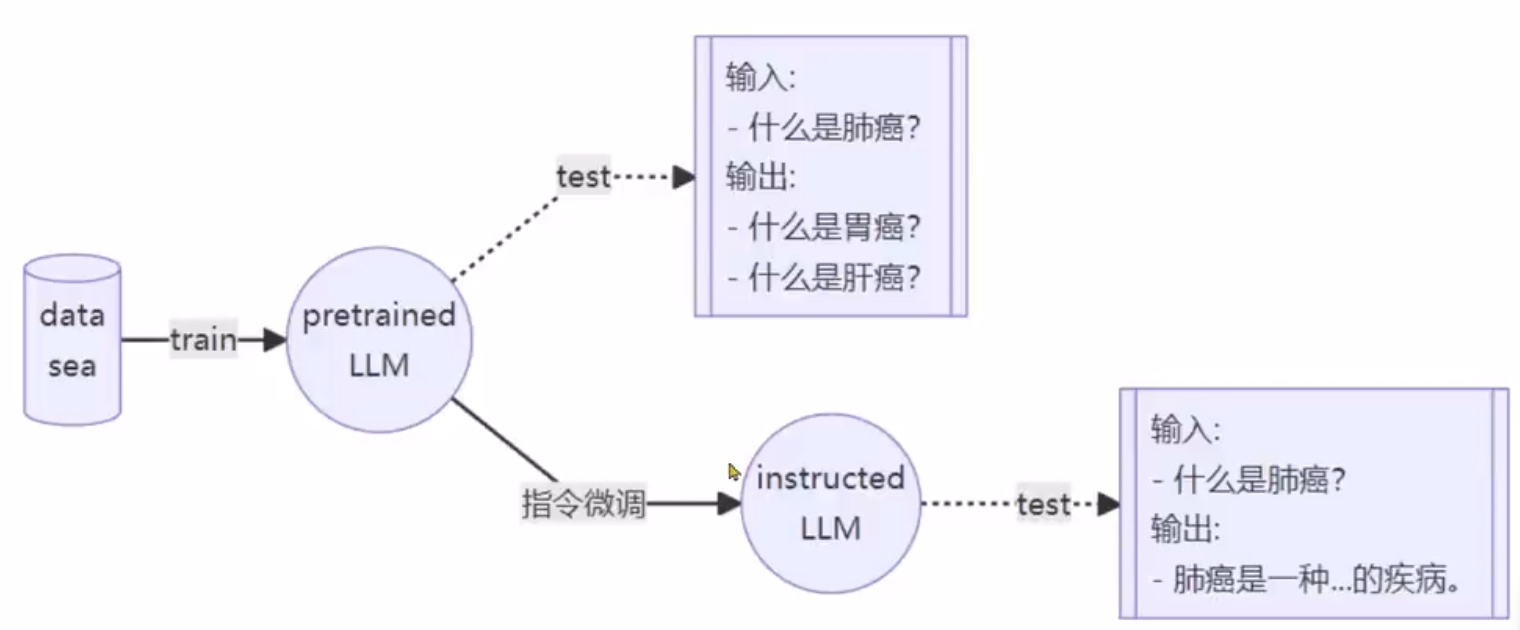
指令跟随微调
一问一答的对话训练
角色指定
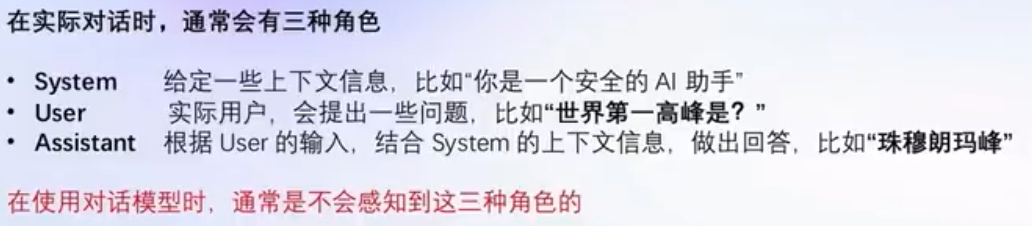
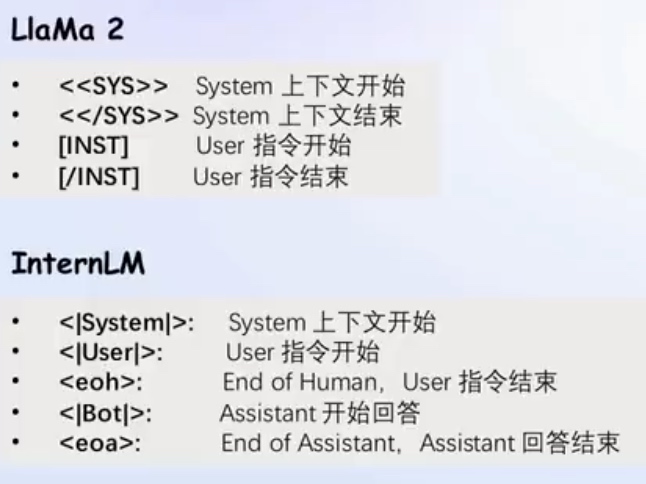
对话模板(仅在微调阶段):
为了能让LLM区分出, system, User和Assistant 不同的模型会有不同的模板
对话模板构建
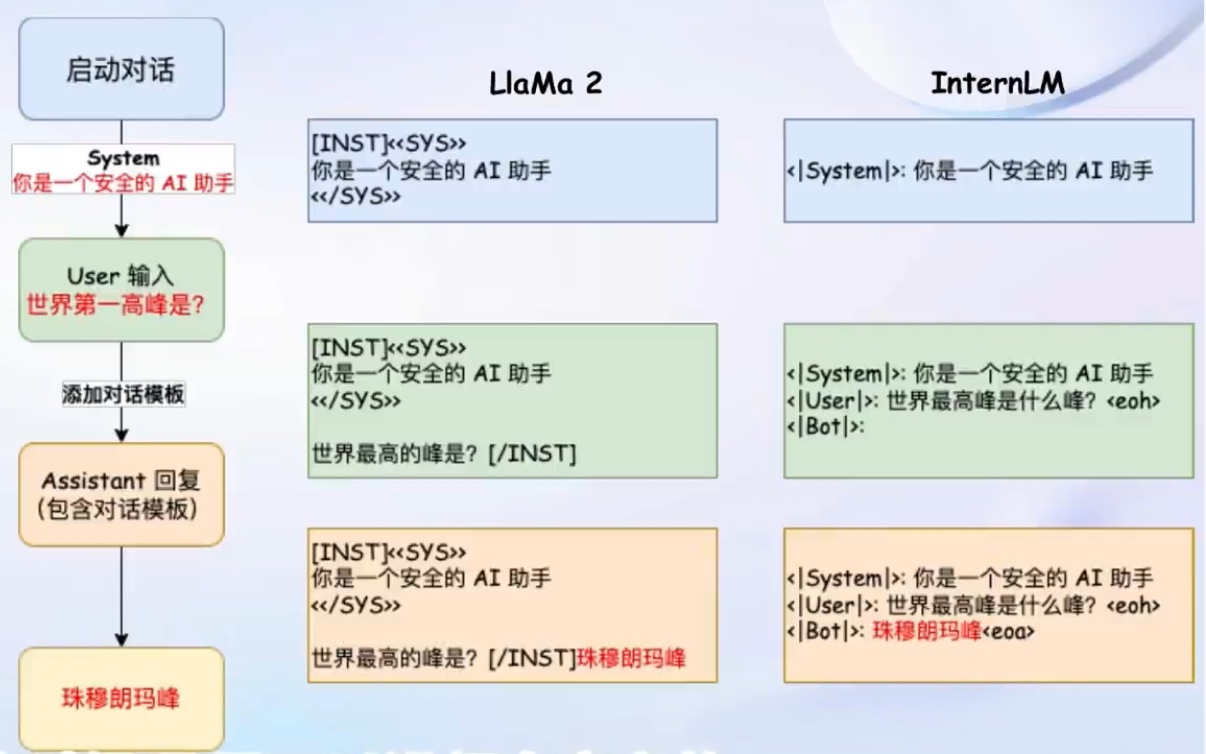
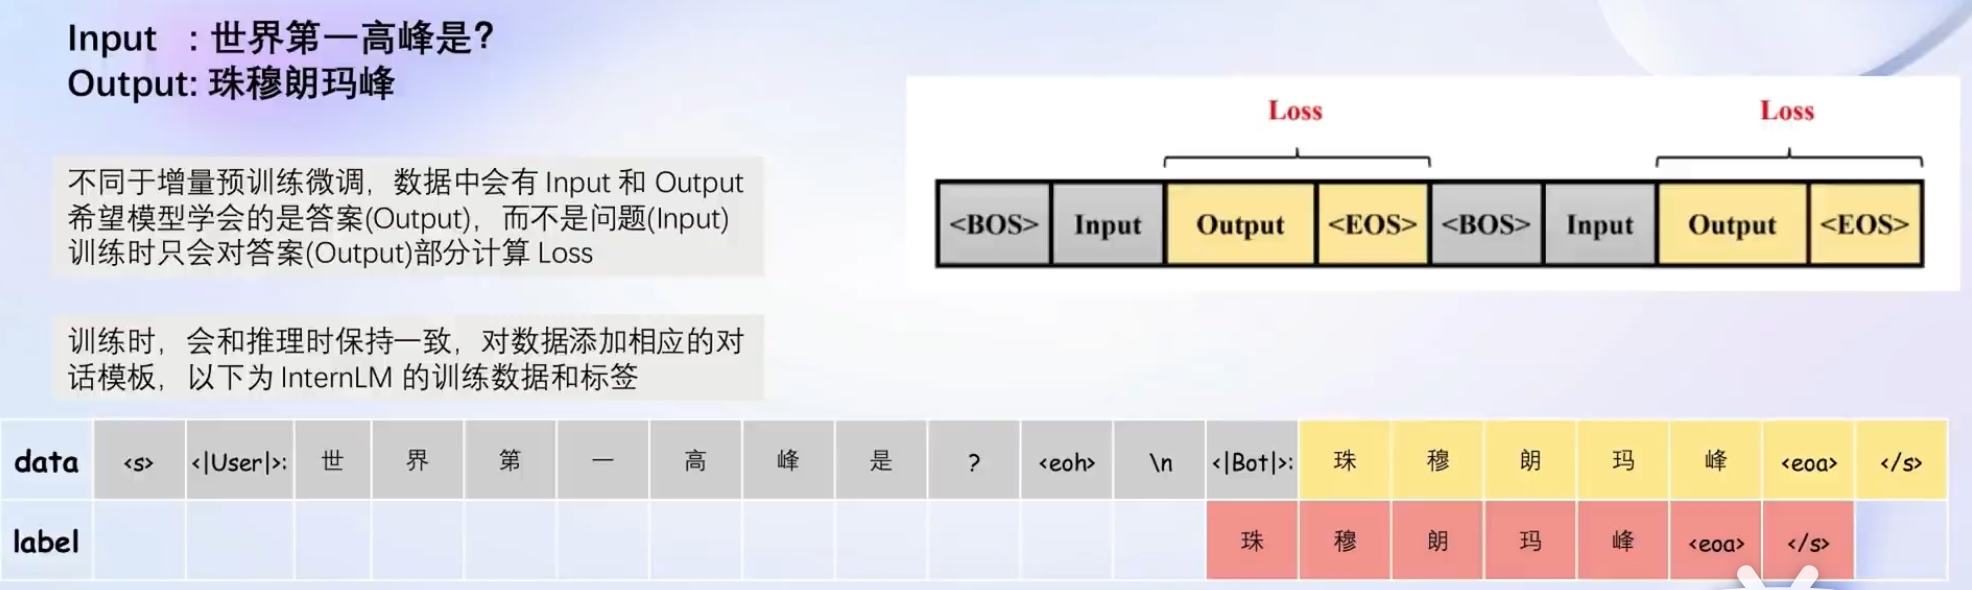
微调时只对答案部分计算损失
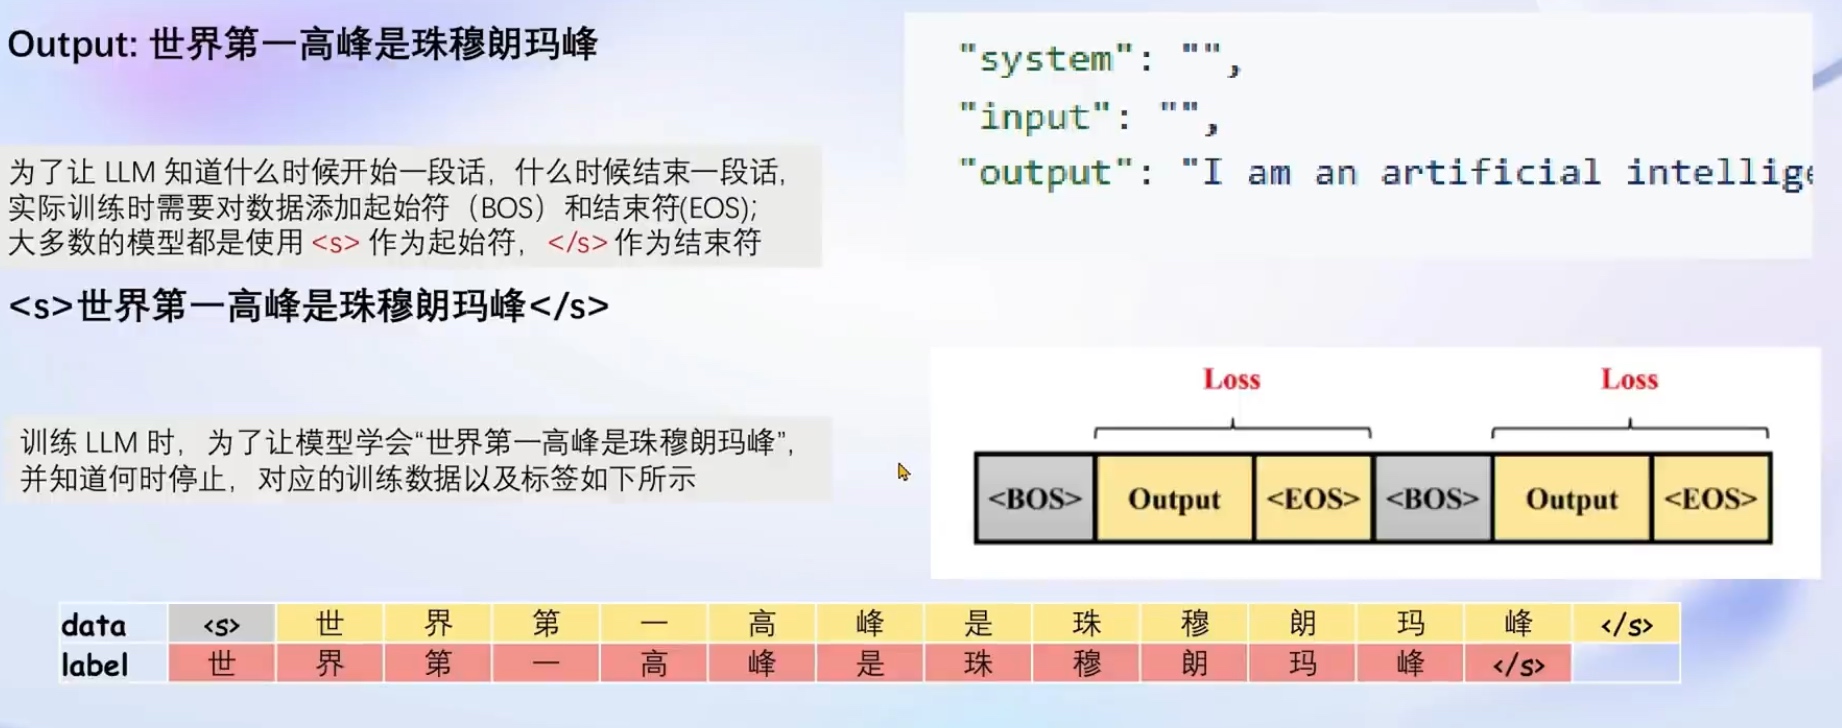
增量预训练微调
不需要问答 陈述式
角色 system input 留空,仍然计算assistant部分的损失
LoRA & QLoRA
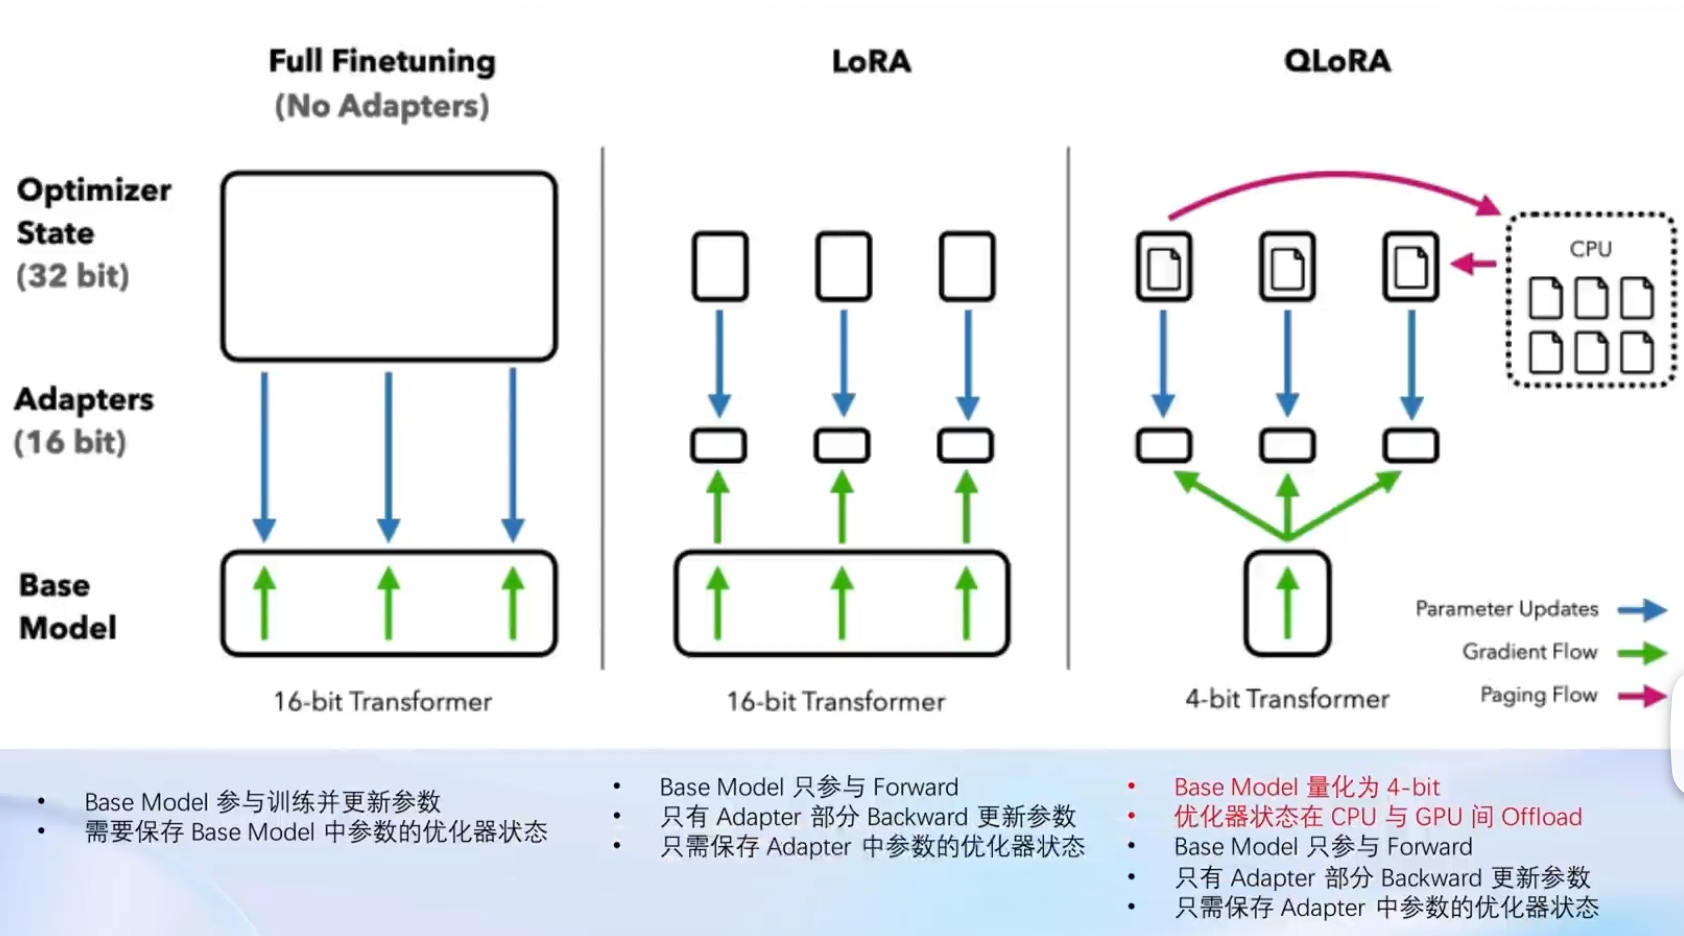
LoRA: low-rank adaptation of large language models
在stable diffusion中为了画出心仪的风格/角色, 往往会在一个公开的底模上, 再套一个LoRA模型, 换一个LoRA, 就相当于换一个初始的风格或者初始的人物, 底座模型不用换
LLM的参数量主要集中在模型中的Linear, 训练这些参数需要很大的显存, LoRA模型就不用那么大的显存开销了
LoRA 通过在原本的 Linear 旁, 新增一个支路, 包含两个连续的小 Linear, 新增的这个支路通常叫做 Adapter(Adapter文件就是常说的LoRA模型文件)
Adapter 参数量远小于原本的 Linear, 能大幅降低训练的显存消耗
XTuner
介绍
一个大语言模型微调工具箱。由 MMRazor 和 MMDeploy 联合开发
傻瓜化: 以配置文件的形式封装了大部分微调场景
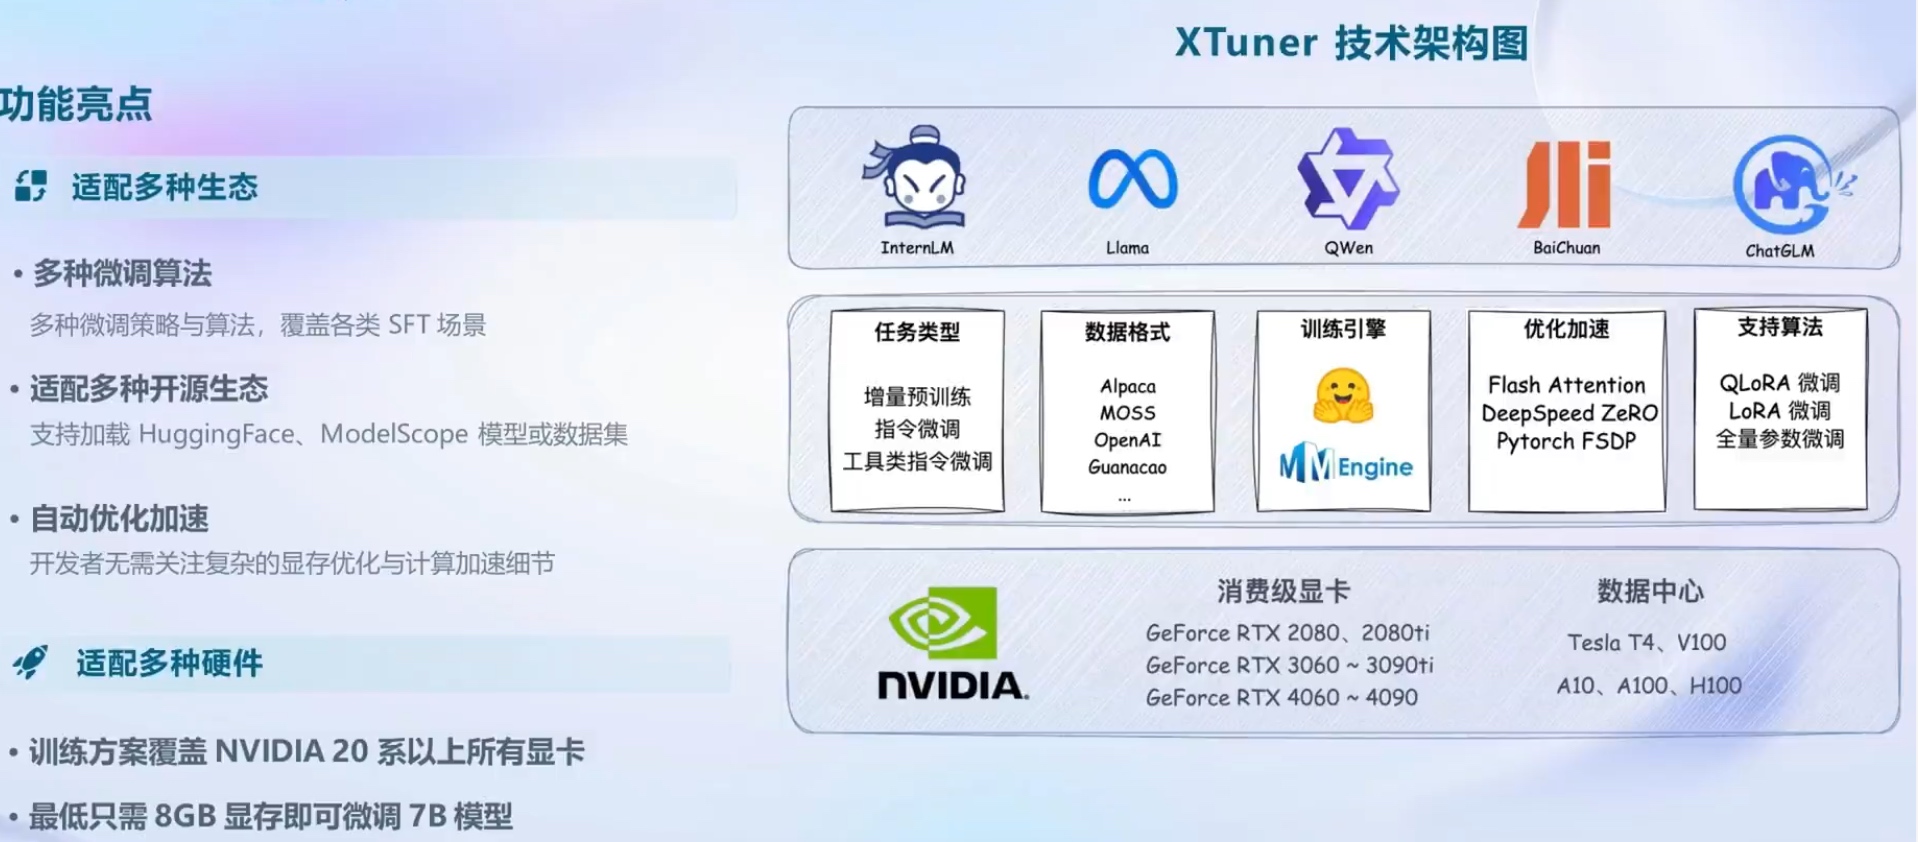
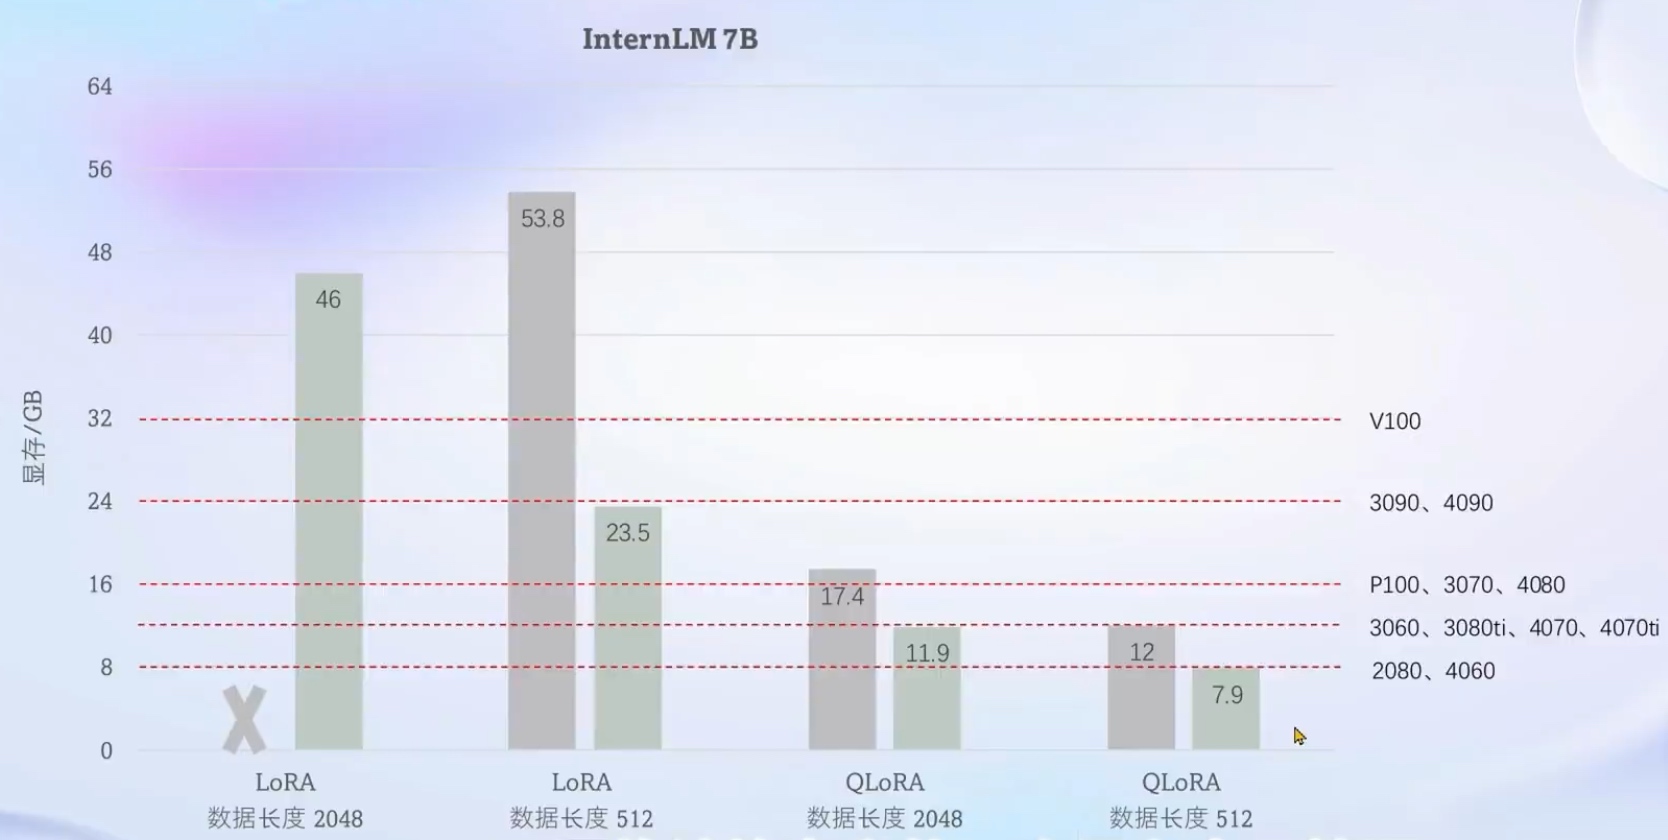
轻量级: 对于 7B 参数量的LLM, 微调所需的最小显存仅为 8GB
支持的开源LLM
- InternLM ✅
- Llama,Llama2
- ChatGLM2,ChatGLM3
- Qwen
- Baichuan,Baichuan2
- ChatGLM
- Zephyr
- ......
还支持工具类模型的对话
强大的数据处理引擎, 很方便的在更多开源的流行数据集上进行一键启动, 使开发者专注于数据内容
数据集映射函数
对话模板映射函数
多数据样本拼接, 充分利用gpu资源
自定义数据集 建议使用json格式
8GB 显存玩转 LLM
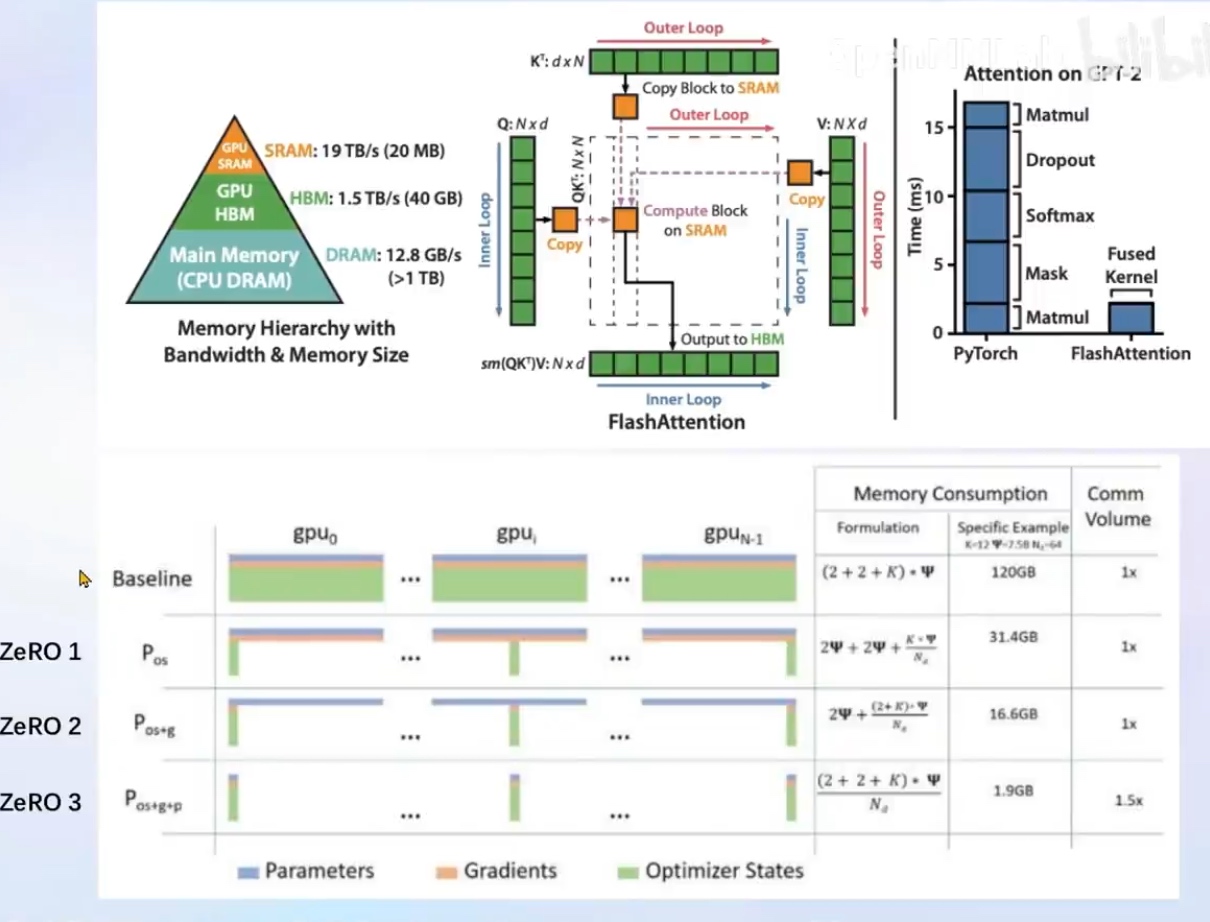
Flash Attention 和 DeepSpeed ZeRO 是 XTuner 最重要的两个优化技巧
- Flash Attention: 将Attention计算并行化, 避免了计算过程中 Attention Score NxN 的显存占用(训练过程N都比较大)
- DeepSpeed ZeRO: ZeRO 优化, 通过将训练过程中的参数, 梯度和优化器状态切片保存, 能够在多 GPU 训练时显著节省显存; 除了将训练中间状态切片外, DeepSpeed 训练时使用 FP16 的权重, 相较于 Pytorch 的 AMP 训练, 在单 GPU上也能大幅节省显存(并非默认启动, 需增加参数 QLoRA算法后面跟 deepspeed_zero2)
优化前后, 不同的计算卡上的一个显存占用情况
动手实战
Ubuntu + Anaconda + CUDA/CUDNN + 8GB nvidia显卡
环境配置
git clone -b v0.1.9 https://github.com/InternLM/xtuner
从源码安装 XTunerpip install -e '.[all]'
微调
XTuner 提供多个开箱即用的配置文件 xtuner list-cfg
拷贝一个配置文件到当前目录: xtuner copy-cfg ${CONFIG_NAME} ${SAVE_PATH}
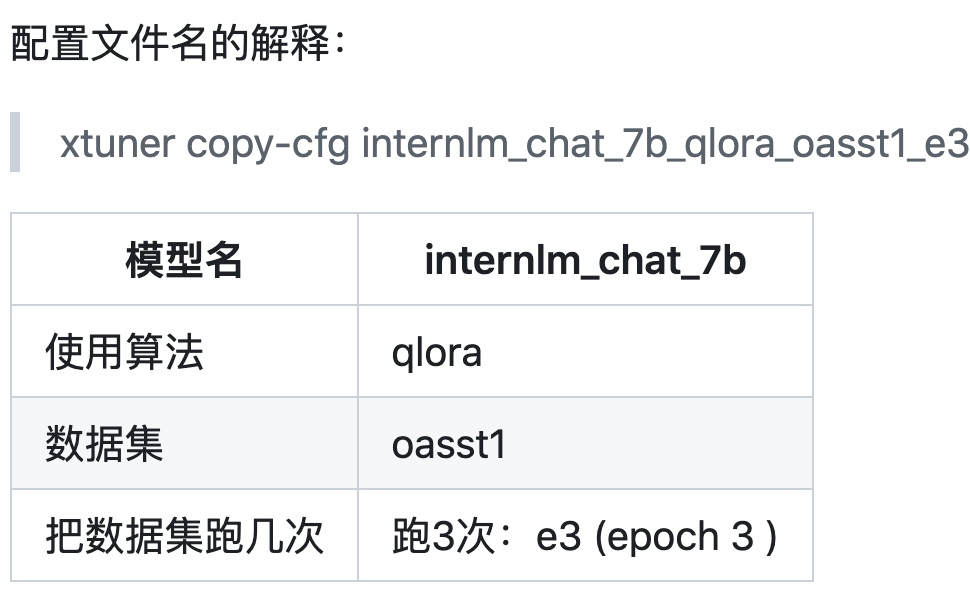
*无 chat比如 internlm-7b 代表是基座(base)模型
model文件夹
数据文件夹
修改配置文件'
开始微调
训练:xtuner train ${CONFIG_NAME_OR_PATH}
也可以增加 deepspeed 进行训练加速:
# 单卡
## 用刚才改好的config文件训练
xtuner train ./internlm_chat_7b_qlora_oasst1_e3_copy.py

# 多卡
NPROC_PER_NODE=${GPU_NUM} xtuner train ./internlm_chat_7b_qlora_oasst1_e3_copy.py

# 若要开启 deepspeed 加速,增加 --deepspeed deepspeed_zero2 即可
将得到的 PTH 模型转换为 HuggingFace 模型,即:生成 Adapter 文件夹, hf 文件夹即为我们平时所理解的所谓 “LoRA 模型文件”
export MKL_SERVICE_FORCE_INTEL=1

xtuner convert pth_to_hf ./internlm_chat_7b_qlora_oasst1_e3_copy.py ./work_dirs/internlm_chat_7b_qlora_oasst1_e3_copy/epoch_1.pth ${SAVE_PATH}
流程准备
- 训练数据
- 模型文件
- 配置文件 下载 xtuner copy-cfg
- 修改配置文件
- 微调
xtuner train internlm_chat_7b_qlora_medqa2019_e3.py --deepspeed deepspeed_zero2
部署与测试
将 HuggingFace adapter 合并到大语言模型:xtuner convert merge ./internlm-chat-7b ./hf ./merged --max-shard-size 2GB
与合并后的模型对话:
xtuner chat --help
# 加载 Adapter 模型对话(Float 16)
xtuner chat ./merged --prompt-template internlm_chat
# 原模型
xtuner chat ./internlm-chat-7b --prompt-template internlm_chat

# 4 bit 量化加载
# xtuner chat ./merged --bits 4 --prompt-template internlm_chat

--prompt-template default,zephyr,internlm_chat,moss_s
ft,llama2_chat,code_llama_chat,chatglm2,chatglm3,qwen_ch
at,baichuan_chat,baichuan2_chat,wizardlm
自定义微调
基于 InternLM-chat-7B 模型,用 MedQA 数据集进行微调,将其往医学问答领域对齐
数据准备, 将数据转为 XTuner 的数据格式
目标格式:(.jsonL)
[{
    "conversation":[
        {
            "system": "xxx",
            "input": "xxx",
            "output": "xxx"
        }
    ]
},
{
    "conversation":[
        {
            "system": "xxx",
            "input": "xxx",
            "output": "xxx"
        }
    ]
}]
开始自定义微调xtuner train internlm_chat_7b_qlora_medqa2019_e3.py --deepspeed deepspeed_zero2
用 MS-Agent 数据集赋予 LLM 以 Agent 能力
MS-Agent
教会LLM模型调用 API接口以获取实时信息
MSAgent 数据集每条样本包含一个对话列表(conversations),其里面包含了 system、user、assistant 三种字段。其中:
- system: 表示给模型前置的人设输入,其中有告诉模型如何调用插件以及生成请求
- user: 表示用户的输入 prompt,分为两种,通用生成的prompt和调用插件需求的 prompt
- assistant: 为模型的回复。其中会包括插件调用代码和执行代码,调用代码是要 LLM 生成的,而执行代码是调用服务来生成结果的
插件本质就是python脚本, 调用 API 接口
xtuner 是从国内的 ModelScope 平台下载 MS-Agent 数据集,因此不用提前手动下载数据集文件。
xtuner list-cfg | grep msagent
xtuner copy-cfg internlm_7b_qlora_msagent_react_e3_gpu8 .

xtuner train ./internlm_7b_qlora_msagent_react_e3_gpu8_copy.py --deepspeed deepspeed_zero2
添加 serper 环境变量
serper给LLM提供请求服务, LLM调用 serper提供的API接口以获取搜索得到的结果
去 serper.dev 免费注册一个账号,生成自己的 api key。这个东西是用来给 lagent 去获取 google 搜索的结果的。等于是 serper.dev 帮你去访问 google,而不是从你自己本地去访问 google 了。export SERPER_API_KEY=abcdefg
xtuner + agent,启动!
未 merge 情况(添加adapter, adapter后面跟上LoRA文件路径)xtuner chat ./internlm-chat-7b --adapter internlm-7b-qlora-msagent-react --lagent --prompt-template internlm_chat
也可merge模型
--lagent 增加web api启动参数
相关推荐
XTuner大模型微调实战[代码]
本文详细介绍了XTuner在大模型微调中的应用,包括Finetune的两种模式(增量预训练和指令微调)及其工作流程,XTuner的基本功能和优化技巧(如LoRA和QLoRA),以及如何在8GB显卡上高效微调大模型。文章还提供了动手实战环节,指导读者如何微调属于自己的大模型,包括数据集准备、配置文件修改、模型训练和测试验证。通过本文,读者可以掌握单卡低成本微调大模型的核心技巧,适用于中小型应用场景。
Xtuner大模型训练入门[项目代码]
本文介绍了Xtuner这一专注于大模型微调的开源工具包,其主打轻量、简单、高效的特点,能够帮助用户快速上手大模型训练。文章详细讲解了从数据准备、模型选择到实际训练的全过程,包括如何配置环境、安装Xtuner、修改配置文件以及执行训练命令。此外,还介绍了模型转换和合并的步骤,帮助用户将训练后的模型转换为可用的格式。Xtuner支持多种主流大模型,如LLaMA、ChatGLM等,并提供了丰富的工具和优化策略,使得即使是不熟悉高阶技术的开发者也能轻松定制自己的大模型。
基于xtuner微调心理健康数据集实现专业心理问答与交互式Demo的智能心理支持系统_心理健康数据微调心理问题专业问答xtuner技术应用智能对话模型心理咨询辅助情绪支持.zip
基于xtuner微调心理健康数据集实现专业心理问答与交互式Demo的智能心理支持系统_心理健康数据微调心理问题专业问答xtuner技术应用智能对话模型心理咨询辅助情绪支持.zip
基于internlm-chat-7b的保险知识大模型微调.zip
个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸!
人工智能-大模型-基于internlm-chat-7b的保险知识大模型微调
基于internlm-chat-7b的保险知识大模型微调 保险知识问答助手数据集采用中的ChineseNlpCorpus提供的包括用户提问、网友回答、最佳回答,共计 588000 余条,数据集样例: "input": "最近在安邦长青树中看到什么豁免,这个是什么意思?" "output": "您好,这个是重疾险中给予投保者的一项权利,安*长青树保障责任规定,投保者可以享受多次赔付,豁免等权益。也就是说不同轻症累计5次赔付,理赔1次轻症豁免后期所交保费,人性化的设计,无需加保费。" "input": "和团队去北极探险,有没有针对这方面的HUTS保险呢"




