 OpenMMLab

书生浦语LMDeploy量化部署(五)
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
LMDeploy 的量化和部署
大模型部署背景
定义
- 将训练好的模型在特定软硬件环境中启动的过程, 使模型能接受输入并返回预测结果
- 为了满足性能和效率的需求, 常常需要对模型进行优化, 例如模型压缩和硬件加速
产品形态
- 远端, 边缘计算端, 移动端
计算设备:
- CPU GPU NPU TPU等
大模型特点
内存开销巨大:
- 庞大的参数量 7B模型仅权重就需要 14+G 内存(FP16 2个字节)
- 采用自回归生成 token, 需要缓存 attention 的k/v 带来巨大的内存开销
动态shape
- 请求数不固定 batch
- token 逐个生成, 且数量不定
相对视觉模型, LLM结构简单
- Transformers结构, 大部分是decoder-only
- 生成过程就是采样过程
大模型部署挑战
设备:
- 如何应对巨大的存储问题, 低存储设备(消费级显卡, 手机等)如何部署
推理(这里是指模型的执行过程, 非服务过程):
- 如何加速 token的生成速度
- 如何解决动态shape, 让推理可以不间断
- 如何有效管理和利用内存
服务:
- 如何提升系统整体吞吐量
- 对于个体用户, 如何降低响应时间 平均响应时长
部署方案
技术点:
- 模型并行
- 低比特量化
- Page Attention
- transformer计算和访存优化
- Continuous Batch
方案:
- huggingface transformers
- 专门的推理加速框架
云端:
- Imdeploy
- vllm
- tensorrt-llm
- deepspeed
移动端:
- llama.cpp 针对很多移动端的设备芯片架构做的优化
- mlc-llm
LMDeploy简介
是LLM在NVIDIA 设备商不熟的全流程解决方案
包括模型轻量化, 推理(核心是turbomind c++)和服务
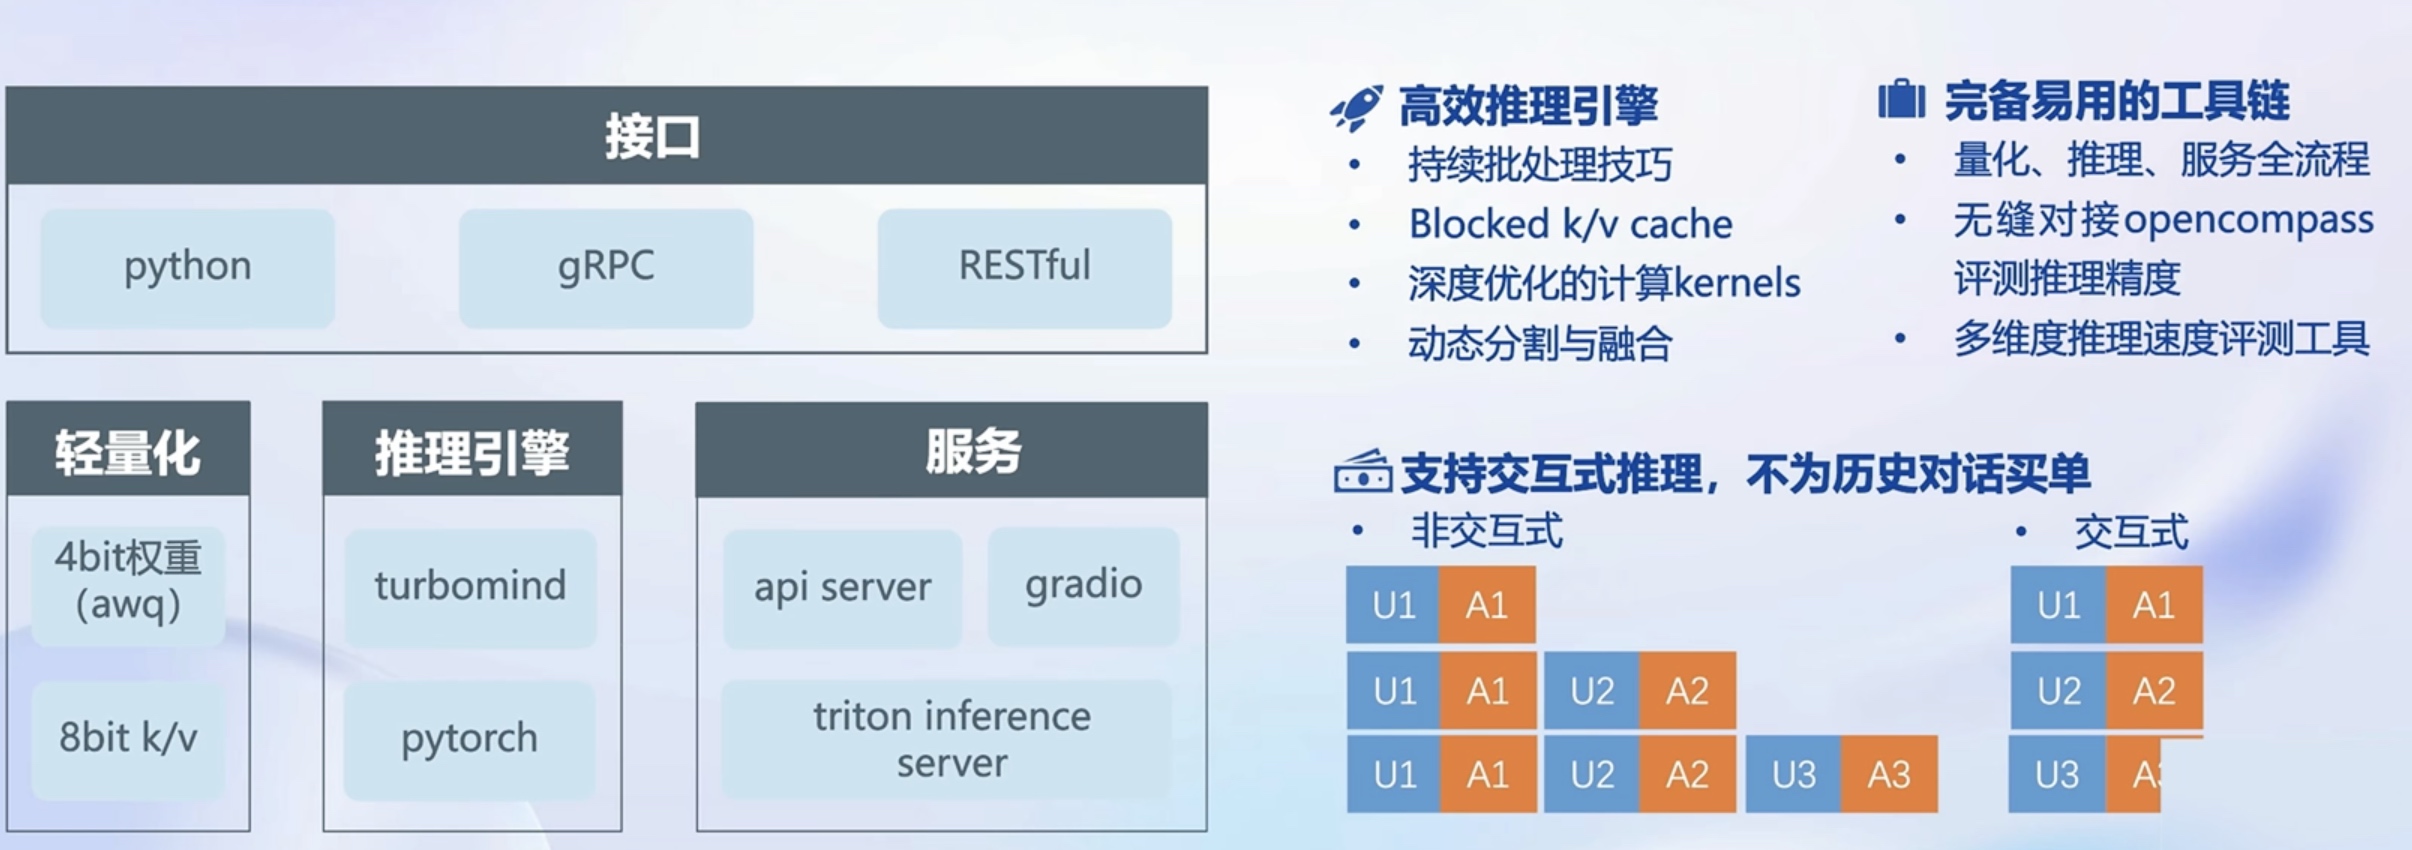
性能提升
- 静态推理性能: 固定batch, 输入输出token数量
- 动态推理性能: 真实对话, 不定长的输入/输出
核心功能- 量化
显存降下来
能容纳更多的长度, 并发
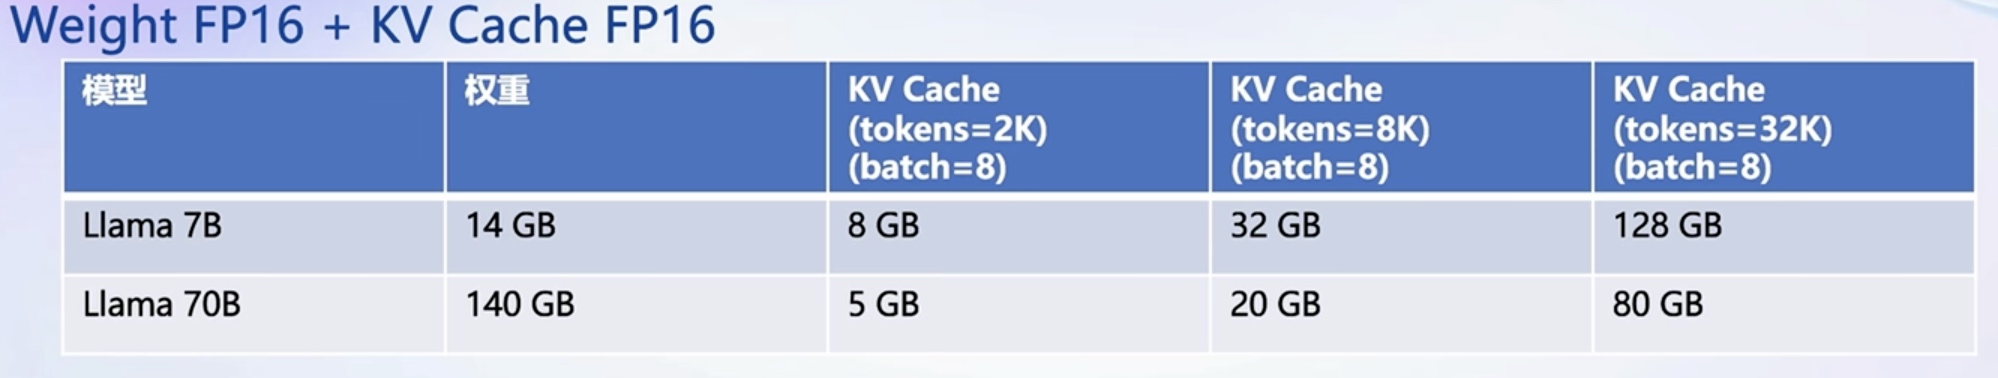
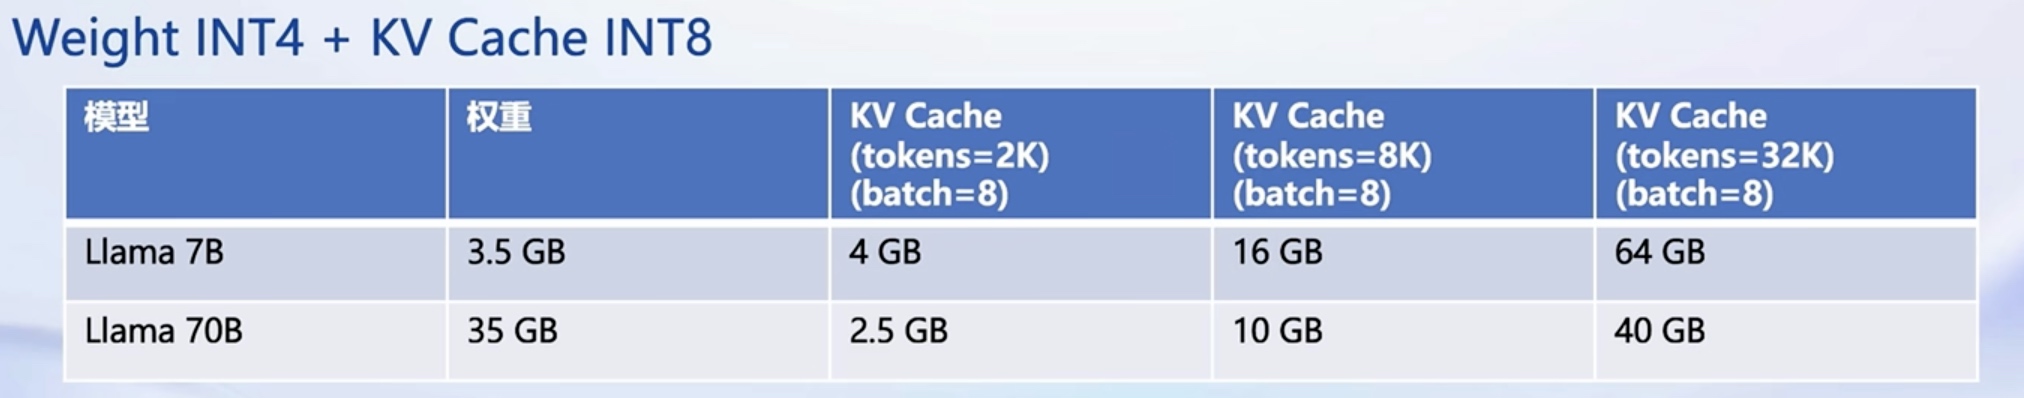
24GB显存
量化前, 7B模型 并发8, max length=2k
量化后, 7B模型 并发8, max length=8k
80GB显存
量化前, 70B模型 oom
量化后, 7B模型 并发8, max length=32k
weight only量化
- 降低显存占用
- 提高推理速度
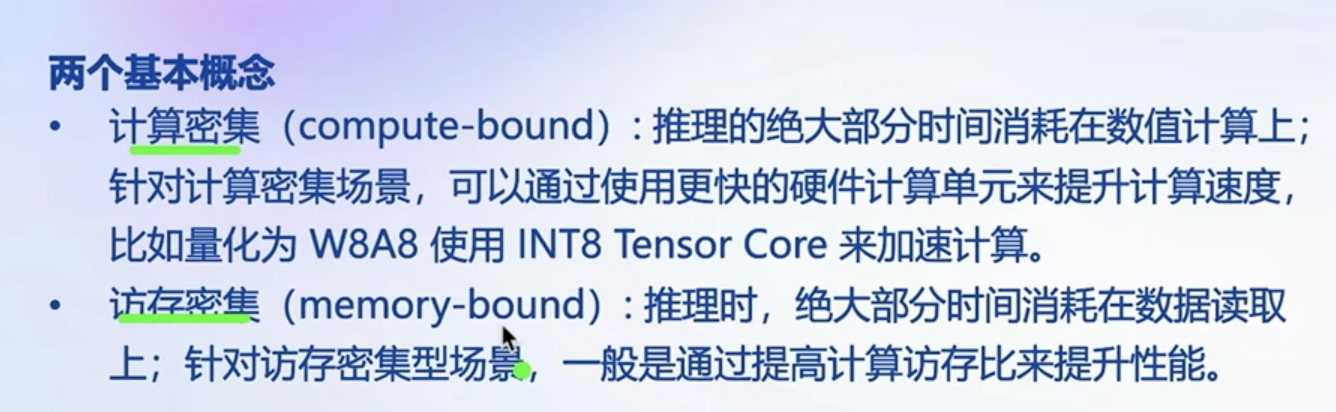
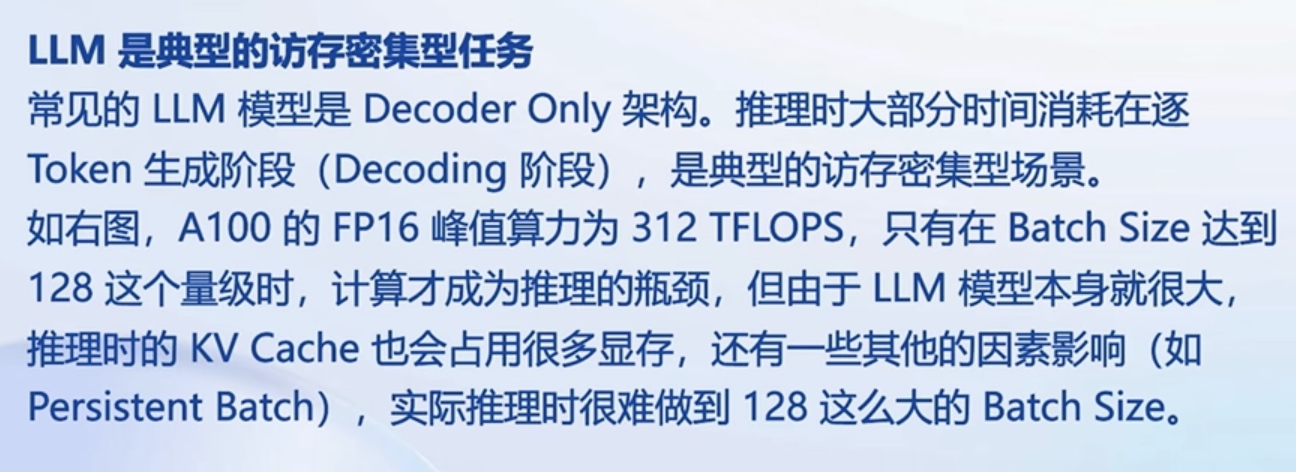
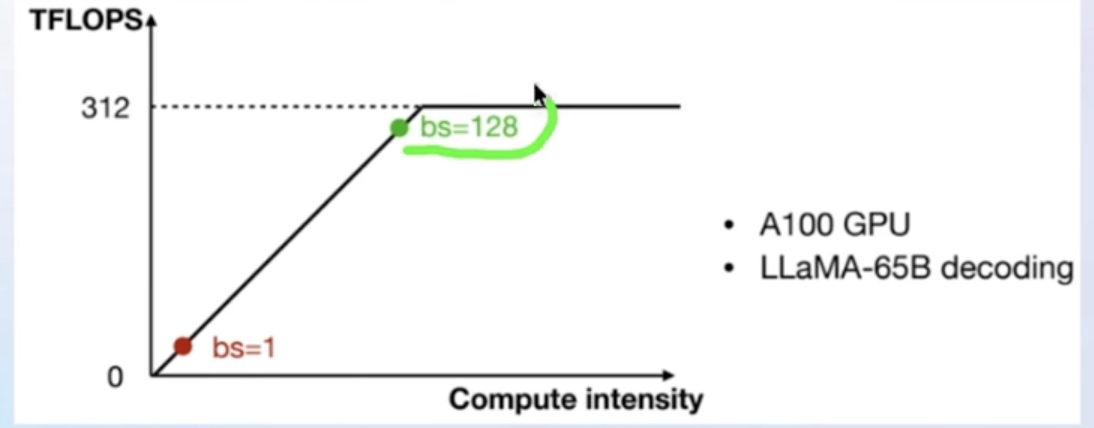
LLM主要是 访存密集型
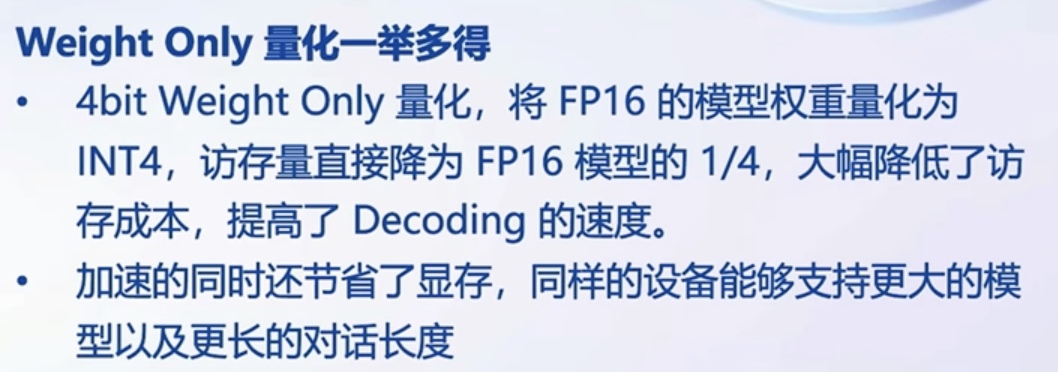
先量化成 4bit存起来, 计算时再反量化回FP16
如何weight only量化
- LMDeploy 使用 MIT HAN LAB 开源的 AWQ 算法, 量化为 4bit模型
- 推理时, 先把 4 bit权重, 反量化回 FP16 (在 Kernel 内部进行, 从Global Memory 读取时仍是 4bit), 依旧使用的是 FP16计算
- AWQ观察到在推理时, 矩阵(张量)计算,只有一小部分参数很重要, 其他可进行量化
- 相较于GPTQ算法, AWQ推理速度更快, 量化的时间更短
推理引擎 turbomind
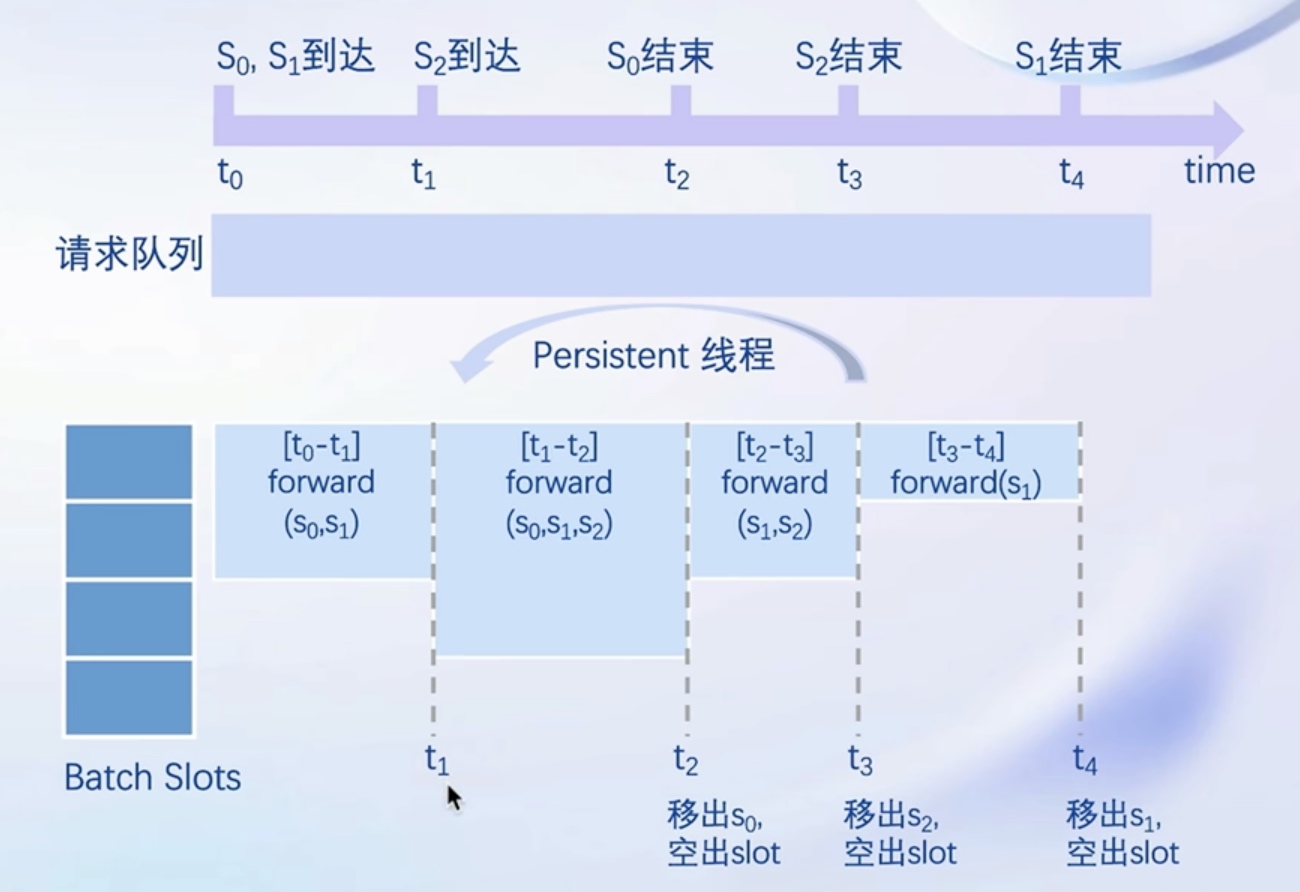
- 持续批处理 (请求可以及时加入 batch 中推理, batch中已经完成推理请求及时退出)
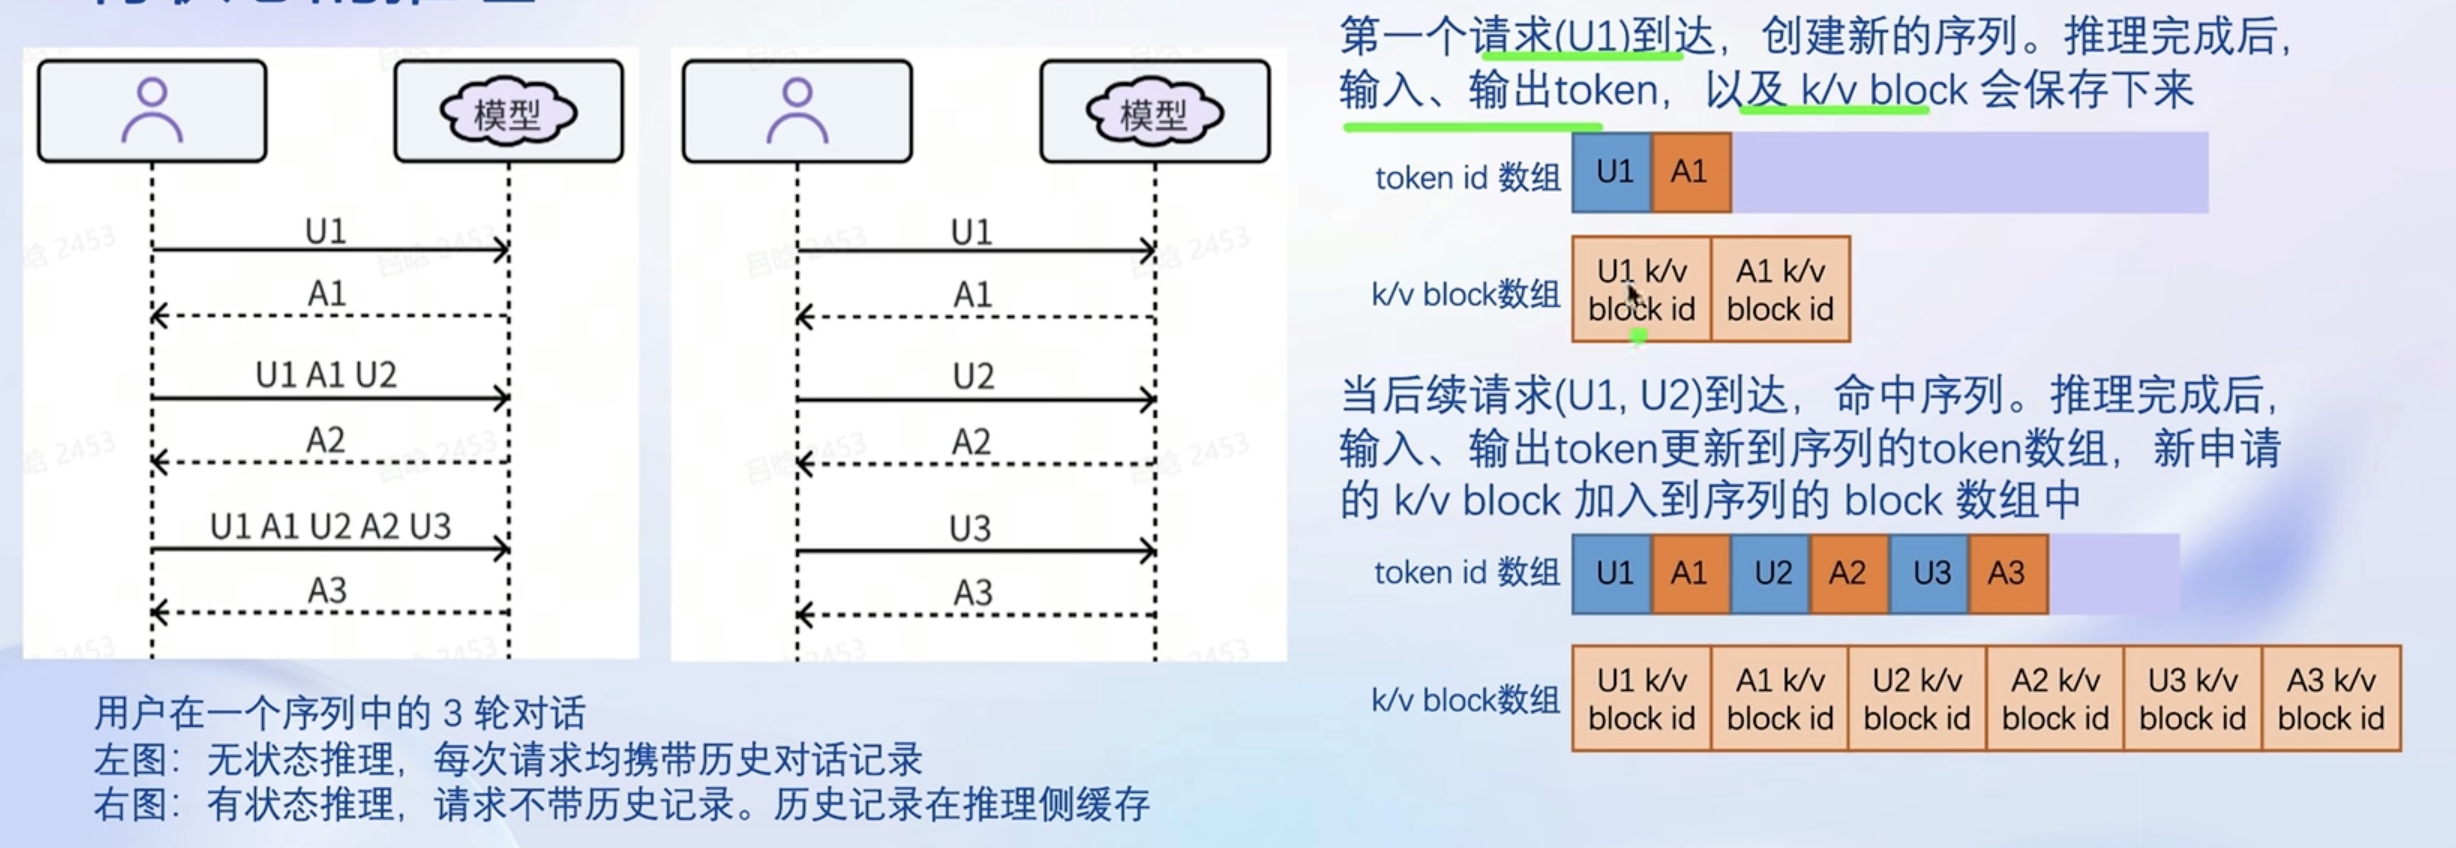
- 有状态的推理 (对话 token 被缓存在推理侧 用户侧请求无需带上历史对话记录)
- Blocked k/v cache 分块存储 Attention支持不连续的 k/v block(paged Attention)
- 高性能 cuda kernel 深入优化里面的计算算子(Flash Attention2; Split-K decoding; 高效的 w4a16,kv8 反量化 kernel)
持续批处理
LLM 推理时主流的策略(Decoder 模型)
- 请求队列
- 推理请求首先先加入到请求队列中
- Persistent 线程
- 若 Batch中有空闲槽位, 从队列拉取请求, 尽量填满空闲槽位. 若无, 继续对当前 Batch 中的请求进行 forward
- batch 每 forward 完一次
- 判断是否有 request 推理结束. 结束的 request, 发送结果, 释放槽位
- 转步骤 1
有状态的推理
server端(推理端)一直保存着上下文
Blocked k/v cache
支持 Paged Attention, 支撑有状态推理
K part V part 需要缓存起来, 整个过程是要用的
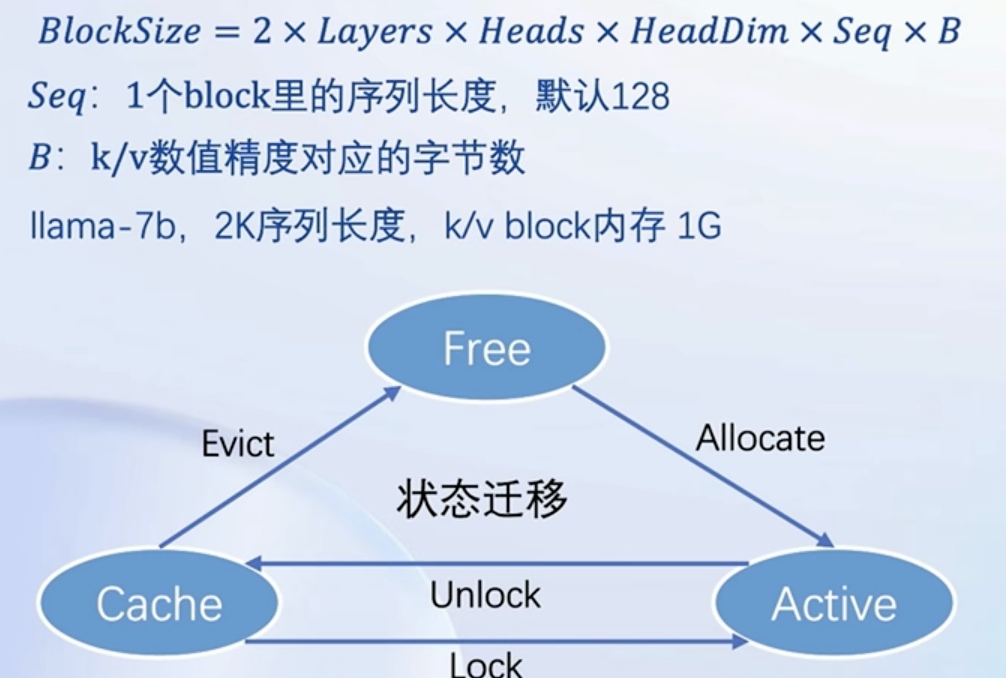
Block状态:
- Free 未被任何序列占用
- Active 被正在推理的序列占用
- Cache 被缓存中的序列占用
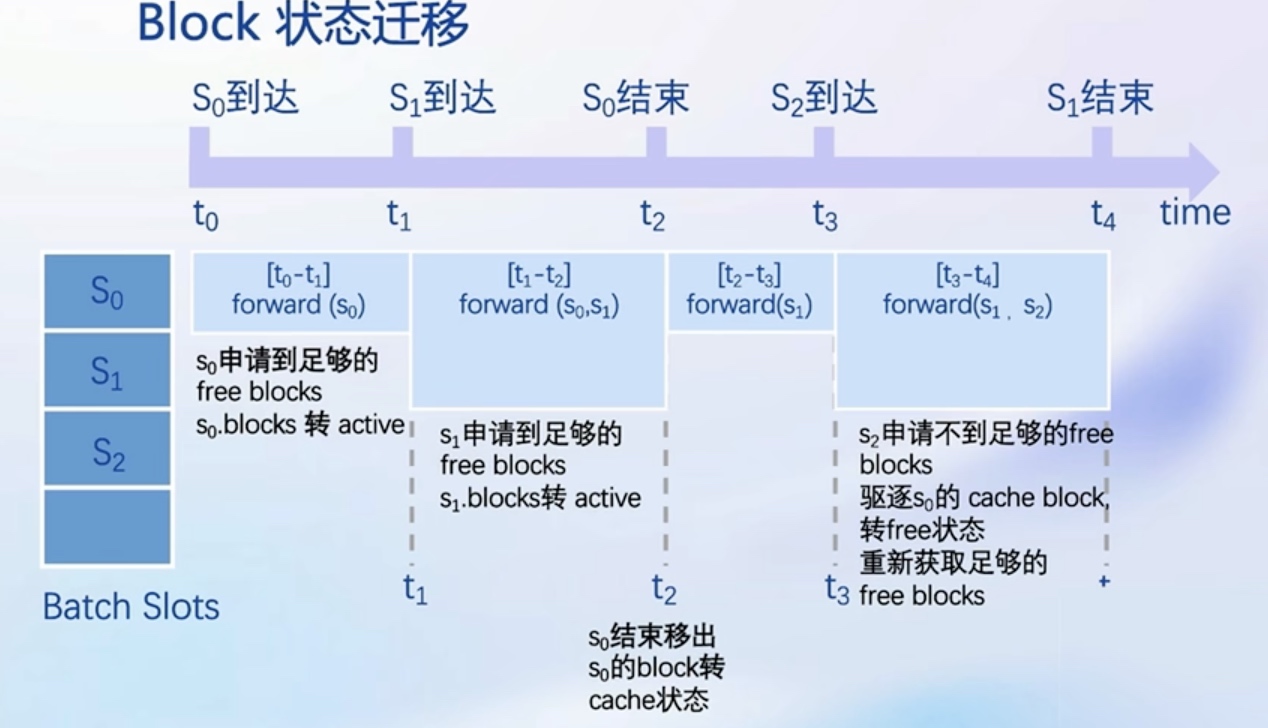
高性能 cuda kernel
深入优化里面的计算算子(Flash Attention2; Split-K decoding; 高效的 w4a16,kv8 反量化 kernel)
针对解码 生成加速
推理服务 api server
models completions interaction

动手实践
安装, 部署, 量化
环境配置
服务部署
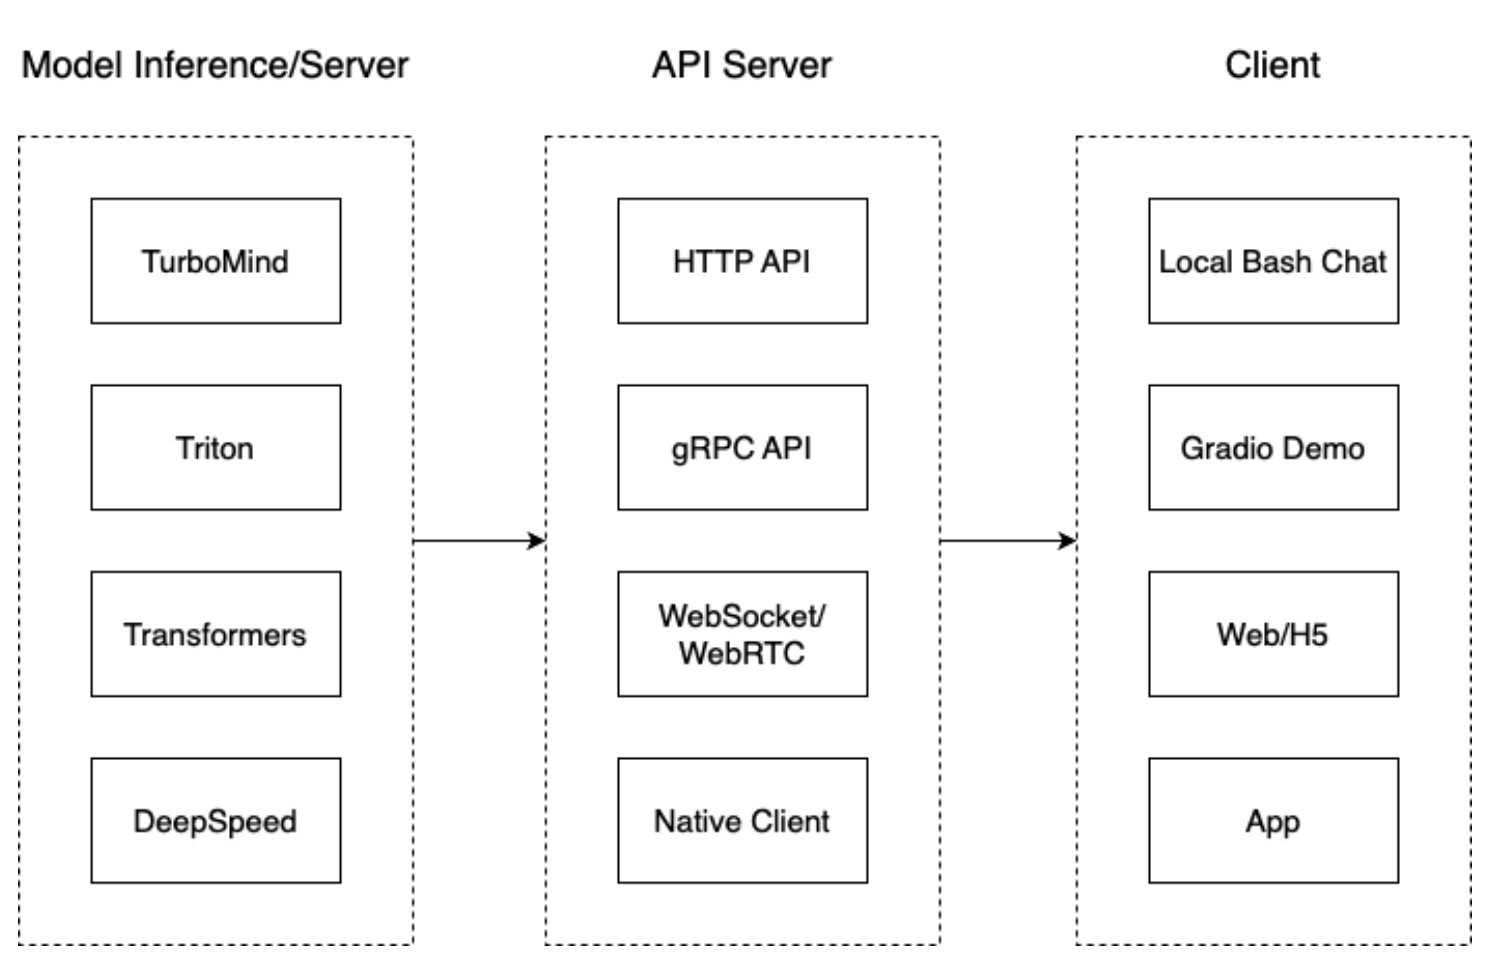
我们把从架构上把整个服务流程分成下面几个模块。
- 模型推理/服务。主要提供模型本身的推理,一般来说可以和具体业务解耦,专注模型推理本身性能的优化。可以以模块、API等多种方式提供。
- Client。可以理解为前端,与用户交互的地方。
- API Server。一般作为前端的后端,提供与产品和服务相关的数据和功能支持。
模型转换
使用 TurboMind 推理模型需要先将模型转化为 TurboMind 的格式,目前支持在线转换和离线转换两种形式。在线转换可以直接加载 Huggingface 模型,离线转换需需要先保存模型再加载。
TurboMind 是一款关于 LLM 推理的高效推理引擎,基于英伟达的 FasterTransformer 研发而成。它的主要功能包括:LLaMa 结构模型的支持,persistent batch 推理模式和可扩展的 KV 缓存管理器
在线转换
lmdeploy 支持直接读取 Huggingface 模型权重,目前共支持三种类型:
- 在 huggingface.co 上面通过 lmdeploy 量化的模型,如 llama2-70b-4bit, internlm-chat-20b-4bit
- huggingface.co 上面其他 LM 模型,如 Qwen/Qwen-7B-Chat
以下命令都会启动一个本地对话界面,通过 Bash 可以与 LLM 进行对话
示例:
# 需要能访问 Huggingface 的网络环境
# 直接加载 Huggingface 的模型
# 1. 加载使用 lmdeploy 量化的版本
lmdeploy chat turbomind internlm/internlm-chat-20b-4bit --model-name internlm-chat-20b
# 2. 加载其他 LLM 模型
lmdeploy chat turbomind Qwen/Qwen-7B-Chat --model-name qwen-7b
也可以直接启动本地的 Huggingface 模型
lmdeploy chat turbomind /share/temp/model_repos/internlm-chat-7b/ --model-name internlm-chat-7b
离线转换
离线转换需要在启动服务之前,将模型转为 lmdeploy TurboMind 的格式,如下所示
# 转换模型(FastTransformer格式) TurboMind
lmdeploy convert internlm-chat-7b /path/to/internlm-chat-7b

# 这里我们使用官方提供的模型文件,就在用户根目录执行,如下所示
lmdeploy convert internlm-chat-7b  /root/share/temp/model_repos/internlm-chat-7b/
执行完成后将会在当前目录生成一个 workspace 的文件夹.
这里面包含的就是 TurboMind 和 Triton “模型推理”需要到的文件
重要的是weights文件
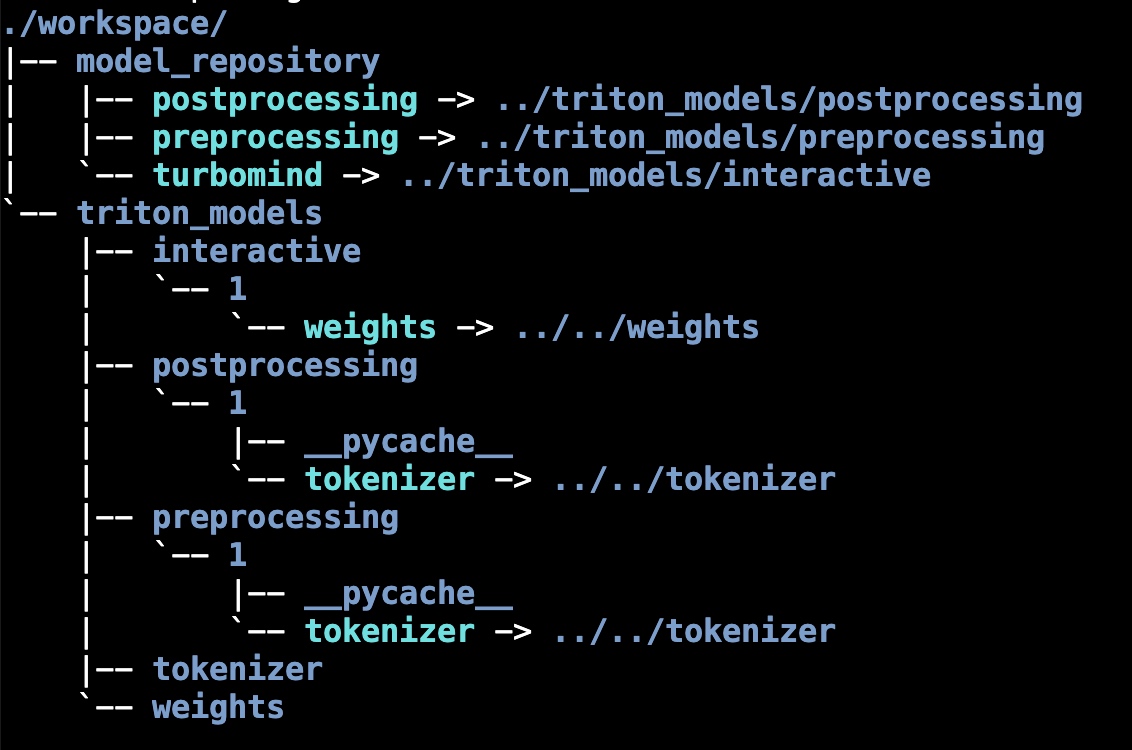
weights 和 tokenizer 目录分别放的是拆分后的参数和 Tokenizer.
如果我们进一步查看 weights 的目录,就会发现参数是按层和模块拆开的
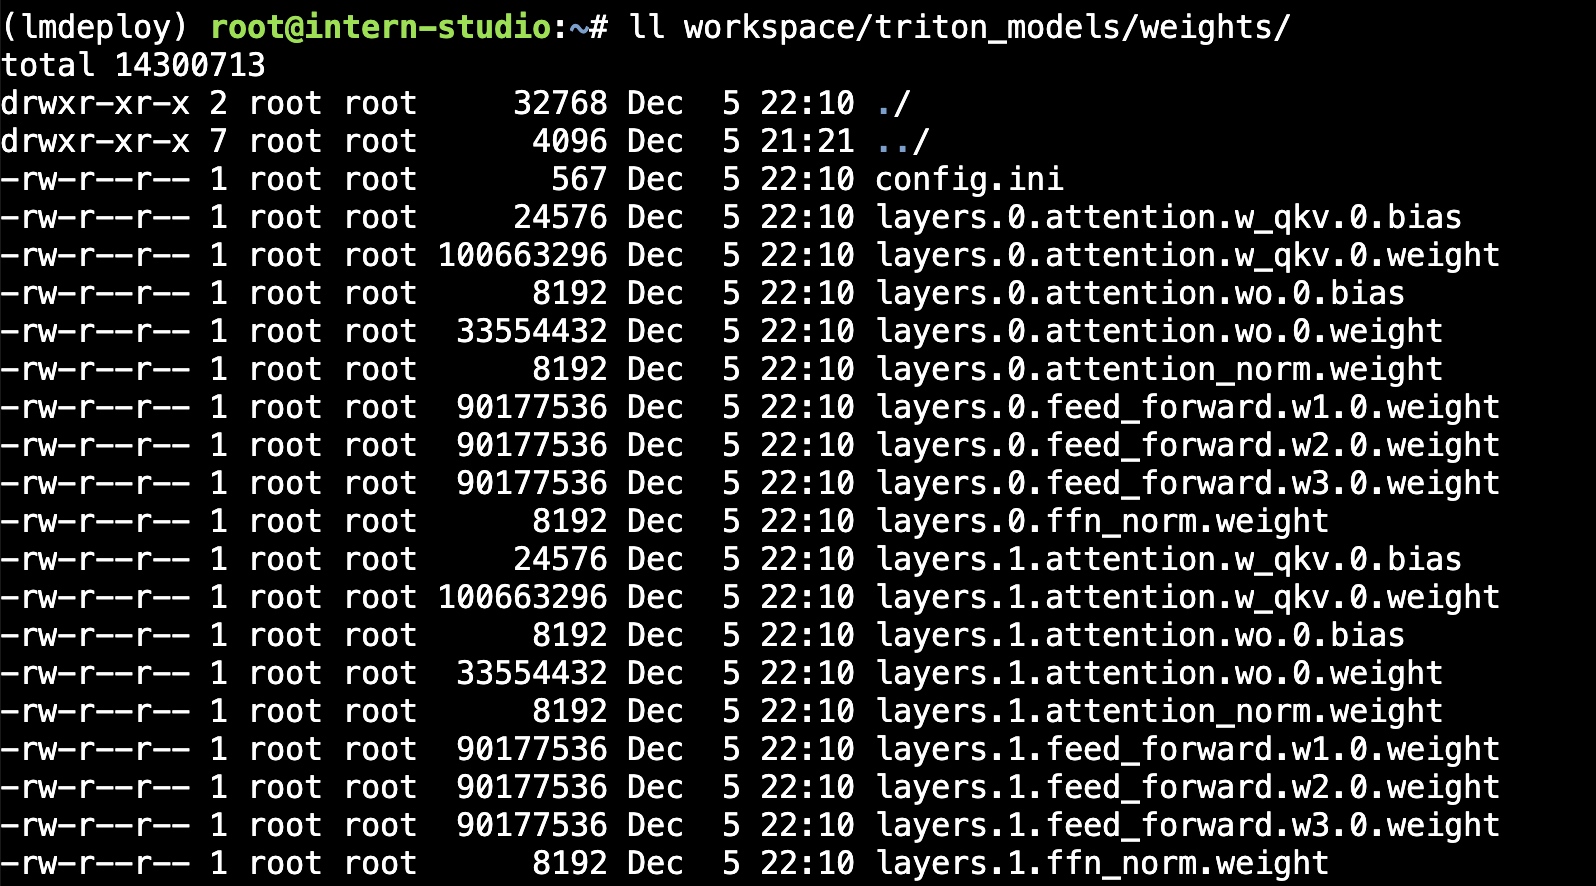
每一份参数第一个 0 表示“层”的索引,后面的那个0表示 Tensor 并行的索引,因为我们只有一张卡,所以被拆分成 1 份。如果有两张卡可以用来推理,则会生成0和1两份,也就是说,会把同一个参数拆成两份
layers.0.attention.w_qkv.0.weight 会变成 layers.0.attention.w_qkv.0.weight 和 layers.0.attention.w_qkv.1.weight。执行 lmdeploy convert 命令时,可以通过 --tp 指定(tp 表示 tensor parallel),该参数默认值为1(也就是一张卡)
就是把一个大的张量(参数)分到多张卡上,分别计算各部分的结果,然后再同步汇总
TurboMind 推理+命令行本地对话
模型转换完成后,我们就具备了使用模型推理的条件,接下来就可以进行真正的模型推理环节
本地对话(Bash Local Chat) 在这里其实是跳过 API Server 直接调用 TurboMind, 简单来说,就是命令行代码直接执行 TurboMind。所以说,实际和前面的架构图是有区别的.
- 支持多种方式运行,比如Turbomind、PyTorch、DeepSpeed. 但 PyTorch 和 DeepSpeed 调用的其实都是 Huggingface 的 Transformers 包,PyTorch表示原生的 Transformer 包,DeepSpeed 表示使用了 DeepSpeed 作为推理框架. Pytorch/DeepSpeed 目前功能都比较弱,不具备生产能力,不推荐使用\
- 执行命令如下
lmdeploy chat turbomind ./workspace可以进入对话
TurboMind推理+API服务
在上面的部分尝试了直接用命令行启动 Client,接下来尝试如何运用 lmdepoy 进行服务化
- 文档是 api server
- turbomind 是model server/inference
- 新开页面client
"模型推理/服务"目前提供了 Turbomind 和 TritonServer 两种服务化方式。
此时,Server 是 TurboMind 或 TritonServer,API Server 可以提供对外的 API 服务。推荐使用 TurboMind
# ApiServer+Turbomind   api_server => AsyncEngine => TurboMind
lmdeploy serve api_server ./workspace \
    --server_name 0.0.0.0 \
    --server_port 23333 \
    --instance_num 64 \
    --tp 1
上面的参数中 server_name 和 server_port 分别表示服务地址和端口,tp 参数我们之前已经提到过了,表示 Tensor 并行。还剩下一个 instance_num 参数,表示实例数,可以理解成 Batch 的大小
可以新开一个窗口,执行下面的 Client 命令。如果使用官方机器,可以打开 vscode 的 Terminal,执行下面的命令
# ChatApiClient+ApiServer(注意是http协议,需要加http)
lmdeploy serve api_client http://localhost:23333
网页 Demo 演示
将 Gradio 作为前端 Demo 演示。在上一节的基础上,我们不执行后面的 api_client 或 triton_client,而是执行 gradio
由于 Gradio 需要本地访问展示界面,因此也需要通过 ssh 将数据转发到本地。命令如下:
ssh -CNg -L 6006:127.0.0.1:6006 root@ssh.intern-ai.org.cn -p <你的 ssh 端口号>
TurboMind 服务作为后端
API Server 的启动和上一节一样,这里直接启动作为前端的 Gradio
# Gradio+ApiServer。必须先开启 Server,此时 Gradio 为 Client
lmdeploy serve gradio http://0.0.0.0:23333 \
    --server_name 0.0.0.0 \
    --server_port 6006 \
    --restful_api True
TurboMind 推理作为后端
Gradio 也可以直接和 TurboMind 连接
# Gradio+Turbomind(local)
lmdeploy serve gradio ./workspace
可以直接启动 Gradio,此时没有 API Server,TurboMind 直接与 Gradio 通信
TurboMind 推理 + Python 代码集成
前面介绍的都是通过 API 或某种前端与”模型推理/服务“进行交互,lmdeploy 还支持 Python 直接与 TurboMind 进行交互
实践
方案实践
“模型推理/服务”,推荐使用 TurboMind,使用简单,性能良好,相关的 Benchmark 对比如下
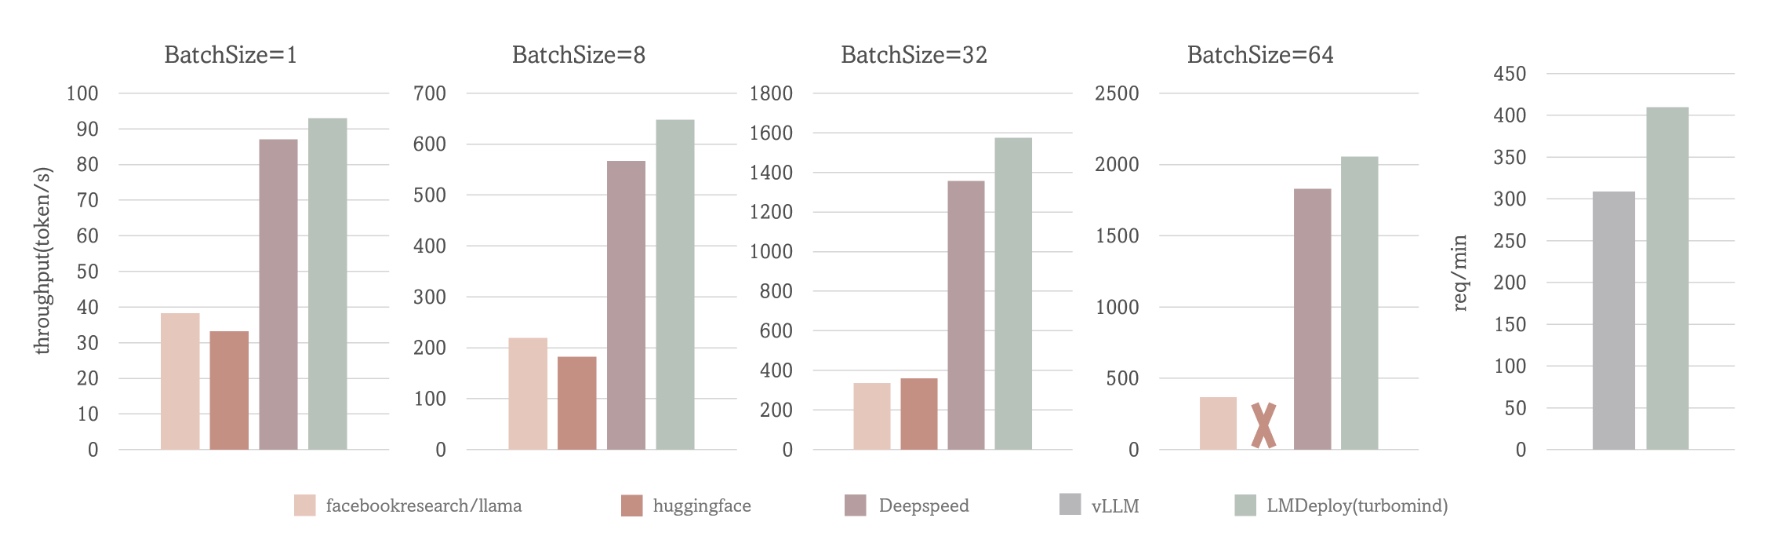
上面的性能对比包括两个场景:
- 场景一(前4张图):固定的输入、输出 token 数(分别1和2048),测试Token输出吞吐量(output token throughput)。
- 场景二(第5张图):使用真实数据,测试吞吐量(request throughput)对比了 TurboMind 和 vLLM 在真实数据上的吞吐量(request throughput)指标,TurboMind 的效率比 vLLM 高 30%。
LMDeploy应该是Transformers的3-5倍左右。
后面的 API 服务和 Client 就得分场景了
- 我想对外提供类似 OpenAI 那样的 HTTP 接口服务。推荐使用 TurboMind推理 + API 服务(2.3)
- 我想做一个演示 Demo,Gradio 无疑是比 Local Chat 更友好的。推荐使用 TurboMind 推理作为后端的Gradio进行演示(2.4.2)
- 我想直接在自己的 Python 项目中使用大模型功能。推荐使用 TurboMind推理 + Python(2.5)
- 我想在自己的其他非 Python 项目中使用大模型功能。推荐直接通过 HTTP 接口调用服务。也就是用本列表第一条先启动一个 HTTP API 服务,然后在项目中直接调用接口
- 我的项目是 C++ 写的,为什么不能直接用 TurboMind 的 C++ 接口?!必须可以!大佬可以右上角叉掉这个窗口啦
模型配置实践
# weights/config.ini
tensor_para_size = 1
session_len = 2056
max_batch_size = 64 # 在 API Server 启动时的 instance_num 参数, 吞度量越大(同时接受的请求数),但也会占用更多显存
max_context_token_num = 1
step_length = 1
cache_max_entry_count = 0.5
cache_block_seq_len = 128
cache_chunk_size = 1
use_context_fmha = 1
quant_policy = 0  # KV int8开关 4
max_position_embeddings = 2048
rope_scaling_factor = 0.0 # 外推能力开关
use_logn_attn = 0 # Attention 缩放 外推能力
外推能力开关
rope_scaling_factor 默认值为 0.0,表示不具备外推能力,设置为 1.0,可以开启 RoPE 的 Dynamic NTK 功能,支持长文本推理
use_logn_attn 参数表示 Attention 缩放,默认值为 0,如果要开启,可以将其改为 1。
模型量化
主要介绍如何对模型进行量化. KV Cache 量化和 4bit Weight Only 量化(W4A16)
主要包括 KV Cache 量化和 模型参数量化. 总的来说,量化是一种以参数或计算中间结果精度下降换空间节省(以及同时带来的性能提升)的策略.
- 计算密集(compute-bound): 指推理过程中,绝大部分时间消耗在数值计算上;针对计算密集型场景,可以通过使用更快的硬件计算单元来提升计算速。
- 访存密集(memory-bound): 指推理过程中,绝大部分时间消耗在数据读取上;针对访存密集型场景,一般通过减少访存次数、提高计算访存比或降低访存量来优化
常见的 LLM 模型由于 Decoder Only 架构的特性,实际推理时大多数的时间都消耗在了逐 Token 生成阶段(Decoding 阶段),是典型的访存密集型场景
- KV Cache 量化是指将逐 Token(Decoding)生成过程中的上下文 K 和 V 中间结果进行 INT8 量化(计算时再反量化),以降低生成过程中的显存占用。
- 4bit Weight 量化,将 FP16 的模型权重量化为 INT4,Kernel 计算时,访存量直接降为 FP16 模型的 1/4,大幅降低了访存成本。Weight Only 是指仅量化权重,数值计算依然采用 FP16(需要将 INT4 权重反量化)
KV Cache 量化
KV Cache 量化是将已经生成序列的 KV 变成 Int8,使用过程一共包括三步:
- 计算 minmax. 主要思路是通过计算给定输入样本在每一层不同位置处计算结果的统计情况.
- 对于 Attention 的 K 和 V:取每个 Head 各自维度在所有Token的最大、最小和绝对值最大值。对每一层来说,上面三组值都是 (num_heads, head_dim) 的矩阵。这里的统计结果将用于本小节的 KV Cache。
- 对于模型每层的输入:取对应维度的最大、最小、均值、绝对值最大和绝对值均值。每一层每个位置的输入都有对应的统计值,它们大多是 (hidden_dim, ) 的一维向量,当然在 FFN 层由于结构是先变宽后恢复,因此恢复的位置维度并不相同。这里的统计结果用于下个小节的模型参数量化,主要用在缩放环节(回顾PPT内容)
- 在这个命令行中,会选择 128 条输入样本,每条样本长度为 2048,数据集选择 C4,输入模型后就会得到上面的各种统计值。值得说明的是,如果显存不足,可以适当调小 samples 的数量或 sample 的长度
# 计算 minmax lmdeploy lite calibrate \ --model /root/share/temp/model_repos/internlm-chat-7b/ \ --calib_dataset "c4" \ --calib_samples 128 \ --calib_seqlen 2048 \ --work_dir ./quant_output
- 通过 minmax 获取量化参数。主要就是利用下面这个公式,获取每一层的 K V 中心值(zp)和缩放值(scale)有这两个值就可以进行量化和解量化操作了。具体来说,就是对历史的 K 和 V 存储 quant 后的值,使用时在 dequant
python zp = (min+max) / 2 scale = (max-min) / 255 quant: q = round( (f-zp) / scale) # 量化 dequant: f = q * scale + zp # 反量化python
- 修改配置。也就是修改 weights/config.ini 文件. KV int8 开关, 只需要把 quant_policy 改为 4 即可
W4A16 量化
W4A16中的 A 是指Activation,保持FP16,只对参数进行 4bit 量化。使用过程也可以看作是三步
第一步:同 1.3.1,不再赘述
第二步:量化权重模型。利用第一步得到的统计值对参数进行量化,具体又包括两小步:
缩放参数。主要是性能上的考虑(回顾 PPT)。
整体量化
最后一步:转换成 TurboMind 格式
最佳实践
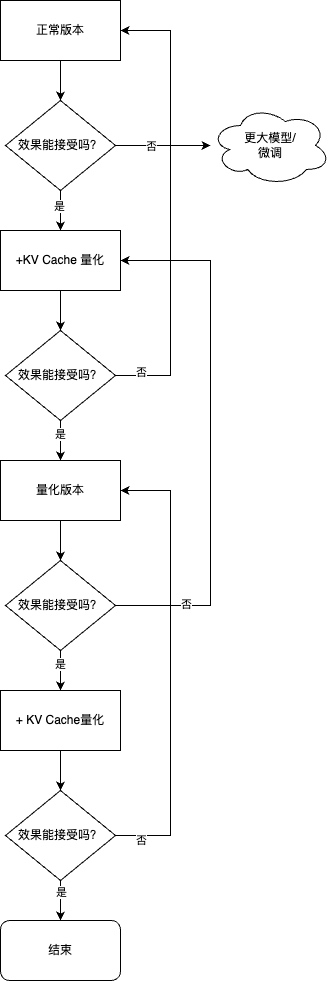
服务部署和量化是没有直接关联的,量化的最主要目的是降低显存占用,主要包括两方面的显存:模型参数和中间过程计算结果。前者对应《3.2 W4A16 量化》,后者对应《3.1 KV Cache 量化》
量化在降低显存的同时,一般还能带来性能的提升,因为更小精度的浮点数要比高精度的浮点数计算效率高,而整型要比浮点数高很多.
建议是:在各种配置下尝试,看效果能否满足需要。这一般需要在自己的数据集上进行测试