

110
社区成员
 发帖
 与我相关
 我的任务

 分享
课程:《Python程序设计》
班级: 2332
姓名: 林渤程
学号:20233210
实验教师:王志强
实验日期:2024年5月15日
必修/选修: 公选课
利用python实现爬虫,爬取B站评论,并获得词云图
1)引入函数库
其中csv用于保存,re、hashlib、time用于多页爬取,pandas等用于生成词云,具体用途在下面提到
import requests
import re
from bs4 import BeautifulSoup
import csv
import hashlib
import time
from urllib.parse import quote
import pandas as pd
from wordcloud import WordCloud
import matplotlib.pyplot as plt
2)请求获取数据
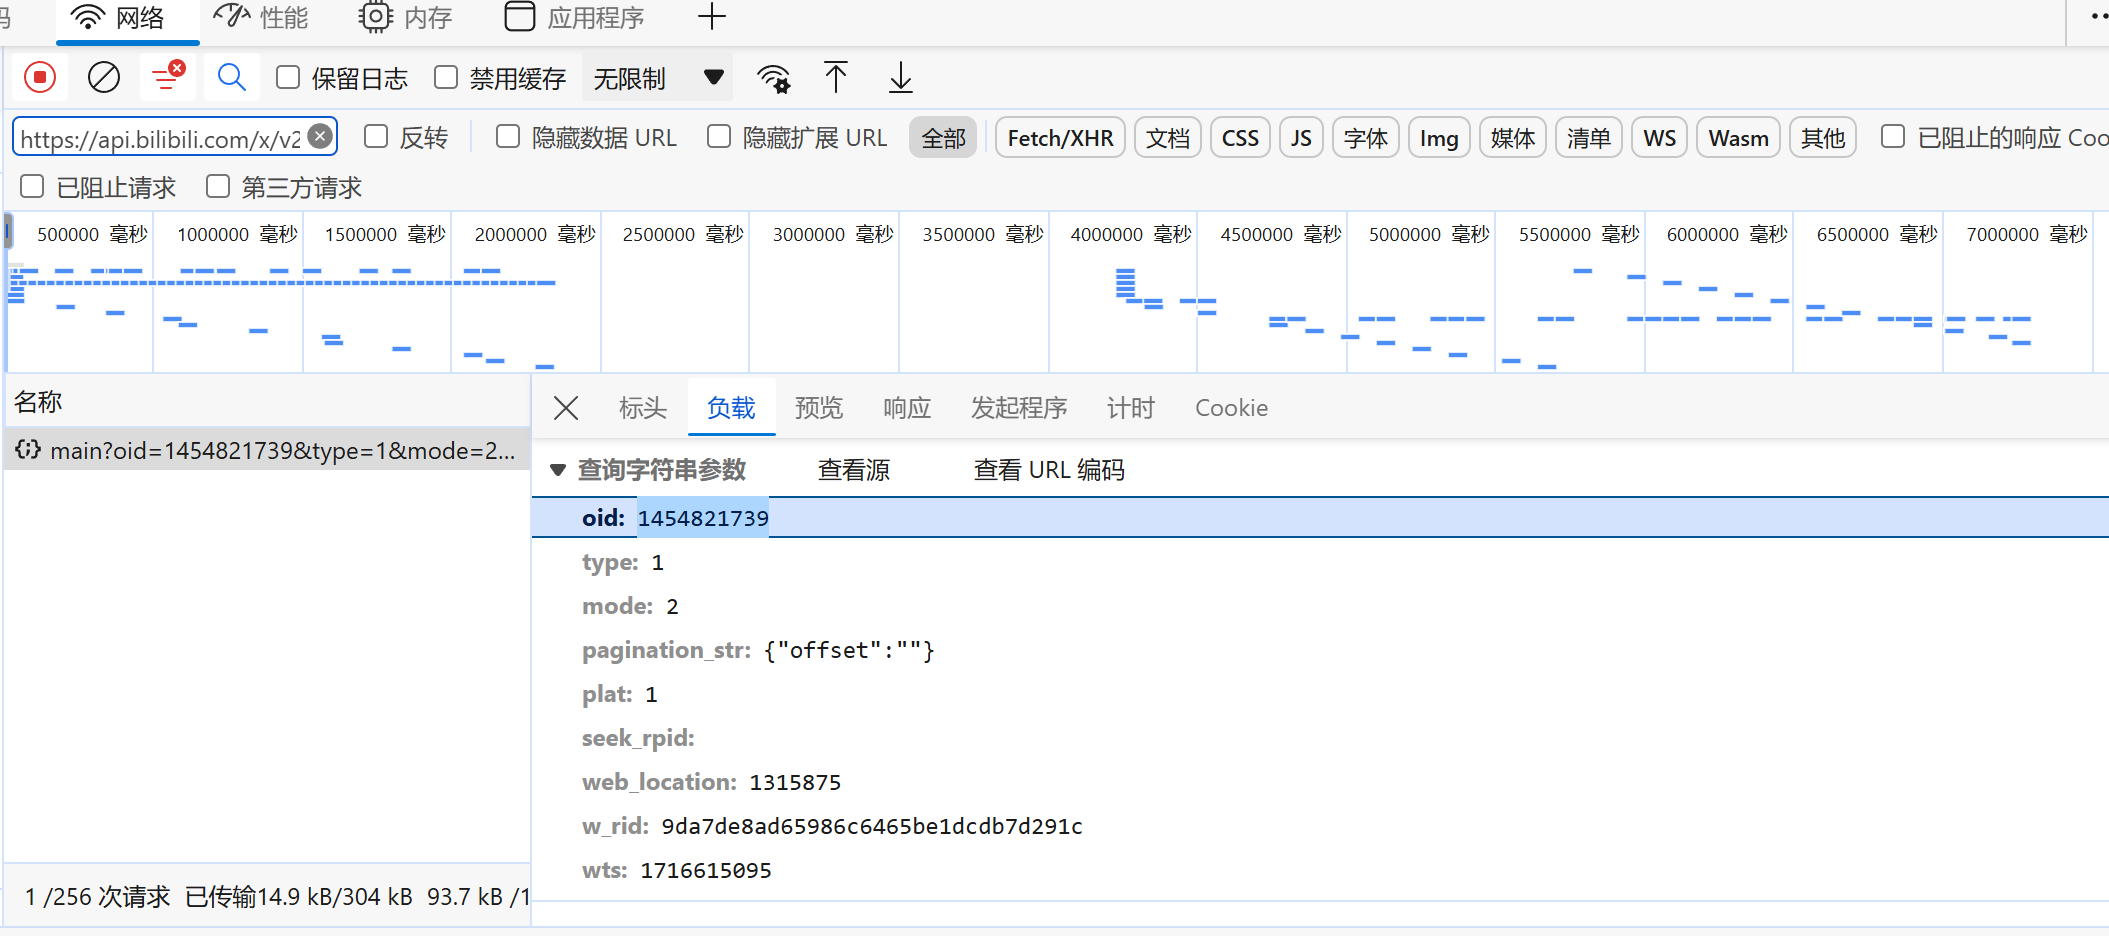
首先,用header假装自己是电脑,防止出现I am a teapot;其中data为字符串参数,具体数值可以在网页后端找到;最后,用request进行请求
def datasolve(next_page, date, w_rid, flag1, oid):
     headers = {
        'User-Agent': "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0.0.0 Safari/537.36 Edg/125.0.0.0"
    }
    # I am a teapot
    url = 'https://api.bilibili.com/x/v2/reply/wbi/main'
    data = {
            'oid': oid,
            'type': '1',
            'mode': '2',
            'pagination_str': '{"offset":%s}' % next_page,
            'plat': '1',
            'web_location': '1315875',
            'w_rid': w_rid,
            'wts': date,
        }
   response = requests.get(url, params=data, headers=headers)
3)解析数据
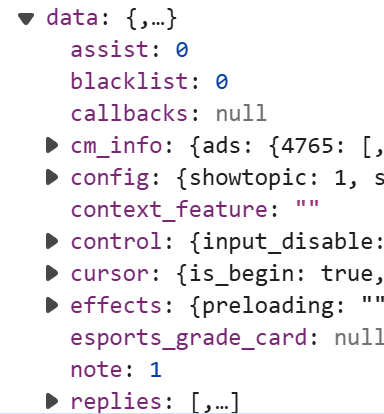
首先,我们发现评论的位置被{}包裹起来,故使用json;而后我们逐一查找键值找到评论所在地,可以利用搜索快速查找,利用键值一层一层往下,最后使用循环将一页评论读完
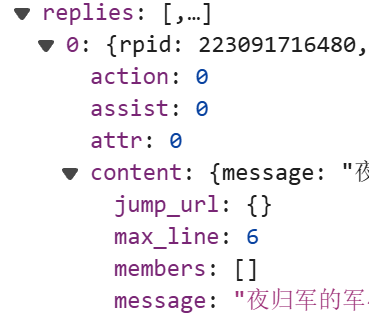
def datasolve(next_page, date, w_rid, flag1, oid):
     headers = {
        'User-Agent': "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0.0.0 Safari/537.36 Edg/125.0.0.0"
    }
    url = 'https://api.bilibili.com/x/v2/reply/wbi/main'
    data = {
            'oid': oid,
            'type': '1',
            'mode': '2',
            'pagination_str': '{"offset":%s}' % next_page,
            'plat': '1',
            'web_location': '1315875',
            'w_rid': w_rid,
            'wts': date,
        }
   response = requests.get(url, params=data, headers=headers)
   json_data = response.json()      #b站的评论响应内容被{}包裹起来,故用json
   all_reply = json_data['data']['replies']
   for reply in all_reply:
        message = reply['content']['message'].replace('\n', ',')    #去掉换行符
        like = reply['like']
        datalist = {
            'reply': message,
            'like': like,
        }
        savedata(datalist, flag1)
        flag1 = False
        print(datalist)
4)保存数据
用csv进行保存,写入表格,其中fieldnames为字段名,即表头,根据获取数据写出,用flag进行判断,防止写完一次、覆盖一次,应使用’a‘,进行追加;采用‘utf-8’来对爬去的信息进行解码
def savedata(datalist, flag):
    if flag:
        fe = open('data.csv', 'w', encoding = 'utf-8', newline='')
        csv_writer = csv.DictWriter(fe, fieldnames=[
            'reply',
            'like',
        ])      #字段名,即表头,根据获取数据
        csv_writer.writeheader()
        csv_writer.writerow(datalist)
    else:
        fe = open('data.csv', 'a', encoding='utf-8', newline='')
        csv_writer = csv.DictWriter(fe, fieldnames=[
            'reply',
            'like',
        ])
        csv_writer.writerow(datalist)
5)多页爬取
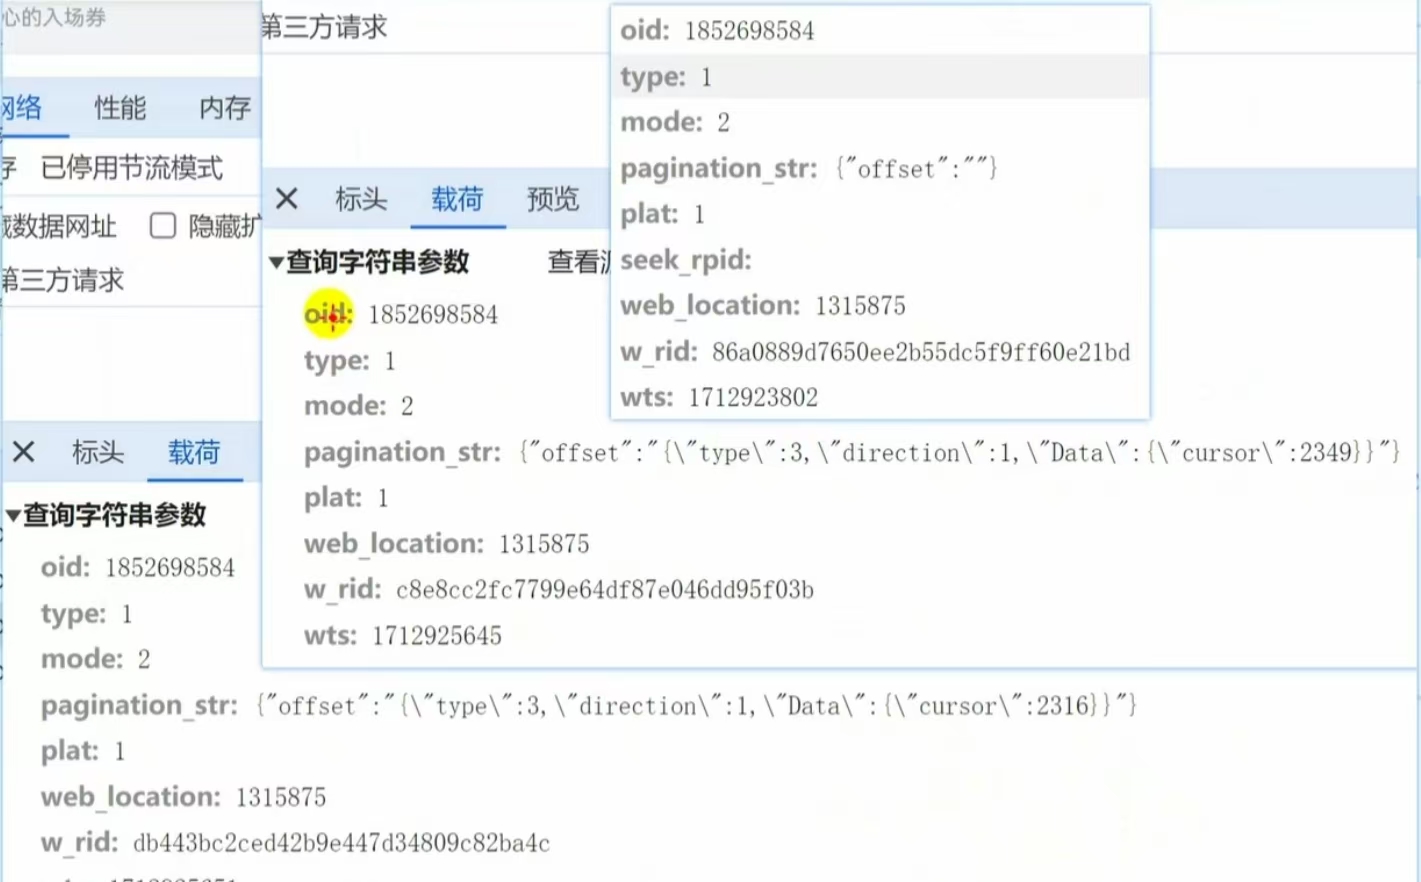
通过比较可以发现,不同的评论页的网址(滚动会出现不同的网址)只有pagination_str,w_rid,wts会变。其中wts为时间戳可直接通过time函数获取,通过学习我们可以发现下一页的pagination_str蕴含在本页中,故同提取评论一样可获得。
-通过不完全归纳法,可以大致看出不同视频只有oid变了
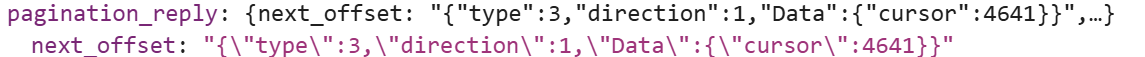
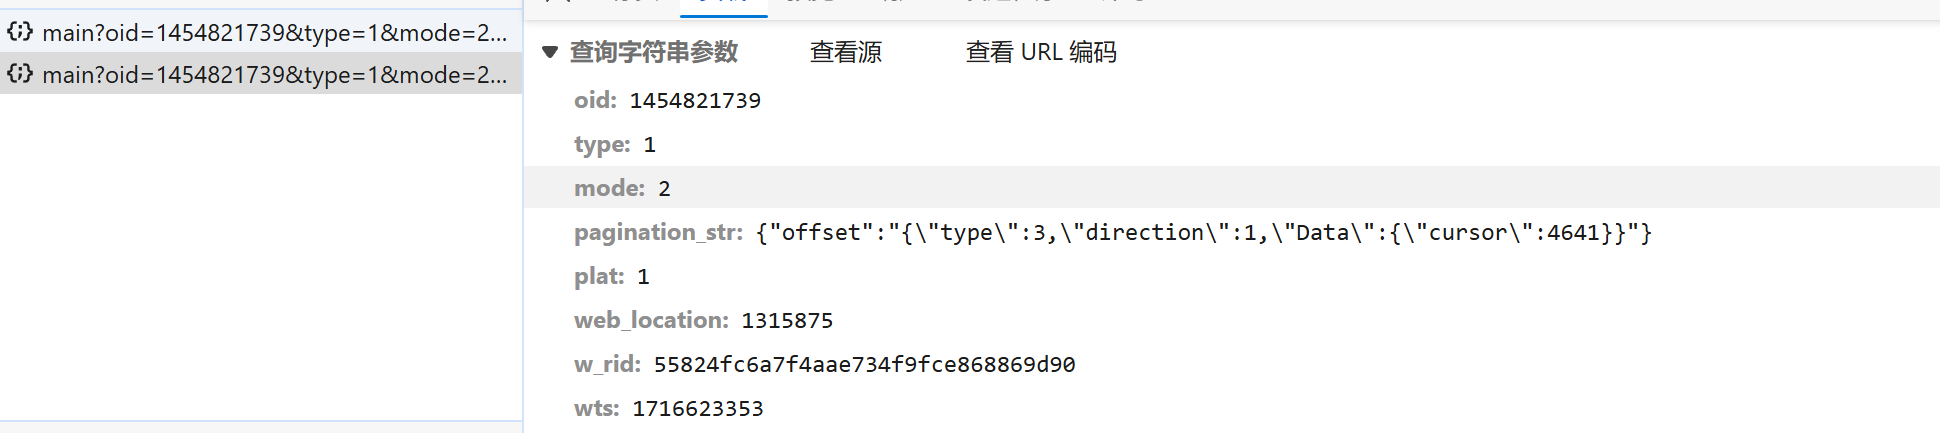
但通过在评论给的相应中搜索我们找不到w_rid在里面,通过学习可知其被加密,故进行泛搜索找到了其源代码
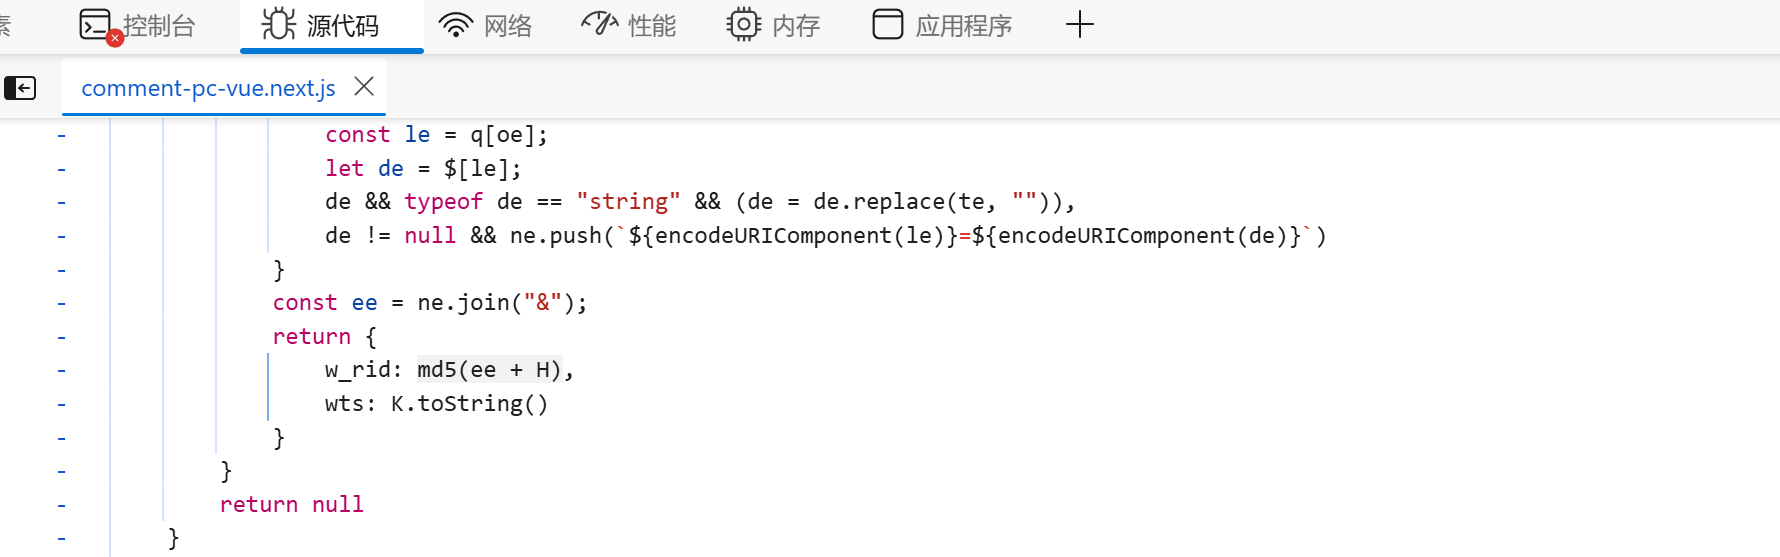
通过滚动页面,设置断点我们可以知道相关的参数,也通过学习与验算可知md5加密在函数库hashlib中
def Hash(date, next_page,flag,oid):
    #获取w_rid的值
    next_offset = '{"offset":%s}' % next_page
    en = [
        "mode=2",
        f"oid={oid}",
        f"pagination_str={quote(next_offset)}",
        "plat=1",
        "type=1",
        "web_location=1315875",
        f"wts={date}"
    ]
    ee = '&'.join(en)
    string = ee + "ea1db124af3c7062474693fa704f4ff8"                 #常数为H
    MD5 = hashlib.md5()
    MD5.update(string.encode('utf-8'))
    w_rid = MD5.hexdigest()
    return w_rid
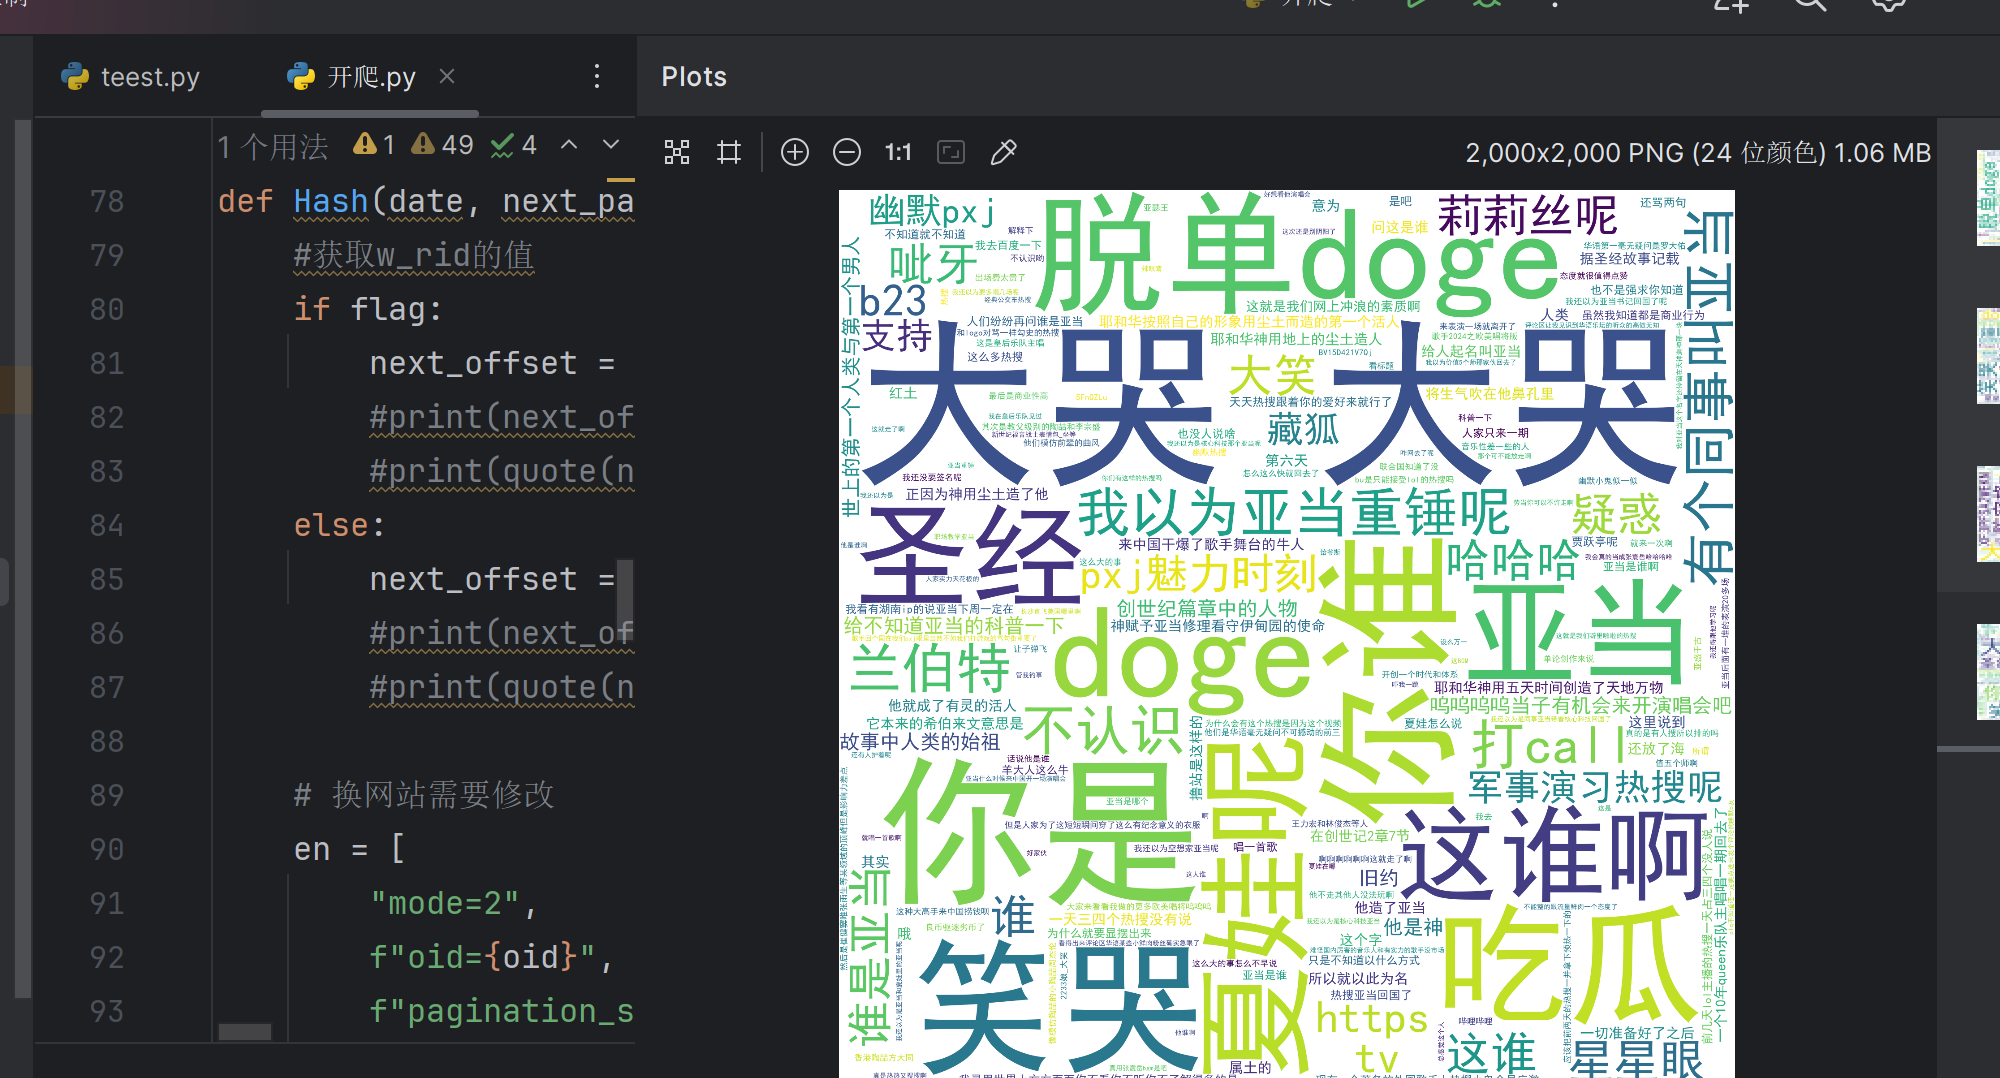
6)云图绘制
df['reply'] 为自己设的字段名,font_path='C:/Windows/Fonts/simhei.ttf' 为字体路径(可通用)
def Cloud():           #生成词云,技术不行
    df = pd.read_csv('data.csv')
    text = " ".join(review for review in df['reply'])
    wordcloud = WordCloud(width=2000, height=2000, font_path='C:/Windows/Fonts/simhei.ttf',
                          background_color='white', min_font_size=10).generate(text)
    plt.figure(figsize=(20,20), facecolor=None)
    plt.imshow(wordcloud)
    plt.axis("off")
    plt.tight_layout(pad=0)
    plt.show()
7)源代码与运行视频
import requests
import re
from bs4 import BeautifulSoup
import csv
import hashlib
import time
from urllib.parse import quote
import pandas as pd
from wordcloud import WordCloud
import matplotlib.pyplot as plt

def datasolve(next_page, date, w_rid, flag1, oid):
    headers = {
        'User-Agent': "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0.0.0 Safari/537.36 Edg/125.0.0.0"
    }
    # I am a teapot
    url = 'https://api.bilibili.com/x/v2/reply/wbi/main'
    if flag1:
        #常数在换网站需要修改
        data = {
            'oid': oid,
            'type': '1',
            'mode': '2',
            'pagination_str': '{"offset":%s}' % next_page,
            'plat': '1',
            'web_location': '1315875',
            'w_rid': w_rid,
            'wts': date,
        }
    else:
        #换网站需要修改
        data = {
            'oid': oid,
            'type': '1',
            'mode': '2',
            'pagination_str': next_page,
            'plat': '1',
            'web_location': '1315875',
            'w_rid': w_rid,
            'wts': date,
        }
    response = requests.get(url, params=data, headers=headers)
    #print(response.status_code)
    json_data = response.json()      #b站的评论响应内容被{}包裹起来,故用json
    #print(json_data)
    all_reply = json_data['data']['replies']

    #提取数据所在列表,字典取值一层一层往下
    for reply in all_reply:
        message = reply['content']['message'].replace('\n', ',')    #去掉换行符
        like = reply['like']
        datalist = {
            'reply': message,
            'like': like,
        }
        savedata(datalist, flag1)
        flag1 = False
        print(datalist)

    #下一页请求参数
    next_offset1 = json_data['data']['cursor']['pagination_reply']['next_offset']
    #可恶啊,真不知道为什么爬下一页的pagination_str会少掉‘\‘,(很多#print都是在排查错误),所以用正则提取数字重构一次
    #所以也多了好多条件语句,可能可以精简,但我累了

    next_offset_num = re.findall('cursor\":(\\d+)', next_offset1)[0]      #\d没有,要\\d,好像是被解释成Unicode字符
    next_offset = '{"offset":"{\\"type\\":3,\\"direction\\":1,\\"Data\\":{\\"cursor\\":%s}}"}' % next_offset_num
    #print(next_offset)
    return next_offset


    # html = response.text     # soup不能直接接收response
    # soup = BeautifulSoup(html, "html.parser")
    # all_rep = soup.find_all("span",class_="reply-content")
    # for rep in all_rep:
    #     print(rep.string)


def Hash(date, next_page, flag, oid):
    #获取w_rid的值
    if flag:
        next_offset = '{"offset":%s}' % next_page
        #print(next_offset)
        #print(quote(next_offset))
    else:
        next_offset = next_page
        #print(next_offset)
        #print(quote(next_offset))

    # 换网站需要修改
    en = [
        "mode=2",
        f"oid={oid}",
        f"pagination_str={quote(next_offset)}",
        "plat=1",
        "type=1",
        "web_location=1315875",
        f"wts={date}"
    ]
    ee = '&'.join(en)
    string = ee + "ea1db124af3c7062474693fa704f4ff8"
    MD5 = hashlib.md5()
    MD5.update(string.encode('utf-8'))
    w_rid = MD5.hexdigest()
    #print(w_rid)
    return w_rid


def savedata(datalist, flag):
    if flag:
        fe = open('data.csv', 'w', encoding = 'utf-8', newline='')
        csv_writer = csv.DictWriter(fe, fieldnames=[
            'reply',
            'like',
        ])      #字段名,即表头,根据获取数据
        csv_writer.writeheader()
        csv_writer.writerow(datalist)
    else:
        fe = open('data.csv', 'a', encoding='utf-8', newline='')
        csv_writer = csv.DictWriter(fe, fieldnames=[
            'reply',
            'like',
        ])
        csv_writer.writerow(datalist)


def Cloud():           #生成词云,技术不行
    df = pd.read_csv('data.csv')
    text = " ".join(review for review in df['reply'])
    wordcloud = WordCloud(width=2000, height=2000, font_path='C:/Windows/Fonts/simhei.ttf',
                          background_color='white', min_font_size=10).generate(text)
    plt.figure(figsize=(20,20), facecolor=None)
    plt.imshow(wordcloud)
    plt.axis("off")
    plt.tight_layout(pad=0)
    plt.show()

if __name__ == "__main__":  # 当程序执行时
    # 调用函数
    oid = input("请输入oid:")          #可能只有oid变了
    next_page = '""'
    flag1 = True
    for page in range(1, 11):     #可修改页数
        print("正在爬取第(",page,")页")
        date = int(time.time())
        w_rid = Hash(date, next_page,flag1, oid)
        #print(w_rid)
        next_page = datasolve(next_page, date, w_rid, flag1, oid)
        flag1 = False
    Cloud()
问题1解决方案:通过观看教程,使用json进行爬取
问题2:多页查找时算出的w_rid不对,一直权限不足
问题2解决方案:很多#print都是在排查错误,不知道为什么爬下一页的pagination_str会少掉‘\‘,所以用正则提取数字重构一次
问题3:正则表达式’\d‘出错
问题3解决方案:要‘\d’,好像是被解释成Unicode字符
问题4:重构后只有第一个可以,后面还不行
问题4解决方案:使用flag进行判断,因为第一个无需重构,但在hash中要修改,还有在data中不是第一个的也要
问题5:文件里写完一个覆盖一个
问题5解决方案:用flag进行判断,w 还是a
多了好多条件语句,可能可以精简,但我真的改不动了,这个加密是真的烦,一点不同就跳不到下一页,原本是想做舆情分析的,但找不到好的参考,所以转做词云了;做完这个实验感觉长脑子了,对爬虫更加理解,深深感受到爬虫速度之快,还有python的库好多、有好多函数。也学会了故障检测,怎么找错。
1.老师很好,人帅心善;
2.对python的学习更加深入了,也理清了一些概念,如面向对象与面向过程的区别
3.老师的讲课内容非常生动形象,举得例子也很贴合,便于我们理解
4.建议:我觉得可以进行一个翻译,选取一个C语言的程序,让我们用这节课所学将它转成python实现同样的功能,加深印象

