

110
社区成员
 发帖
 与我相关
 我的任务

 分享
课程:《Python程序设计》
班级: 202322
姓名: 曾键哲
学号:20232208
实验教师:王志强
实验日期:2024年5月26日
必修/选修: 公选课
1.实验内容
(1)实验要求
Python综合应用:爬虫、数据处理、可视化、机器学习、神经网络、游戏、网络安全等。
课代表和各小组负责人收集作业(源代码、视频、综合实践报告)
例如:编写从社交网络爬取数据,实现可视化舆情监控或者情感分析。
例如:利用公开数据集,开展图像分类、恶意软件检测等
例如:利用Python库,基于OCR技术实现自动化提取图片中数据,并填入excel中。
例如:爬取天气数据,实现自动化微信提醒
例如:利用爬虫,实现自动化下载网站视频、文件等。
例如:编写小游戏:坦克大战、贪吃蛇、扫雷等等
注:在Windows/Linux系统上使用VIM、PDB、IDLE、Pycharm等工具编程实现。
(2)实验内容
从豆瓣评论爬取数据,并填入 excel 中。
利用python分析excel表格生成词云。
实验背景:现在很多人遇到想看一个电影但是不知道知不知道观看的问题,但是一个个去查看影评却又太消耗时间,所以制作了这个程序;从评论区爬取数据之后可以生成词云,快速判断是否适合自己观看。
实验设计:
从评论页面 , 通过通过右键鼠标审查元素获取 URL
开始程序前下载pandas,requests,beautifulSoup,jieba,wordcloud库,分别用于发送各种HTTP请求,帮助我们解析网页数据,解析html和xml文档,将中文提词,以及最后生成词云。
使用pip install 下载,很幸运没有出现问题
模拟浏览器头部信息,以伪装为真实的浏览器访问网页,防止被反爬机制拒绝
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/121.0.0.0 Safari/537.36'
}
提示用户输入要爬取的URL并设置要爬取的页数
target = input("请输入url:")
max_pages = 20
初始化一个空列表,用于存储爬取到的评论并循环爬取每一页
comments = []

for page in range(max_pages):
    url_to_fetch = target + '?start=' + str(page * 20)

    response = requests.get(url=url_to_fetch, headers=headers)

    response.encoding = 'utf-8'

    soup = BeautifulSoup(response.text, 'lxml')

    comment_elements = soup.find_all('span', {'class': 'short'})

    for element in comment_elements:
        comments.append(element.text.strip())
创建字典存放评论,并转化为DataFrame,后保存到excel文件中
data = {'评论内容': comments}

df = pd.DataFrame(data)

output_filename = "douban_comments2.xlsx"

df.to_excel('C:/Users/曾键哲/Desktop/ciyuntu/douban_comments2.xlsx', index=False, engine='openpyxl')
由于自身在程序中打开阅读.xlsx文件时遇到困难,所以将其转化为.txt文件阅读并用于生成词云。
下面是将.xlsx文件转化为.txt文件的代码
def excel_to_txt(excel_file, txt_file):
    try:
        df = pd.read_excel(excel_file)
    except FileNotFoundError:
        print("ERROR")
        return

    try:
        with open(txt_file, 'w', encoding='utf-8') as f:
            for index, row in df.iterrows():
                for column_index, column_value in enumerate(row):
                    if column_index > 0:
                        f.write('\t')
                    f.write(str(column_value))
                f.write('\n')
    except Exception as e:
        print(f"ERROR")

excel_file = "C:/Users/曾键哲/Desktop/ciyuntu/douban_comments2.xlsx"
txt_file = "C:/Users/曾键哲/Desktop/ciyuntu/douban_comments2.txt"
excel_to_txt(excel_file, txt_file)
读取TXT文件内容,使用jieba进行中文分词,再将分词列表用空格连接成字符串文本,最后除去一些没有助于判断是否值得观影的词汇,如语气词
with open("C:/Users/曾键哲/Desktop/ciyuntu/douban_comments2.txt", encoding="utf-8") as f:
    s = f.read()

list_s = jieba.lcut(s)

text = ' '.join(list_s)

stopwords = ["是", "的", "了", "啊"]
最后设置参数并创建词云图
wc = wordcloud.WordCloud(
    font_path="msyh.ttc",
    width=1000,
    height=700,
    background_color='white',
    max_words=100,
    stopwords=stopwords
)

wc.generate(text)

wc.to_file("C:/Users/曾键哲/Desktop/ciyuntu/ciyuntu.png")
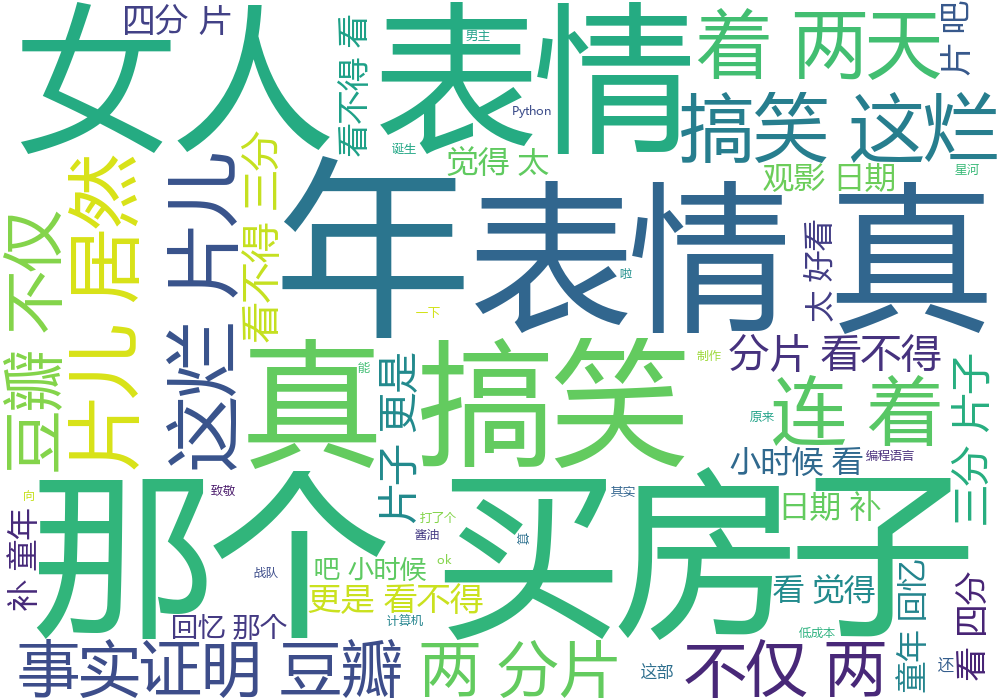
最后生成的词云图
def excel_to_txt(excel_file, txt_file):
    try:
        df = pd.read_excel(excel_file)
    except FileNotFoundError:
        print("ERROR")
        return

    try:
        with open(txt_file, 'w', encoding='utf-8') as f:
            for index, row in df.iterrows():
                for column_index, column_value in enumerate(row):
                    if column_index > 0:
                        f.write('\t')
                    f.write(str(column_value))
                f.write('\n')
    except Exception as e:
        print(f"ERROR")

excel_file = "C:/Users/曾键哲/Desktop/ciyuntu/douban_comments2.xlsx"
txt_file = "C:/Users/曾键哲/Desktop/ciyuntu/douban_comments2.txt"
excel_to_txt(excel_file, txt_file)
with open(txt_file, 'w', encoding='utf-8') as f:
问题3:生成的词云中语气词占多数,影响原本的判断目的
问题3解决方案:屏蔽语气词,防止其在词云中出现
参考资料
...
```
对于这次爬取豆瓣电影评论以及生成词云图的实验,我有以下几点感悟和思考:
在这次实验中,我使用了pandas来处理Excel数据,jieba来进行中文分词,以及wordcloud来生成词云图。这些库是我在从前的学习中少有接触的,通过此次试验,扩大了我的基础知识,也使我在未来能更灵活的运用python这门语言。
在实验中,中文分词也给我带来了不小的问题。中文分词有别于其他语言,部分字词表意的同时还能表达预期,高频的语气词会干扰词云的有效生成,也是这次实验中的一个需要注意的点。在最开始的词云中,有不少语气词,这是需要再处理的。尽管已经作了处理,但是在其他影评生成的词云中还是会出现少量没有考虑到的语气词出现在词云中。
这也让我意识到,以后在处理中文文本时,需要特别关注分词筛选和优化,以确保分析的准确性和有效性。
此次试验也是我学习python以来做过的最有挑战性的实验。没有老师的指导,有了问题需要自己上网挨个需求解决方案。并且在这次实验中,我接触到了更多从前没有使用过的python的方法和库,丰富了自己对python的理解,同时也能让我在未来更好的运用python来方便生活与学习。
Python课程感想体会——“人生苦短,我用python”
在Python课程的学习过程中,我不仅了解了Python的语法和不少库、函数的使用方法,还将其实用化,写了不少真正有作用的代码,感受到了编程实际应用的魅力。特别是在最后一次的实验中,我使用python编写了爬取豆瓣评论并保存,生成词云图的程序,可以有效的帮助我判断一个电影是否适合我来观看。
在此次课程中,我体会到了python强大的兼容性,支持多种我意想不到的操作,比如主,客机对话,转换文件,保存网页数据等等;更让我欣喜的是python的简洁程度,正如王老师开课所说:“人生苦短,我用python”,用python写一个程序十分简洁,其他的语言可能需要大段的代码,但是使用python却十分的方便,短短几行足矣。不管是之前的主客机对话实验,还是这次的爬虫实验,所写出的代码都不算长,很方便的实现了程序段功能,并且可以在日后一直使用。
我觉得这次课程最大的意义不仅仅是学会了python这一门便捷的语言,更是让将所学知识应用于实际项目中,加深了我对编程的实用性和价值的理解。通过项目的实践,我不仅巩固了所学知识,还学会了如何将理论知识与实际问题相结合,提高了我的综合能力和实践能力。最后,python的快速,简洁也能在其他方面对我起到有效的帮助,比如蓝桥杯的竞赛,前两题填空题使用其他语言写起来太慢,但是python依靠他的简洁性可以轻松帮我完成。
意见:
我希望在未来的Python课程中,能够增加更多的项目实践机会。尤其是小组合作,当大家一起合作完成一个较大,颇有成果的项目时,不仅自身会有很大的成就感,而且大家可以更好地理解和应用所学知识,相互配合,提高我们的团队编程能力和解决问题的能力。并且服务于日后我们可能碰到的需要团队合作的项目。
总之,这次Python课程的学习经历让我受益匪浅。我不仅掌握了Python的基础知识,还体会到了编程实用性的价值。我相信在未来的学习和工作中,Python将会成为我不可或缺的一项技能。
