

 C#

c#控制台,输出一定数量汉字后就开始乱码是什么情况
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
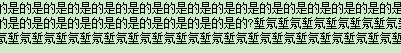
比如这样,就两行一行是定义一个字符串“是的是的是的”,
然后Console.WriteLine就这样了,
在控制台输出一定字后,就开始乱码了,
从文件里读出来的文字也一样,输出到一定数量就乱码。
这是什么情况,有什么解决办法么。
相关推荐
java按字节截取带有汉字的字符串的解法(推荐)
本文将深入探讨如何正确地按字节截取带有汉字的字符串,以确保不出现半字符或者乱码的情况。
C#面试必会:字符统计源码全拆解,附Benchmark数据
字符统计是C#面试高频考点,也是文本处理、NLP、数据清洗的基础能力。本文从Unicode字符判定规则出发,逐层拆解汉字/字母/数字/符号全分类统计的O(n)实现源码,对比Dictionary与数组两种频率统计方案的性能差异,并附BenchmarkDotNet实测数据。同时覆盖密码强度校验、爬虫清洗、词频统计等工业落地场景,展望大文件分块读取与Span优化等进阶方向。
C#/.NET自研中文分词器:基于Trie树与双向最大匹配的实践
中文分词是自然语言处理的基础环节,直接影响搜索引擎、文本挖掘与信息检索的效果。基于词典的分词算法中,Trie树是一种高效的前缀检索结构,能够显著提升词典匹配速度;正向最大匹配与逆向最大匹配相结合的双向匹配策略,则能有效消解歧义。这类规则驱动的方法无需训练数据,具备计算开销低、可解释性强、易于定制词典等工程优势,特别适合中小规模文本处理场景。在C#/.NET技术栈中,由于成熟开源分词库相对匮乏,自研一个轻量分词器成为可行路径。通过加载自定义词典、构建Trie树、实现双向最大匹配及未登录词兜底处理,即可满足站内
C#(.net)中按字节数截取字符串最后出现乱码问题的解决
在C#(.NET)开发过程中,我们可能会遇到一个常见的问题,那就是按字节数截取字符串时,尤其是在处理包含非ASCII字符(如中文字符)的字符串时,末尾可能出现乱码。
c#字符串编码问题的处理解决
在C#中,如果你想看看某个汉字的Unicode编码可以使用如下代码:```csharpstring s = "梁";byte[] unicode = Encoding.Unicode.GetBytes(




