

 大学生Python学习

python爬虫-采集黑马程序员论坛的帖子
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
- 实验目的
- 熟悉XPath的语法,能够根据需要编写XPath的路径表达式;
- 使用正则表达式提取文章标题、链接、发布时间和作者;
- 掌握lxml库的用法,能够灵活应用lxml库解析网页数据;
- 掌握jsonpath模块的用法,能够灵活运用jsonpath模块解析JSON文档。
- 实验内容
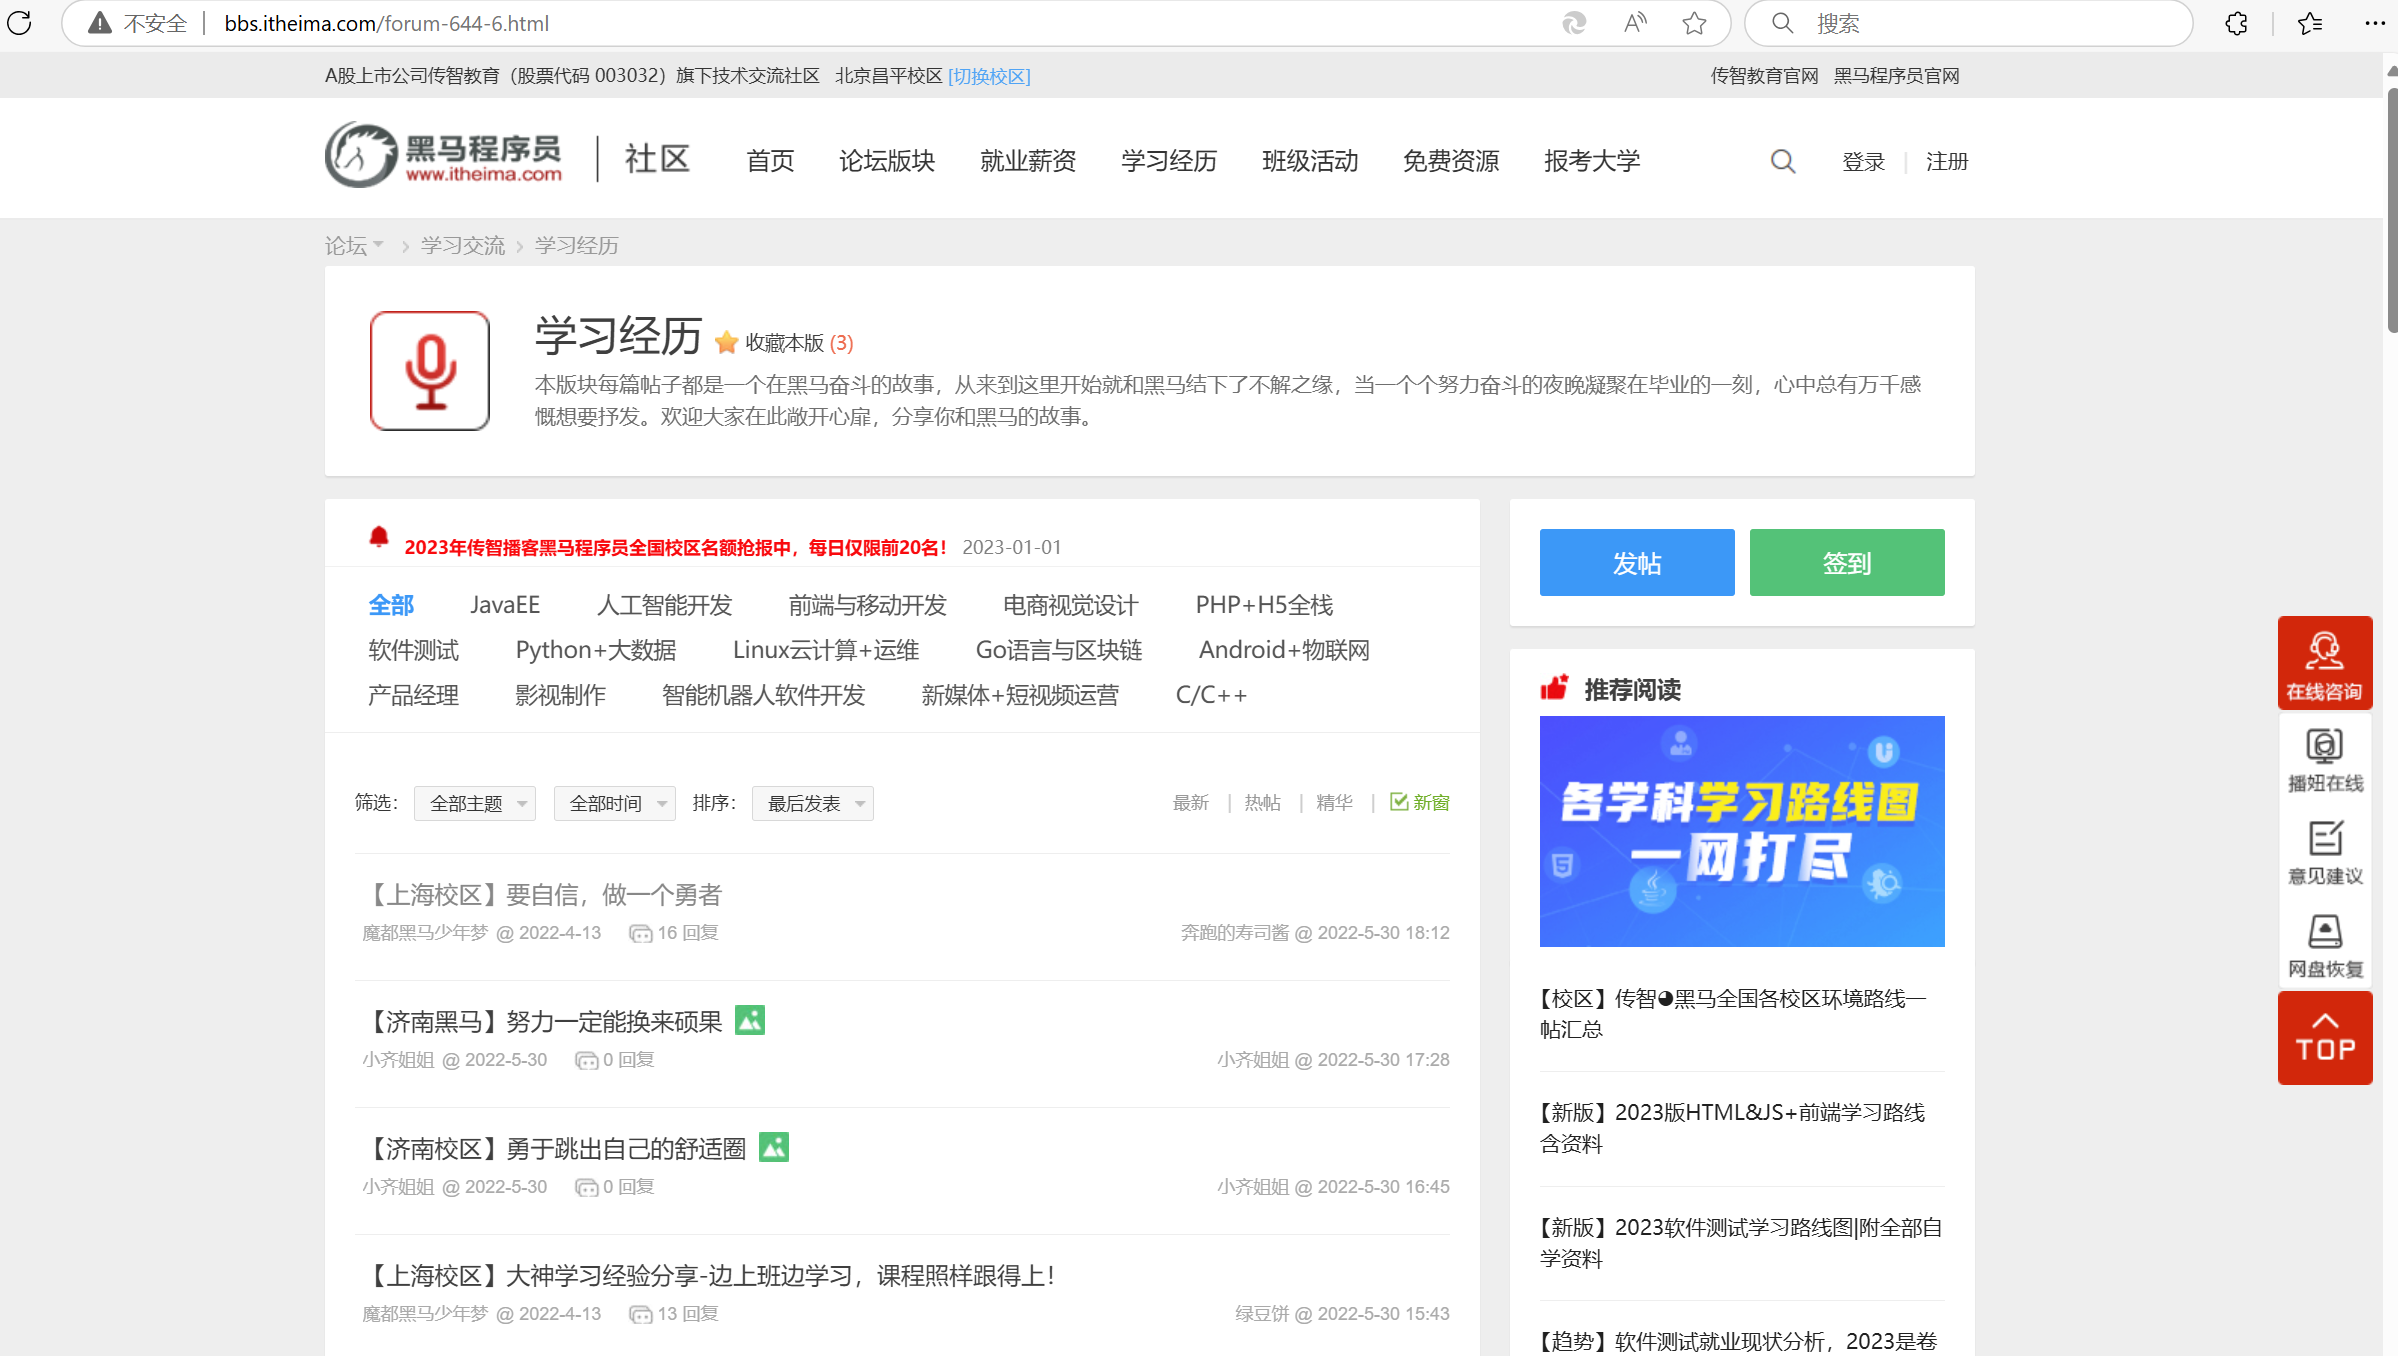
通过浏览器搜索黑马程序员论坛(http://bbs.itheima.com/forum-644-6.html),打开Python+人工智能技术交流板块页面(python技术交流论坛),每个帖子都以相同的布局方式显示了详细的信息,包括文章标题、发布时间、文章作者等。通过爬虫技术采集文章的标题、文章的链接、文章作者和发布时间。
- 实验过程(步骤)
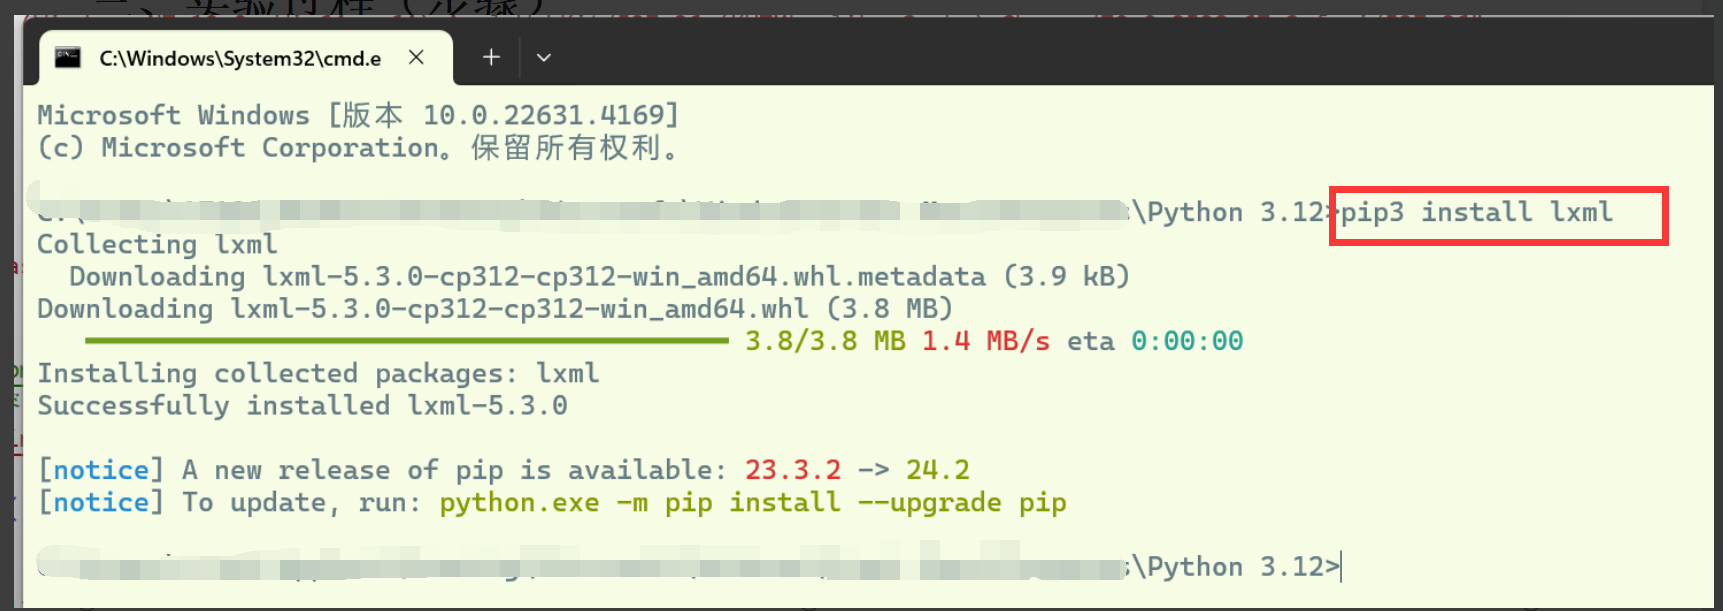
- 没有requests库和lxml库,先用pip3安装库
-
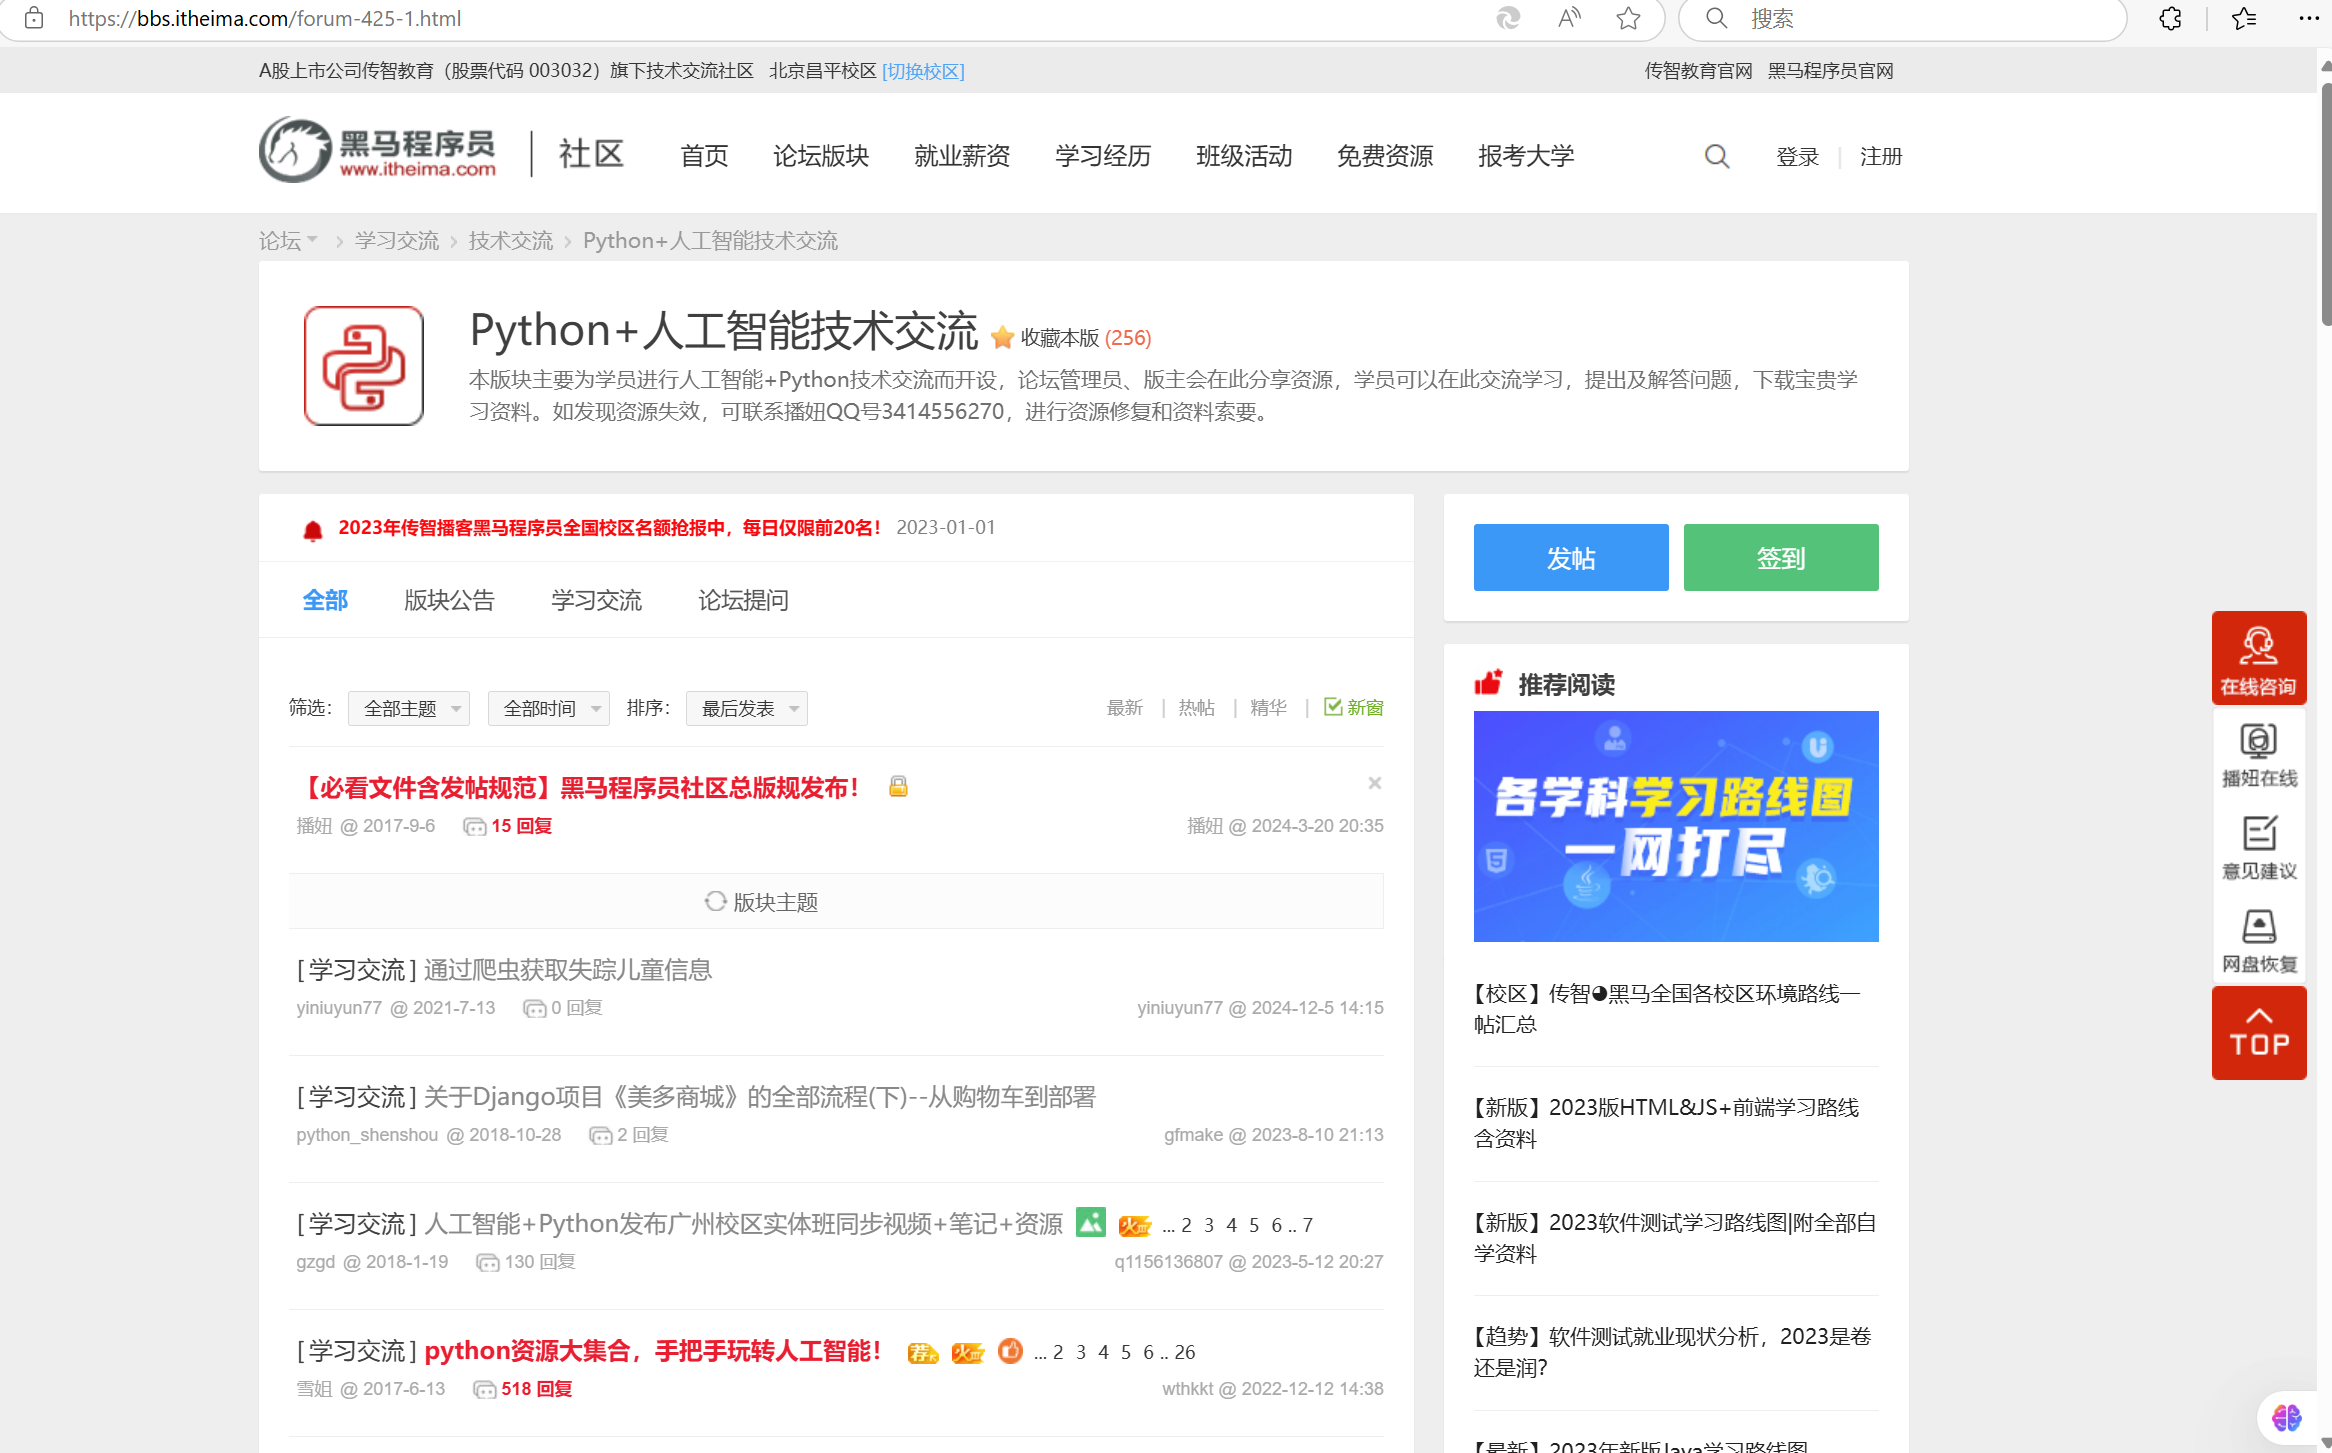
Python+人工智能技术交流板块页面:python技术交流论坛
-
实验要求:
打开Python+人工智能技术交流板块页面,每个帖子都以相同的布局方式显示了详细的信息,包括文章标题、发布时间、文章作者等。通过爬虫技术采集文章的标题、文章的链接、文章作者和发布时间。
-
总体代码:
方法一:lxml库解析网页数据
import requests
import json
from lxml import etree

# 请求的 URL 和头信息
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36 Edg/130.0.0.0',
}

def load_page(url):
    response = requests.get(url, headers=headers)
    if response.status_code == 200:
        return response.text
    else:
        print(f"访问失败: {response.status_code}")
        return None

def parse_html(html):
    items = []
    if html:
        # 使用 lxml 的 etree 解析 HTML
        tree = etree.HTML(html)

        # 使用 XPath 提取文章标题、链接、发布时间和作者
        articles = tree.xpath('//a[@onclick="atarget(this)" and @class="s xst"]')

        for article in articles:
            link = article.get('href')
            title = article.text.strip()  # 去除标题前后的空格

            # 找到发布时间和作者
            parent = article.getparent()
            time = parent.xpath('.//span[@style="margin-left: 0;"]/text()')
            author = parent.xpath('.//span[@style="margin-left: 5px;"]/text()')

            # 如果找不到时间或作者,打印调试信息
            if not time:
                print(f"未找到发布时间: {title}")
            if not author:
                print(f"未找到作者: {title}")

            item = {
                "文章链接": link,
                "文章标题": title,
                "发布时间": author[0].strip() if author else None,
                "文章作者": time[0].strip() if time else None,
            }
            items.append(item)
    return items

def save_file(items):
    try:
        with open('D:\\1.json', mode='w+', encoding='utf-8') as f:
            f.write(json.dumps(items, ensure_ascii=False, indent=2))
    except Exception as e:
        print(e)

def heima_forum(begin_page, end_page):
    li_data = []
    for page in range(begin_page, end_page + 1):
        url = f'https://bbs.itheima.com/forum-425-{page}.html'
        print(f"正在请求第 {page} 页")
        html = load_page(url)
        if html:  # 确保 HTML 内容存在
            data = parse_html(html)
            li_data += data
        else:
            print(f"第 {page} 页加载失败,跳过该页。")
    save_file(li_data)

if __name__ == "__main__":
    begin_page = int(input("请输入起始页:"))
    end_page = int(input("请输入结束页:"))
    heima_forum(begin_page, end_page)
采集到的文章的标题、文章的链接、文章作者和发布时间
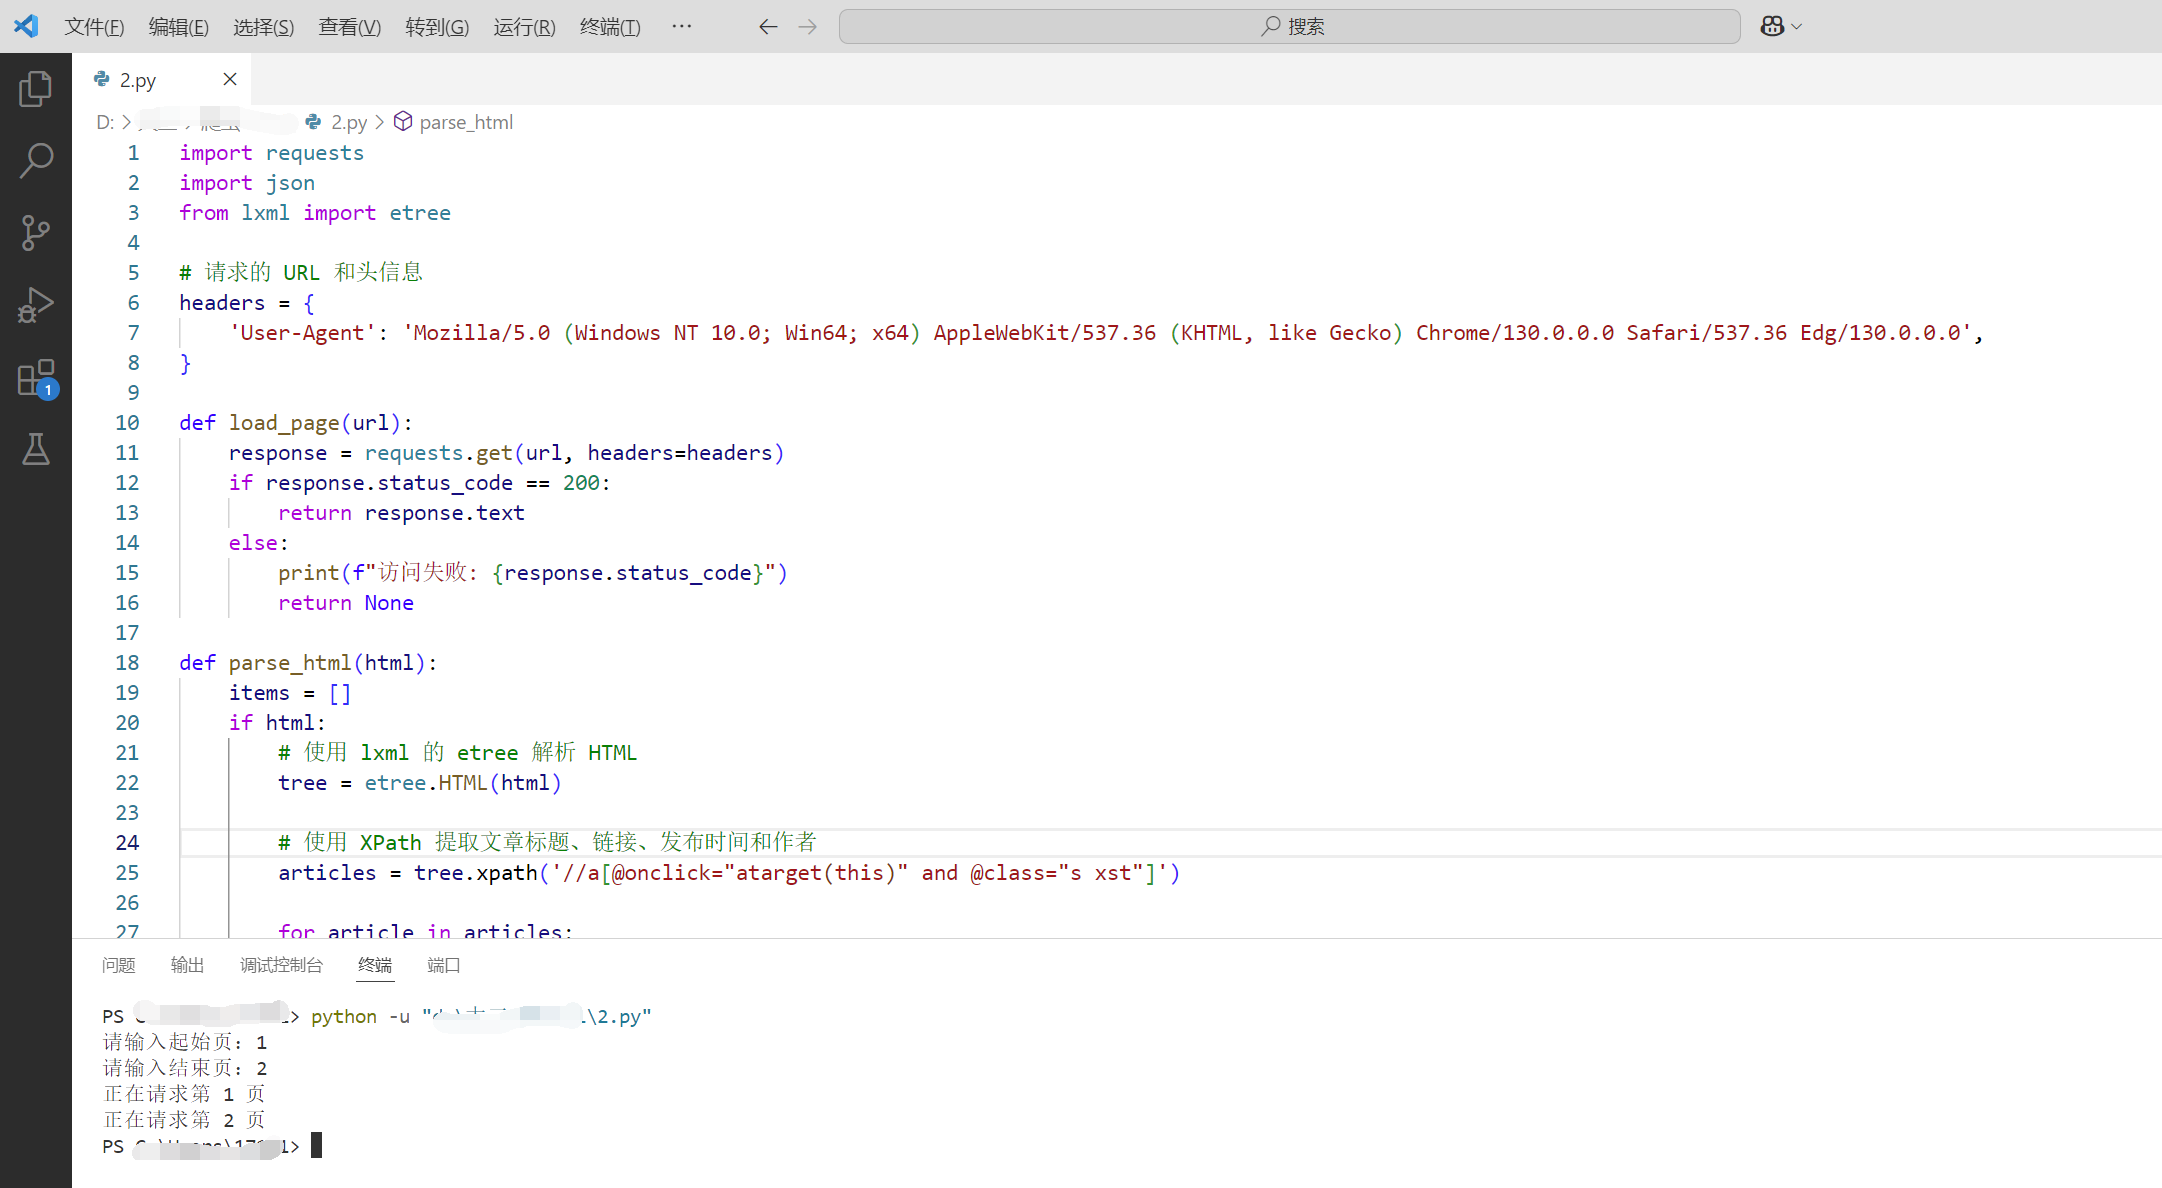
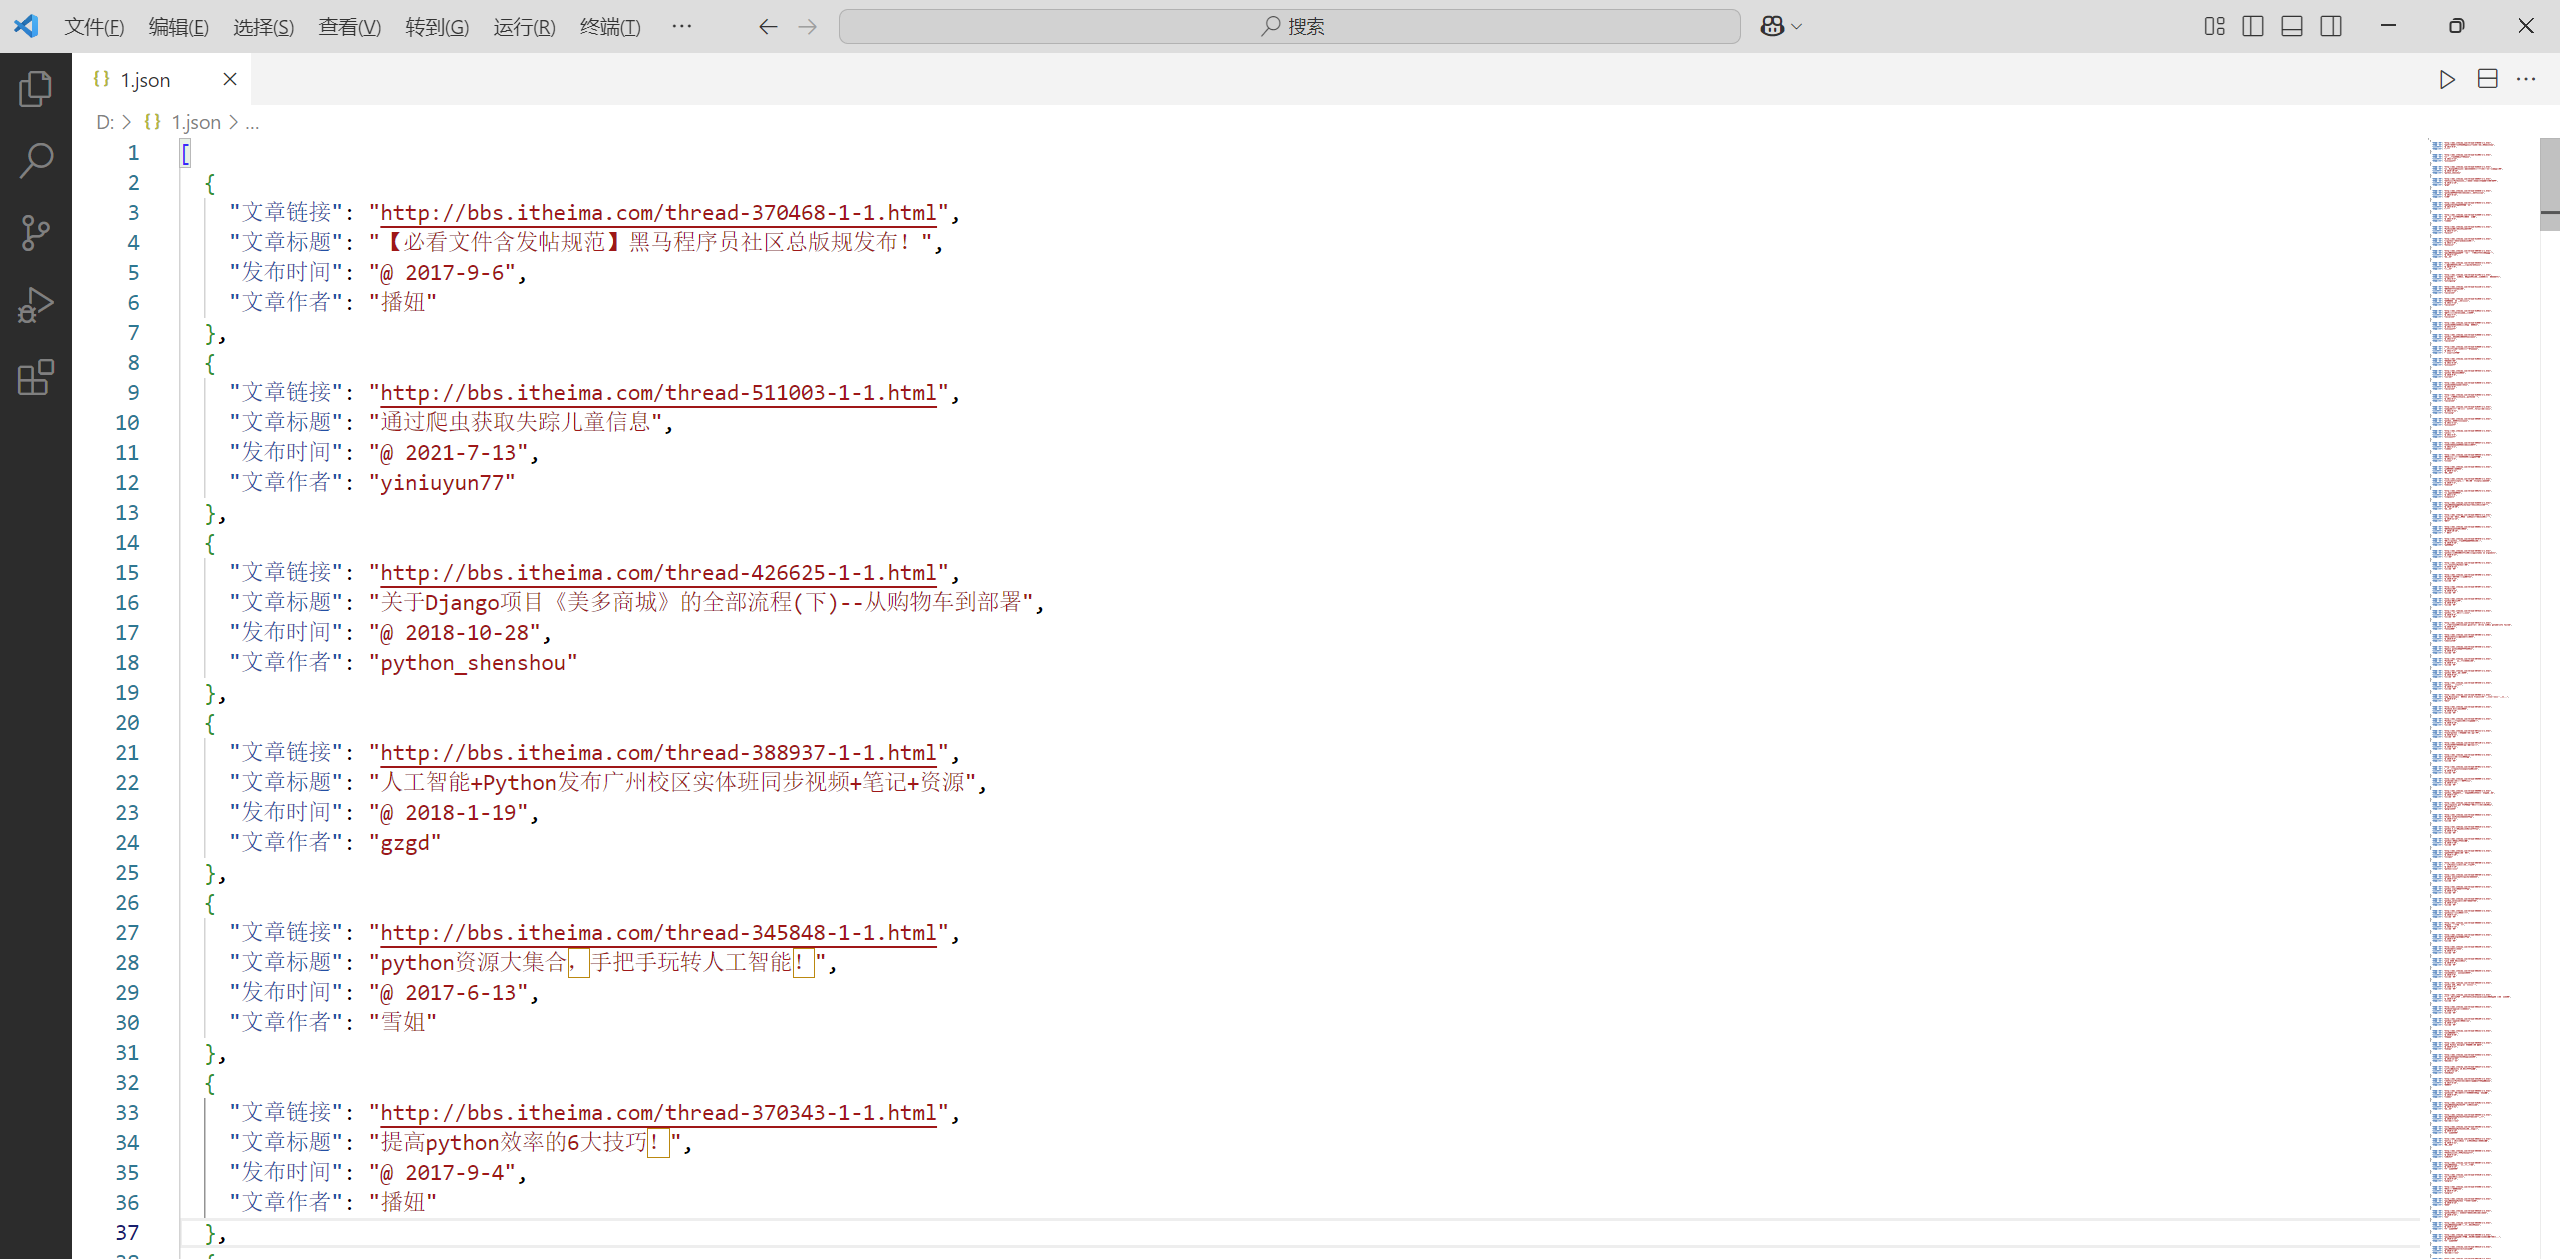
随机验证一下采集是否正确:
{
"文章链接": "http://bbs.itheima.com/thread-345848-1-1.html",
"文章标题": "python资源大集合,手把手玩转人工智能!",
"发布时间": "@ 2017-6-13",
"文章作者": "雪姐"
}
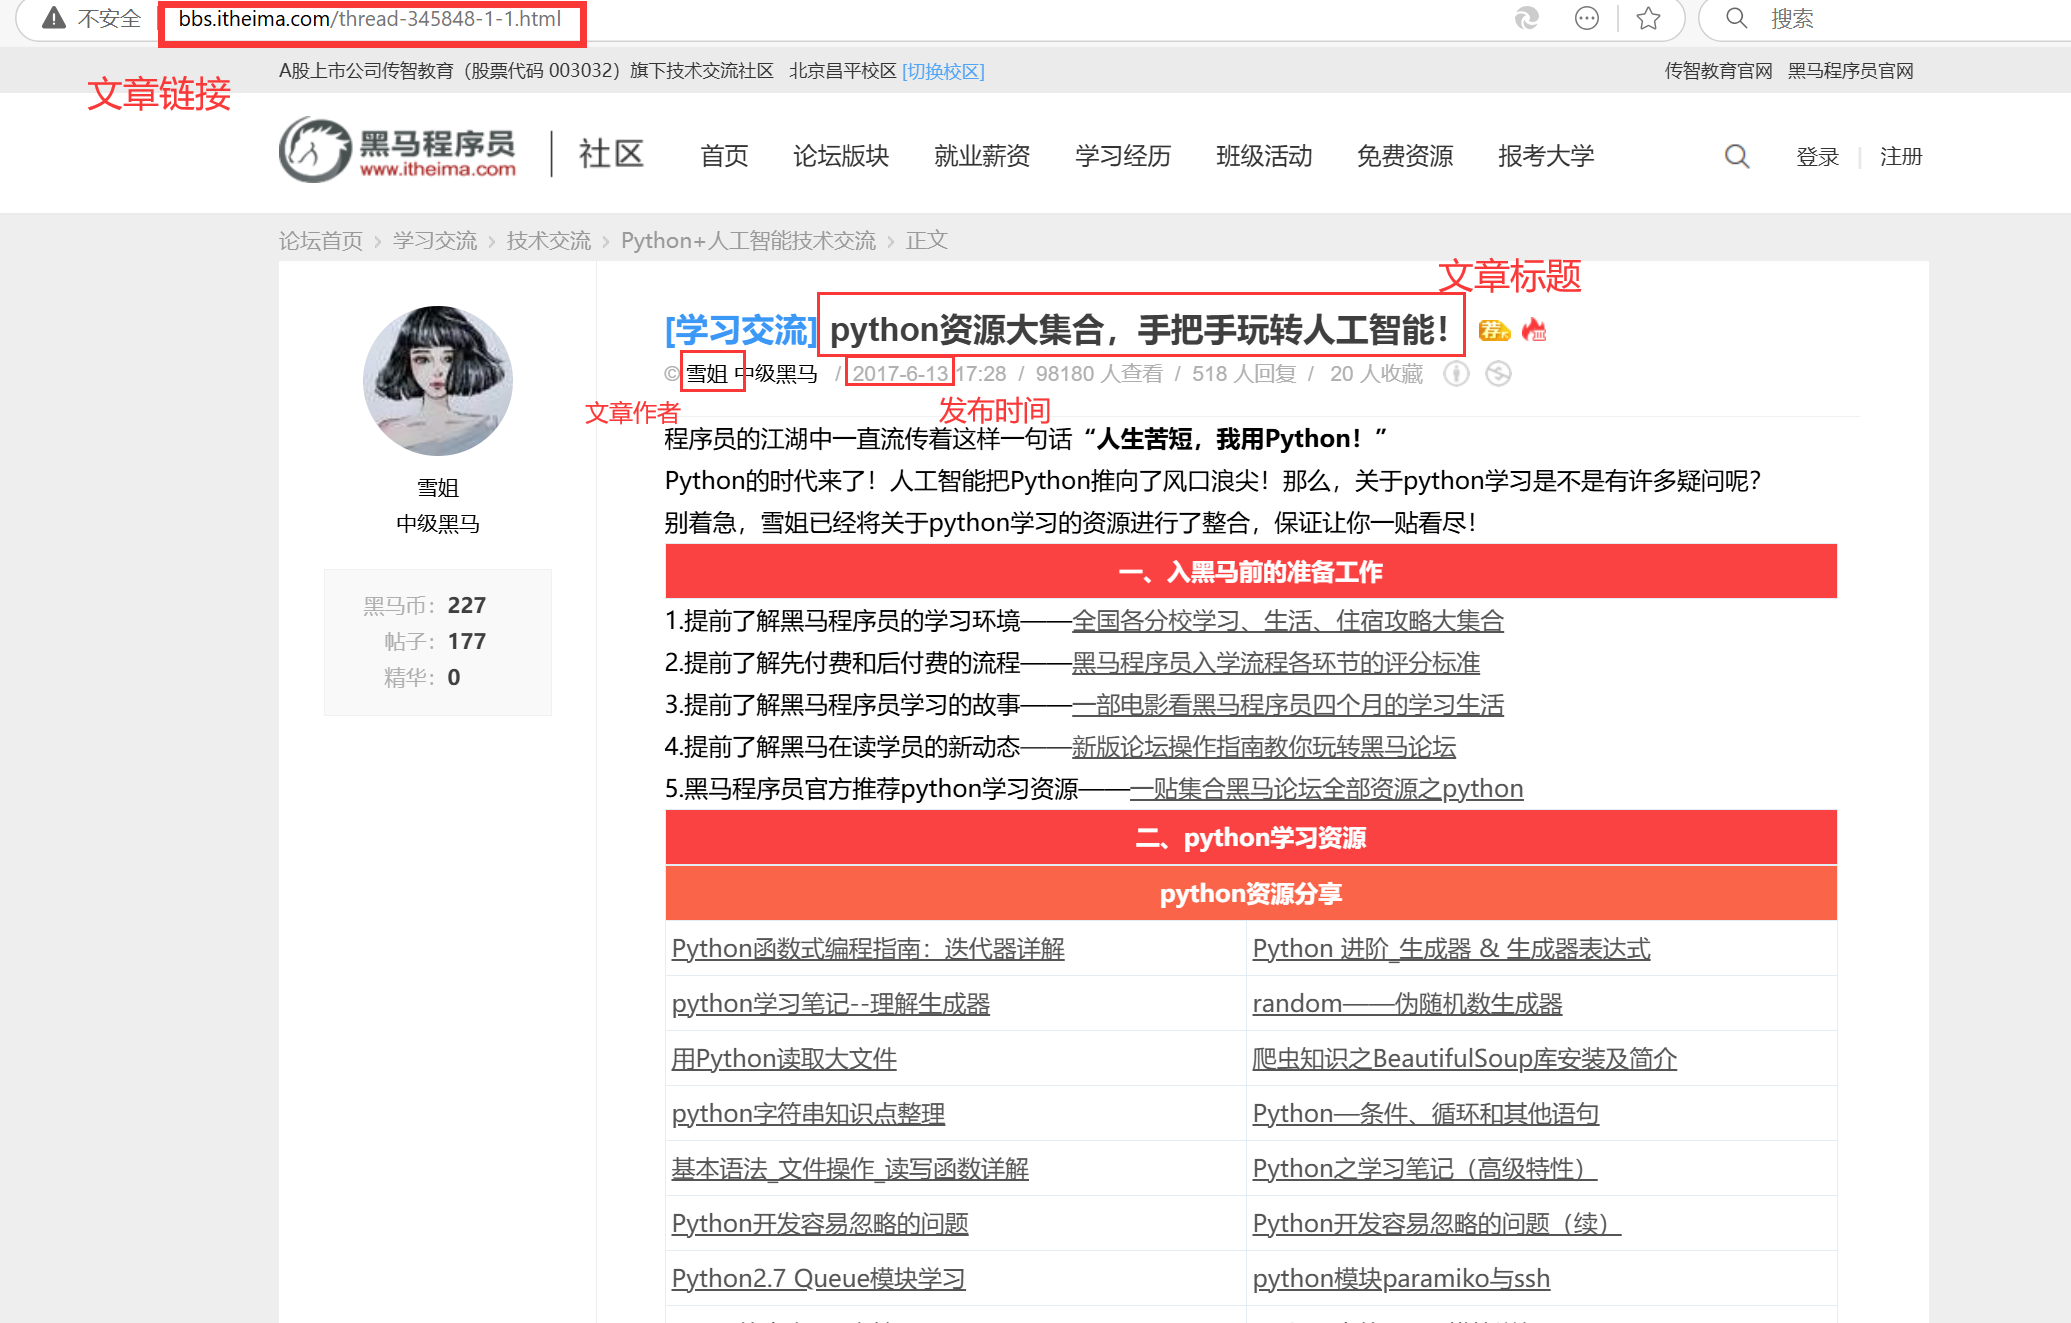 采集正确
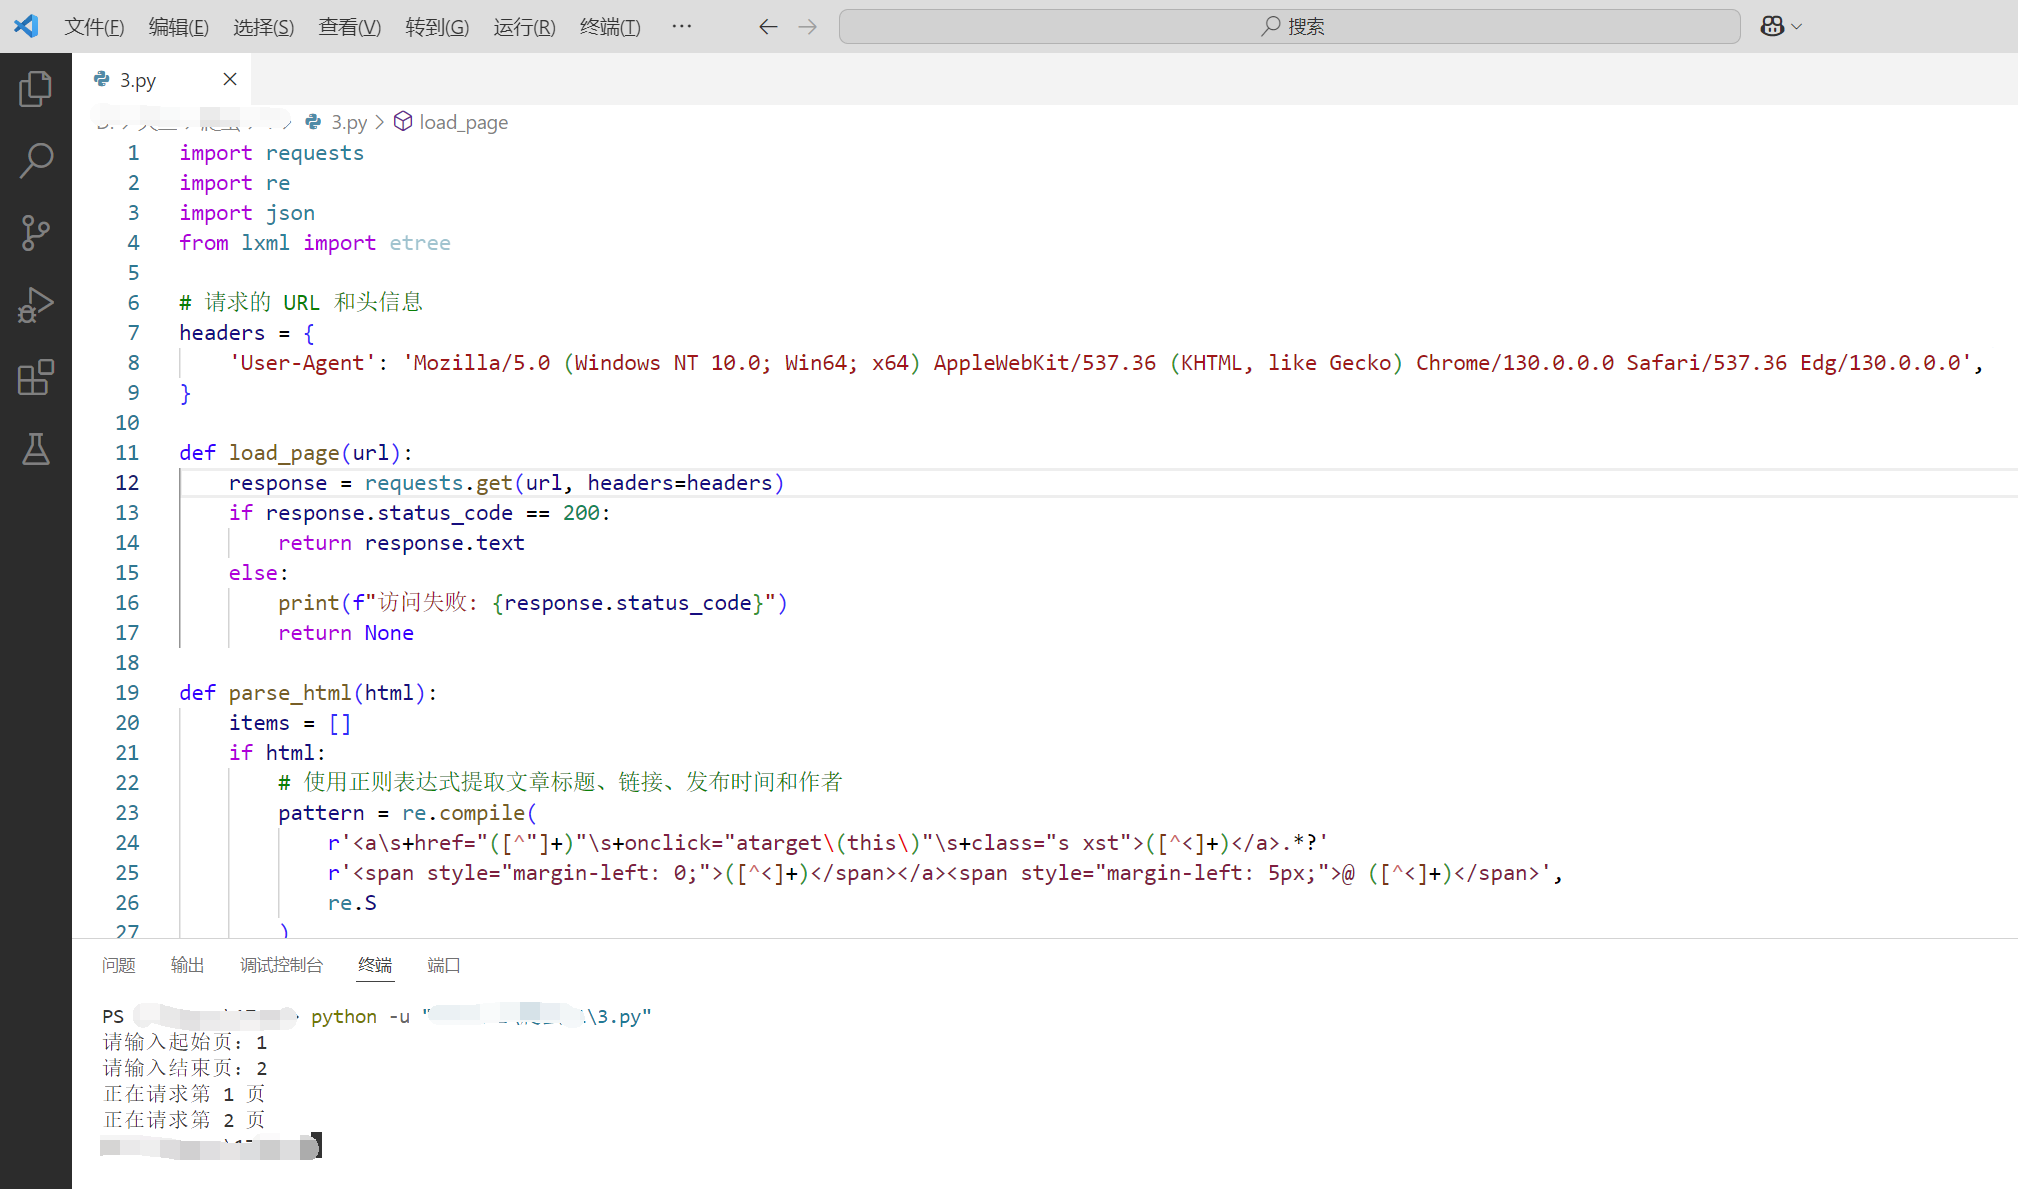
方法二:正则表达式import requests import re import json from lxml import etree # 请求的 URL 和头信息 headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36 Edg/130.0.0.0', } def load_page(url): response = requests.get(url, headers=headers) if response.status_code == 200: return response.text else: print(f"访问失败: {response.status_code}") return None def parse_html(html): items = [] if html: # 使用正则表达式提取文章标题、链接、发布时间和作者 pattern = re.compile( r'<a\s+href="([^"]+)"\s+onclick="atarget\(this\)"\s+class="s xst">([^<]+)</a>.*?' r'<span style="margin-left: 0;">([^<]+)</span></a><span style="margin-left: 5px;">@ ([^<]+)</span>', re.S ) matches = pattern.findall(html) for match in matches: item = { "文章链接": match[0], "文章标题": match[1], "文章作者": match[2], "发布时间": match[3], } items.append(item) return items def save_file(items): try: with open('D:\\1.json', mode='w+', encoding='utf-8') as f: f.write(json.dumps(items, ensure_ascii=False, indent=2)) except Exception as e: print(e) def heima_forum(begin_page, end_page): li_data = [] for page in range(begin_page, end_page + 1): url = f'https://bbs.itheima.com/forum-425-{page}.html' print(f"正在请求第 {page} 页") html = load_page(url) data = parse_html(html) li_data += data save_file(li_data) if __name__ == "__main__": begin_page = int(input("请输入起始页:")) end_page = int(input("请输入结束页:")) heima_forum(begin_page, end_page)采集到的文章的标题、文章的链接、文章作者和发布时间
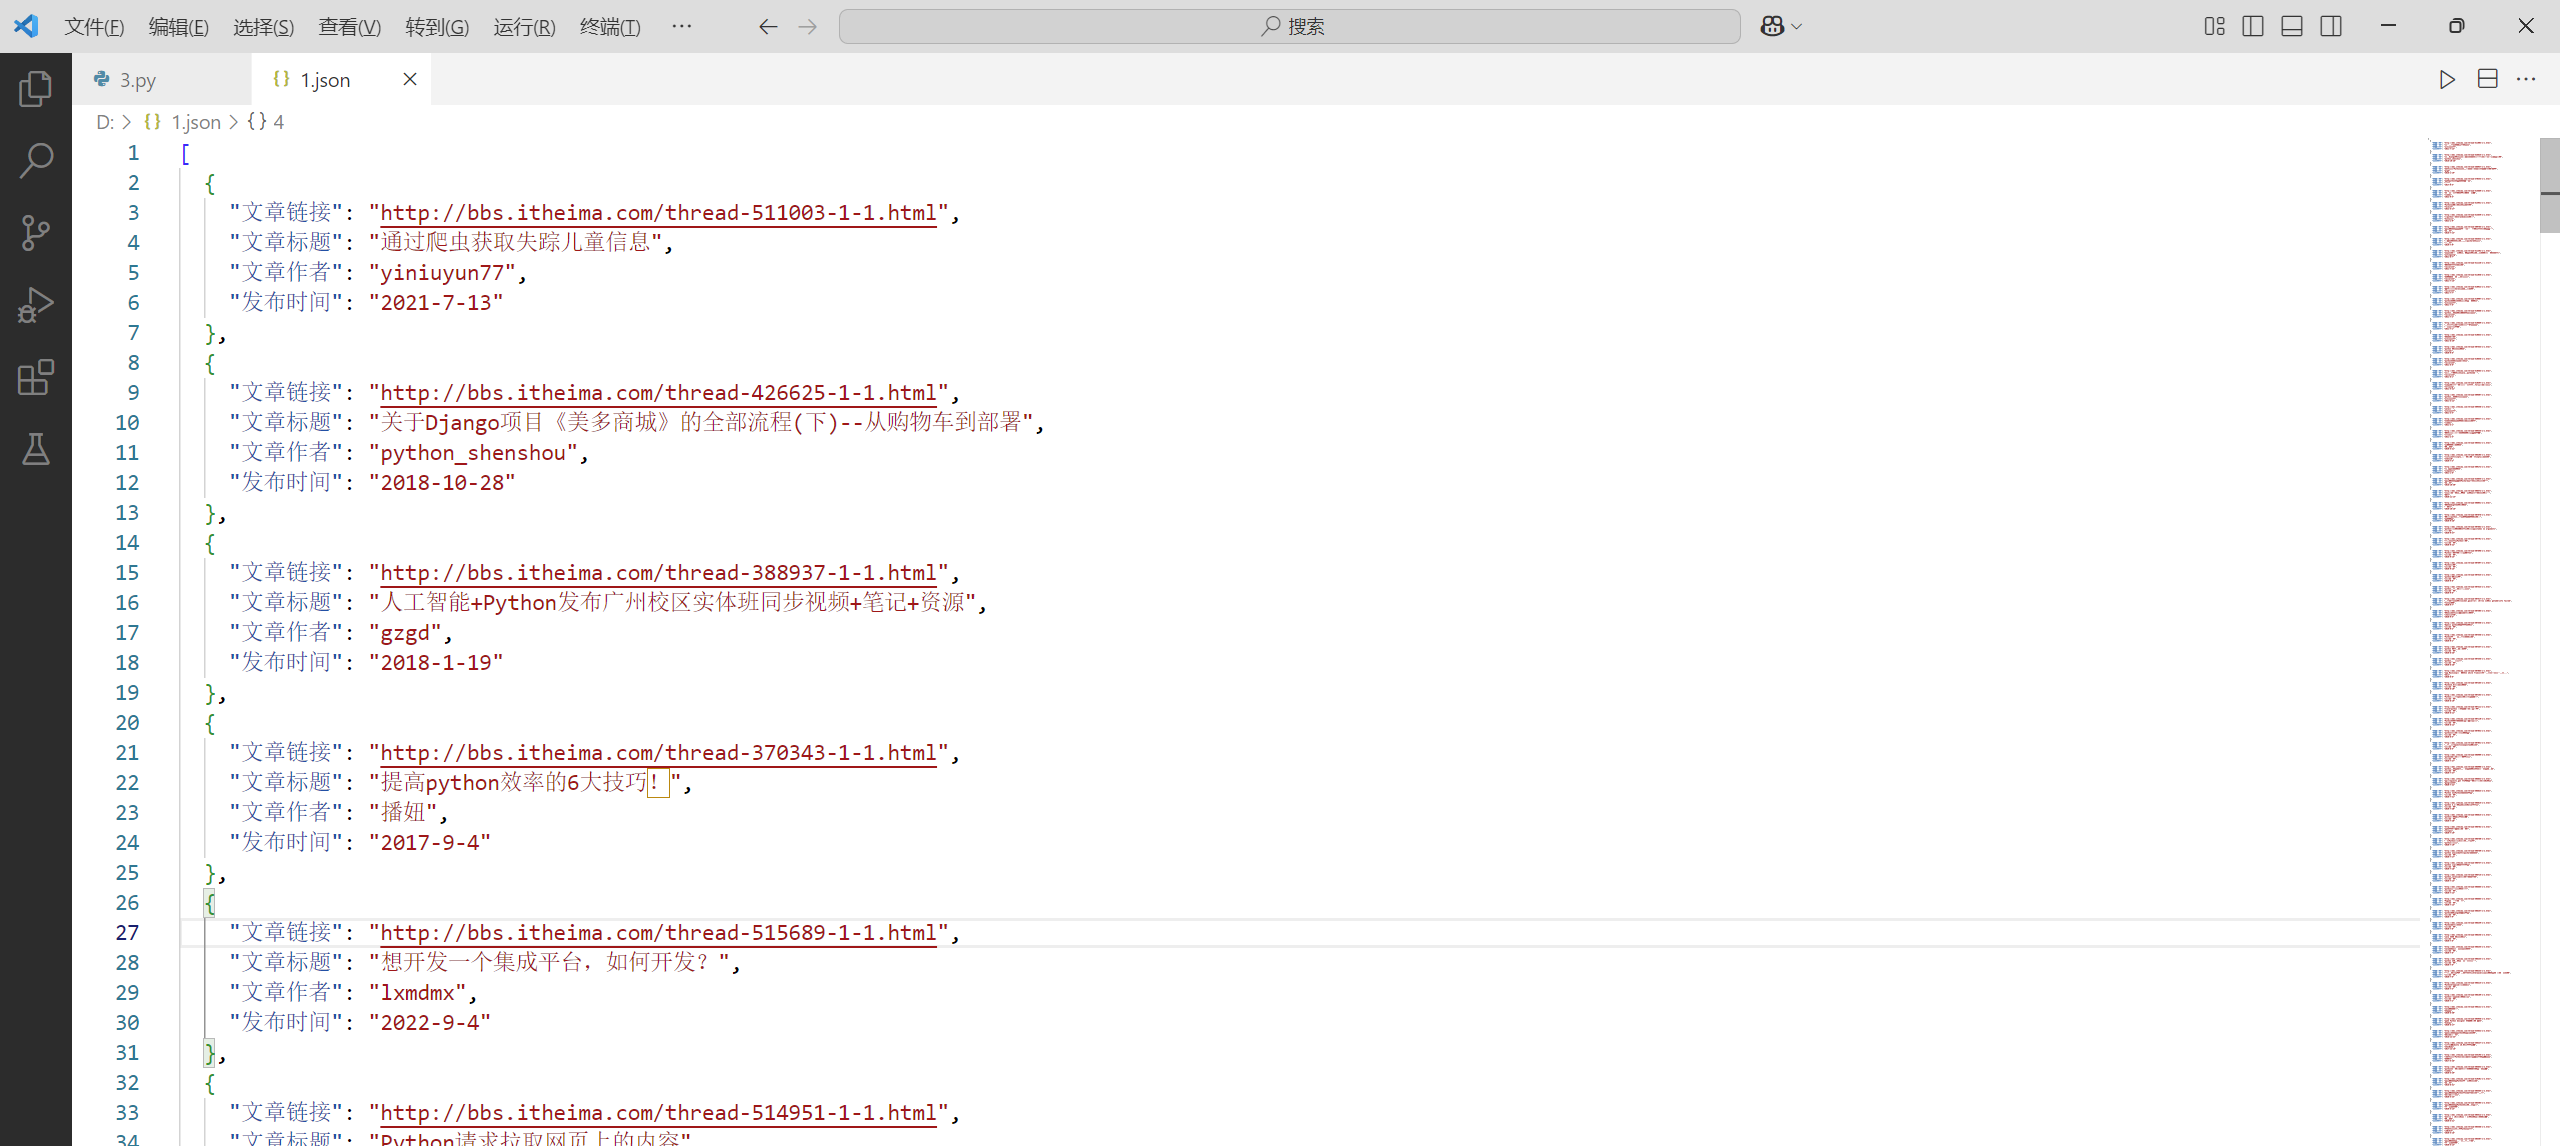
随机验证一下采集是否正确:
{
"文章链接": "http://bbs.itheima.com/thread-515689-1-1.html",
"文章标题": "想开发一个集成平台,如何开发?",
"文章作者": "lxmdmx",
"发布时间": "2022-9-4"
}
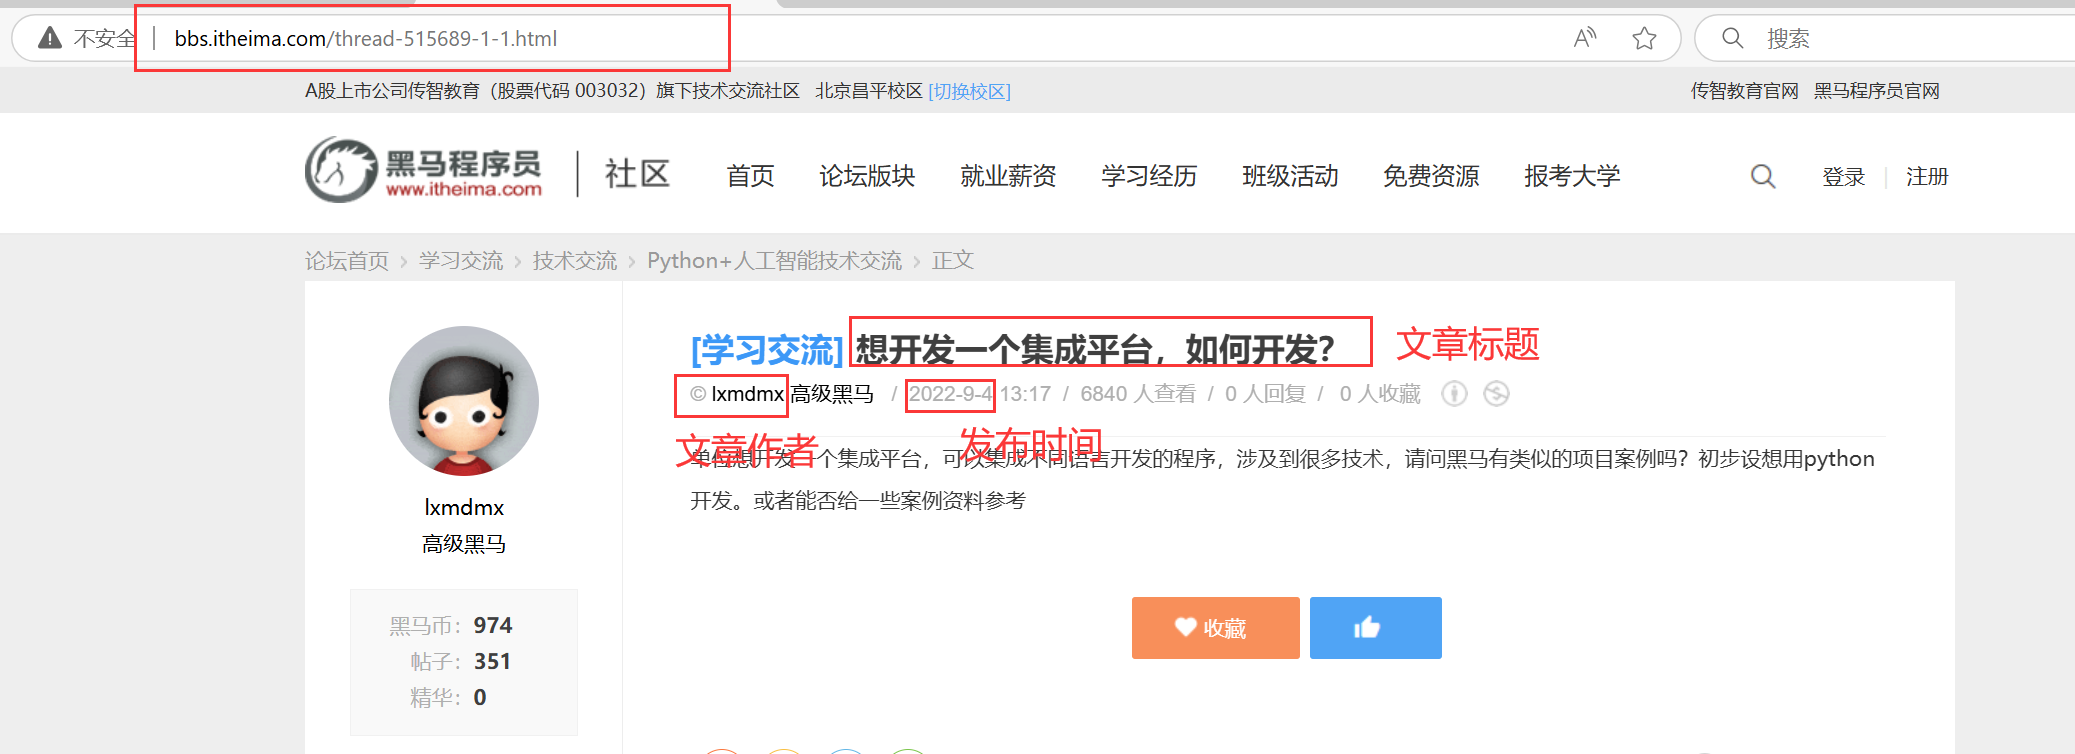 采集正确
相关推荐
周启应 2.docx
或者采集黑马程序员论坛Python+人工智能技术交流板块的帖子信息,包括文章标题、文章链接、作者和发布时间。
黑马程序员2018python爬虫课件完整版
黑马程序员作为知名的IT教育机构,其2018年的Python爬虫课程旨在教授学员如何有效地抓取和处理网络上的信息。在这个完整的课程中,你将深入理解Python爬虫的基本原理,并学习到一系列实用的技巧。
解析Python网络爬虫_复习大纲.docx
网络爬虫,又称网页蜘蛛、网络机器人,是一种按照一定的规则,自动请求万维网网站并提取网络数据的程序或脚本。2. 请简述通用爬虫和聚焦爬虫的区别。
基于B站黑马程序员Python教程整理笔记
B站黑马程序员的Python教程涵盖基础、进阶知识与实战项目。基础部分包括变量、运算符等;进阶涉及文件操作、正则表达式等高级特性;实战项目有网页爬虫、数据分析等。学习该教程可建立扎实编程基础,应对实际
黑马程序员Python学习路线图.jpg
黑马程序员Python学习路线图;Python基础、Python高级、前端开发、Web开发、爬虫开发、自动化运维




