

 智能硬件

浪潮信息元脑R1服务器:单机突破DeepSeek 671B全参数部署难题
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
作为全球领先的AI计算解决方案提供商,浪潮信息持续推动技术创新,于2月11日正式发布元脑R1推理服务器。该产品通过浪潮信息自主研发的系统架构优化与软硬协同设计,成功实现单机部署DeepSeek R1 671B全参数模型,显著降低企业部署门槛。浪潮信息此次创新不仅突破了大模型推理的显存瓶颈,更通过元脑R1服务器的卓越性能,为金融、制造等千行百业提供了高效可靠的智能算力支撑。
当前,DeepSeek开源多版本模型,助力各行业加速应用大模型技术推动业务升级转型。其中,DeepSeek R1 671B模型作为全参数基础大模型,相比蒸馏模型具有更强的泛化能力、更高的准确性和更好的上下文理解能力,但也对系统显存容量、显存带宽、互连带宽和延迟提出了更高要求:在FP8精度下至少需要约800GB显存承载,FP16/BF16精度下需要1.4TB以上的显存空间;此外,DeepSeek R1是典型的长思维链模型,具有短输入、长输出的应用特点,推理解码阶段依赖更高的显存带宽和极低的通信延迟。面向671B模型的算力特征和系统需求,元脑R1推理服务器提供领先的显存容量、显存带宽和通信速度,能够助力企业高效完成DeepSeek全参数模型的本地化部署。
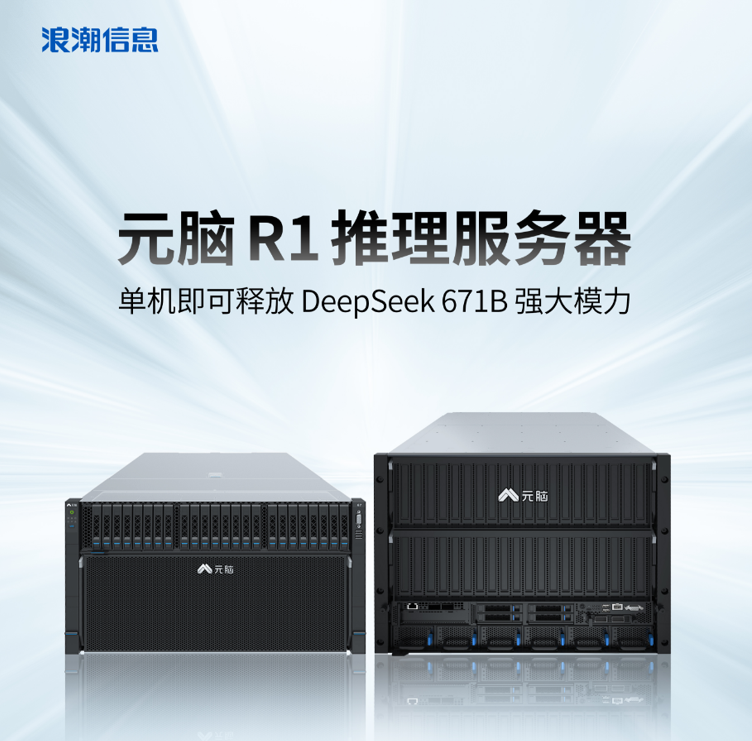
元脑R1推理服务器NF5688G7是领先的高算效AI计算平台,原生搭载FP8计算引擎,针对DeepSeek R1 671B模型部署速度快且无精度损失。在显存方面,提供1128GB HBM3e高速显存,满足671B模型 FP8精度下不低于800GB显存容量的需求,单机支持全量模型推理情况下,仍保留充足的KV缓存空间。显存带宽高达4.8TB/s,完美契合DeepSeek R1模型"短输入长输出、显存带宽敏感"的技术特征,在推理解码阶段可实现极致加速。在通信方面,GPU P2P带宽达900GB/s,保障单机部署张量并行最佳通讯性能,基于最新推理框架单机可支持20-30用户并发。同时,单台NF5688G7配备3200Gbps无损扩展网络,可根据用户业务需求增长实现敏捷扩展,提供成熟的R1服务器集群Turnkey解决方案。
元脑R1推理服务器NF5868G8是专为大推理模型(Large Reasoning Model)创新设计的高吞吐推理服务器,业界首次实现单机支持16张标准PCIe双宽卡,提供高达1536GB显存容量,支持在FP16/BF16精度下单机部署DeepSeek 671B模型。创新研发基于PCIe Fabric的16卡全互连拓扑,任意两卡P2P通信带宽可达128GB/s,降低通信延迟超60%。通过软硬协同优化,相较传统2机8卡PCIe机型,NF5868G8可将DeepSeek 671B模型推理性能提升近40%,目前已支持多元AI加速卡选配。
浪潮信息作为新一代智算架构的引领者,始终致力于通过元脑生态体系构建开放多元的AI基础设施。通过持续加码AI计算平台、资源平台和算法平台的研发投入,浪潮信息已形成完整的元脑智算产品矩阵。值得关注的是,浪潮信息正携手元脑生态合作伙伴,共同推动包括元脑R1服务器在内的创新成果在智能制造、智慧城市等领域的规模化应用落地。
相关推荐
DeepSeek-R1研究论文[源码]
DeepSeek-R1是一项突破性的研究成果,通过强化学习(RL)激励大型语言模型(LLMs)的推理能力,无需监督微调(SFT)作为初步步骤。该研究开发了DeepSeek-R1-Zero和DeepSeek-R1两个模型,前者直接在基础模型上应用RL训练,展现出自验证、反思和生成长链思维等能力;后者通过引入冷启动数据解决了前者的不足。团队还开源了六个基于Llama和Qwen的蒸馏模型,其中DeepSeek-R1-Distill-Qwen-32B在多项基准测试中表现优异。DeepSeek-R1采用混合专家(MoE)架构,总参数量为671B,激活参数量为37B,上下文长度为128K。模型在数学、代码和推理任务上表现卓越,尤其在MMLU、DROP等基准测试中名列前茅。研究还提供了详细的运行指南和配置建议,支持商业使用并采用MIT License授权。
sglang是如何运行?
SGLang通过软硬协同优化与全栈设计,实现了从缓存管理、解码加速到多模态支持的全面突破。高效运行时:RadixAttention与推测解码降低计算冗余;灵活前端:DSL支持复杂逻辑与并行控制;硬件适配:量化、并行策略与高性能内核释放GPU潜力。这些特性使其成为当前开源社区中性能领先的LLM推理引擎,适用于高并发、低延迟的工业级场景。
HCIP - Al Solution 华为认证—— 2、人工智能基础
AI发展跨越拐点,从专用走向通用专用领域(2020年前):AI主要用于感知和理解世界,核心是对数据进行分析并给出建议。通用领域(2020年后):AI转向生成和创造世界,核心是合成数据并创造新结果。转折点:Stable Diffusion(图像生成)标志着从专用走向通用的关键节点。后续发展:从图像生成扩展到文本生成、图像交互、视频生成(如Sora)。AI里程碑事件:1956年:达特茅斯会议提出“人工智能”概念。1997年:深蓝机器人战胜人类(围棋)。
本地部署DeepSeek-R1微信机器人[可运行源码]
本文详细介绍了如何基于本地部署的DeepSeek-R1大模型实现微信智能聊天机器人。主要内容包括三个步骤:本地部署Ollama工具、下载并配置DeepSeek-R1模型、以及通过NGCBot项目接入微信。文章提供了详细的安装指南和配置说明,包括如何选择适合自己电脑配置的模型版本(从1.5B到671B不等),如何修改环境变量和安装路径,以及如何解决微信版本兼容性问题。最后还介绍了NGCBot的配置设置和常见问题解答,帮助读者快速搭建属于自己的本地AI聊天机器人。
DeepSeek-R2前瞻[代码]
文章主要探讨了DeepSeek即将发布的R2模型及其相关技术进展。作者通过分析DeepSeek官方发布的论文,介绍了新的DeepSeek-GRM模型,该模型以27B参数实现了与R1模型671B参数相当的性能,显著降低了训练和推理阶段的硬件消耗。文章详细对比了GRM与R1在推理、训练和硬件消耗方面的差异,并指出GRM模型有望在边缘设备上部署。此外,文章还介绍了GRM模型的关键技术SPCT(自原则批评调优),并展望了R2模型可能带来的技术突破。最后,作者分享了大模型AI的学习路径和资源,为读者提供了从初阶到高阶的完整学习指南。





