

 2025年北航面向对象设计与构造

BUAA_OO_UNIT1 总结
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
BUAA_OO_UNIT1 总结
一、程序结构分析
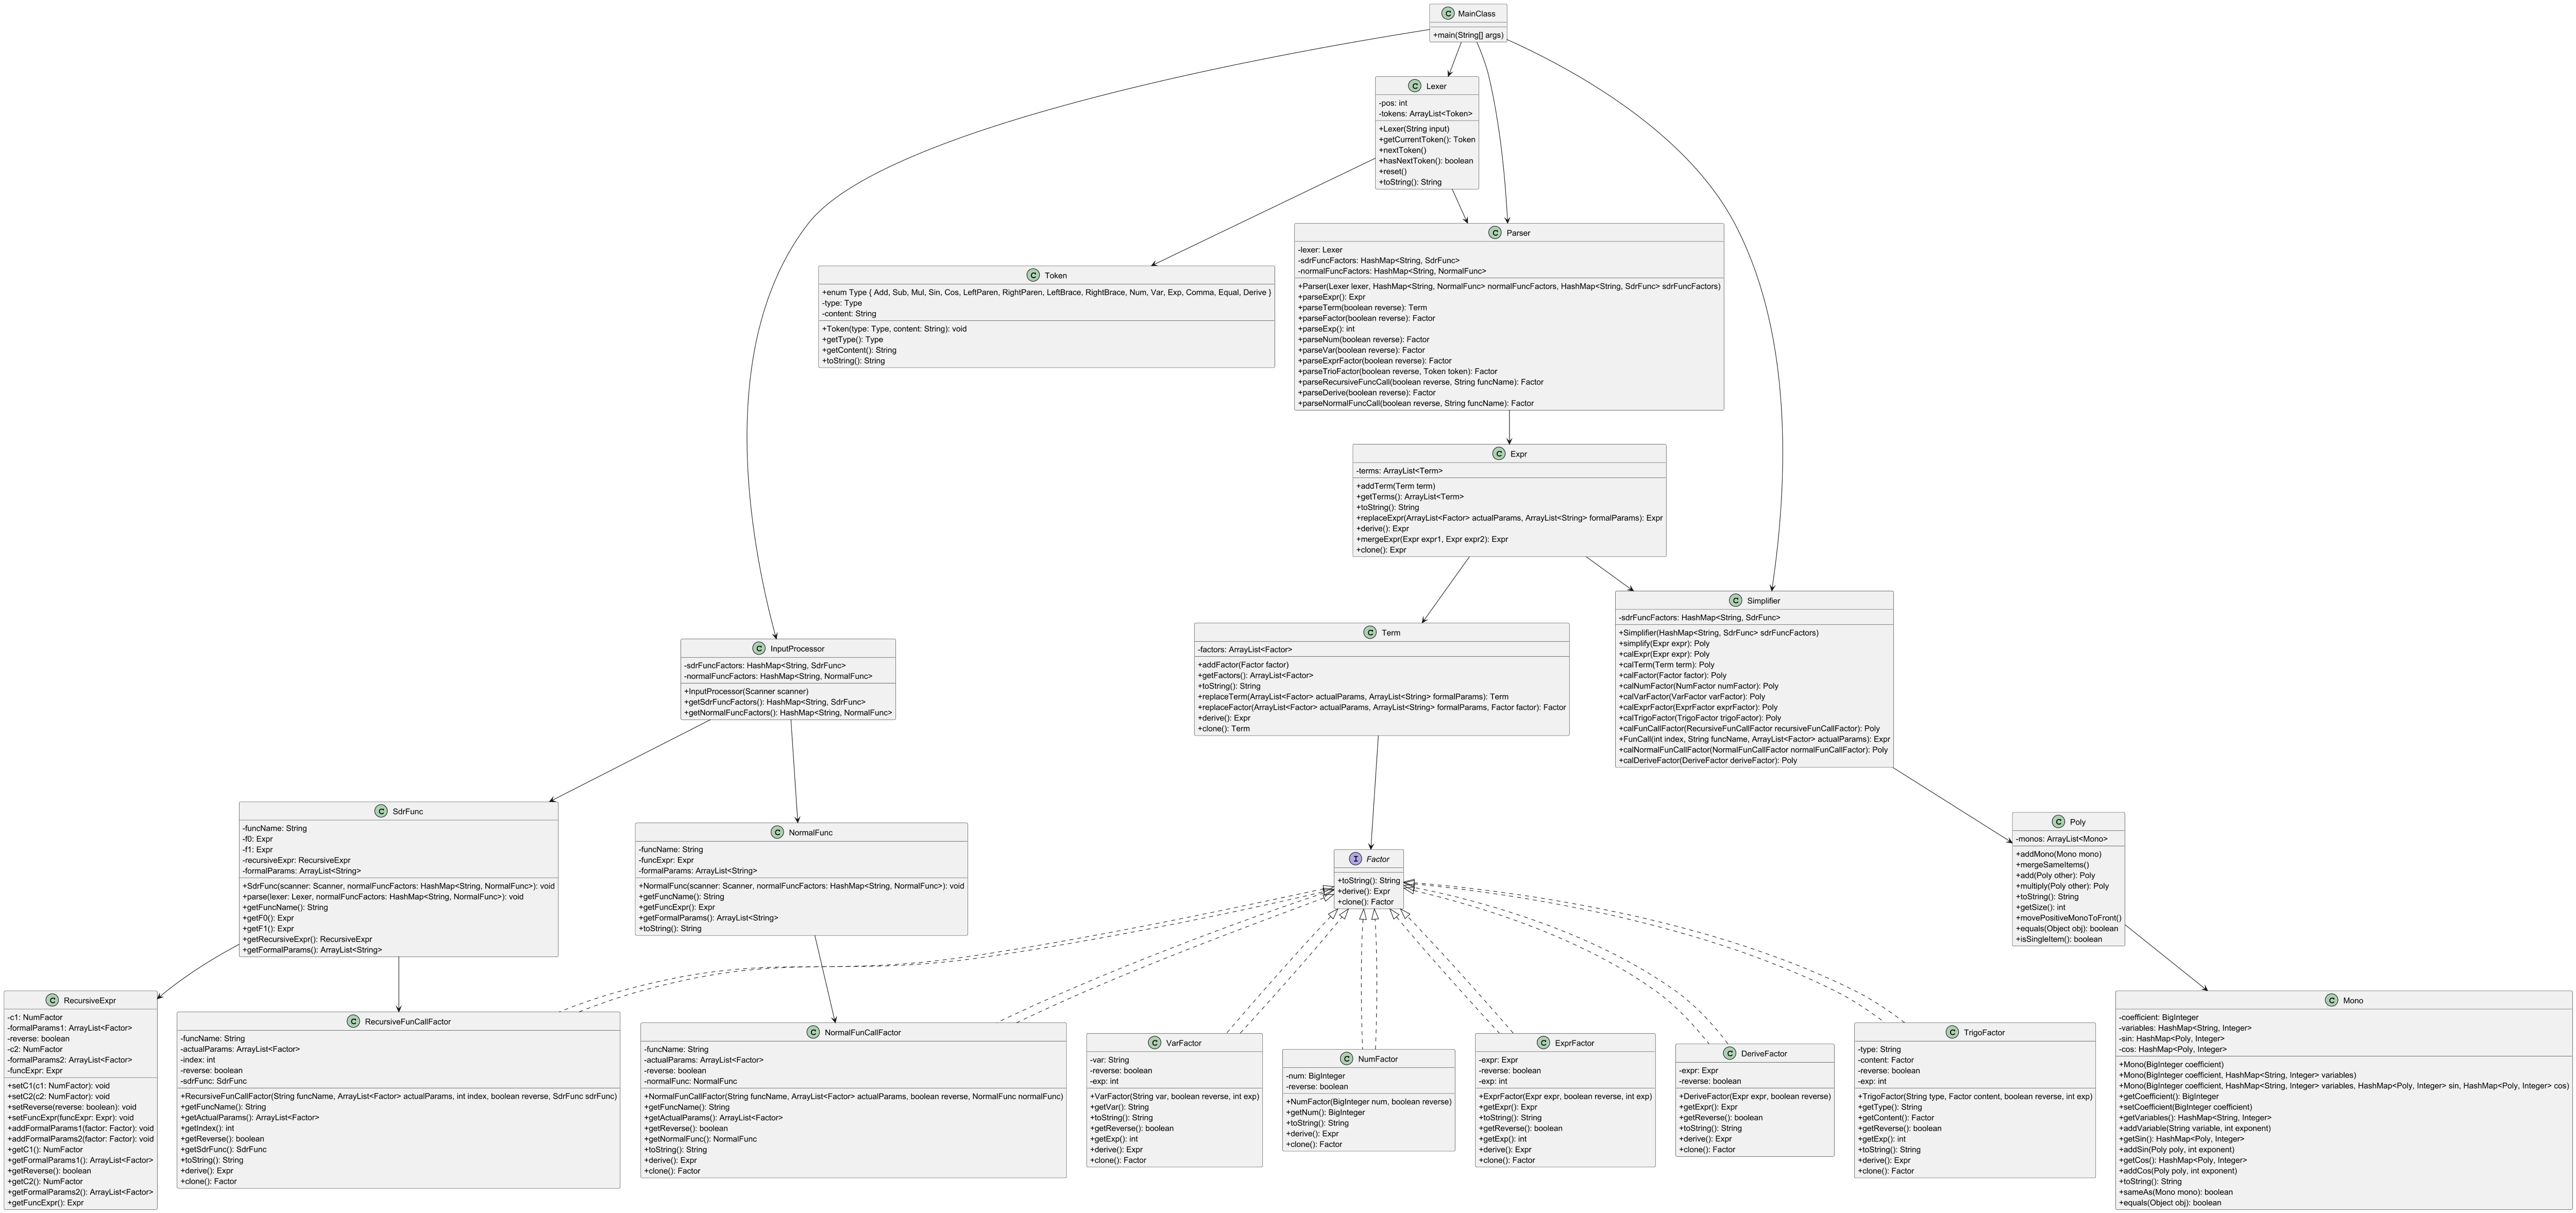
UML类图
-
MainClass:程序的入口,负责调用InputProcessor、Lexer、Parser、Simplifier类进行表达式的解析输入和化简计算
-
InputProcessor:负责预处理并保存自定义递推函数和自定义普通函数的定义,该类的实例化对象中将储存含有已定义好的自定义递推函数和自定义普通函数的容器
-
Lexer:词法分析器,对输入进行初步的词法分析,除去不必要的空白字符并将输入分成一个个token
-
Parser:语法分析器,使用递归下降法对Lexer生成的tokens进行进一步的语法分析,生成最终的Expr类
-
Simplifier:化简器,负责将表达式转化成多项式,并化简
-
NormalFunc:自定义普通函数。该类储存了一个自定义普通函数的全部信息,包括函数名和形参列表以及定义的函数表达式
-
SdrFunc:自定义递推函数。该类储存了一个自定义递推函数的全部信息,包括函数名、形参列表、初始定义式和递推定义式
-
RecursiveExpr:递推定义式。该类储存了一个递推定义式,包括c1,f{n-1}的形参列表、c2、f{n-2}的形参列表和一个函数表达式
-
Token:词元。该类记录了一个token的type和content
-
Expr:表达式类。含有一个term容器
-
Term:项类。含有一个Factor容器
-
Factor:因子接口。定义了clone、toString、derive三个方法
-
NumFactor:常数因子
-
VarFactor:变量因子(幂函数因子),含指数和变量名
-
ExprFactor:表达式因子,含表达式和指数
-
RecursiveFunCallFactor:自定义递推函数因子,含函数名、序号和实参列表
-
TrigoFactor:三角函数因子,含三角函数名、表达式和指数
-
NormalFunCallFactor:自定义普通函数因子,含函数名、实参列表
-
DeriveFatcor:求导因子
-
Poly:多项式,含mono容器,并提供多项式相加,相乘,合并同类项等多种方法
-
Mono:单项式,形如 c \times x^{m}y^{n}...\times sin^{t_1}(poly_1)sin^{t_2}(poly_2)...\times cos^{t_1}(poly_1)cos^{t_2}(poly_2)... 的形式,含有系数,幂函数容器,三角函数容器
度量分析
-
类的代码量分析
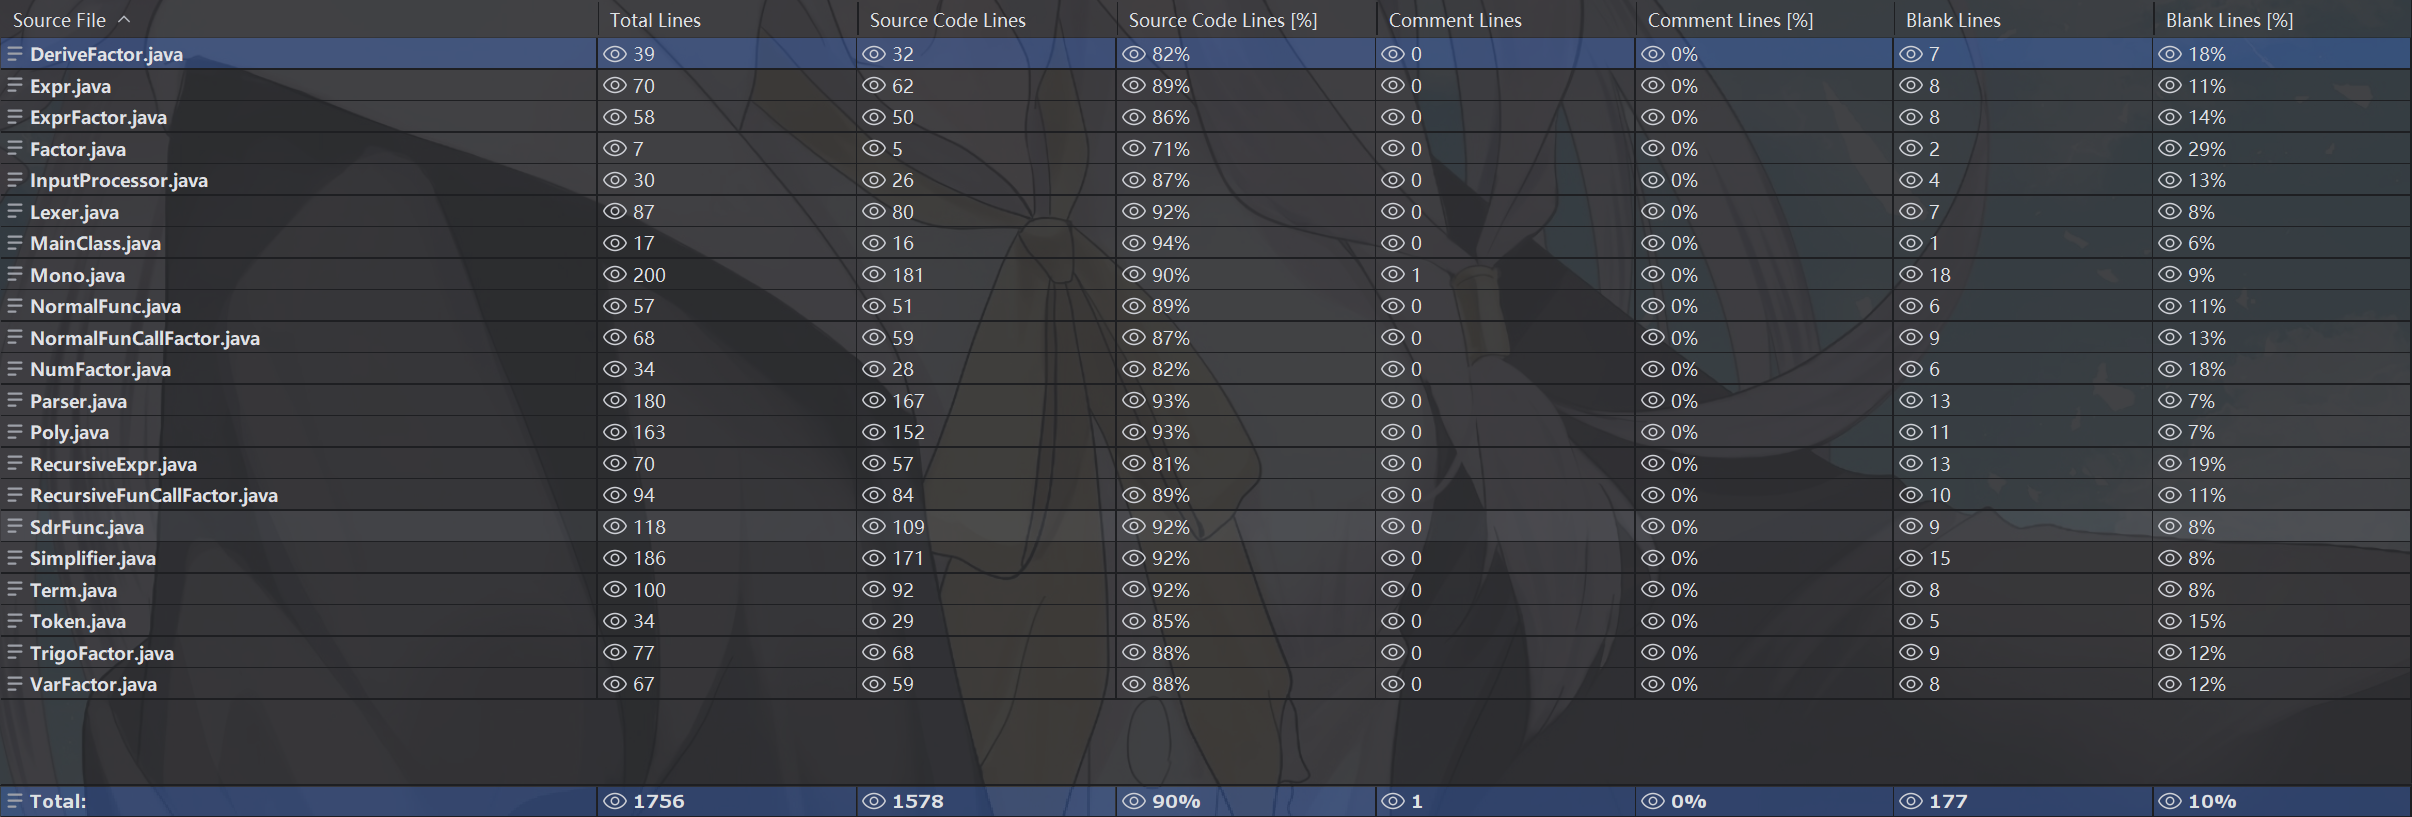
代码总行数达到了1500+,其中Mono类的总行数最多,是因为其中的toString函数中既有多次对容器的遍历,又有较多的if-else判断语句,用于特判各种输出情况,是一个可以进行优化的地方,还有个sameAs用于判断同类项的方法也较为复杂;再者是Parser和Simplifier两个类,一个是对输入采用递归下降法进行解析的类,一个是将解析完的表达式转化成多项式并化简的类,主要是Factor种类较多,导致每种Factor都要写一个parser方法和cal方法,进而使得这两个类代码规模较大
-
类的代码复杂度分析
Class OCavg OCmax WMC DeriveFactor 1.17 2 7 Expr 1.86 3 13 ExprFactor 1.29 2 9 InputProcessor 1.67 3 5 Lexer 4.33 19 26 MainClass 1 1 1 Mono 3.57 19 50 NormalFunCallFactor 1.38 3 11 NormalFunc 1.8 3 9 NumFactor 1.4 2 7 Parser 2.83 10 34 Poly 4.33 9 39 RecursiveExpr 1 1 12 RecursiveFunCallFactor 1.44 4 13 SdrFunc 3.14 14 22 Simplifier 2.85 8 37 Term 3.14 10 22 Token 1 1 4 TrigoFactor 1.5 3 12 VarFactor 1.43 3 10 Average 2.29 6.00 16.33
可见仍是Mono、Poly、Parser、Simplifier的复杂度较高,原因大致同上
-
方法复杂度分析
Method CogC ev(G) iv(G) v(G) DeriveFactor.DeriveFactor(Expr, boolean) 0 1 1 1 DeriveFactor.clone() 0 1 1 1 DeriveFactor.derive() 0 1 1 1 DeriveFactor.getExpr() 0 1 1 1 DeriveFactor.getReverse() 0 1 1 1 DeriveFactor.toString() 1 1 1 2 Expr.addTerm(Term) 0 1 1 1 Expr.clone() 1 1 2 2 Expr.derive() 1 1 2 2 Expr.getTerms() 0 1 1 1 Expr.mergeExpr(Expr, Expr) 2 3 1 3 Expr.replaceExpr(ArrayList<Factor>, ArrayList<String>) 1 1 2 2 Expr.toString() 1 1 2 2 ExprFactor.ExprFactor(Expr, boolean, int) 0 1 1 1 ExprFactor.clone() 0 1 1 1 ExprFactor.derive() 1 2 2 2 ExprFactor.getExp() 0 1 1 1 ExprFactor.getExpr() 0 1 1 1 ExprFactor.getReverse() 0 1 1 1 ExprFactor.toString() 1 1 1 2 InputProcessor.InputProcessor(Scanner) 2 1 3 3 InputProcessor.getNormalFuncFactors() 0 1 1 1 InputProcessor.getSdrFuncFactors() 0 1 1 1 Lexer.Lexer(String) 28 1 31 31 Lexer.getCurrentToken() 1 2 2 2 Lexer.hasNextToken() 0 1 1 1 Lexer.nextToken() 0 1 1 1 Lexer.reset() 0 1 1 1 Lexer.toString() 1 1 2 2 MainClass.main(String[]) 0 1 1 1 Mono.Mono(BigInteger) 0 1 1 1 Mono.Mono(BigInteger, HashMap<String, Integer>) 0 1 1 1 Mono.Mono(BigInteger, HashMap<String, Integer>, HashMap<Poly, Integer>, HashMap<Poly, Integer>) 0 1 1 1 Mono.addCos(Poly, int) 1 2 2 2 Mono.addSin(Poly, int) 1 2 2 2 Mono.addVariable(String, int) 1 2 2 2 Mono.equals(Object) 5 3 3 4 Mono.getCoefficient() 0 1 1 1 Mono.getCos() 0 1 1 1 Mono.getSin() 0 1 1 1 Mono.getVariables() 0 1 1 1 Mono.sameAs(Mono) 39 19 10 19 Mono.setCoefficient(BigInteger) 0 1 1 1 Mono.toString() 29 1 21 21 NormalFunCallFactor.NormalFunCallFactor(String, ArrayList<Factor>, boolean, NormalFunc) 0 1 1 1 NormalFunCallFactor.clone() 1 1 2 2 NormalFunCallFactor.derive() 0 1 1 1 NormalFunCallFactor.getActualParams() 0 1 1 1 NormalFunCallFactor.getFuncName() 0 1 1 1 NormalFunCallFactor.getNormalFunc() 0 1 1 1 NormalFunCallFactor.getReverse() 0 1 1 1 NormalFunCallFactor.toString() 3 1 3 3 NormalFunc.NormalFunc(Scanner, HashMap<String, NormalFunc>) 3 1 4 4 NormalFunc.getFormalParams() 0 1 1 1 NormalFunc.getFuncExpr() 0 1 1 1 NormalFunc.getFuncName() 0 1 1 1 NormalFunc.toString() 3 1 3 3 NumFactor.NumFactor(BigInteger, boolean) 0 1 1 1 NumFactor.clone() 0 1 1 1 NumFactor.derive() 0 1 1 1 NumFactor.getNum() 1 1 2 2 NumFactor.toString() 1 1 2 2 Parser.Parser(Lexer, HashMap<String, NormalFunc>, HashMap<String, SdrFunc>) 0 1 1 1 Parser.parseDerive(boolean) 0 1 1 1 Parser.parseExp() 1 1 2 2 Parser.parseExpr() 9 1 7 7 Parser.parseExprFactor(boolean) 2 1 3 3 Parser.parseFactor(boolean) 12 8 15 15 Parser.parseNormalFuncCall(boolean, String) 2 1 3 3 Parser.parseNum(boolean) 0 1 1 1 Parser.parseRecursiveFuncCall(boolean, String) 2 1 3 3 Parser.parseTerm(boolean) 5 1 5 5 Parser.parseTrioFactor(boolean, Token) 2 1 3 3 Parser.parseVar(boolean) 2 1 3 3 Poly.add(Poly) 2 1 3 3 Poly.addMono(Mono) 0 1 1 1 Poly.equals(Object) 17 7 5 8 Poly.getSize() 0 1 1 1 Poly.isSingleItem() 5 4 4 7 Poly.mergeSameItems() 8 4 5 5 Poly.movePositiveMonoToFront() 3 3 3 3 Poly.multiply(Poly) 27 1 9 9 Poly.toString() 9 4 4 6 RecursiveExpr.addFormalParams1(Factor) 0 1 1 1 RecursiveExpr.addFormalParams2(Factor) 0 1 1 1 RecursiveExpr.getC1() 0 1 1 1 RecursiveExpr.getC2() 0 1 1 1 RecursiveExpr.getFormalParams1() 0 1 1 1 RecursiveExpr.getFormalParams2() 0 1 1 1 RecursiveExpr.getFuncExpr() 0 1 1 1 RecursiveExpr.getReverse() 0 1 1 1 RecursiveExpr.setC1(NumFactor) 0 1 1 1 RecursiveExpr.setC2(NumFactor) 0 1 1 1 RecursiveExpr.setFuncExpr(Expr) 0 1 1 1 RecursiveExpr.setReverse(boolean) 0 1 1 1 RecursiveFunCallFactor.RecursiveFunCallFactor(String, ArrayList<Factor>, int, boolean, SdrFunc) 0 1 1 1 RecursiveFunCallFactor.clone() 1 1 2 2 RecursiveFunCallFactor.derive() 0 1 1 1 RecursiveFunCallFactor.getActualParams() 0 1 1 1 RecursiveFunCallFactor.getFuncName() 0 1 1 1 RecursiveFunCallFactor.getIndex() 0 1 1 1 RecursiveFunCallFactor.getReverse() 0 1 1 1 RecursiveFunCallFactor.getSdrFunc() 0 1 1 1 RecursiveFunCallFactor.toString() 3 1 4 4 SdrFunc.SdrFunc(Scanner, HashMap<String, NormalFunc>) 3 1 4 4 SdrFunc.getF0() 0 1 1 1 SdrFunc.getF1() 0 1 1 1 SdrFunc.getFormalParams() 0 1 1 1 SdrFunc.getFuncName() 0 1 1 1 SdrFunc.getRecursiveExpr() 0 1 1 1 SdrFunc.parse(Lexer, HashMap<String, NormalFunc>) 28 1 20 20 Simplifier.FunCall(int, String, ArrayList<Factor>) 10 4 5 5 Simplifier.Simplifier(HashMap<String, SdrFunc>) 0 1 1 1 Simplifier.calDeriveFactor(DeriveFactor) 2 1 2 2 Simplifier.calExpr(Expr) 2 2 2 3 Simplifier.calExprFactor(ExprFactor) 3 1 3 3 Simplifier.calFactor(Factor) 7 8 8 8 Simplifier.calFunCallFactor(RecursiveFunCallFactor) 2 1 2 2 Simplifier.calNormalFunCallFactor(NormalFunCallFactor) 2 1 2 2 Simplifier.calNumFactor(NumFactor) 0 1 1 1 Simplifier.calTerm(Term) 1 1 2 2 Simplifier.calTrigoFactor(TrigoFactor) 5 2 4 4 Simplifier.calVarFactor(VarFactor) 3 2 3 3 Simplifier.simplify(Expr) 0 1 1 1 Term.addFactor(Factor) 0 1 1 1 Term.clone() 1 1 2 2 Term.derive() 6 1 4 4 Term.getFactors() 0 1 1 1 Term.replaceFactor(ArrayList<Factor>, ArrayList<String>, Factor) 15 9 10 10 Term.replaceTerm(ArrayList<Factor>, ArrayList<String>) 1 1 2 2 Term.toString() 1 1 2 2 Token.Token(Type, String) 0 1 1 1 Token.getContent() 0 1 1 1 Token.getType() 0 1 1 1 Token.toString() 0 1 1 1 TrigoFactor.TrigoFactor(String, Factor, boolean, int) 0 1 1 1 TrigoFactor.clone() 0 1 1 1 TrigoFactor.derive() 3 2 3 3 TrigoFactor.getContent() 0 1 1 1 TrigoFactor.getExp() 0 1 1 1 TrigoFactor.getReverse() 0 1 1 1 TrigoFactor.getType() 0 1 1 1 TrigoFactor.toString() 2 1 3 3 VarFactor.VarFactor(String, boolean, int) 0 1 1 1 VarFactor.clone() 0 1 1 1 VarFactor.derive() 1 2 2 2 VarFactor.getExp() 0 1 1 1 VarFactor.getReverse() 0 1 1 1 VarFactor.getVar() 0 1 1 1 VarFactor.toString() 2 1 3 3
可以从该表中更加清晰的看出某些类复杂度高的原因,例如Mono类复杂度高是因为其中的toString方法和sameAs方法的复杂度过高,需要对这两个方法进行拆分和优化改进。对于所有复杂度较高的方法,大概有两种优化思路:
-
尽量减少if-else分支的使用
-
提取一些方法出来,采用多个方法组合的形式减少某些方法的复杂度
二、架构体验设计
hw1设计思路
第一次作业主要沿用了OOPre课第七次作业的设计,采用递归下降法对输入进行解析,采用词法分析Lexer和语法分析Paser得到一个表达式类Expr,并且用接口Factor统一管理常数因子,变量因子和表达式因子的行为。为了方便后几次作业的迭代,我将输入解析和表达式化简分成两步进行,专门设计一个类Simplifier将Expr计算成Poly多项式,计算的过程中进行括号的展开和合并同类项,本次作业的单项式Mono类仅含有系数coefficient和指数exponent。关于多个连续符号的处理,我也将所有的Term和Factor对象赋予了一个reverse属性,用来记录符号是否翻转,只要符合文法的定义的表达式就能够正常的被parser解析,并在Simplifier中计算时从上向下进行reverse的传递,将符号最终传递给单项式
hw2设计思路
第二次作业主要增加了三角函数因子和自定义递推函数两个新内容。
首先在我的构架中新增了三角函数因子,并为其创建了parser和cal方法进行解析和计算成多项式,于是单项式的属性也需要得到修改,变成了 c \times x^{m}y^{n}...\times sin^{t_1}(poly_1)sin^{t_2}(poly_2)...\times cos^{t_1}(poly_1)cos^{t_2}(poly_2)...的形式,于是Mono增加了如下三个容器
 public class Mono {
     private BigInteger coefficient;
     private HashMap<String, Integer> variables = new HashMap<>();
     private HashMap<Poly, Integer> sin = new HashMap<>();
     private HashMap<Poly, Integer> cos = new HashMap<>();
     //...
 }
并且由于输出有规定,在Poly中新加入了一个判定是否为除表达式因子以外的因子的方法,来决定输出时三角函数括号内是否需要再内嵌一个括号。
其次是自定义递推函数,分为定义和调用两个过程,于是构建了一个类InputProcessor专门处理函数的定义,同时也方便了下次作业新增函数的定义解析。为了储存递推函数的信息,新建了一个类SdrFunc
 public class SdrFunc {
     private String funcName;
     private Expr f0;
     private Expr f1;
     private RecursiveExpr recursiveExpr = new RecursiveExpr();
     private ArrayList<String> formalParams = new ArrayList<>();
     //...
 }
由于初始定义式由表达式构成,而递推定义式的形式不太一样,故还新建了一个类RecursiveExpr用来储存递推表达式的信息
 public class RecursiveExpr {
     private NumFactor c1;
     private ArrayList<Factor> formalParams1 = new ArrayList<>();
     private boolean reverse;
     private NumFactor c2;
     private ArrayList<Factor> formalParams2 = new ArrayList<>();
     private Expr funcExpr;
     //...
 }
还需构建一个自定义递推函数调用因子,在parse时仅解析实参列表和序号,不直接进行函数调用,将函数的展开过程放到Simplifier中进行,以统一parser的作用仅用于输入的处理
 public class RecursiveFunCallFactor implements Factor {
     private String funcName;
     private ArrayList<Factor> actualParams;
     private int index;
     private boolean reverse;
     private SdrFunc sdrFunc;
     //...
 }
最后,在Simplifier中实现递归函数的调用方法,逐层往下递归调用该方法,用实参列表代替形参列表,最终完成递归函数的调用
hw3设计思路
第三次作业增加了求导因子和自定义普通函数。
自定义普通函数同上自定义递推函数,只不过是简单版本。
求导因子思路也差不多,将求导的过程放在Simplifier类里,实现解析与化简的分离。具体求导的实现也不难,熟练运用链式法则和乘法法则就行,在Expr、Term和Factor中都实现各自的derive方法即可。这里我统一将derive方法的返回类型定义为Expr,方便我求导之后的多项式转换
PS:关于重构,由于笔者在两次迭代中并未进行重构,故不发表见解
可扩展性
在第三次作业的架构中,我保留了各种变量名的可变性,和函数名的可变性,不局限于x,y与f,g,h,可以采用多样的函数名
三、bug分析
第一次作业:
无bug
第二次作业:
-
在Parser中进行tokenPos的移动时出现了问题,没有考虑越界的情况,发生了空指针错误,增加了越界判定
-
三角函数输出时括号格式不对,当三角函数内为表达式因子时需要多嵌套一层括号,加入了判断非表达式因子的方法
-
递推表达式第二项系数有可能为负数,在输入解析时漏判了该情况
-
输出时未考虑三角函数指数为0的情况
第三次作业:
-
求导时各类的reverse属性忘记考虑,导致符号发生错误
-
求导的多层嵌套出现问题,求导因子的求导仅求导了一次,而应该求导两次
四、hack策略
首先记录下自己的代码在测试过程中使用过的测试样例,因为自己出现过的错误往往大家都会犯,其次还可以使用测评机生成大量测试用例进行大范围无差别测试(但是写测评机需要耗费大量精力,所以可以借鉴往届学长们的博客使用)
关于是否看别的同学的代码来构造样例,个人认为这不失为一种很好的方法,既能锻炼阅读他人代码的能力,又能学习其他同学优秀的代码风格或者设计思路,但太过于耗费时间和精力,需要有所取舍。
五、优化处理
由于三角函数的引入,使得优化的方式变得扑朔迷离了起来,各种三角函数公式的应用,能使一个表达式最终化简到无法想象的形式。但是越复杂公式的应用,往往也意味着更加复杂的化简方法,与特判条件,不一定能提高我们程序的性能,所以,笔者仅仅实现了同类项的合并,以及正项的提前,能够保证代码的简洁性和正确性就足以。
六、心得体会
作为OO正课的第一个Unit,一上来的强度确实有点大,每周花费大量时间在OO迭代作业、修bug和hack上,对面向对象的模式有了更加深刻的理解,同时也能够熟练运用递归下降法进行输入解析,并对层次化结构和归一化结构有了一定的认识。在构思和设计代码时,学会了参考往届博客和评论区他人的经验,hack别人代码时学会了对代码进行更加有效广泛的测试。总之,在高强度的第一单元练习下来,我有了长足的进步。
七、未来方向
理论课上时可以多讲一点作业有关的内容,让大家更好地理解作业指导书。
相关推荐
熊数据集集2983张VOC+YOLO格式.zip
数据集格式:VOC格式+YOLO格式 压缩包内含:3个文件夹,分别存储图片、xml、txt文件 JPEGImages文件夹中jpg图片总计:2983 Annotations文件夹中xml文件总计:2983 labels文件夹中txt文件总计:2983 标签种类数:1 标签名称:["bear"] 每个标签的框数(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准): bear 框数 = 3021 总框数:3021 图片清晰度(分辨率:像素):清晰 图片是否增强:否 标签形状:矩形框,用于目标检测识别 重要说明:暂无 特别声明:本数据集不对训练的模型或者权重文件精度作任何保证,数据集只提供准确且合理标注
vue+springboot_基于Java语言的茶叶销售商城电商系统_176brjo7毕业设计源码数据库.zip
vue+springboot_基于Java语言的茶叶销售商城电商系统_176brjo7毕业设计源码数据库.zip
43一个强到且很实用的Linux网络管理工具.docx
43一个强到且很实用的Linux网络管理工具
【计量经济学】基于Oster无工具变量法的内生性处理:遗漏变量偏差敏感性分析与稳健因果效应界估算
内容概要:本文介绍了基于Oster(2019)提出的无工具变量法处理内生性问题的实现方法,核心是通过系数稳定性与拟合优度变化进行敏感性分析,量化遗漏变量偏差的影响,并估计在控制不可观测变量后的稳健因果效应β(beta tilde)。该方法利用两步回归(有无控制变量)之间的系数和R²变化,结合不可观测选择强度参数δ与最大潜在R²(Rmax),外推可能的因果效应边界,从而判断基准结果是否对遗漏变量稳健。文中提供了Stata(psacalc)、R(ooster包)和Python三种主流语言的具体实现代码与操作示例,强调结果依赖于参数设定,需进行敏感性扫描以增强说服力。 适合人群:经济学、管理学、社会学、公共卫生、教育等领域的实证研究者,尤其是正在撰写论文、面临审稿人关于内生性质疑的研究生与青年学者。 使用场景及目标:①在缺乏有效工具变量时,评估OLS回归结果对遗漏变量的敏感性;②生成稳健因果效应的点估计与置信区间,回应审稿人对内生性问题的质疑;③通过δ与Rmax的多值扫描,可视化展示结论稳健性。 阅读建议:此方法属于敏感性分析而非因果识别工具,应与IV、DID、固定效应等方法结合使用;使用者需确保两步回归样本一致,并替换示例中的变量名为实际数据变量,同时务必对关键参数开展敏感性测试,避免过度解读单一结果。
园区管理者如何通过数据分析精准培育创新主体?.docx
园区管理者如何通过数据分析精准培育创新主体?




