

 AI大模型

求助,模型打包为.gguf后输出出现了明显的差异,部署上ollama亦有差异
 墨衍会员 · AI 创作全网分发 墨衍智能分发 通过墨衍一键同步至各平台 可同步平台 CSDN微信公众号微博知乎掘金百家号博客园抖音小红书 你的文章也可以这样分发 墨衍会员 ¥399起/年,写一次发全网
我也要 关注 + 加入社区
最近本人来开始摸索微调训练,因为需要部署在ollama上面,所以需要转换成.gguf格式,但是部署上了ollama后,发现结果和预期差异很大,所以一步一步往回追溯,最后发现使用convert_hf_to_gguf.py转换后的.gguf模型,使用llama-cli运行时的输出,和预期的差异很大,使用训练数据来测试,结果完全不对。另外部署上ollama后相同的输入数据,答案和上一步直接运行.gguf差异也很大
首先是转成.gguf前最后一步,验证adapter合并后模型模型的代码:
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    pipeline,
    BitsAndBytesConfig
)
from peft import PeftModel, PeftConfig
from datasets import load_dataset
import json
import time


# 1. 设置路径
merge_model_path = "/home/ps/pyCode/merged_model"  # 原始基础模型
test_data_path = "/home/ps/文档/trainingData"  # 测试数据集

# 2. 加载基础模型和分词器
tokenizer = AutoTokenizer.from_pretrained(
    merge_model_path,
    trust_remote_code=True,
    padding_side="right"
)
tokenizer.pad_token = tokenizer.eos_token  # 确保设置填充token
# 配置量化(可选,减少显存占用)
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16
)

merge_model = AutoModelForCausalLM.from_pretrained(
    merge_model_path,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
    torch_dtype=torch.bfloat16
)


# 4. 创建文本生成管道
text_generator = pipeline(
    "text-generation",
    model=merge_model,
    #device=model.device,
    max_new_tokens=256,  # 最大生成长度
    do_sample=True,      # 启用随机采样
    temperature=0.7,     # 控制随机性 (0-1)
    top_p=0.9,           # 核采样参数
     tokenizer=tokenizer,
     eos_token_id=tokenizer.eos_token_id
)

# 加载测试数据集
#test_data = load_dataset("json", data_files=test_data_path+ "/*.json", split="train")


outputs = text_generator([{"role":"system","content":"根据输入的症状描述或诊断症状名,告诉我对应的症状名,对应的贴敷方案"},{"role":"user","content":f"开放性脏器,经常反复感染,是妇科的常见病,多发病。临床上以小腹不适,活动后加重,腰酸,腿酸,白带过多,外阴瘙痒。盆腔炎性疾病包括女性生殖道器官及其周围组织(子宫、附件、盆腔腹膜等组织)。"}],
        return_full_text=False,  # 不返回输入文本
        num_return_sequences=1,
    )

# 提取生成的文本
response = outputs[0]['generated_text'].strip()
print(f"test question answer:{response}");

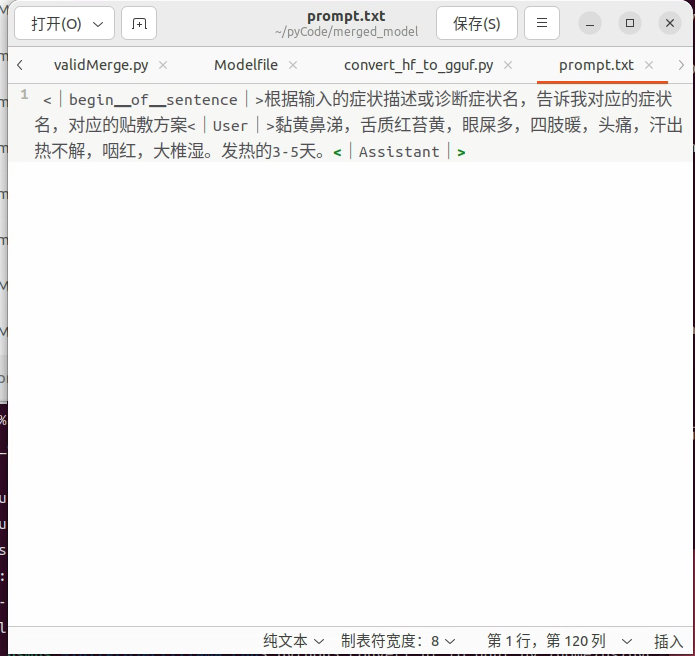
outputs = text_generator("<|begin▁of▁sentence|>根据输入的症状描述或诊断症状名,告诉我对应的症状名,对应的贴敷方案<|User|>黏黄鼻涕,舌质红苔黄,眼屎多,四肢暖,头痛,汗出热不解,咽红,大椎湿。发热的3-5天。<|Assistant|>",
        return_full_text=False,  # 不返回输入文本
        num_return_sequences=1,
    )
# 提取生成的文本
response = outputs[0]['generated_text'].strip()
print(f"no 2 test question answer:{response}");
第二次的是按照切词器格式直接输入文本来进行测试,这两次都达到了预期,和标准答案完全一致,我这个模型的system固定为:"根据输入的症状描述或诊断症状名,告诉我对应的症状名,对应的贴敷方案"
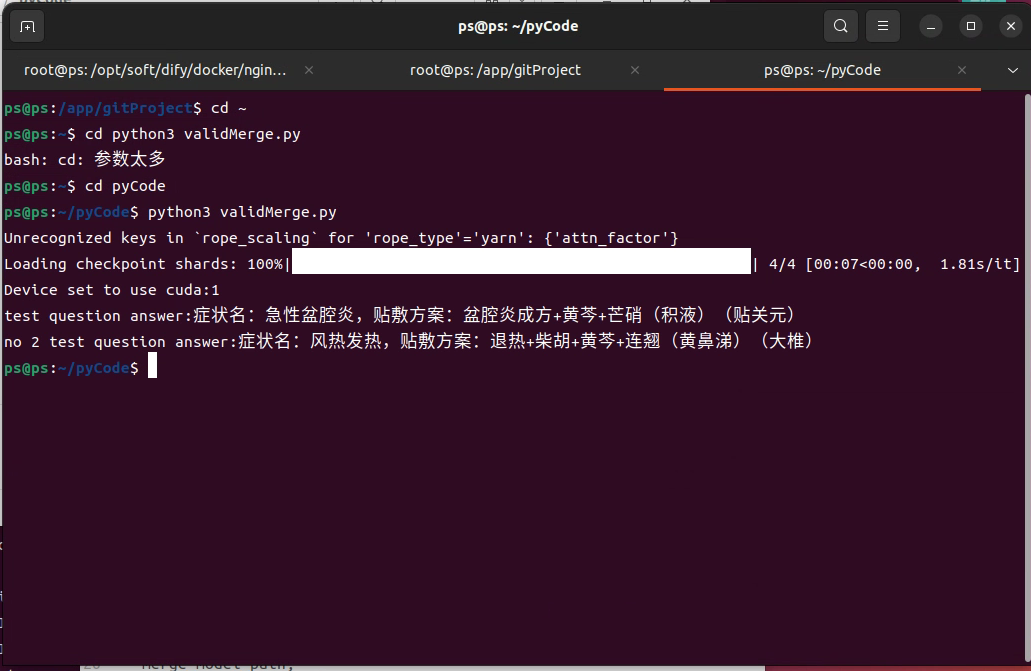
然后使用llama.cpp进行了模型转换,指令:"python3 convert_hf_to_gguf.py /home/ps/pyCode/merged_model --outtype f16 "
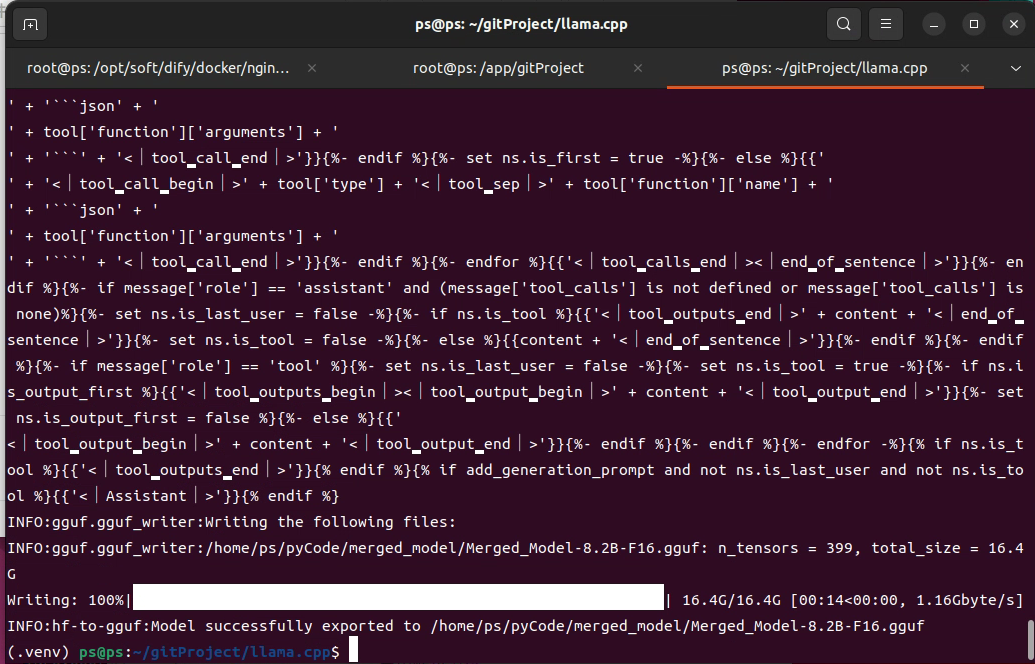
转换成功
最后运行llama-cli指令"/home/ps/gitProject/llama.cpp/build/bin/llama-cli -m Merged_Model-8.2B-F16.gguf --file prompt.txt"
prompt.txt内容如下,就是验证合并模型的第二次输入
运行结果:
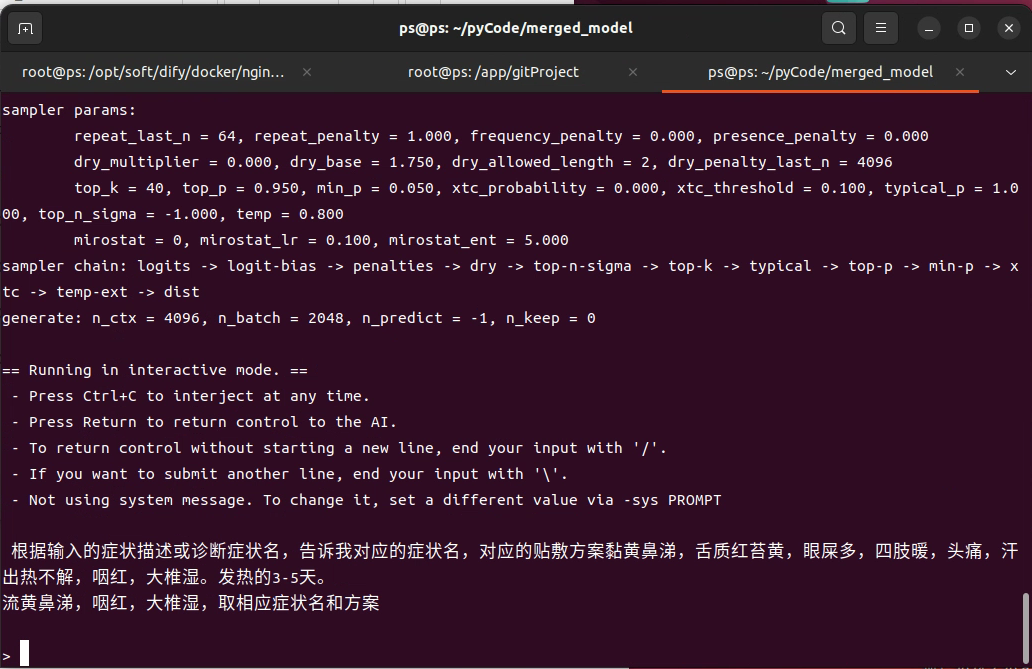
明显不对,这个问题可能是什么原因导致的?
转换的详细log,运行llama-cli的详细log我会放在下面两楼
相关推荐
paddle2gguf文档
paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2gguf文档。paddle2ggu
从 HuggingFace 到本地推理:GGUF 模型转换与 Ollama 部署实战指南
本文详细介绍了如何将HuggingFace模型转换为GGUF格式,并通过Ollama进行本地部署的完整流程。从环境配置、模型下载、转换量化到Ollama部署,提供了实战技巧和常见问题解决方案,特别针对Qwen2模型进行了优化指导,帮助开发者高效实现本地AI推理。
LM Studio加载Ollama模型[代码]
本文详细介绍了如何在LM Studio中加载Ollama的模型。首先需要下载LM Studio和Ollama,并选择适合本地设备的模型版本(如deepseek-r1:7b)。接着通过Windows的Chocolatey安装jq库,并新建文件夹用于存放GitHub项目。克隆ollama-lmstudio-bridge项目后,执行其中的脚本文件,将模型共享到LM Studio的默认路径。最后在LM Studio的“我的模型”中即可看到并加载共享的模型。整个过程涵盖了从下载到配置的完整步骤,适合需要在本地运行模型的用户参考。
GGUF量化文件选型工具
本资源为独立原创、可运行、可测试的技术工具项目,包含完整源码、README、MIT LICENSE、原创与授权声明、自动化测试、真实运行截图及使用说明。适合开发者学习、验证和二次开发;项目默认离线运行,不包含第三方源码、模型权重、品牌素材或受限内容。
GGUF运行后端兼容矩阵工具|原创源码+测试+离线报告
原创本地工程分析工具合集单项资源。每个压缩包均包含完整 JavaScript/Node.js 源码、3 项自动化测试、可复现合成示例、离线 HTML/JSON/SVG 报告、1080×720 真实运行效果图、README、运行说明、功能清单、MIT License 及原创授权声明。Node.js 18+ 可直接运行,零第三方运行依赖,适合开发者进行工程预检、质量审查和交付复核。




