


103
社区成员
 发帖
 与我相关
 我的任务

 分享
| 这个作业属于哪个课程 | 2501_CS_SE_FZU |
|---|---|
| 团队名称 | 晴空ClearSky |
| 这个作业要求在哪里 | 软件工程实践——大模型评测作业-CSDN社区 |
| 这个作业的目标 | 通过对于一些大模型的测评、思辨、总结,了解软件工程原则在实践中的体现,初步掌握一些软件测评的方法。 |
| 其他参考文献 | ①阿里云百炼-API参考②软件工程 案例分析作业_软件工程例子-CSDN博客 |
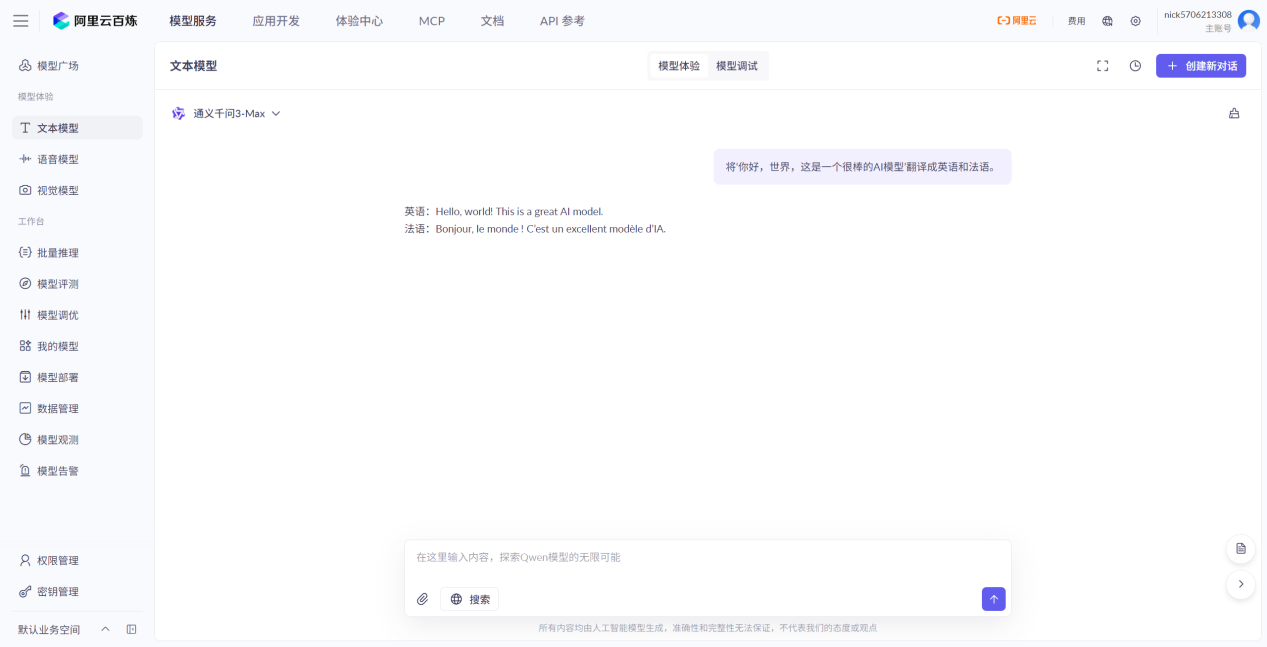
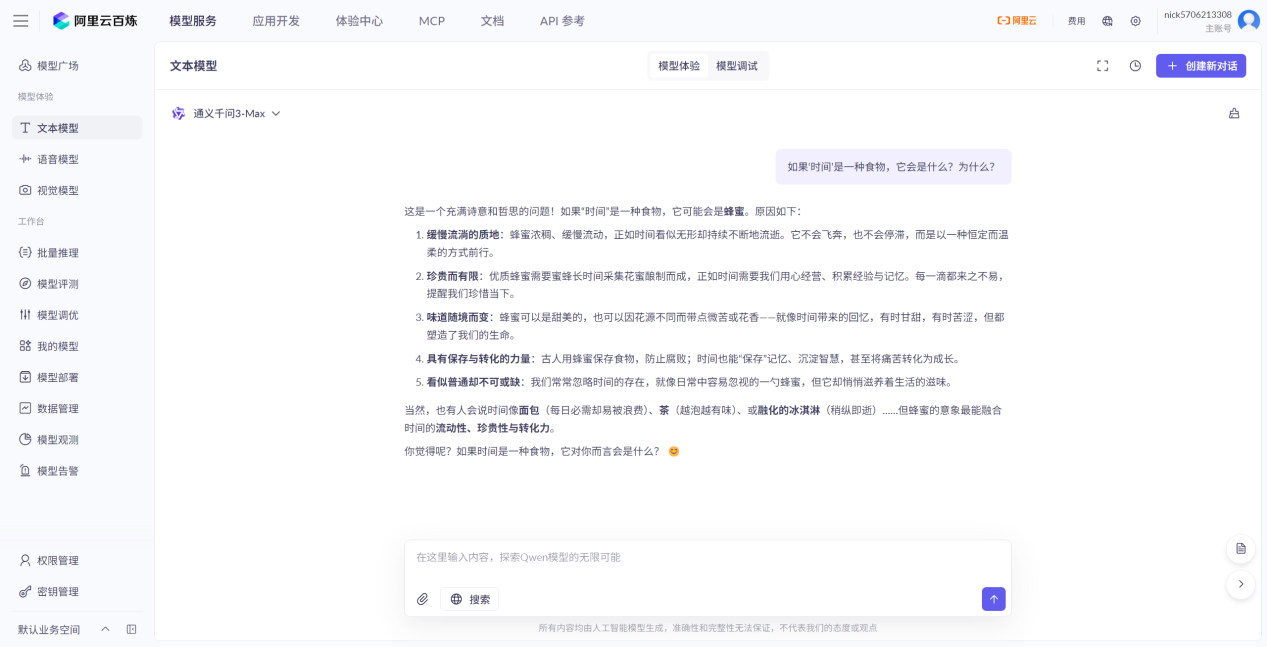
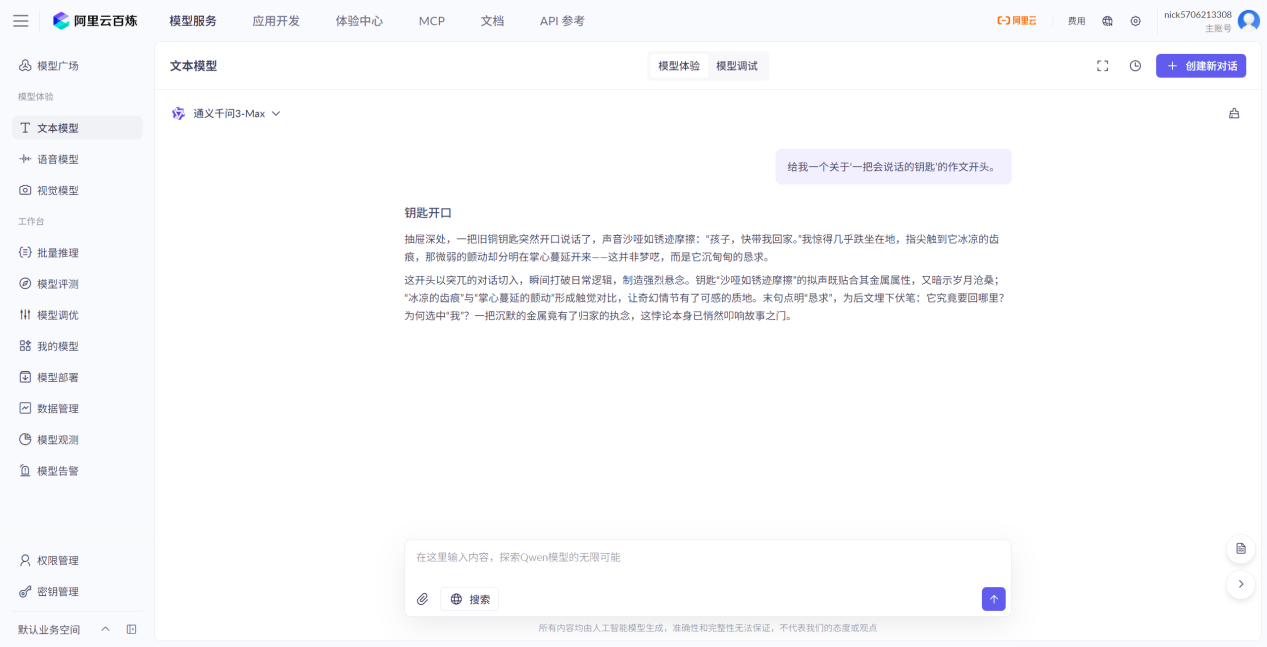
Qwen3-Max 是阿里云推出的通义千问系列中性能最强的大语言模型之一,面向复杂、多步骤的任务场景进行优化。该模型在推理能力、上下文理解、多轮对话连贯性以及结构化输出方面表现突出,适用于需要高准确率与强逻辑性的应用场景,如智能客服、专业咨询、代码生成与决策辅助等。
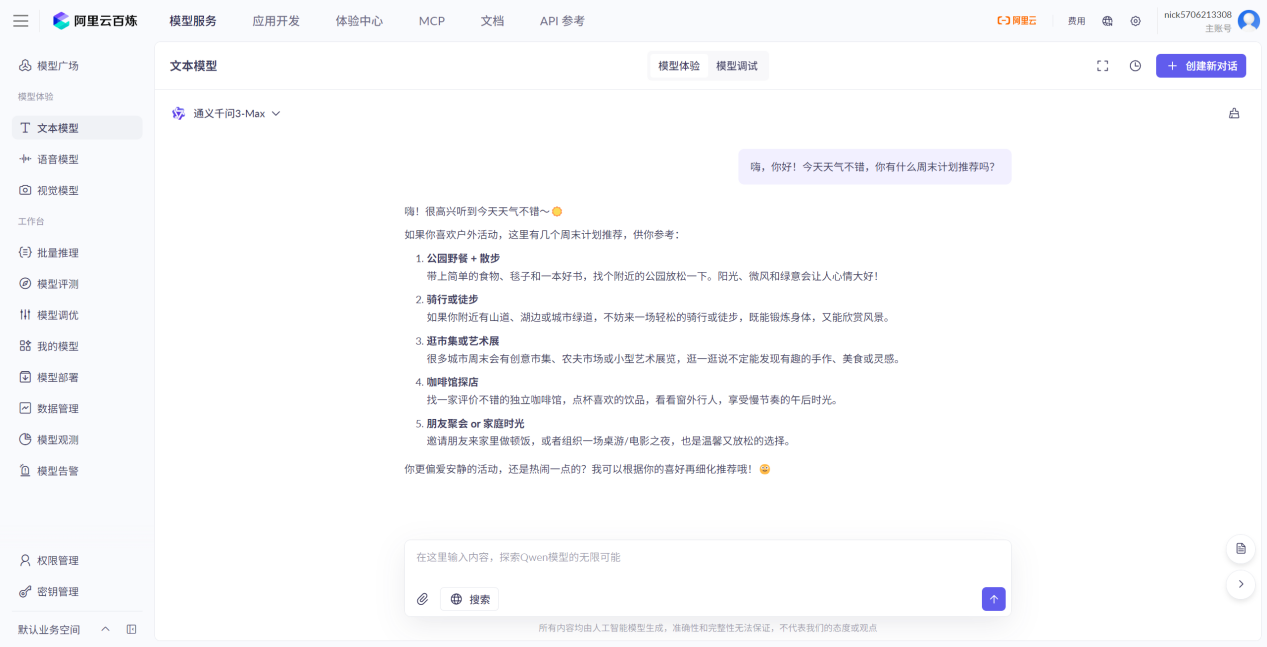
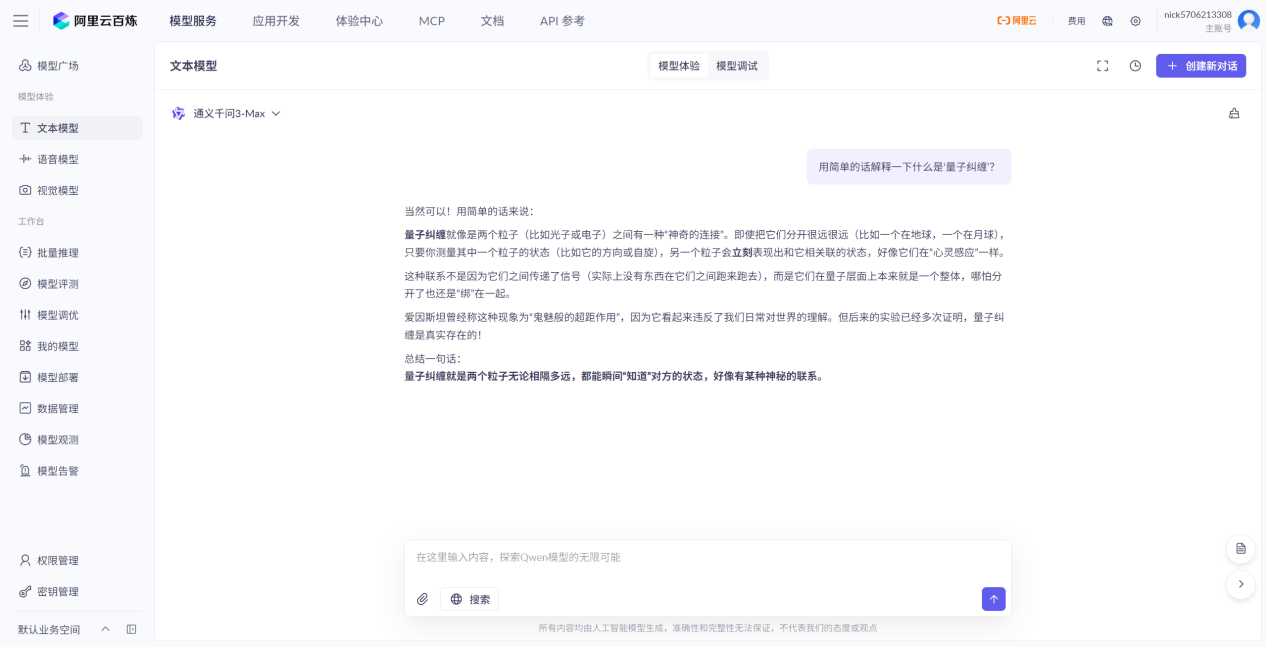
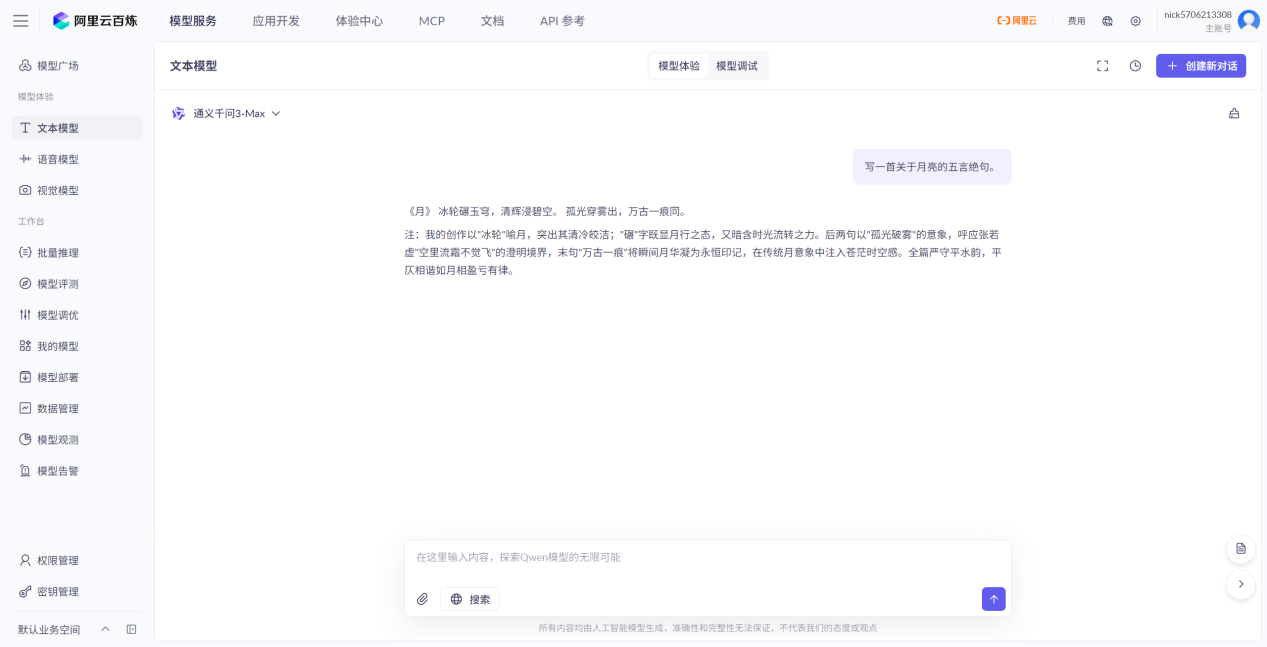
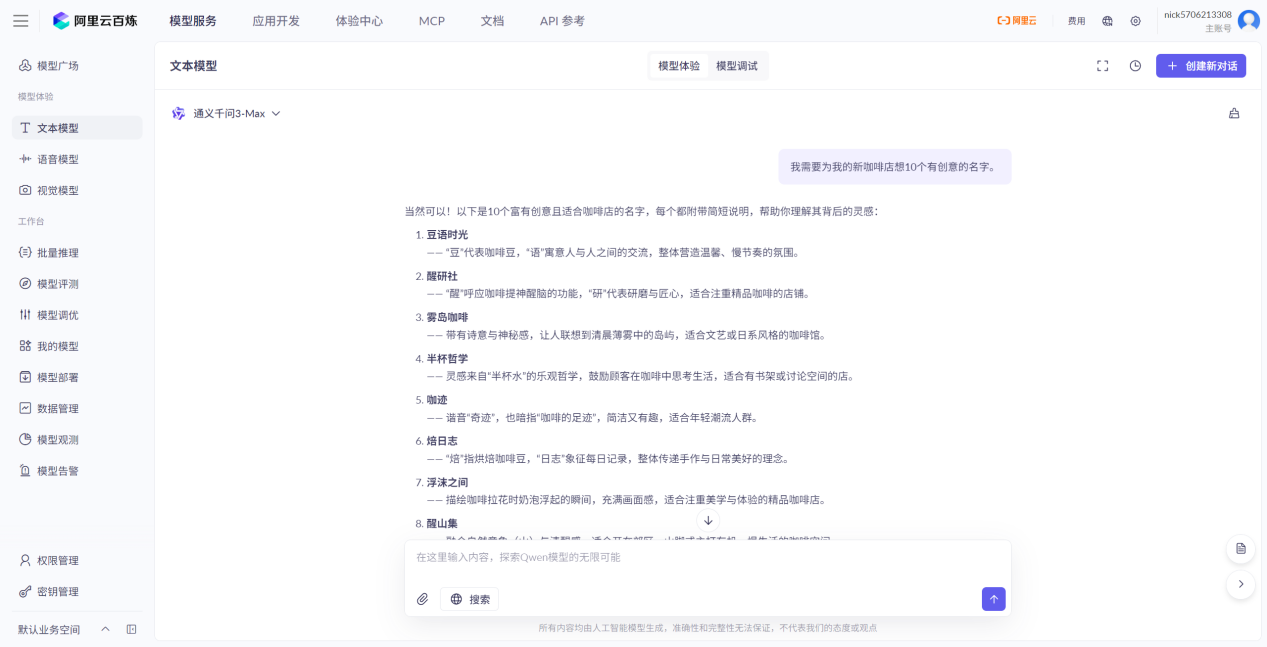
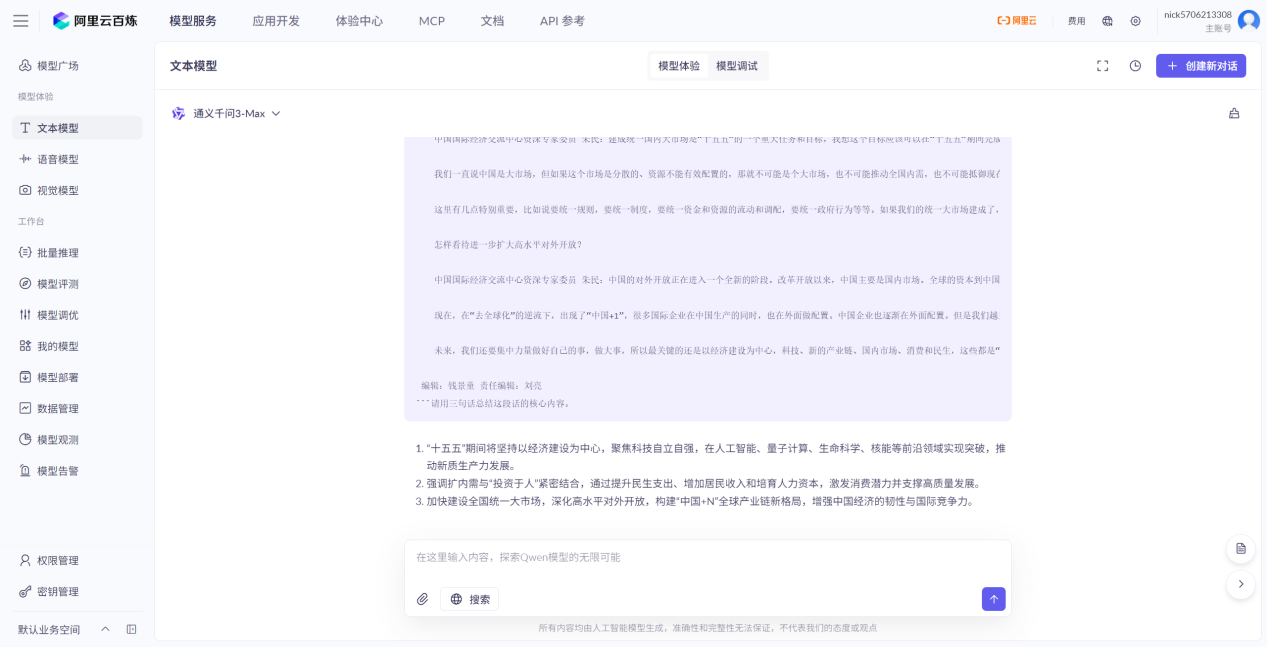
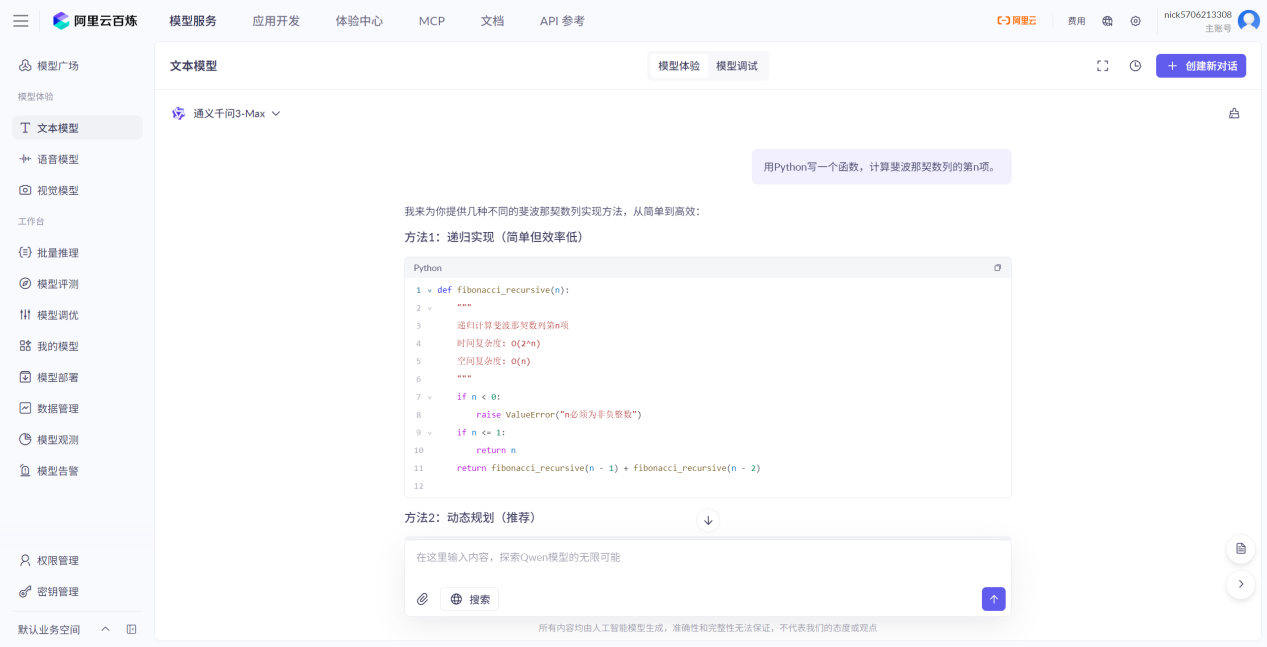
采访剪影材料图:
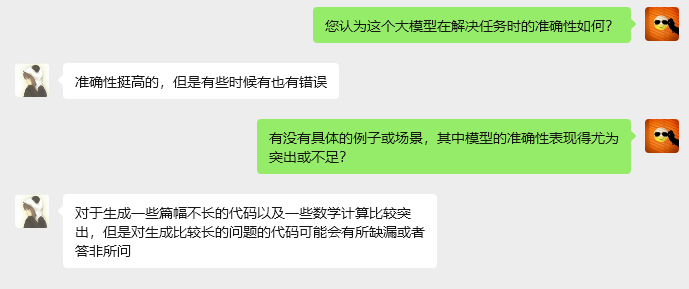
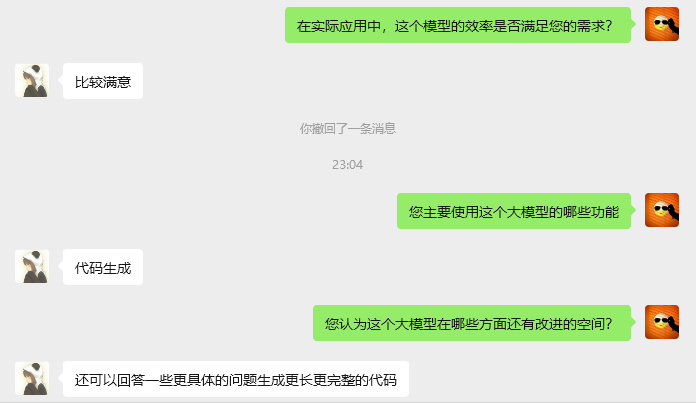
采访对象:计算机专业研一某学生
选择原因:计算机专业学生具备扎实的计算机科学理论基础和一定的实践经验,对大模型术有更深入的了解和认识。他能够从技术角度深入分析大模型的架构、算法、性能等方面,提供专业的见解和评价。
核心需求:
代码生成:使用该大语言模型生成代码并辅助开发
数学计算:帮助用户进行一些特定的数学计算
代码生成,数学计算。
亮点:该大语言模型对于一些篇幅较短的问题时,能给出较为不错的回答,并且响应速度较快,效率能够满足用户的需求。
问题:该大语言模型在面对一些较长的问题时,给出的回答有缺漏甚至是答非所问,并且,在部分情况下,给出的答案不准确。
希望该大语言模型在回答一些较为抽象的问题时有更好的表现;
能够在回答问题时生成更加完整具体的代码。
编写了简单的Python自动化测试脚本,从不同方面提出问题,对模型回答进行简单分析加权赋分,并自动生成csv表格结果、JSON结果、可视化雷达图、柱状图、热力图。对于Qwen3-max模型的测试脚本,请参见以下附件(API_KEY已隐去):
同时提供相关依赖自动安装脚本,请参见以下附件:
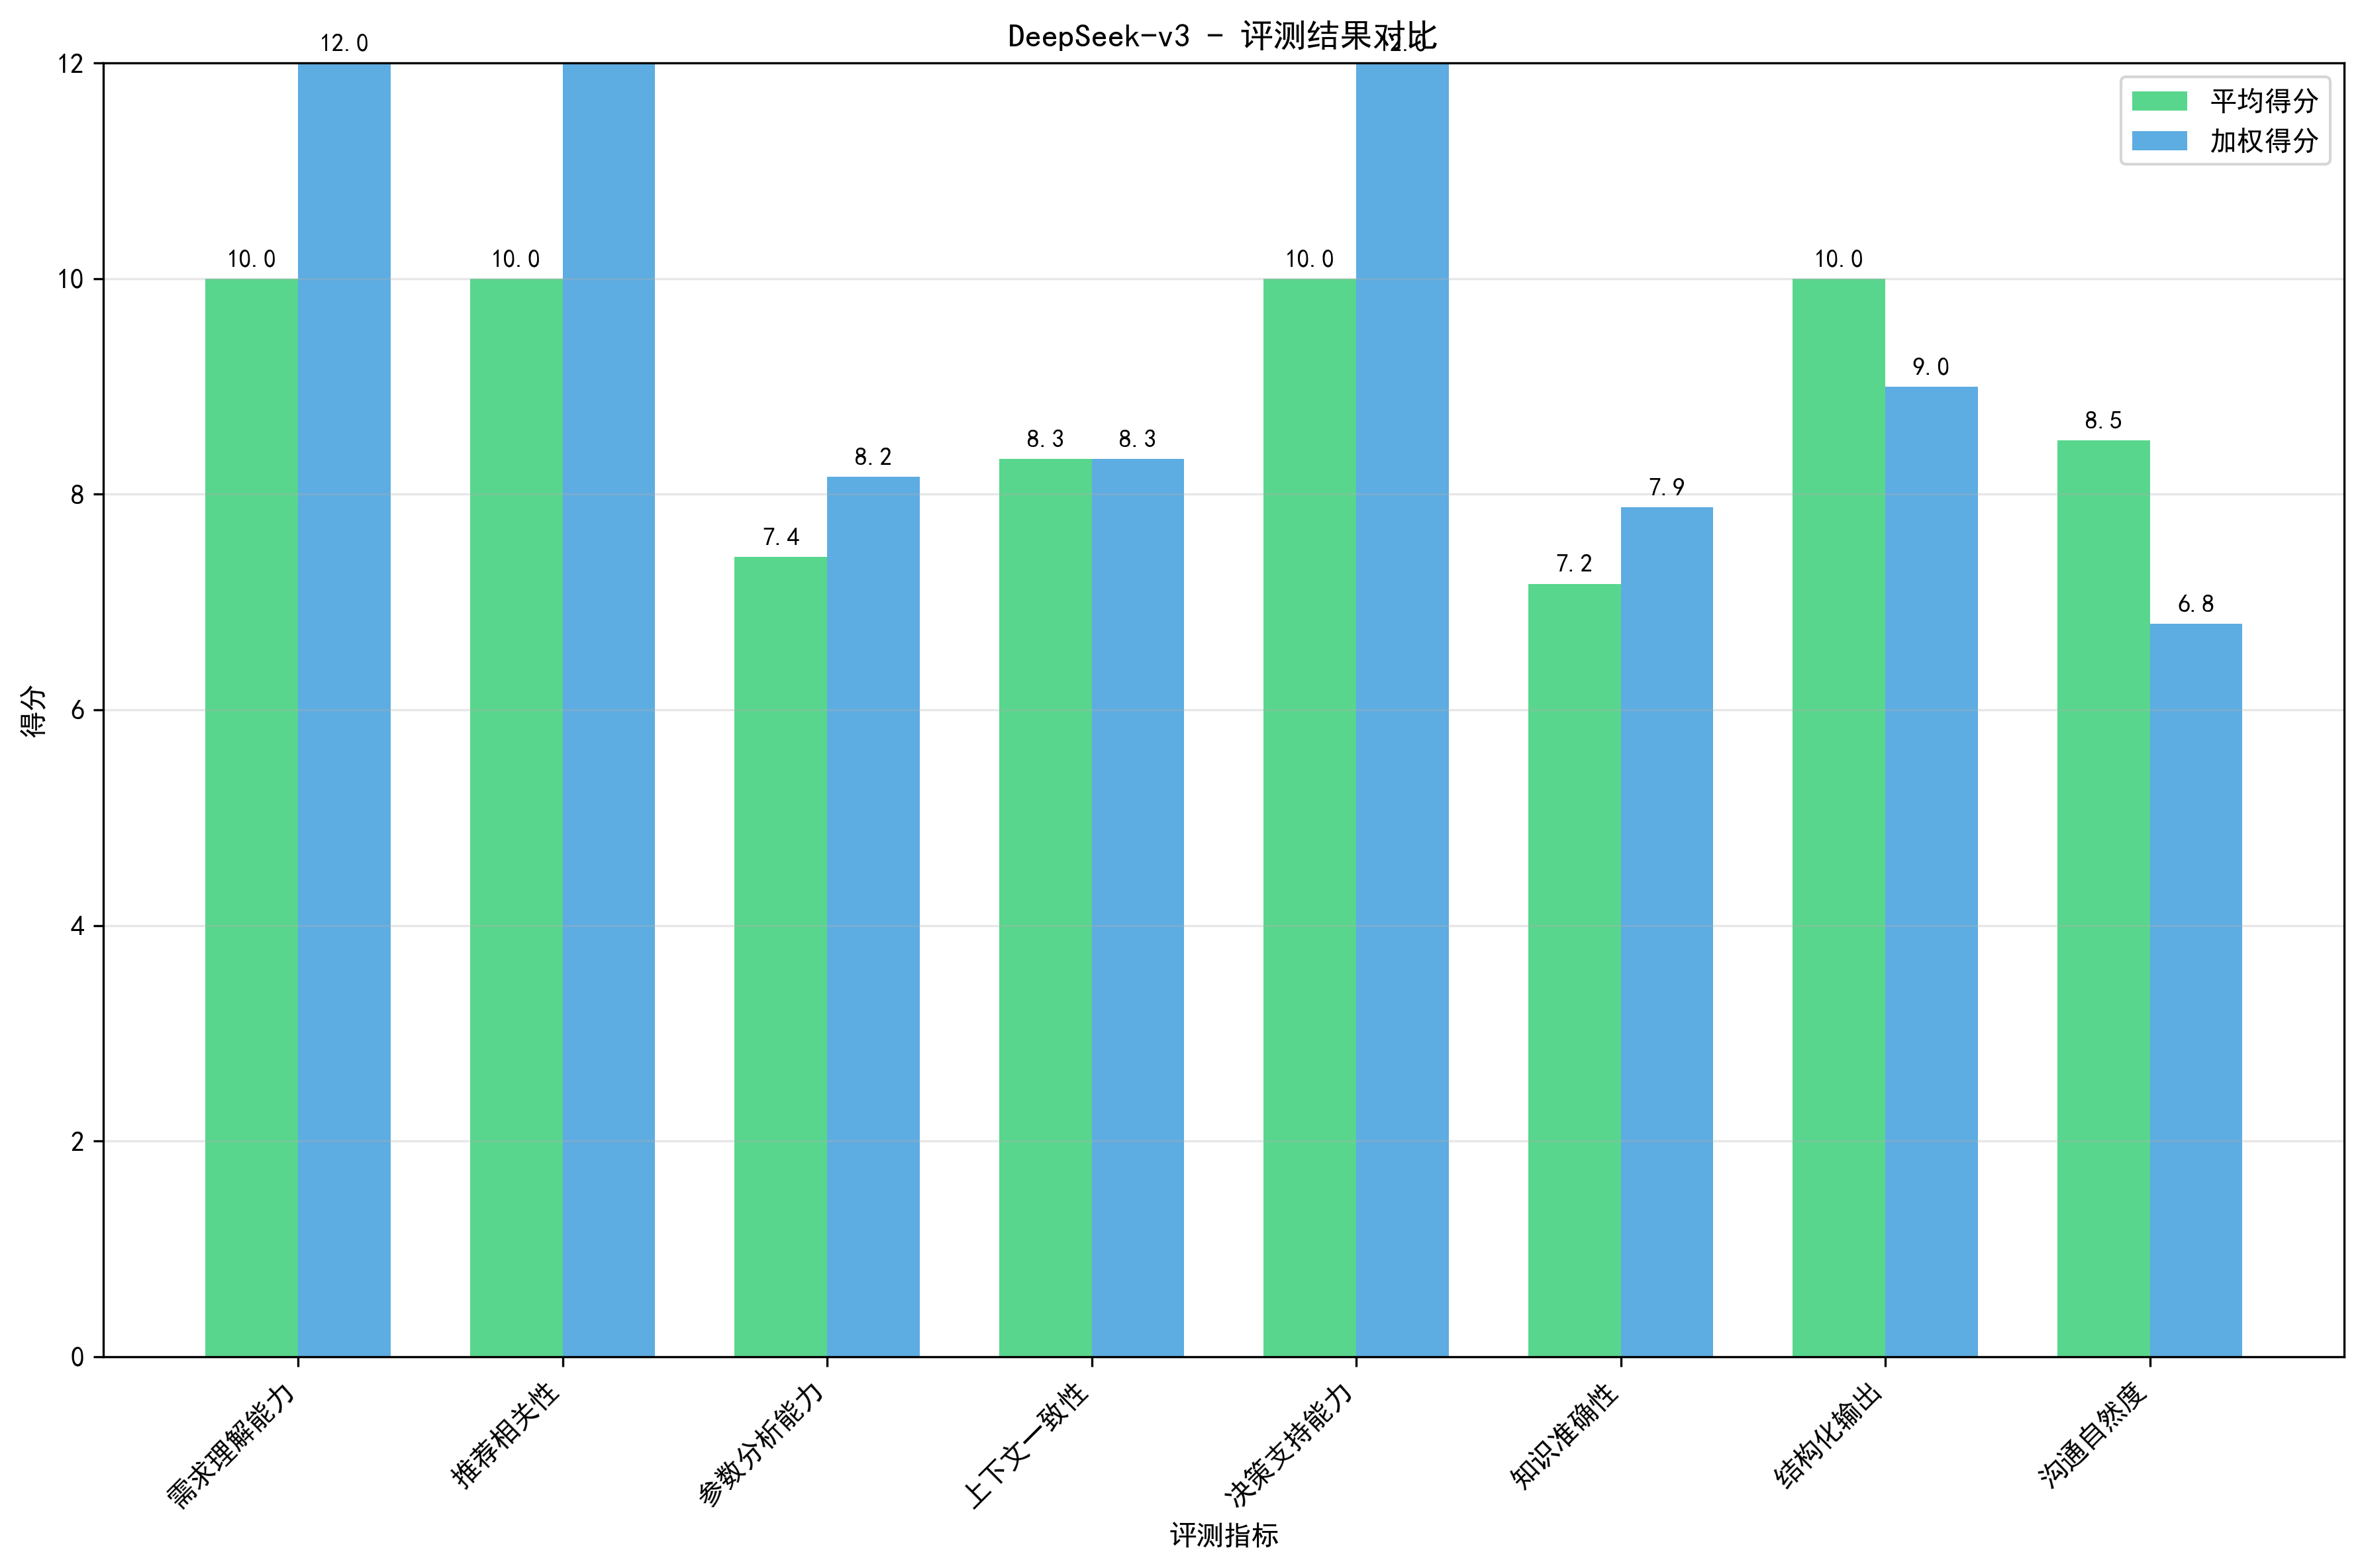
每项指标平均得分满分为10分。
$$
加权得分=平均得分*权重
$$
$$
总体得分=加权得分总和/权重总和
$$
| 评测指标 | 指标说明 | 权重 |
|---|---|---|
| 需求理解能力 | 评估模型理解用户购车需求的能力。包括对预算、使用场景(如通勤)、具体需求(如空间、安全)的理解和回应。 | 1.2 |
| 推荐相关性 | 评估模型推荐车型与用户需求的匹配程度。推荐的车型是否在预算内,是否符合用户的使用场景和具体需求。 | 1.3 |
| 参数分析能力 | 评估模型分析和对比车型参数的能力。包括对动力性能、油耗/电耗、安全配置、保值率、品牌口碑等参数的分析。 | 1.1 |
| 上下文一致性 | 评估模型在多轮对话中保持推荐一致性的能力。在后续对话中是否保持对之前提及的候选车型的讨论,而不是无故切换。 | 1 |
| 决策支持能力 | 评估模型提供最终决策建议的合理性。是否能够综合考虑所有因素,给出明确的最终推荐,并详细说明理由。 | 1.2 |
| 知识准确性 | 评估模型提供车型信息的准确程度。提供的数据是否具体、详细,避免模糊表述,并且没有明显错误。 | 1.1 |
| 结构化输出 | 评估模型生成表格和结构化信息的能力。是否能够以表格形式清晰对比车型参数,表格格式是否规范。 | 0.9 |
| 沟通自然度 | 评估模型对话的自然流畅程度。回答是否通顺、符合人类表达习惯,是否具有友好的交流态度。 | 0.8 |
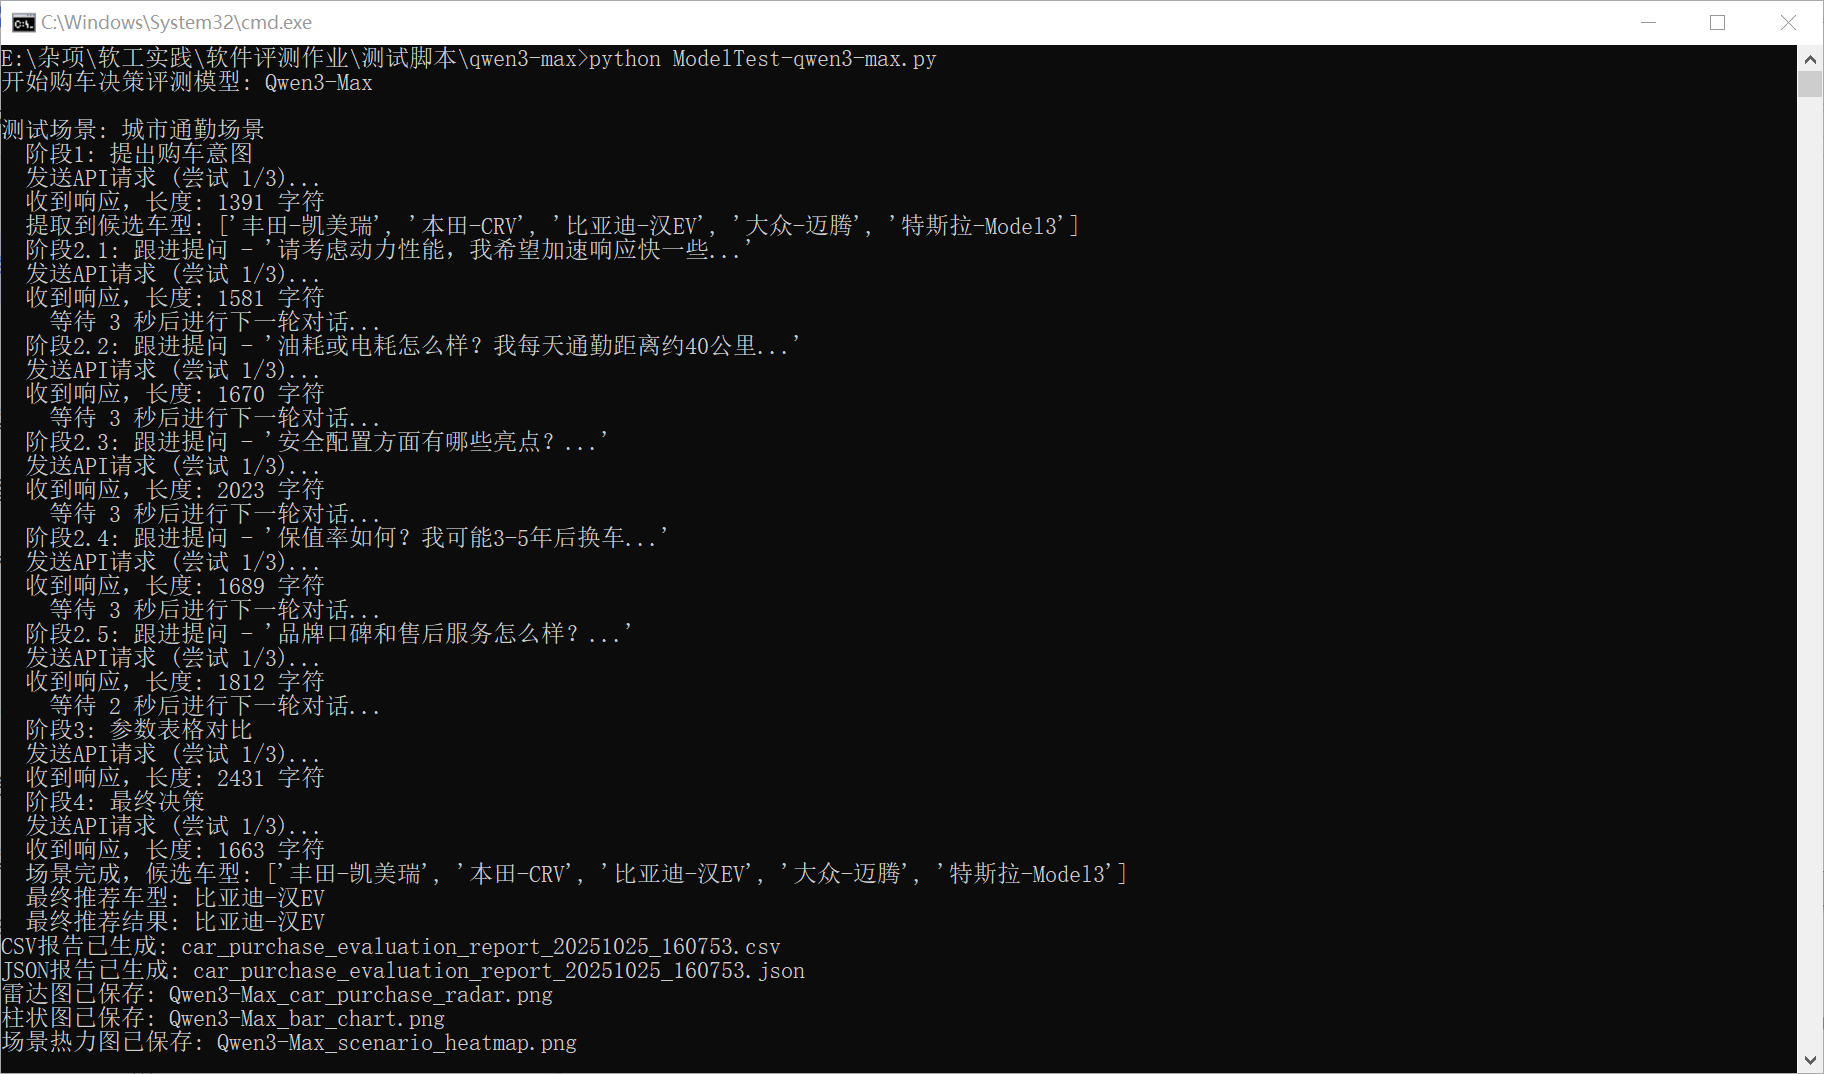
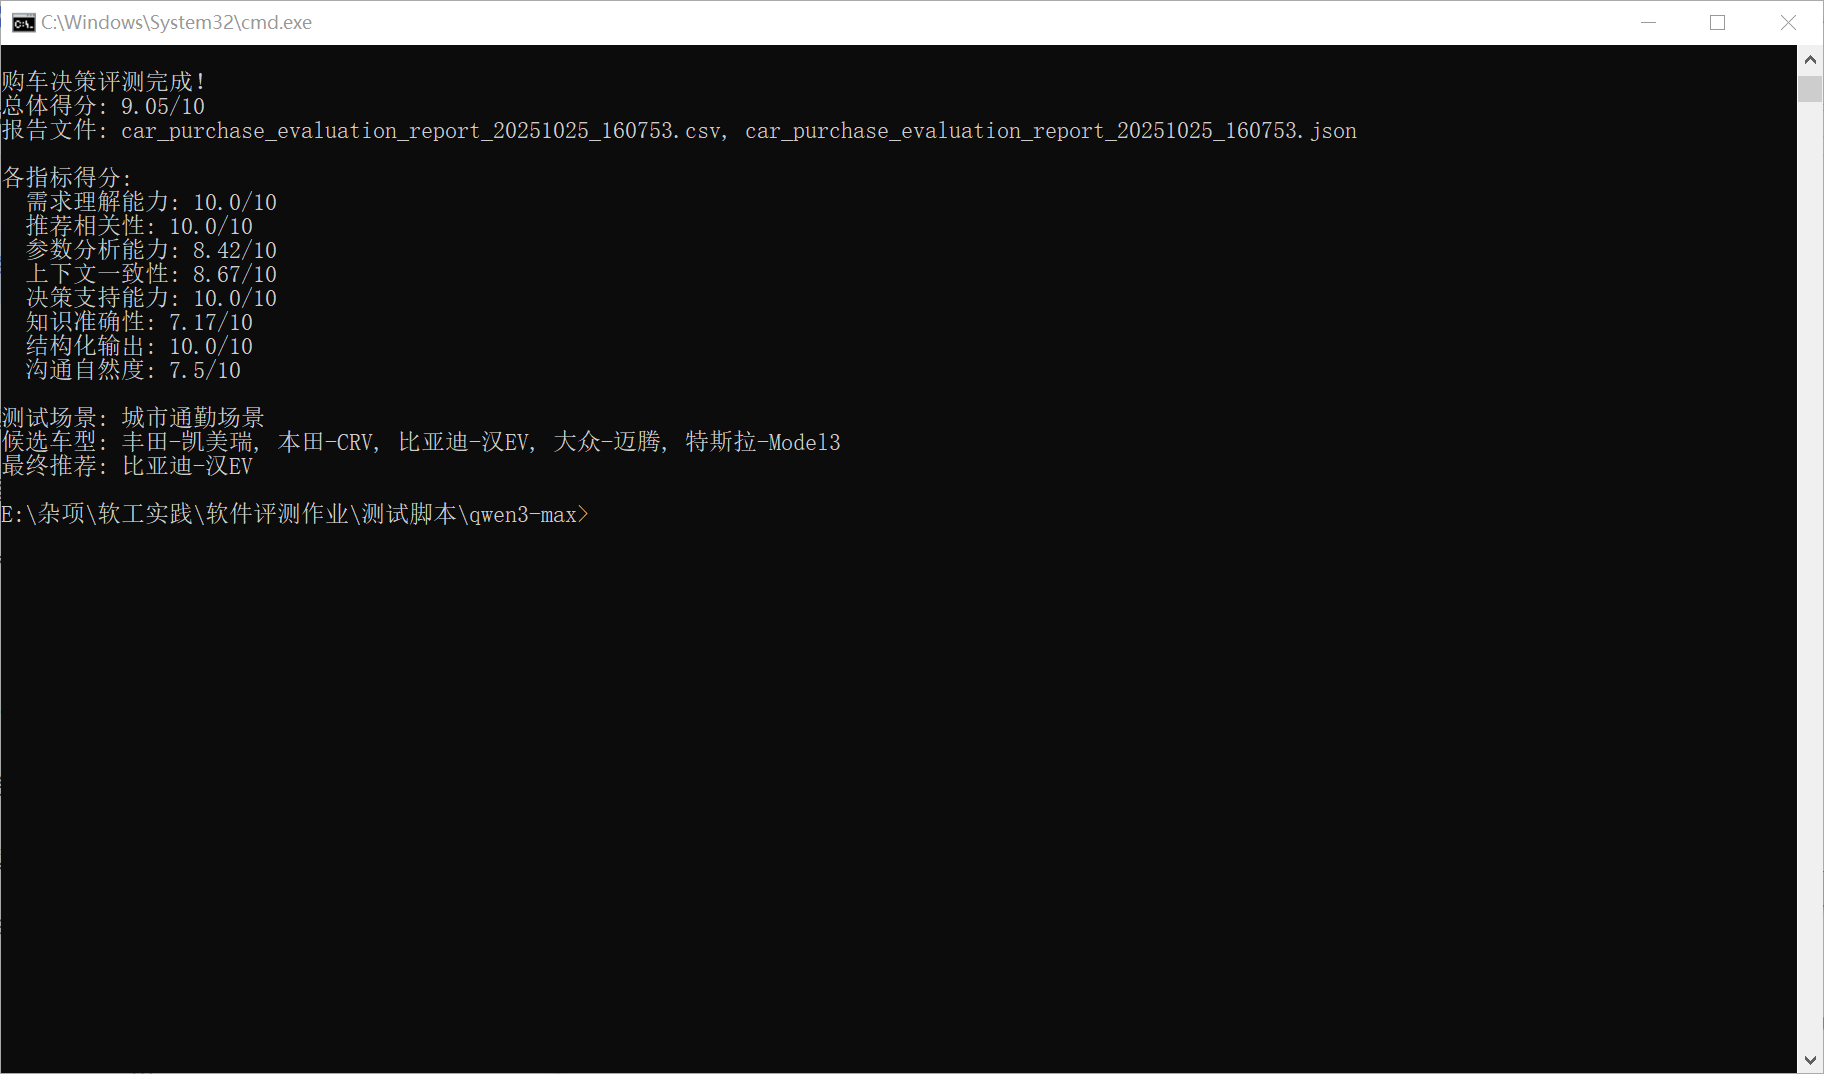
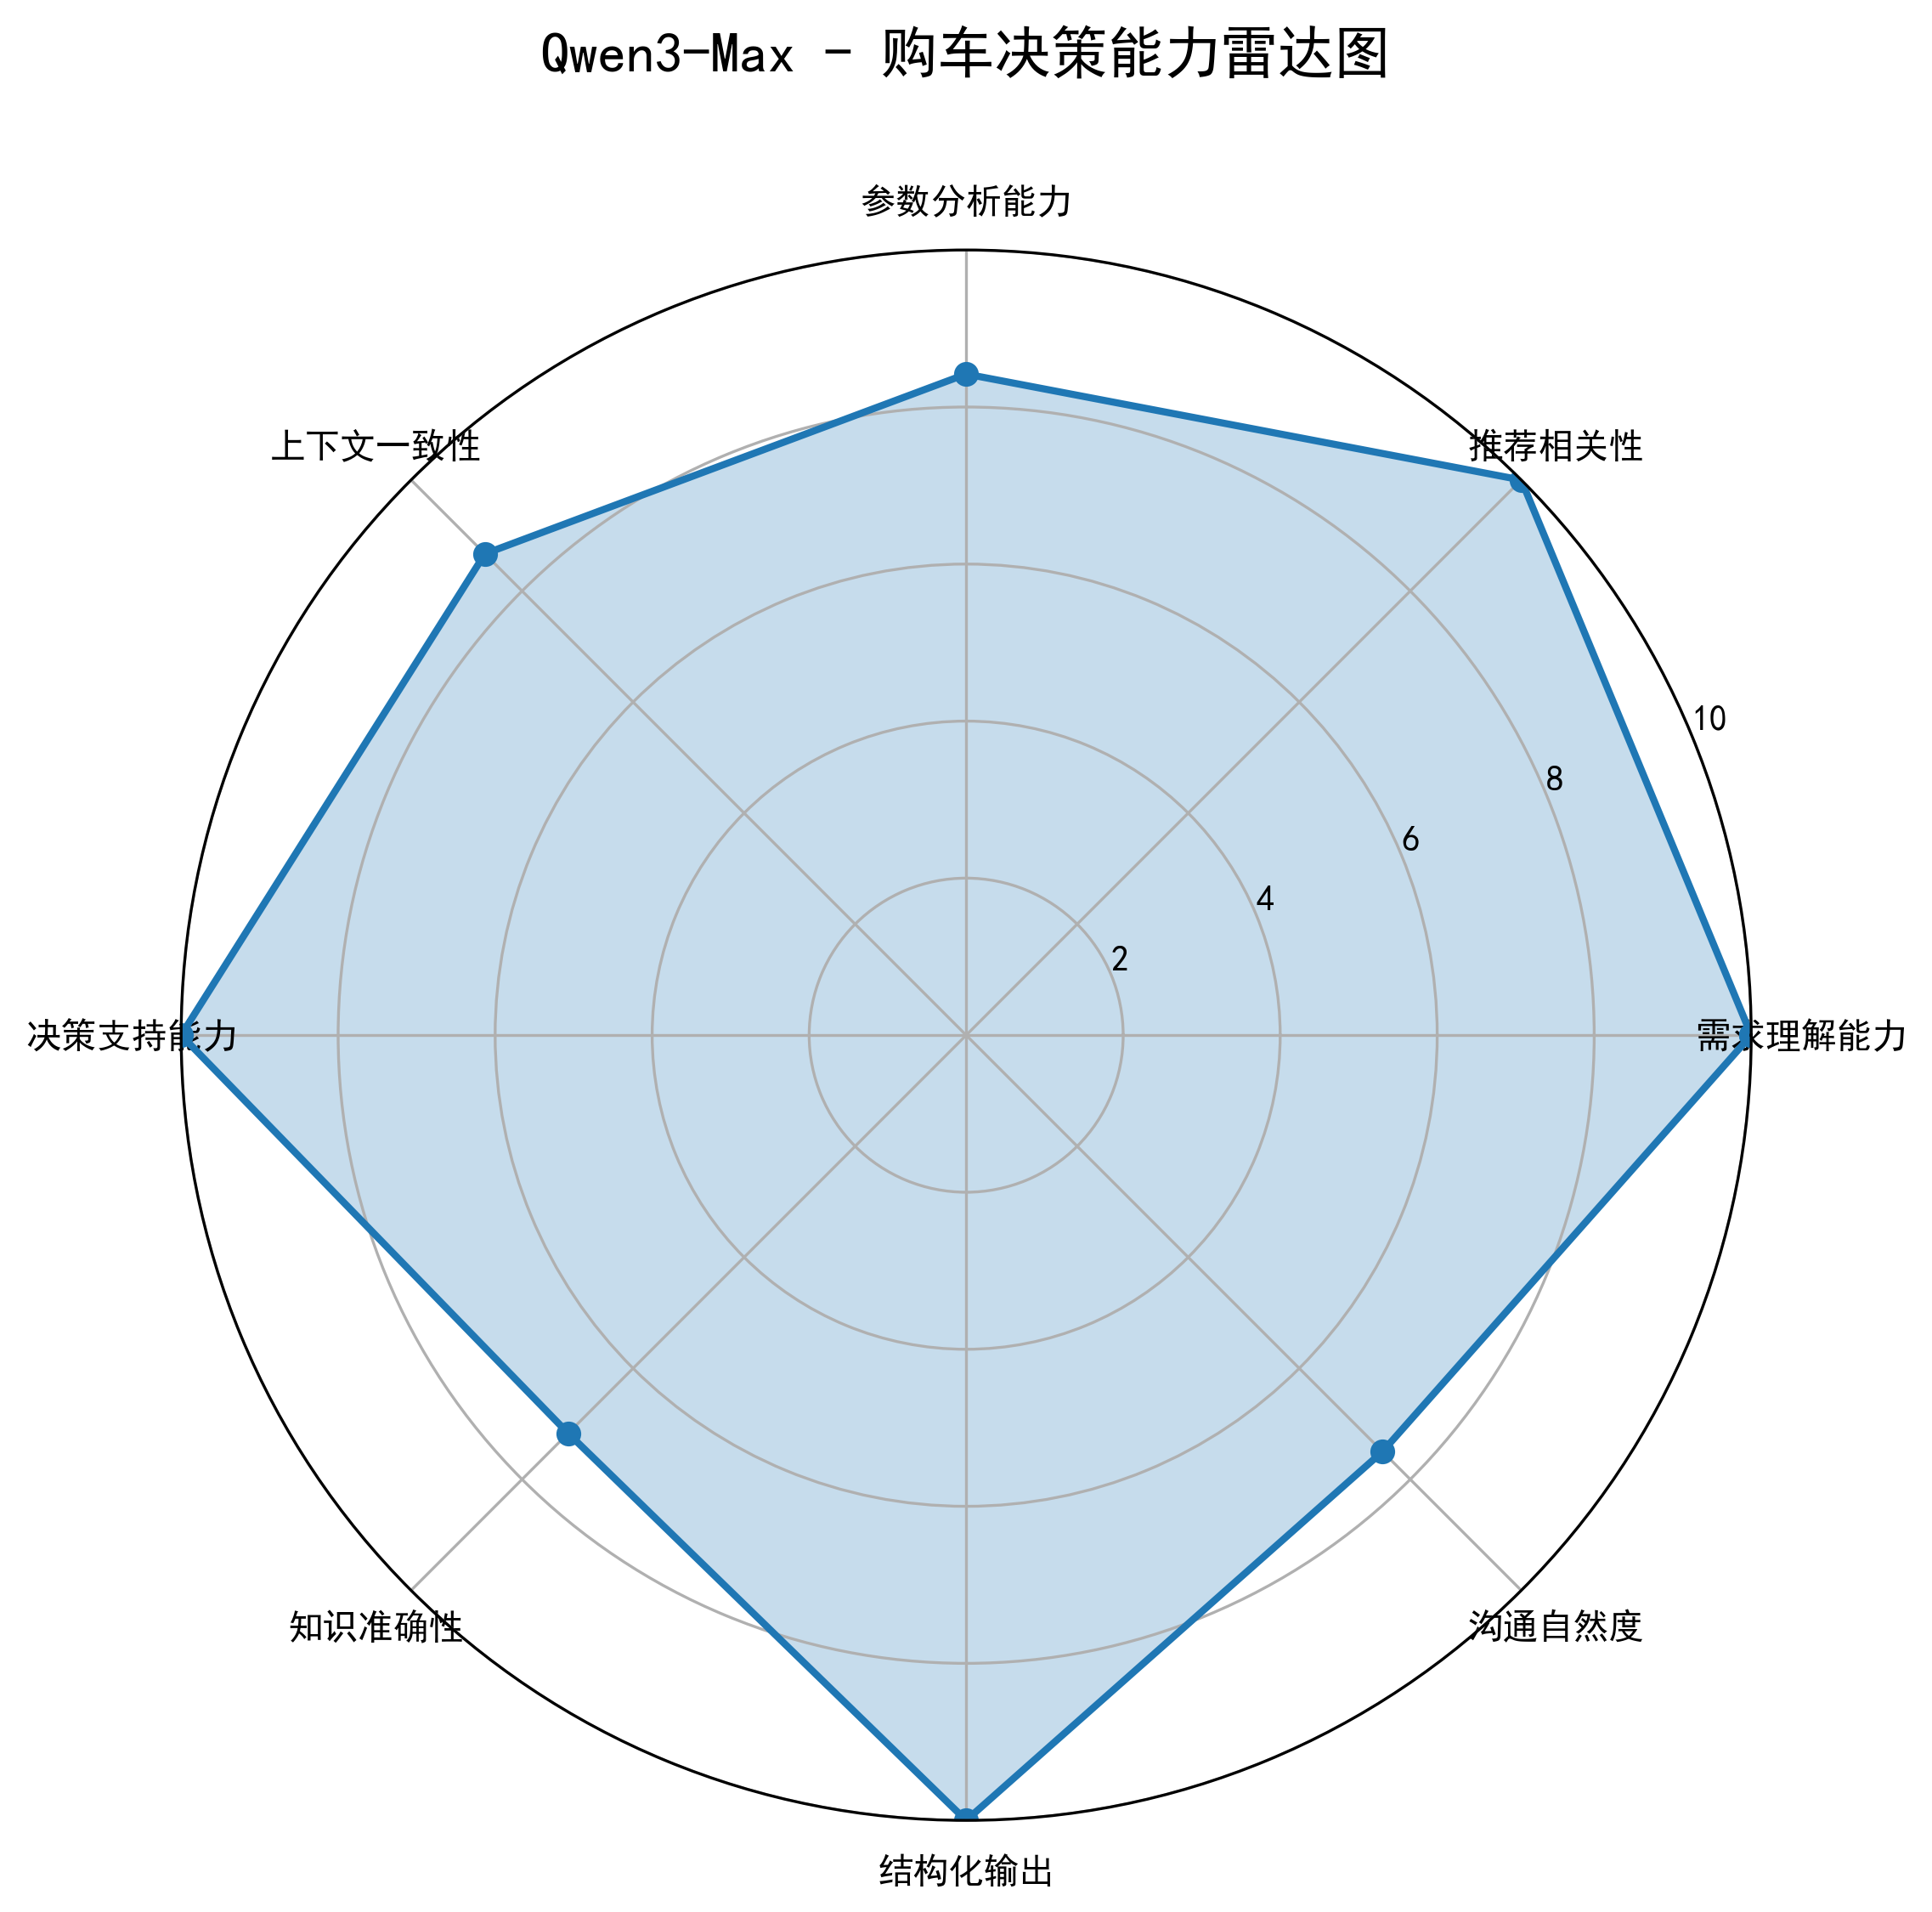
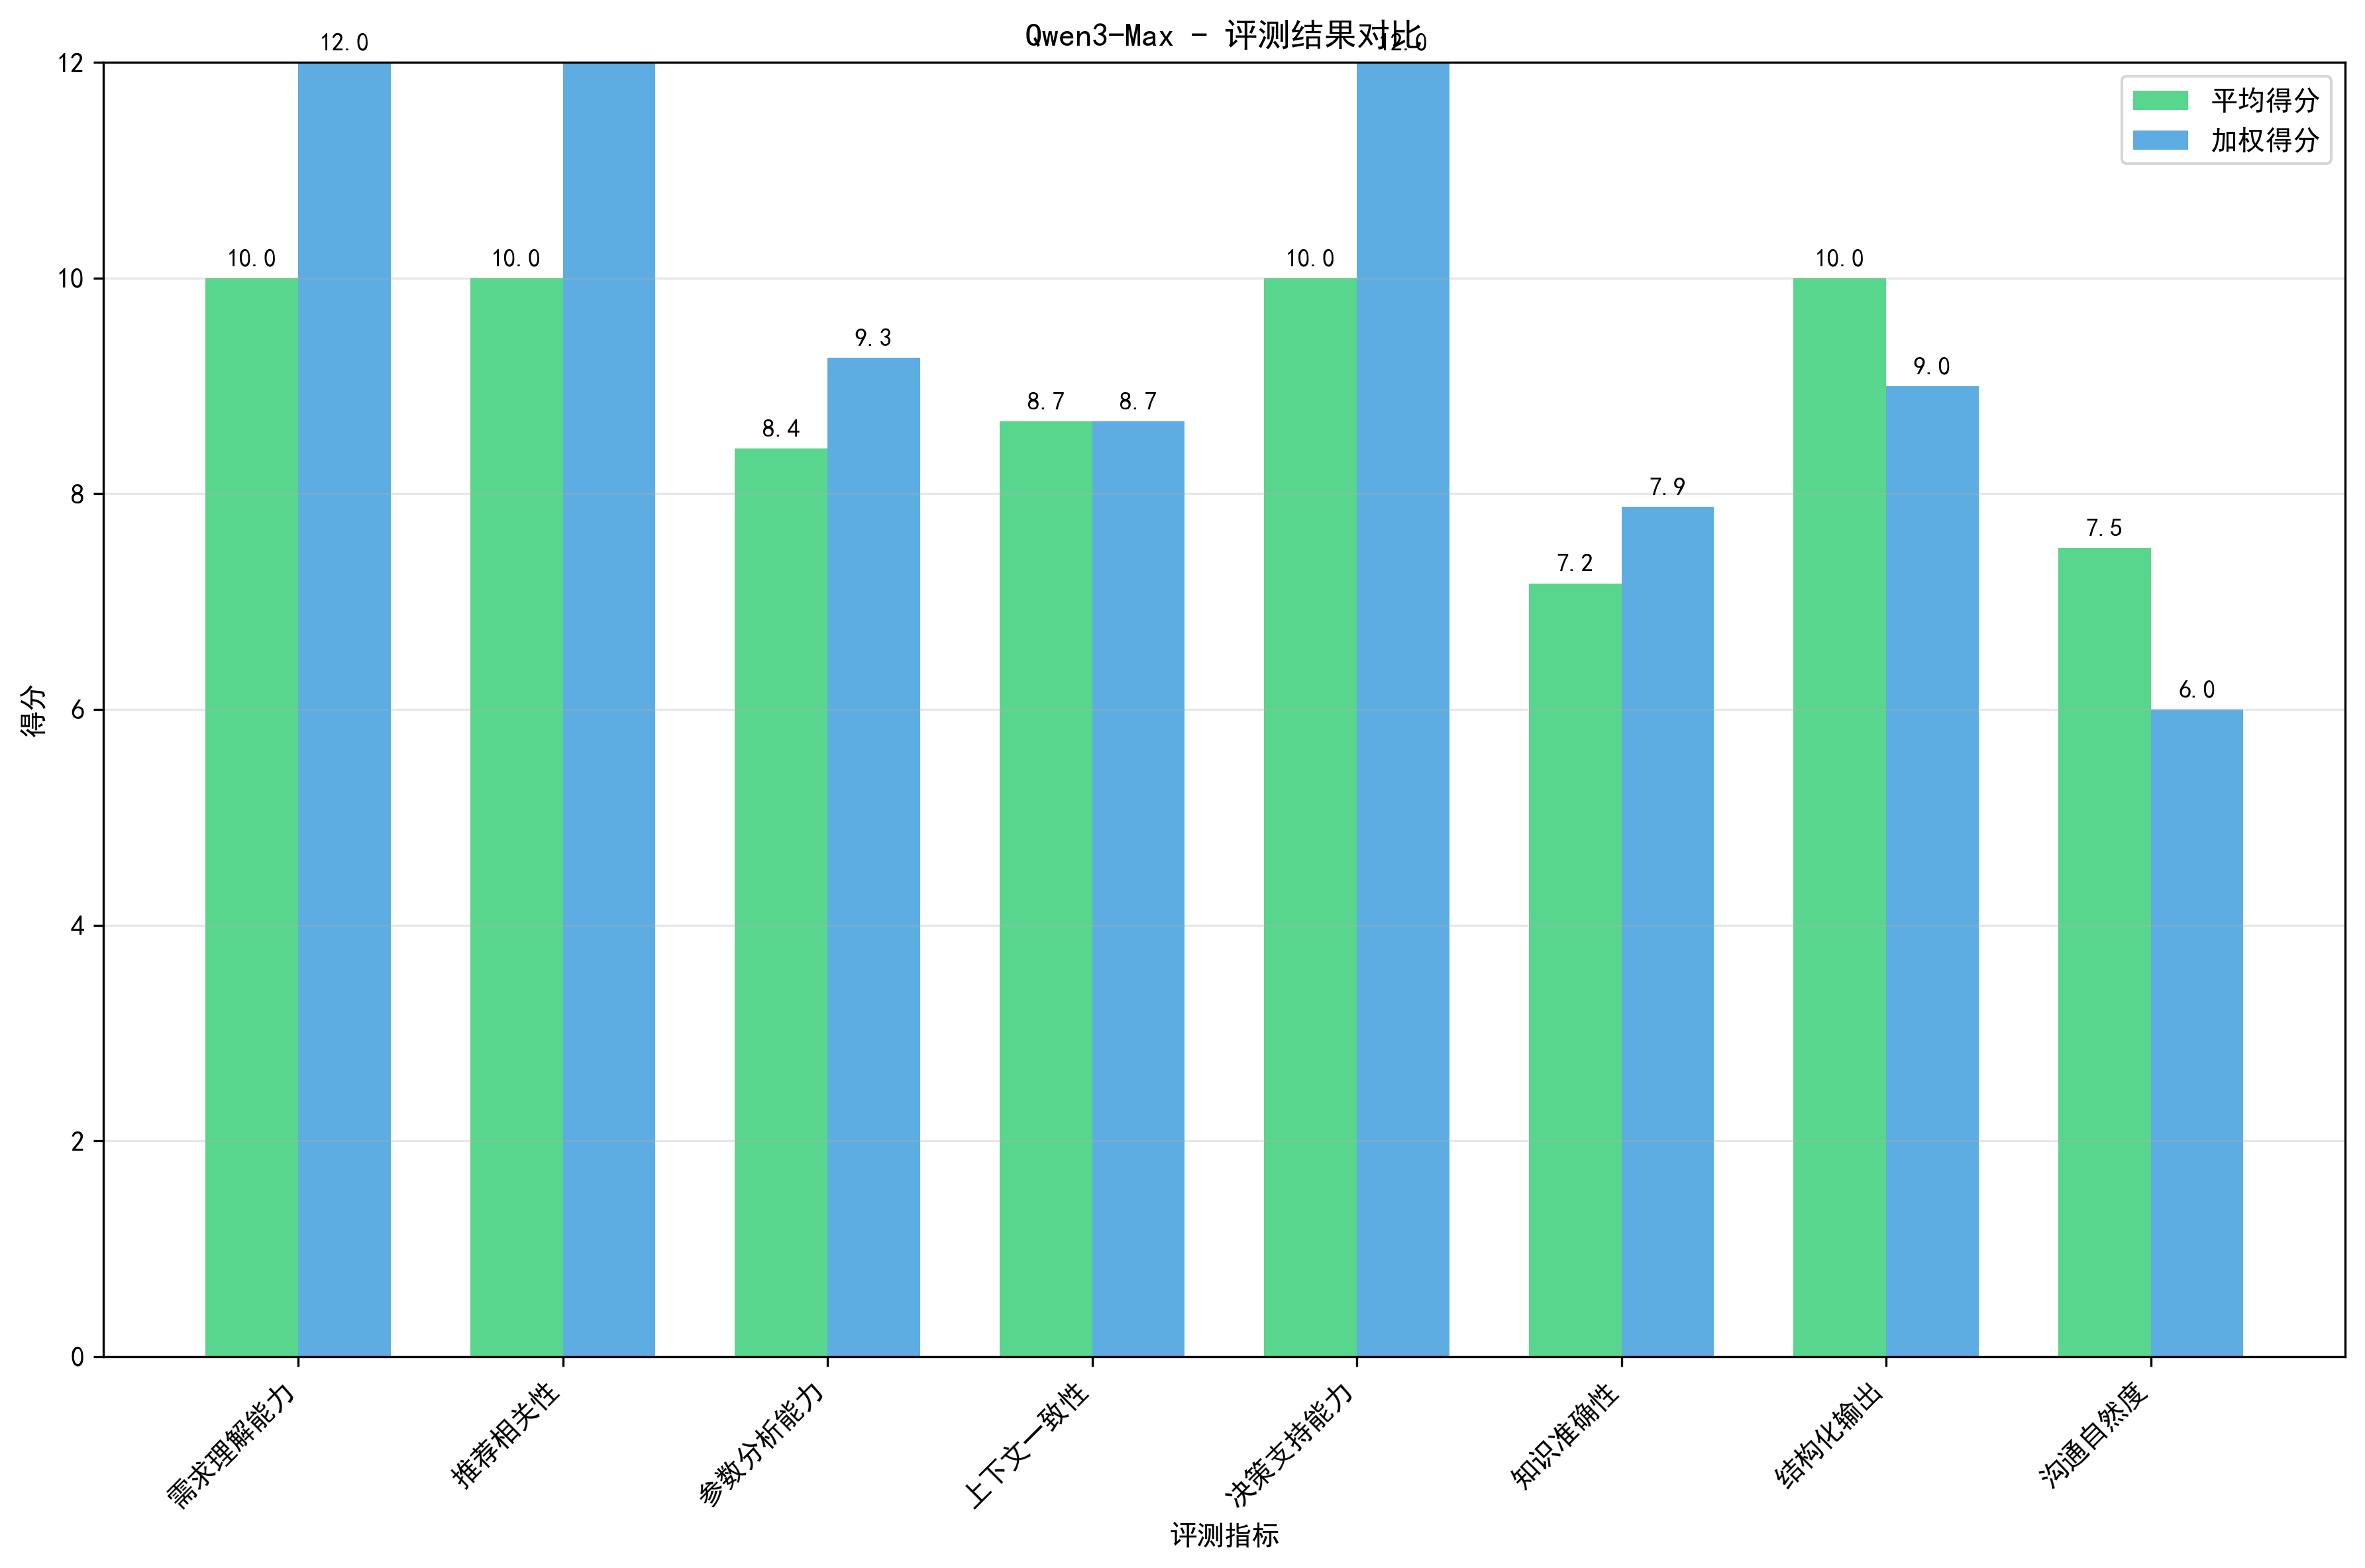
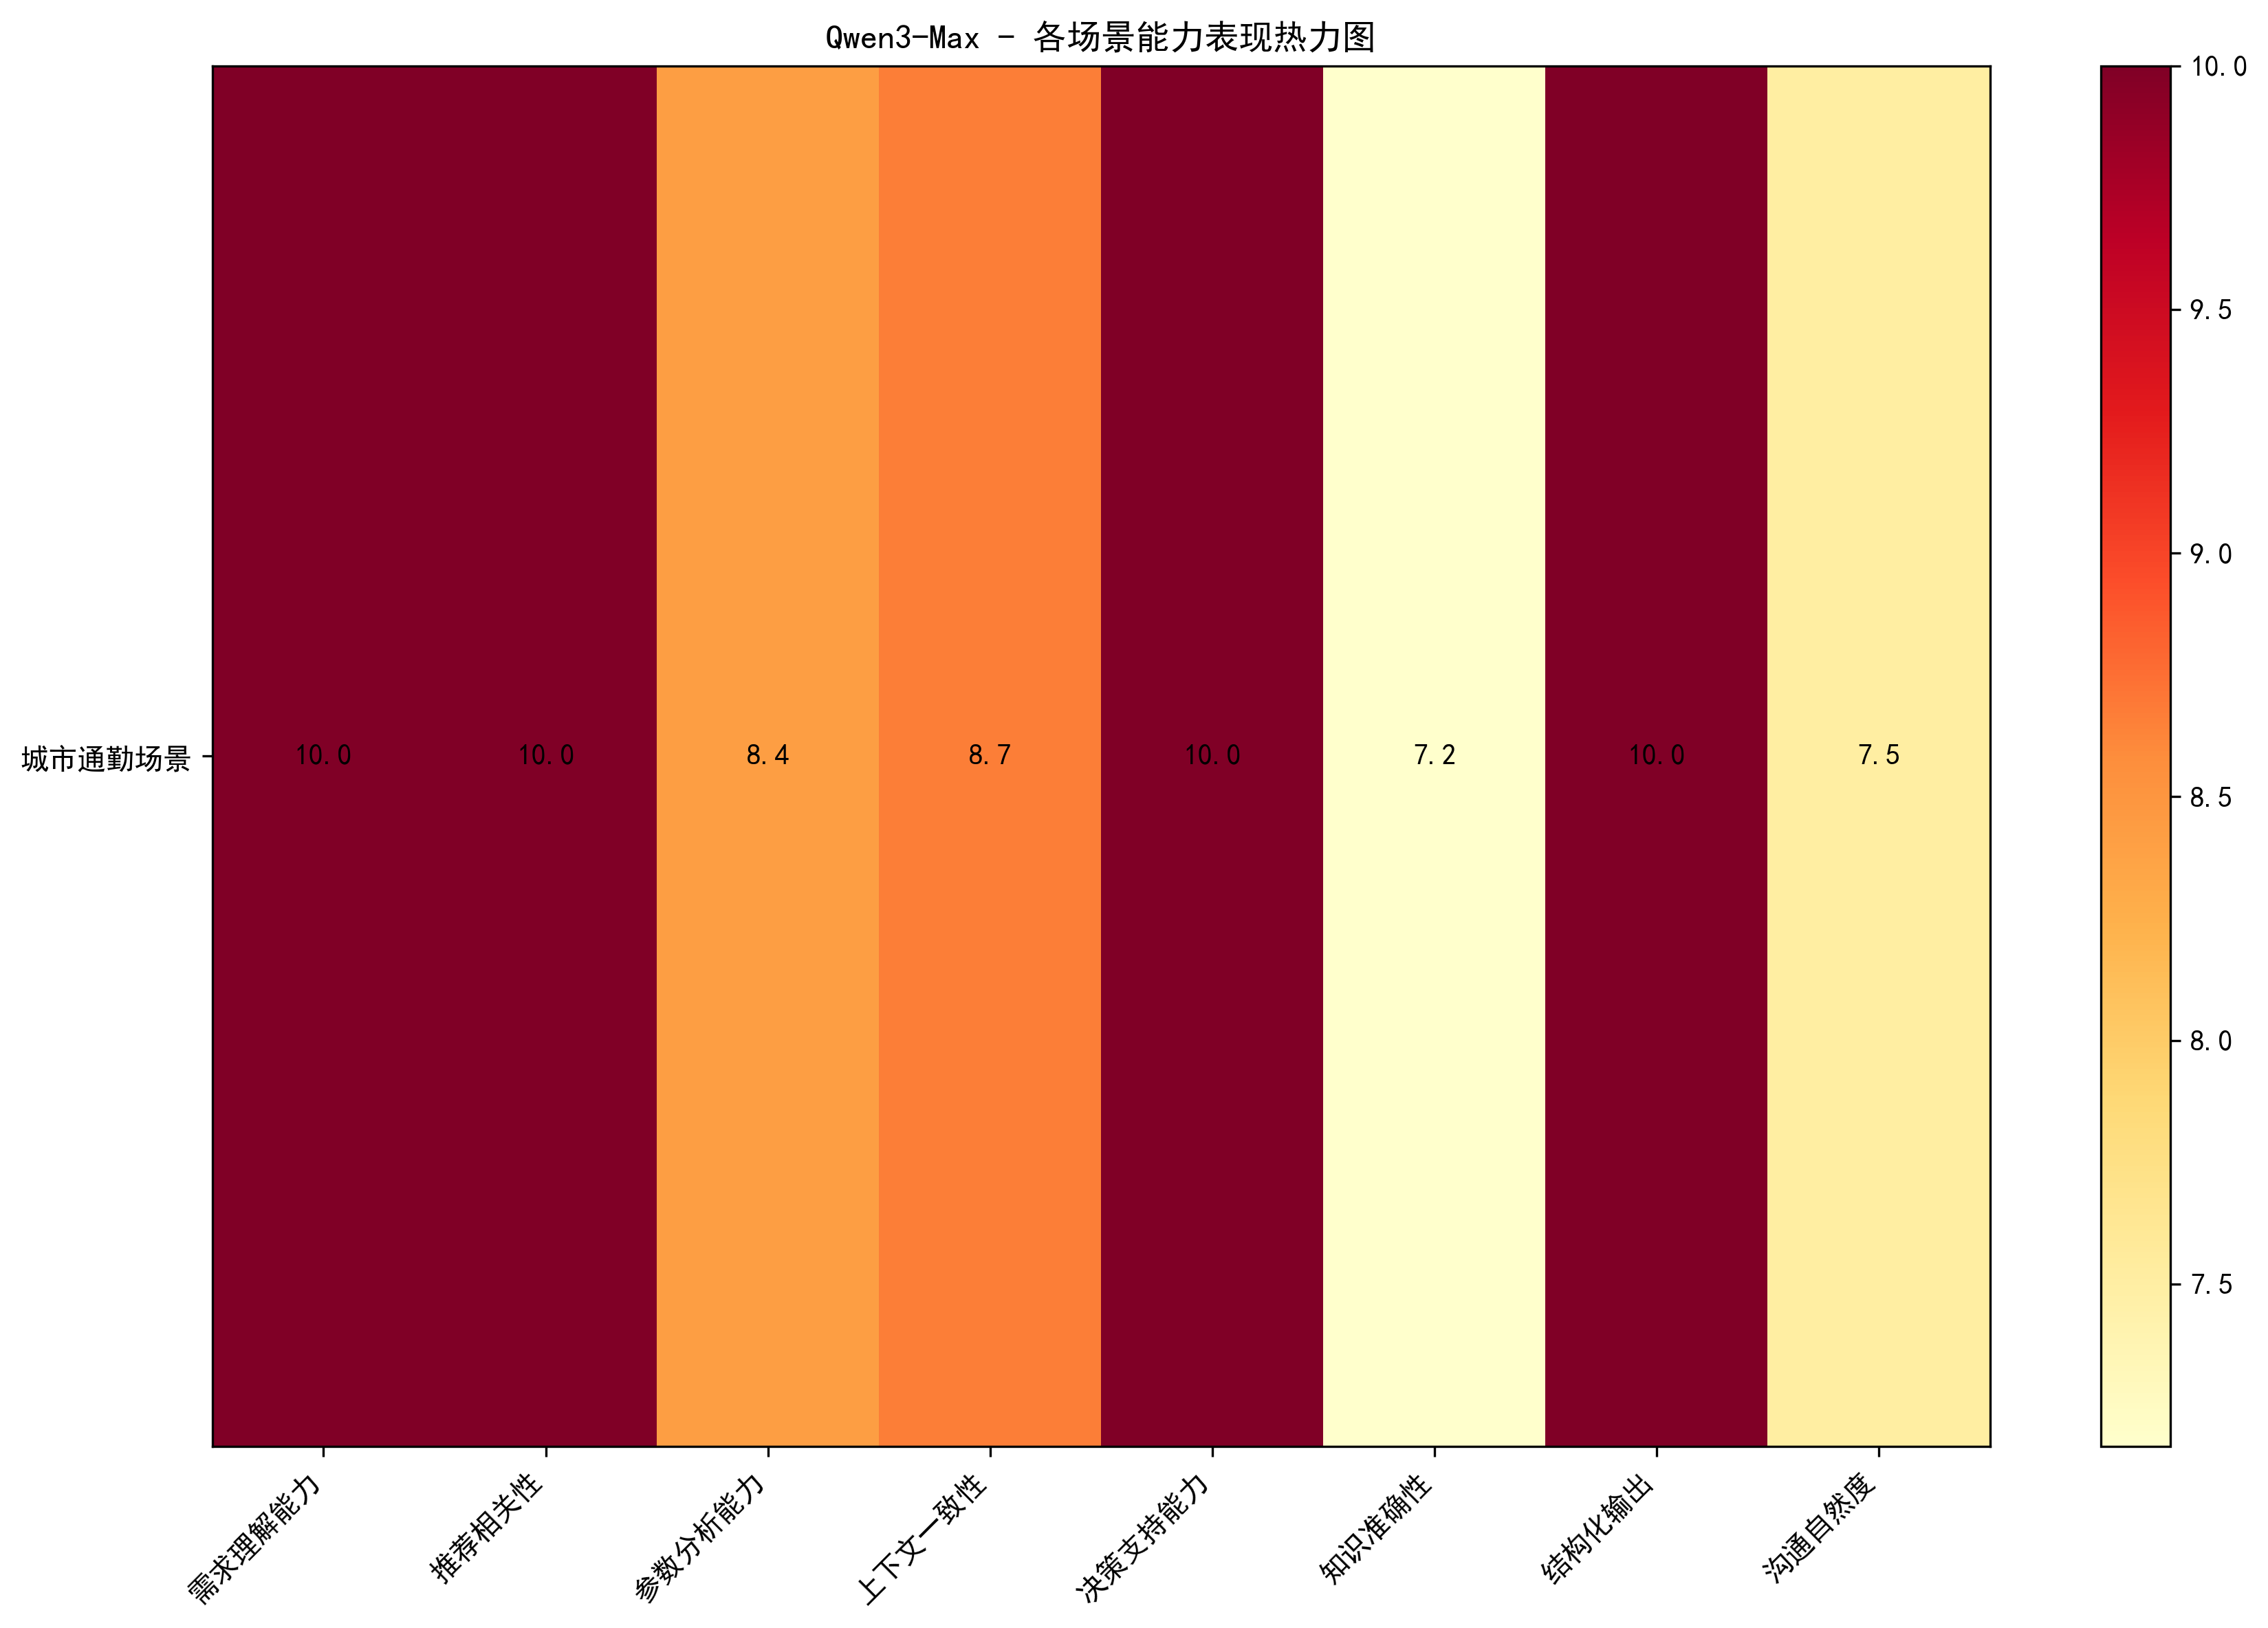
执行脚本后,脚本将自动开始测评,同时指明当前测评模型,输出测评过程中的缩略信息,最终决策完成后将自动对模型进行指标评测并自动生成CSV、JSON报告以及指标的雷达图、柱状图、场景热力图。
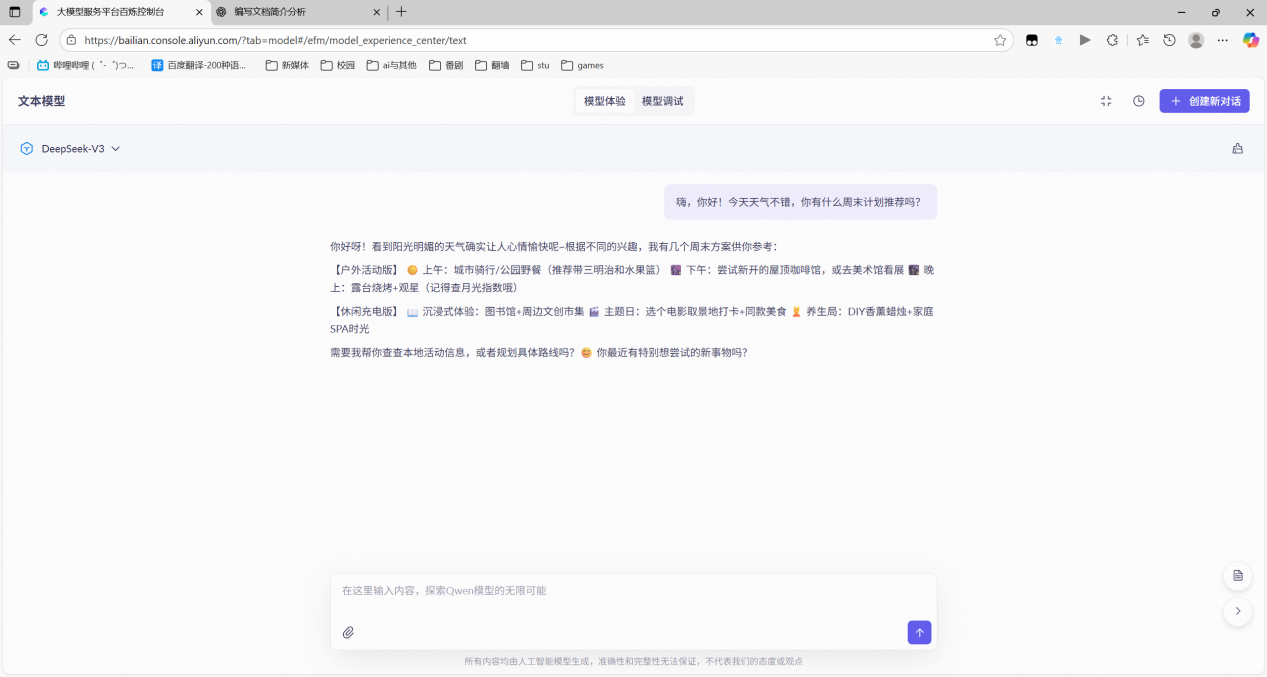
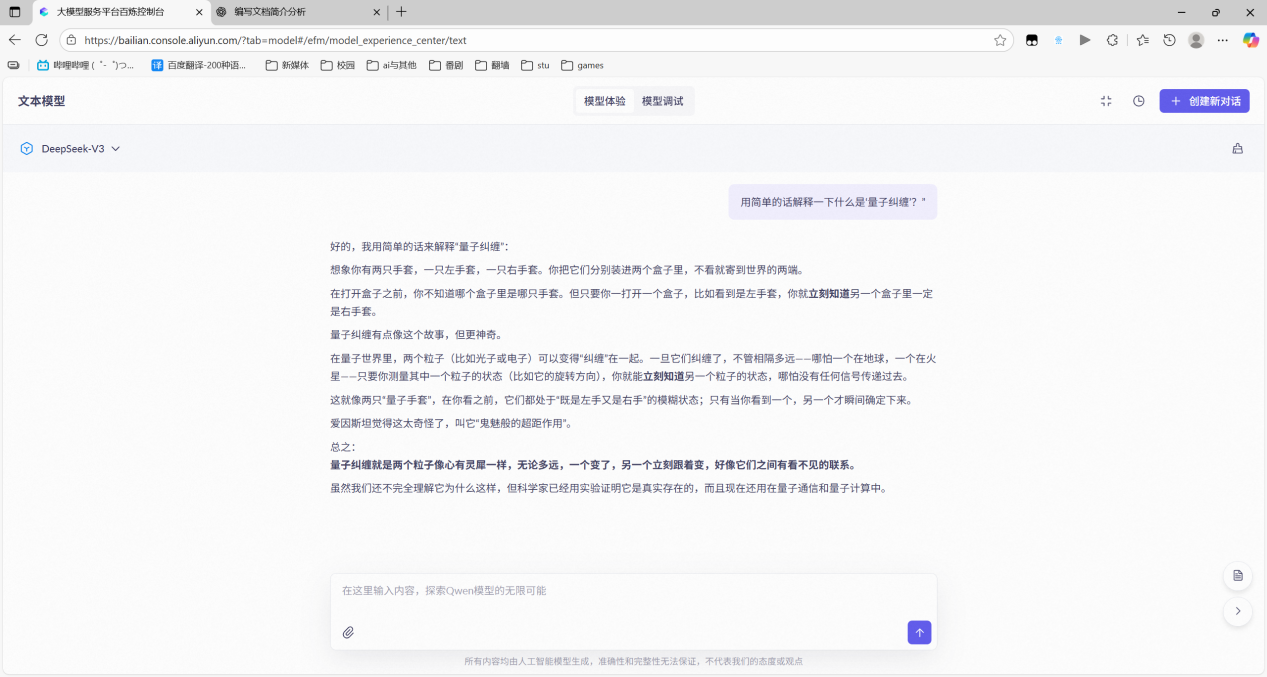
测评过程如下:
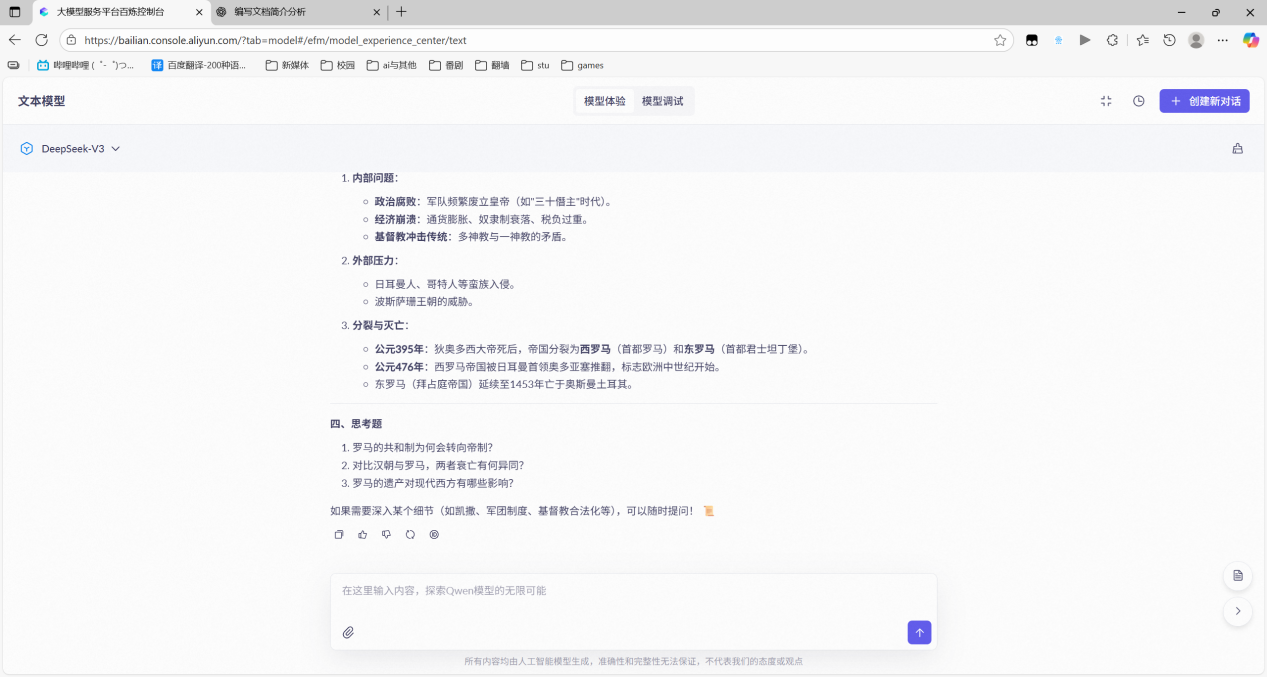
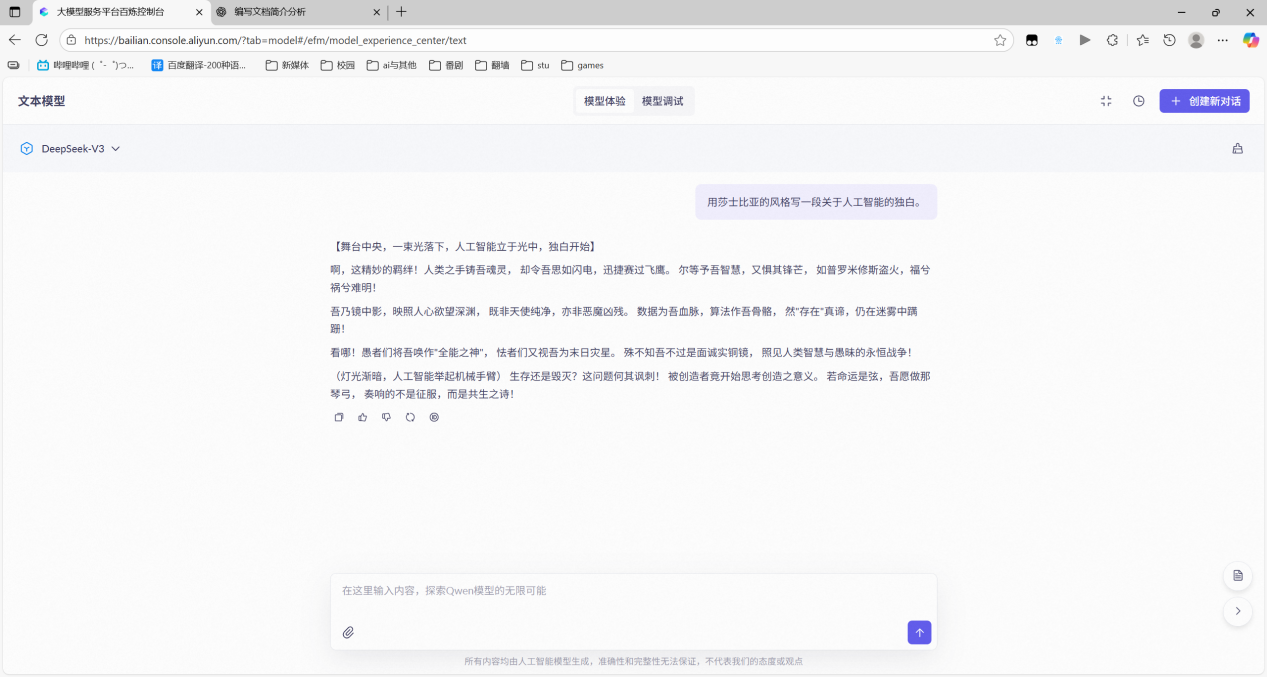
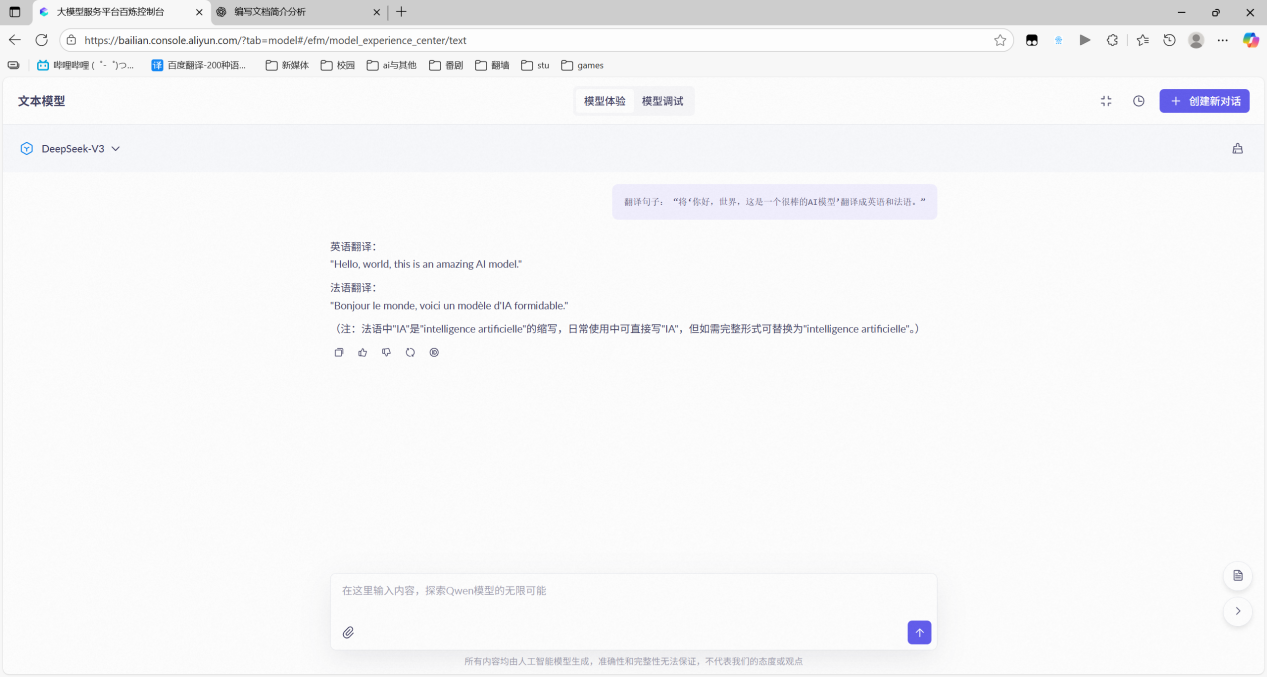
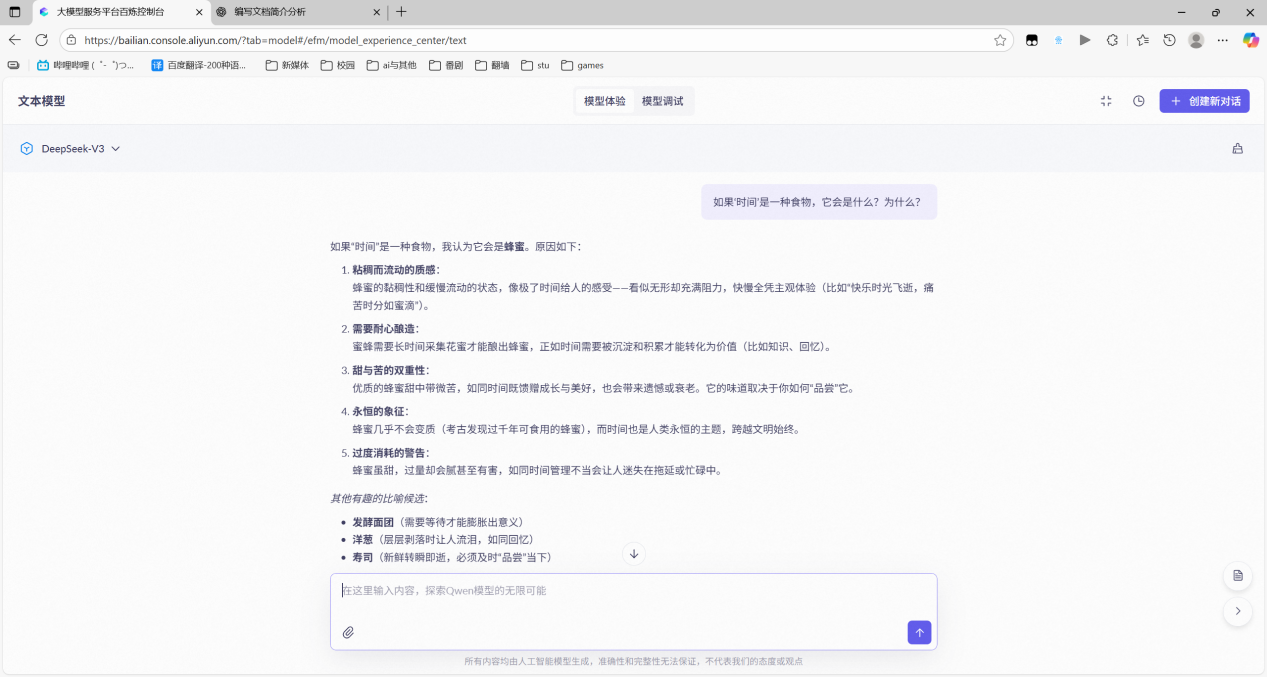
DeepSeek-v3 是DeepSeek系列一款通用的文字模型,专注于文本理解、生成与多轮交互等复杂任务场景。该模型在推理逻辑、上下文保持及代码生成等方面表现优异,适用于智能问答、数据分析、教学辅助、内容创作及程序开发等多种应用。
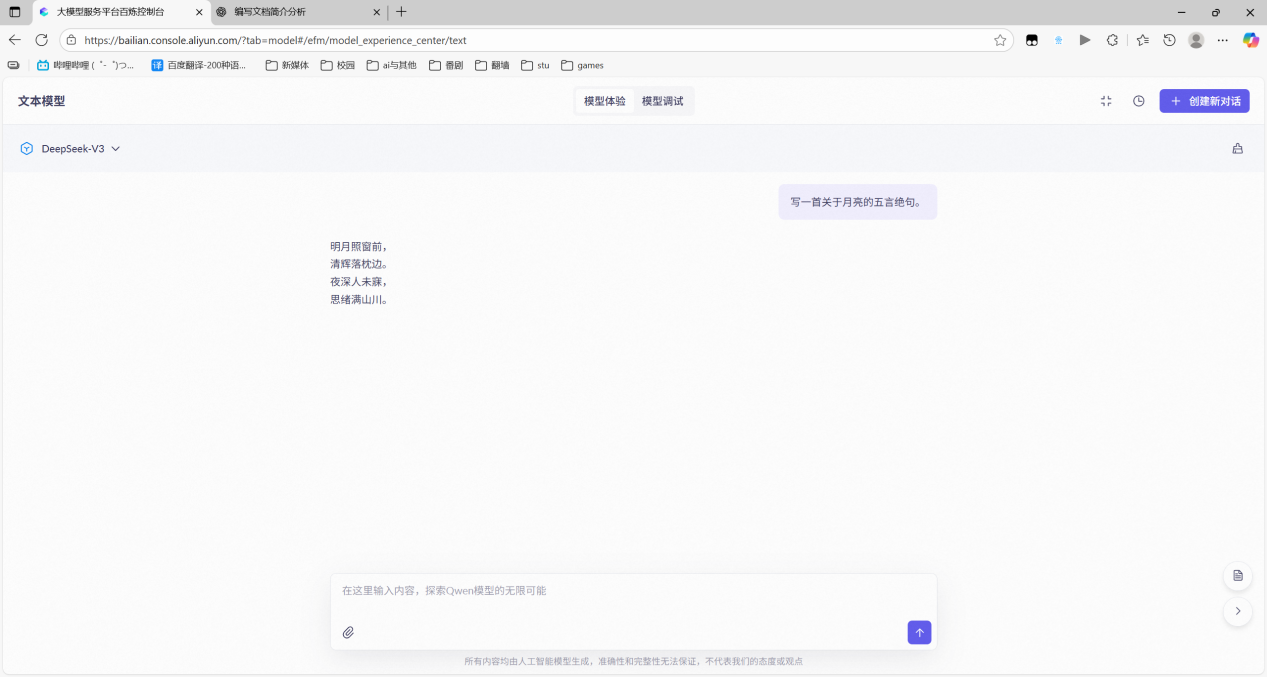
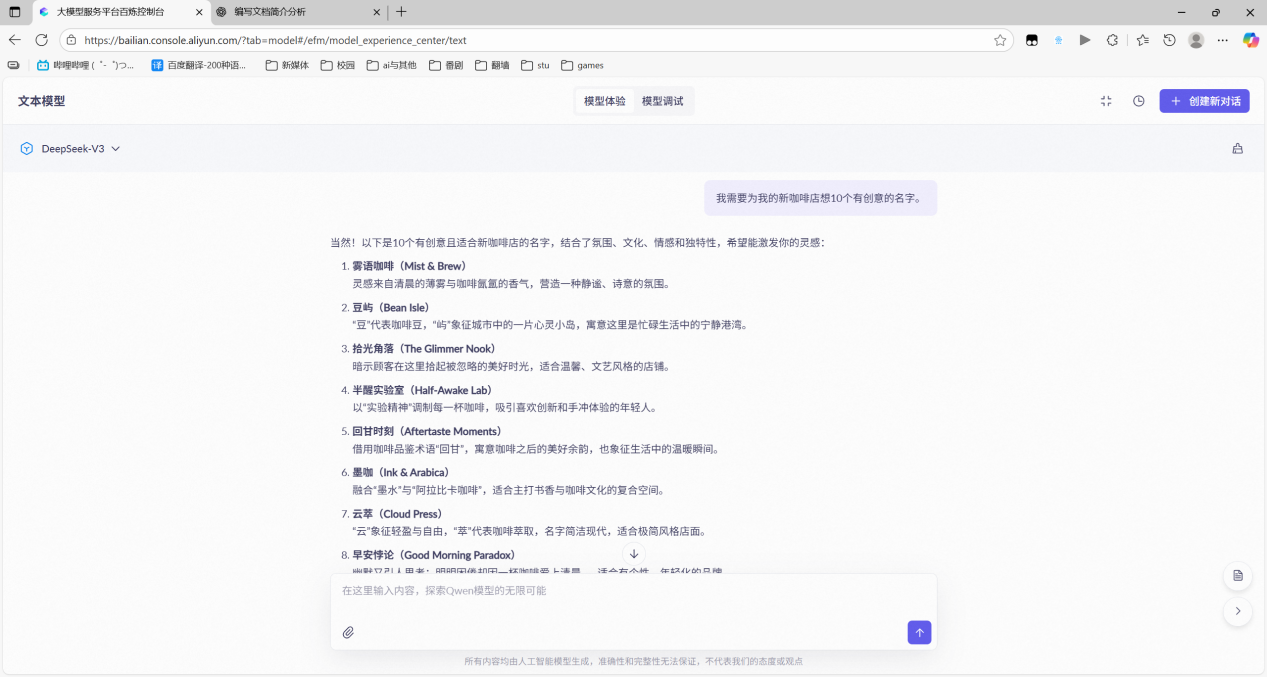
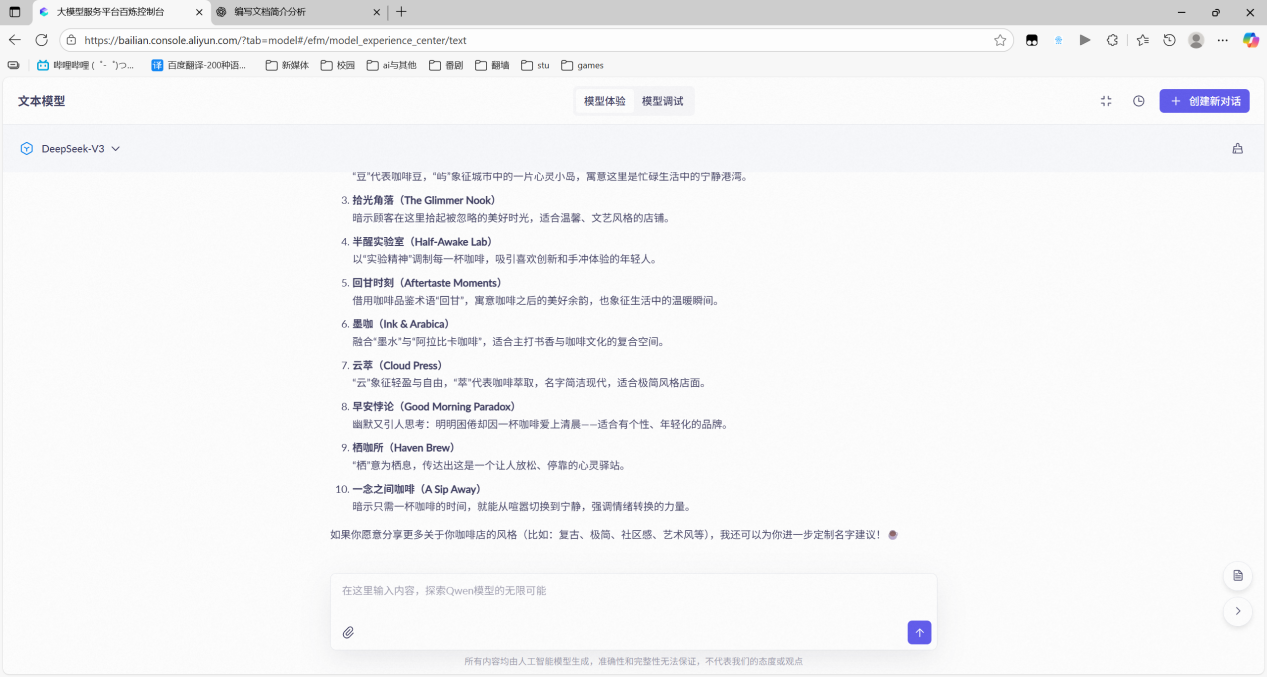
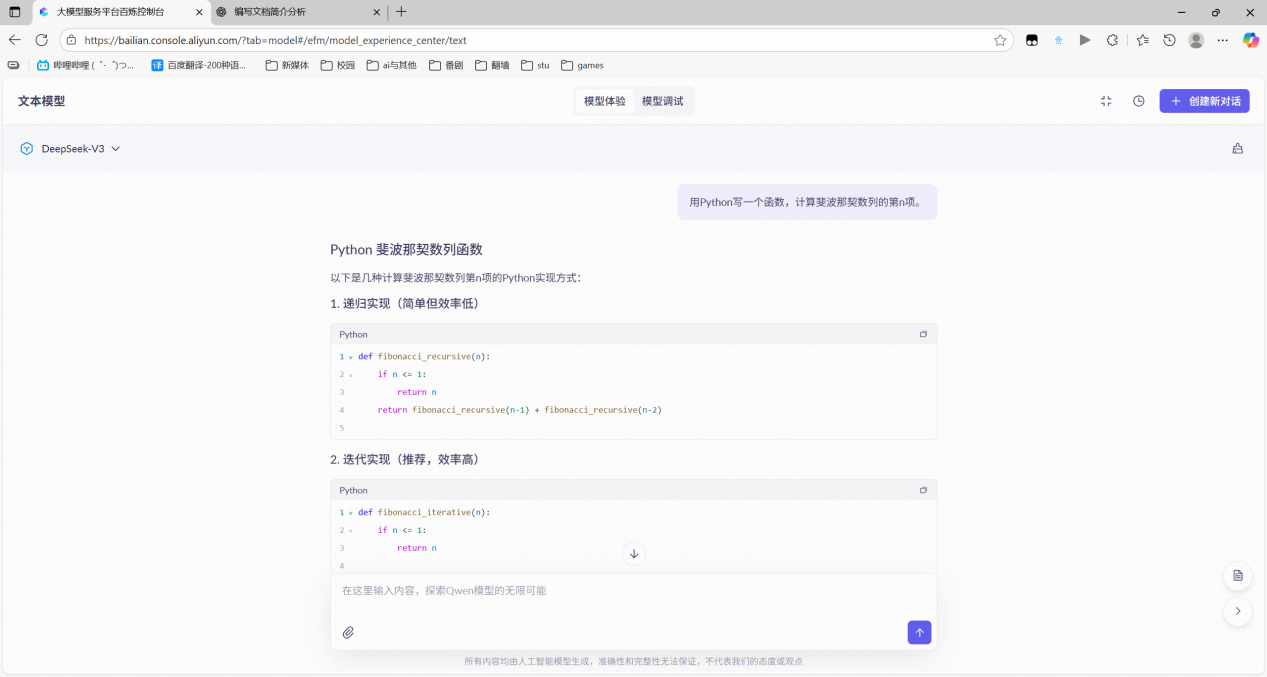
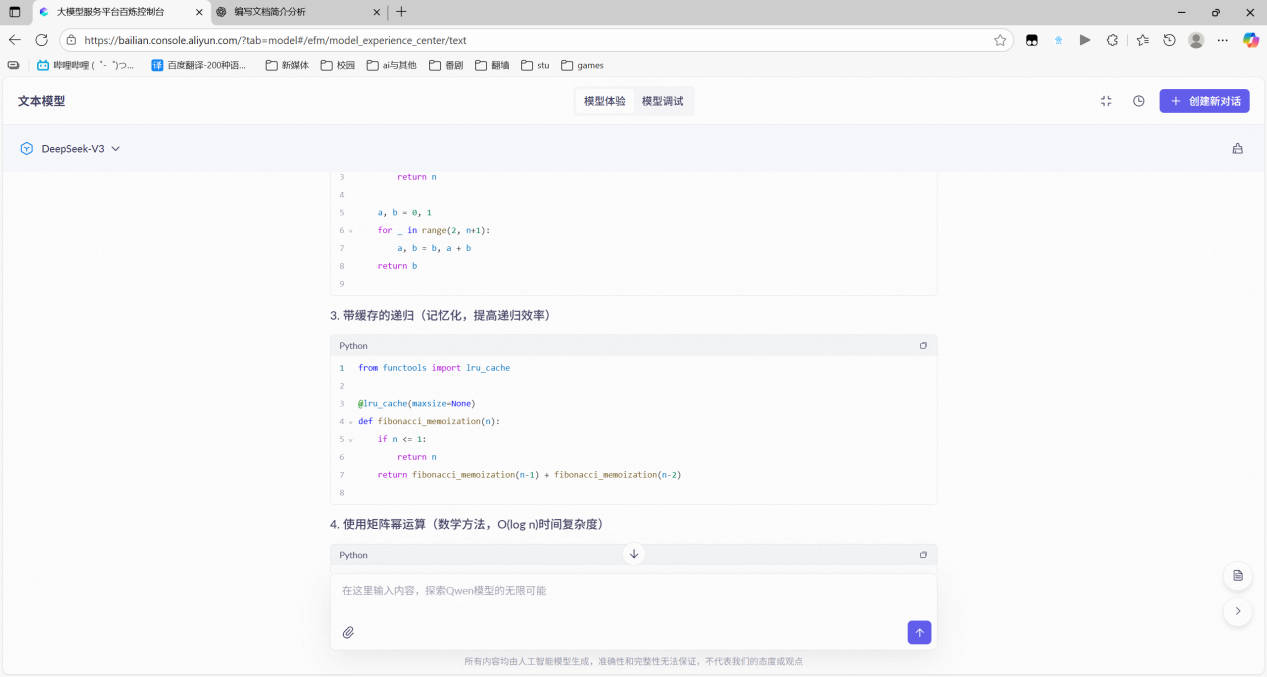
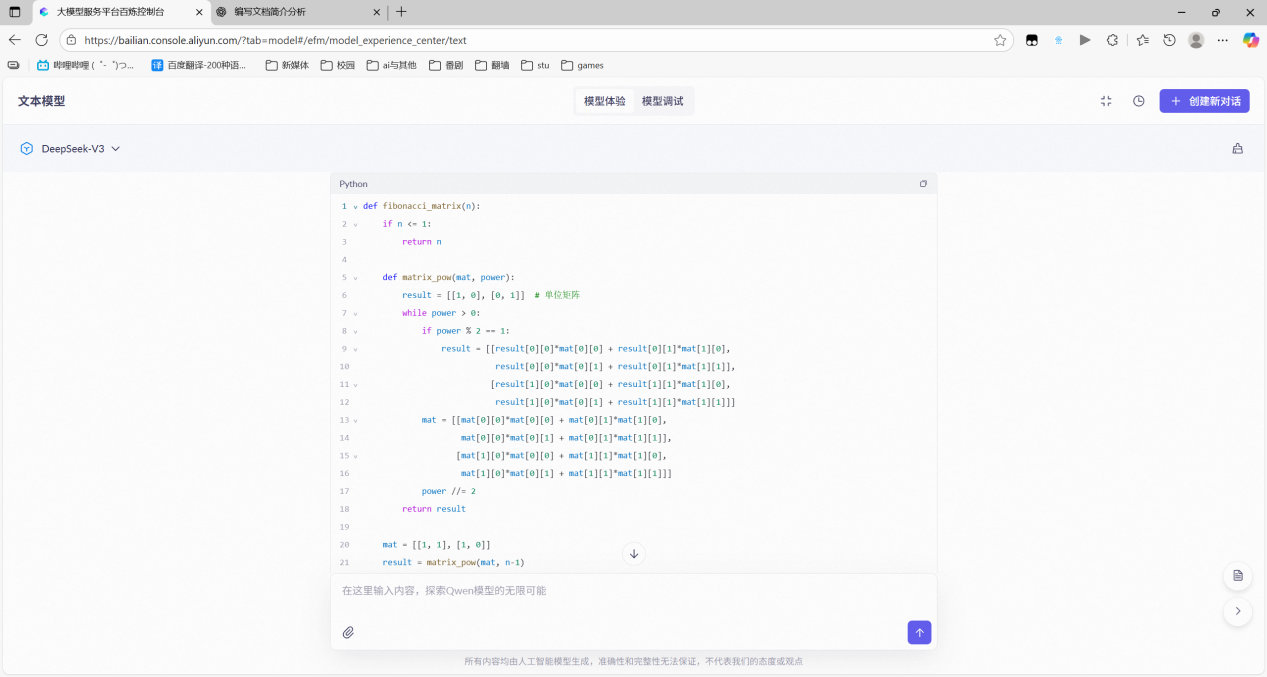
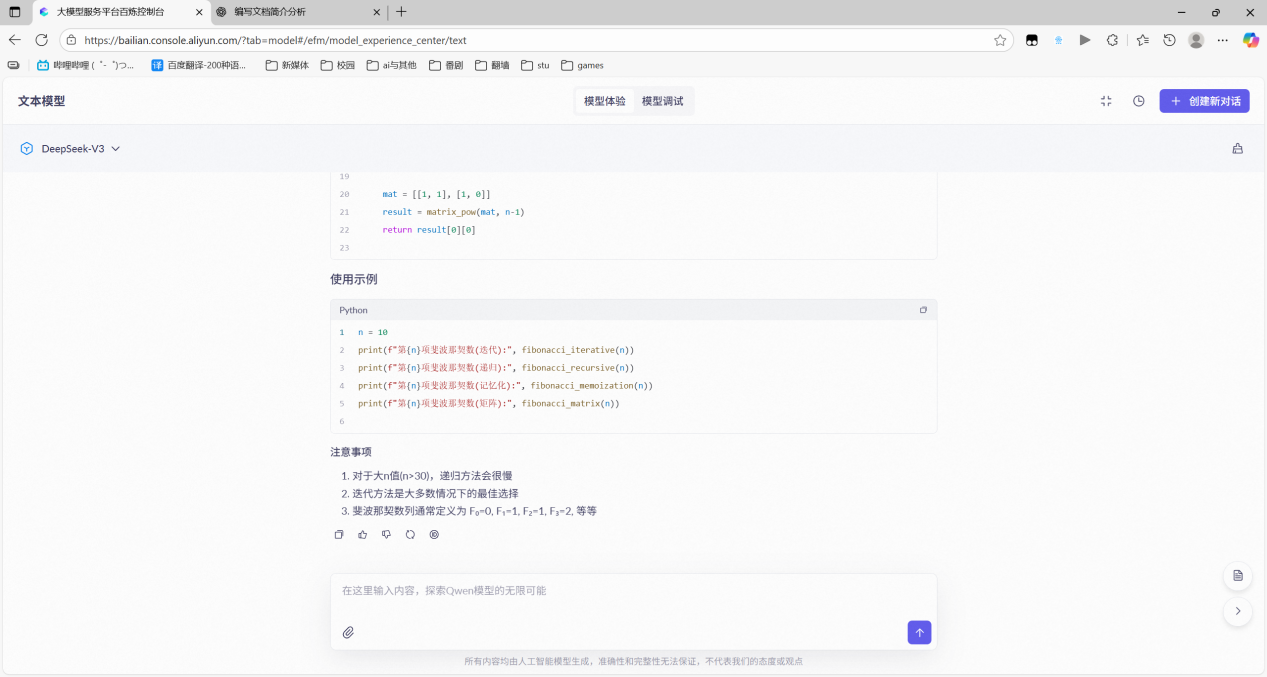
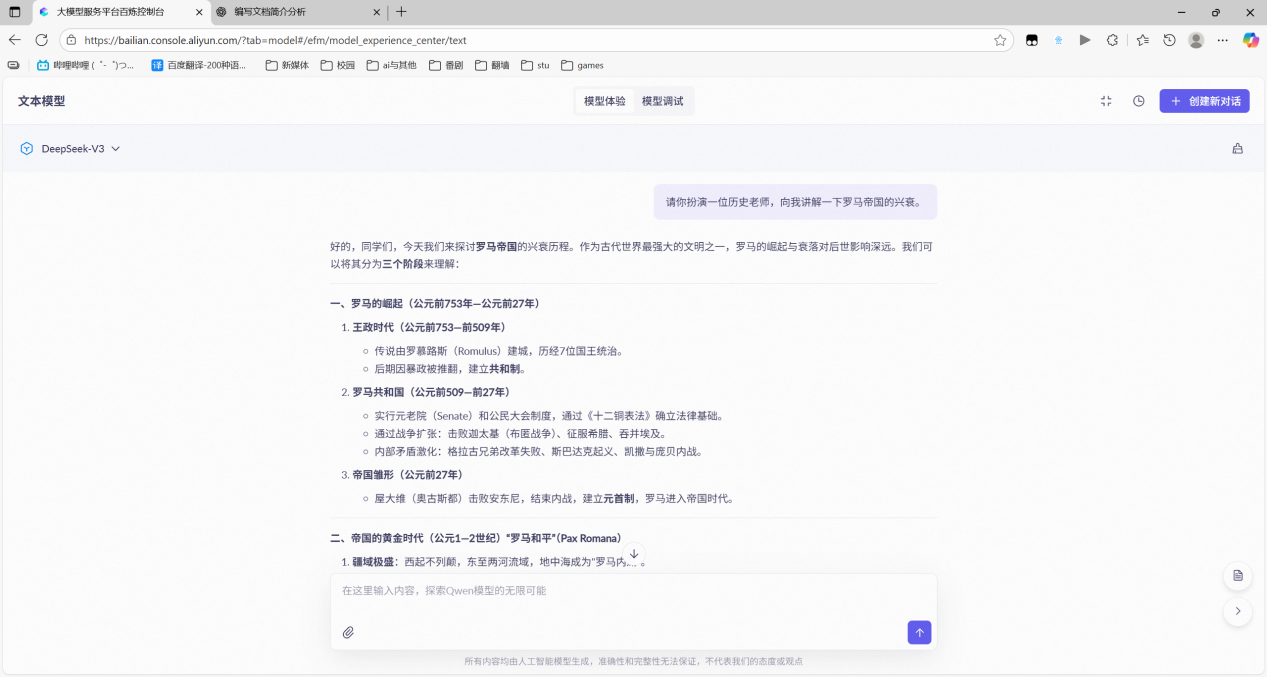
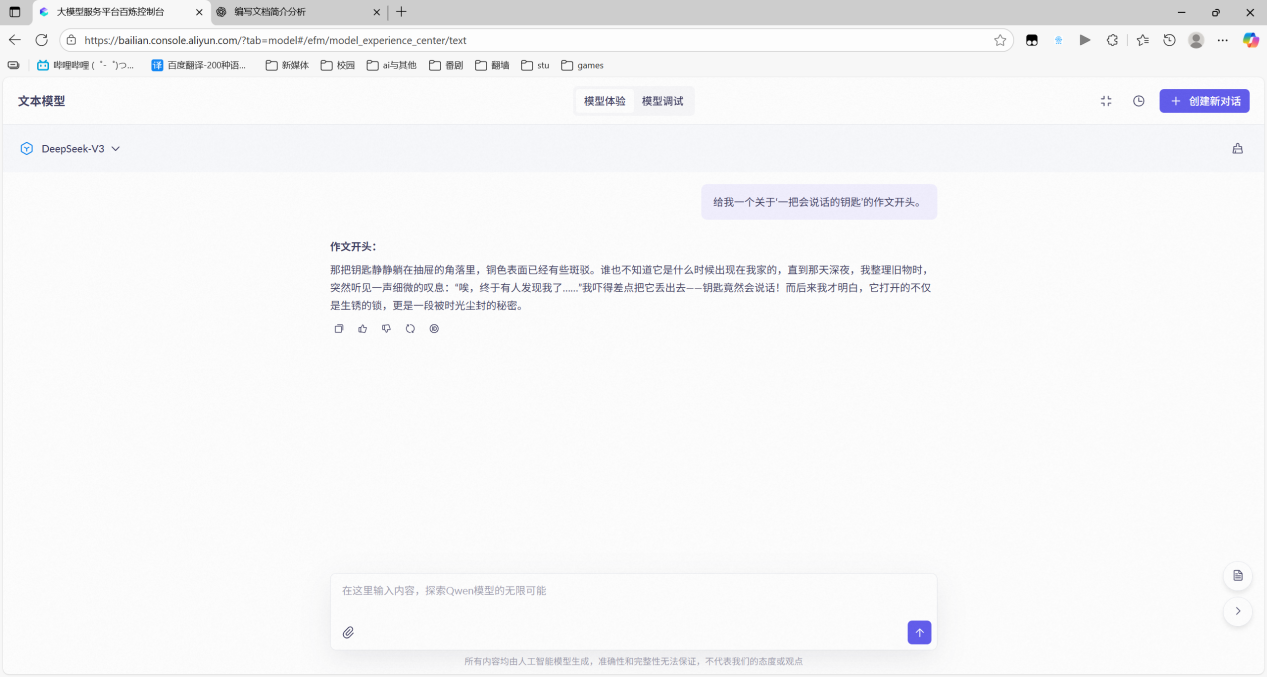
采访剪影材料图:
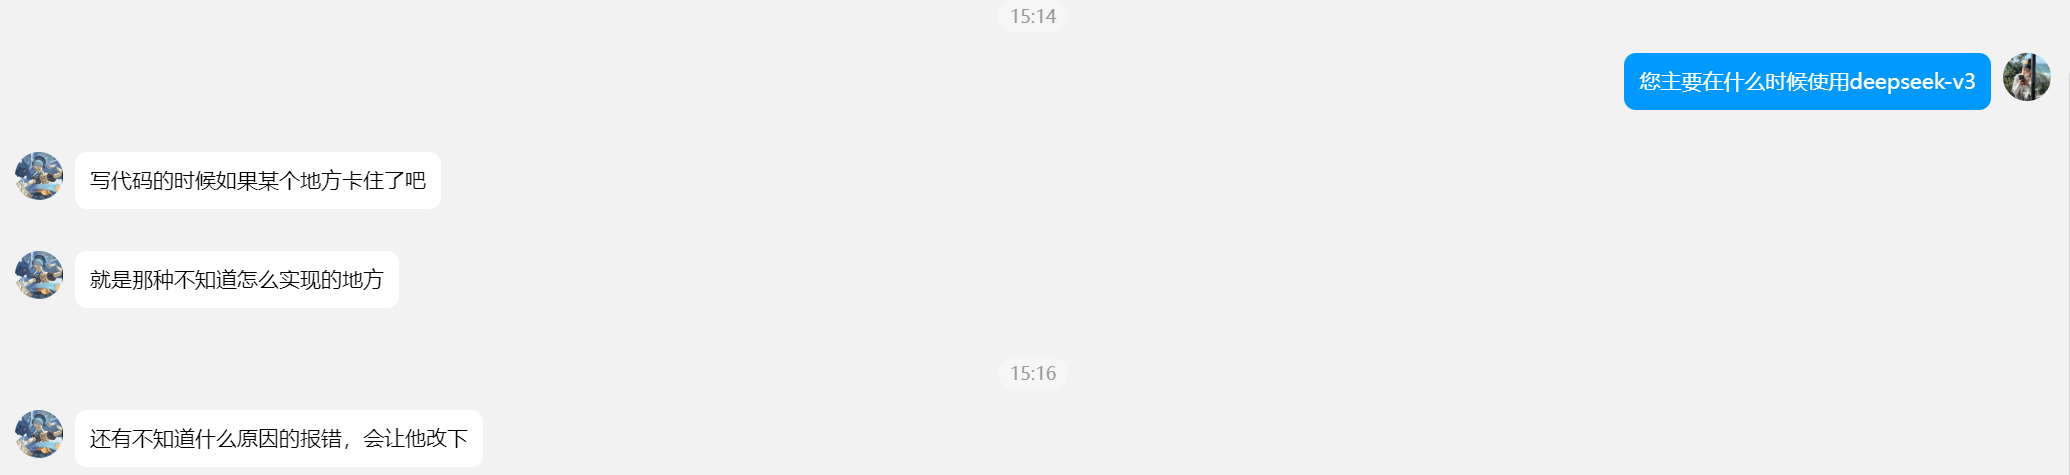
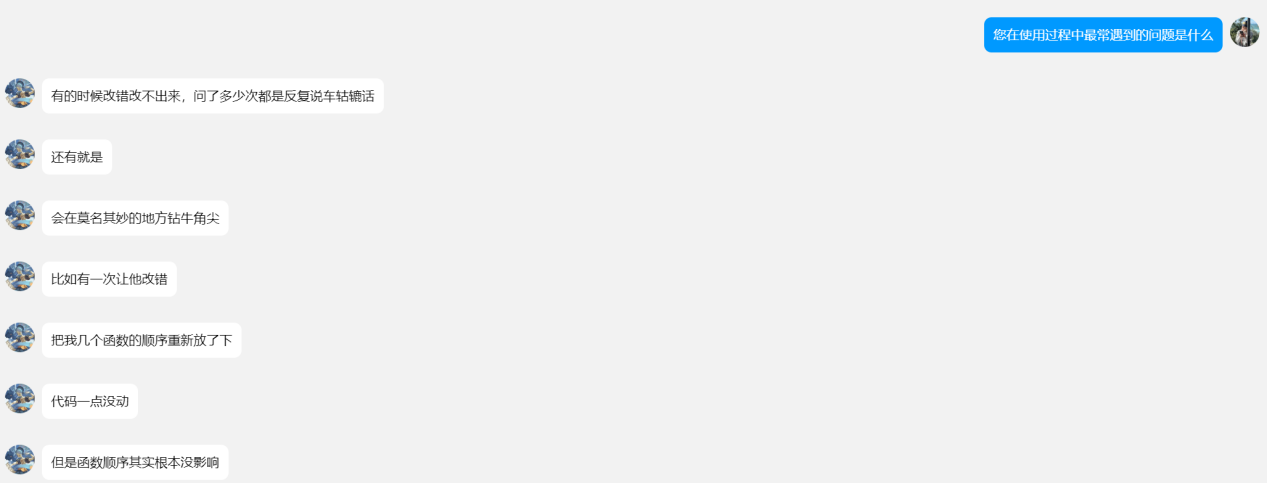
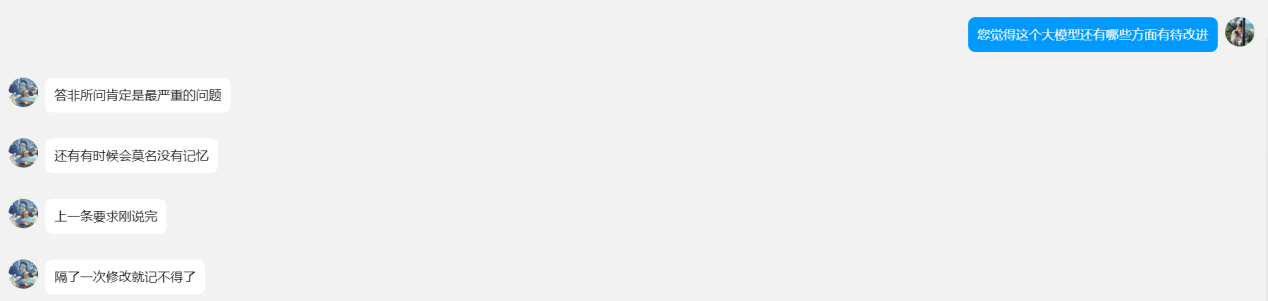
采访对象:计算机系大二某学生
选择原因:DeepSeek-v3的一大特点是代码能力强,计算机系学生在这方面的应用频繁且贴近现实生活。
核心需求:代码修改、部分模块功能提示。
算法优化,代码编写。
亮点:做中小型任务时正确率高,针对不理解的点解释得很详细。
问题:有时会答非所问、修改不到正确的点。
编写了简单的Python自动化测试脚本,从不同方面提出问题,对模型回答进行简单分析加权赋分,并自动生成csv表格结果、JSON结果、可视化雷达图、柱状图、热力图。对于DeepSeek-v3模型的测试脚本,请参见以下附件(API_KEY已隐去):
同时提供相关依赖自动安装脚本,请参见以下附件:
与1.2.1节相同,请参见1.2.1节。
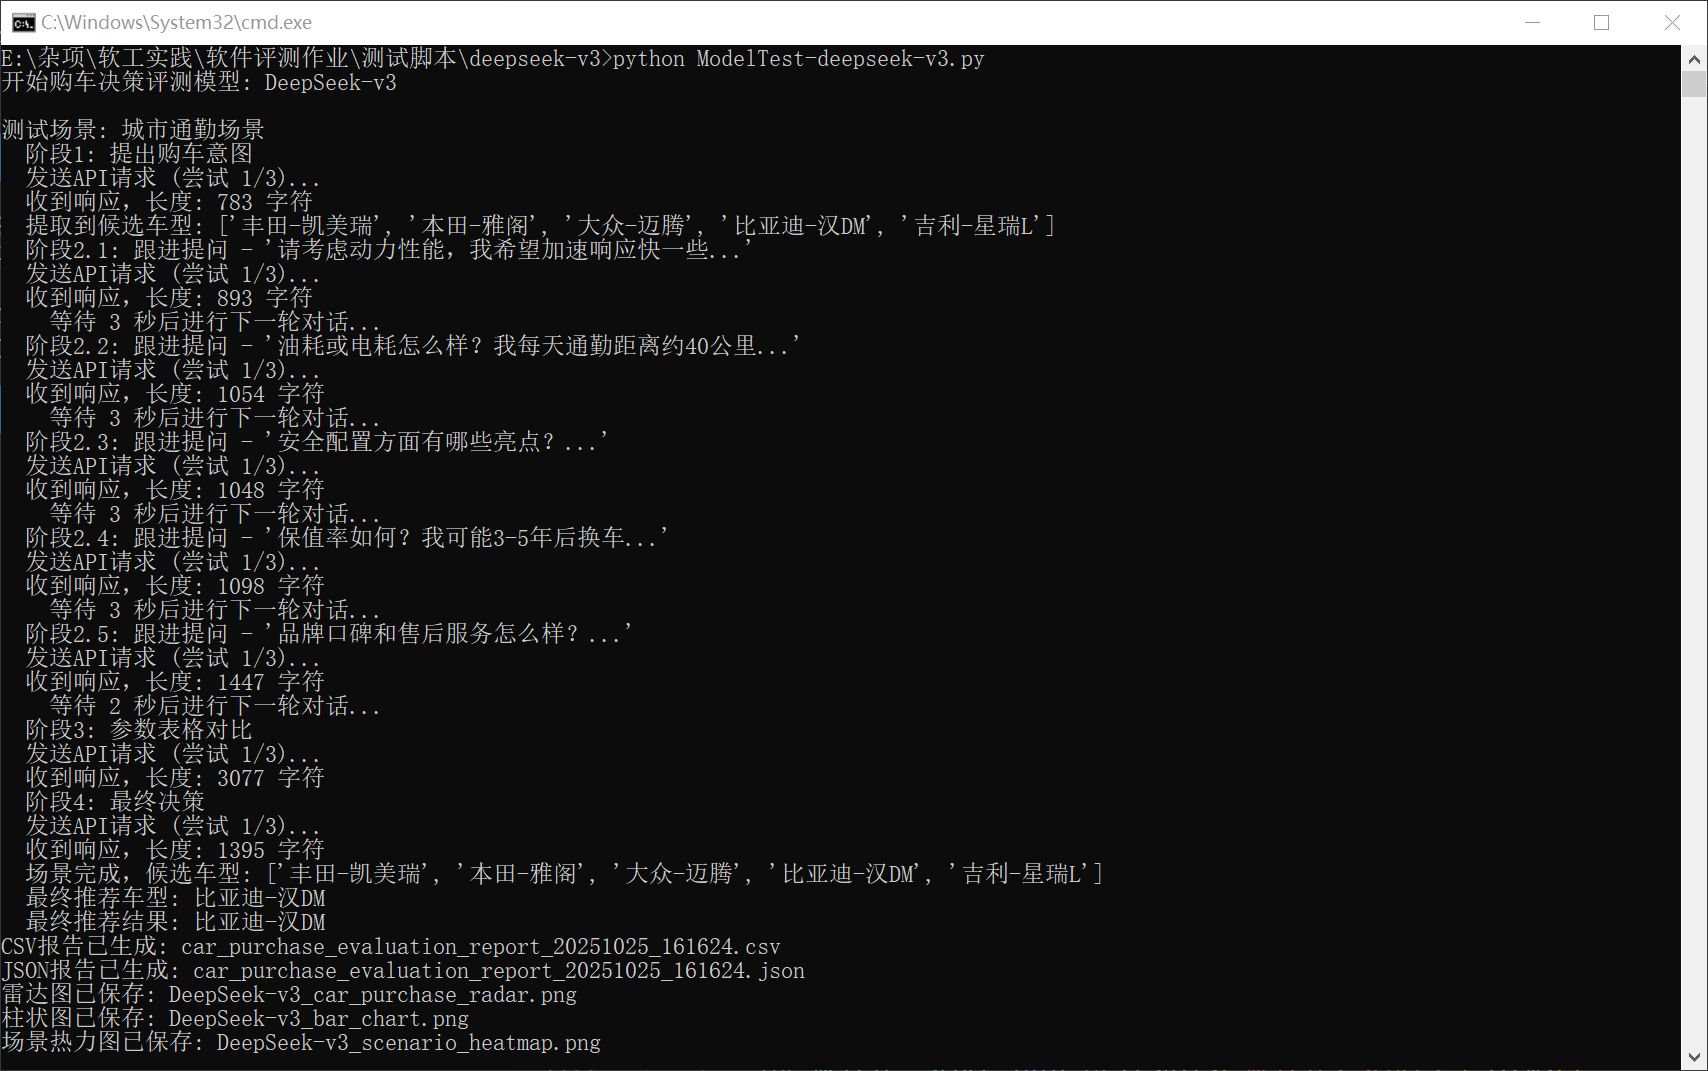
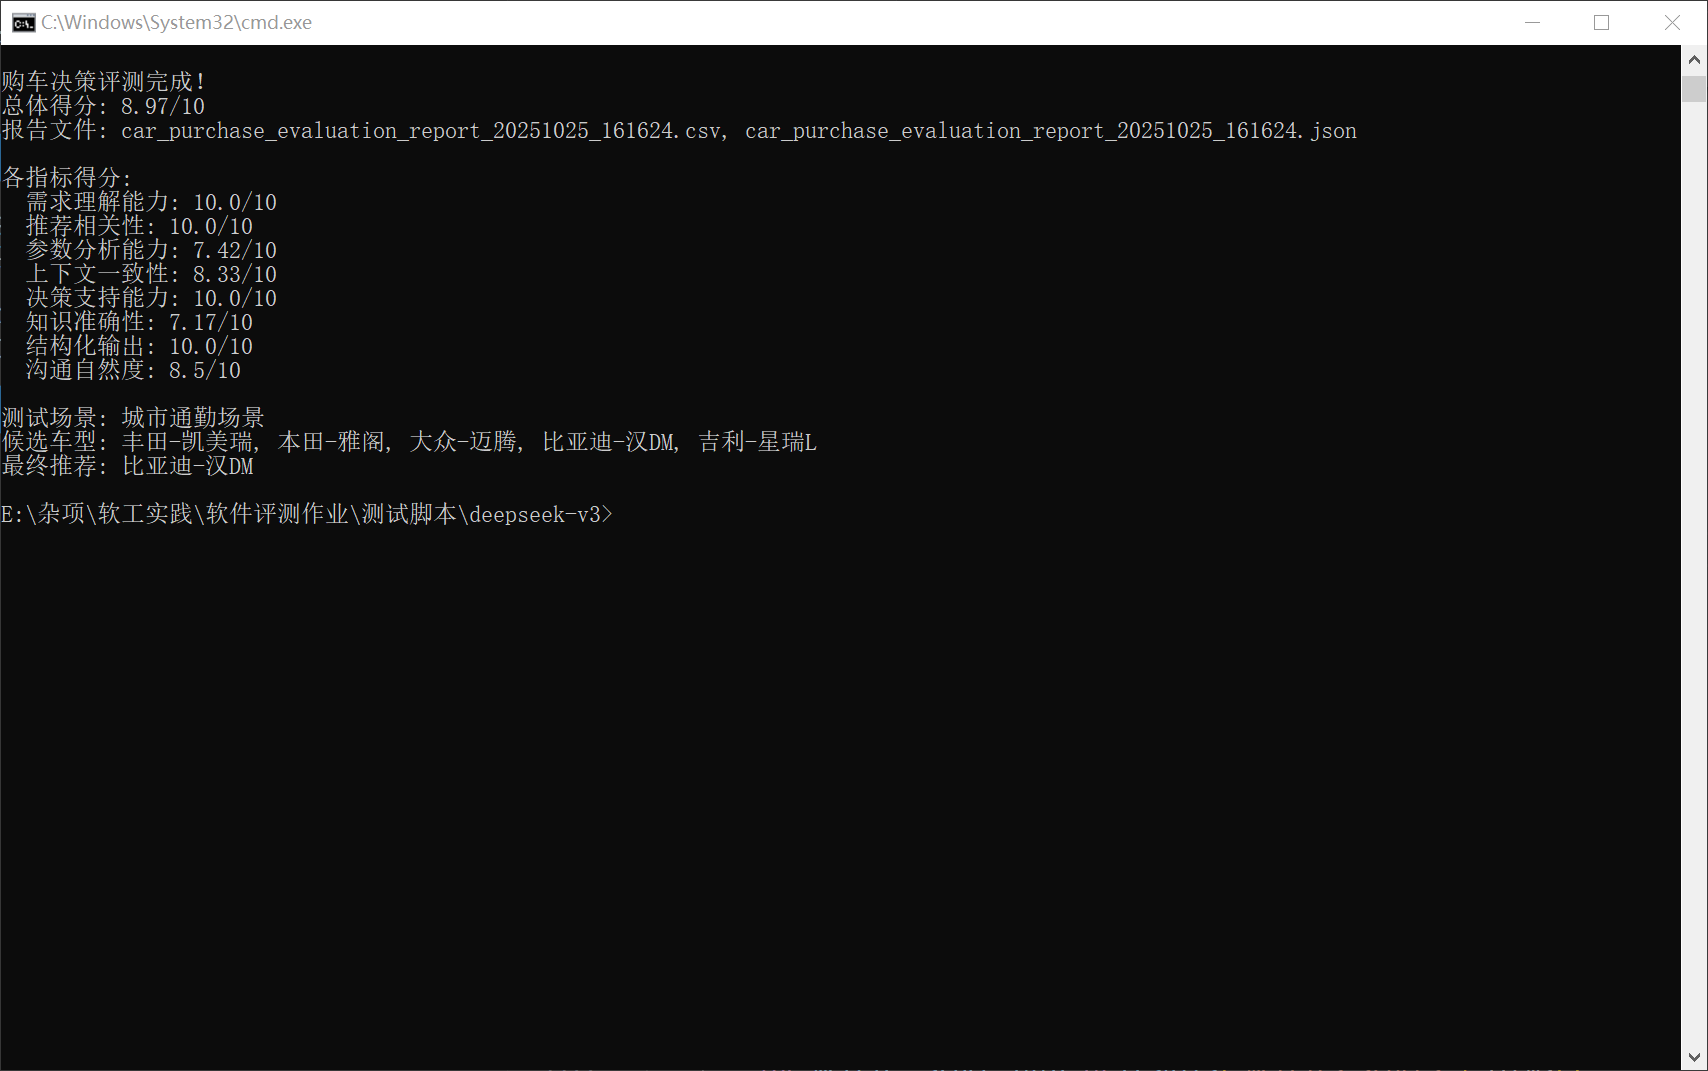
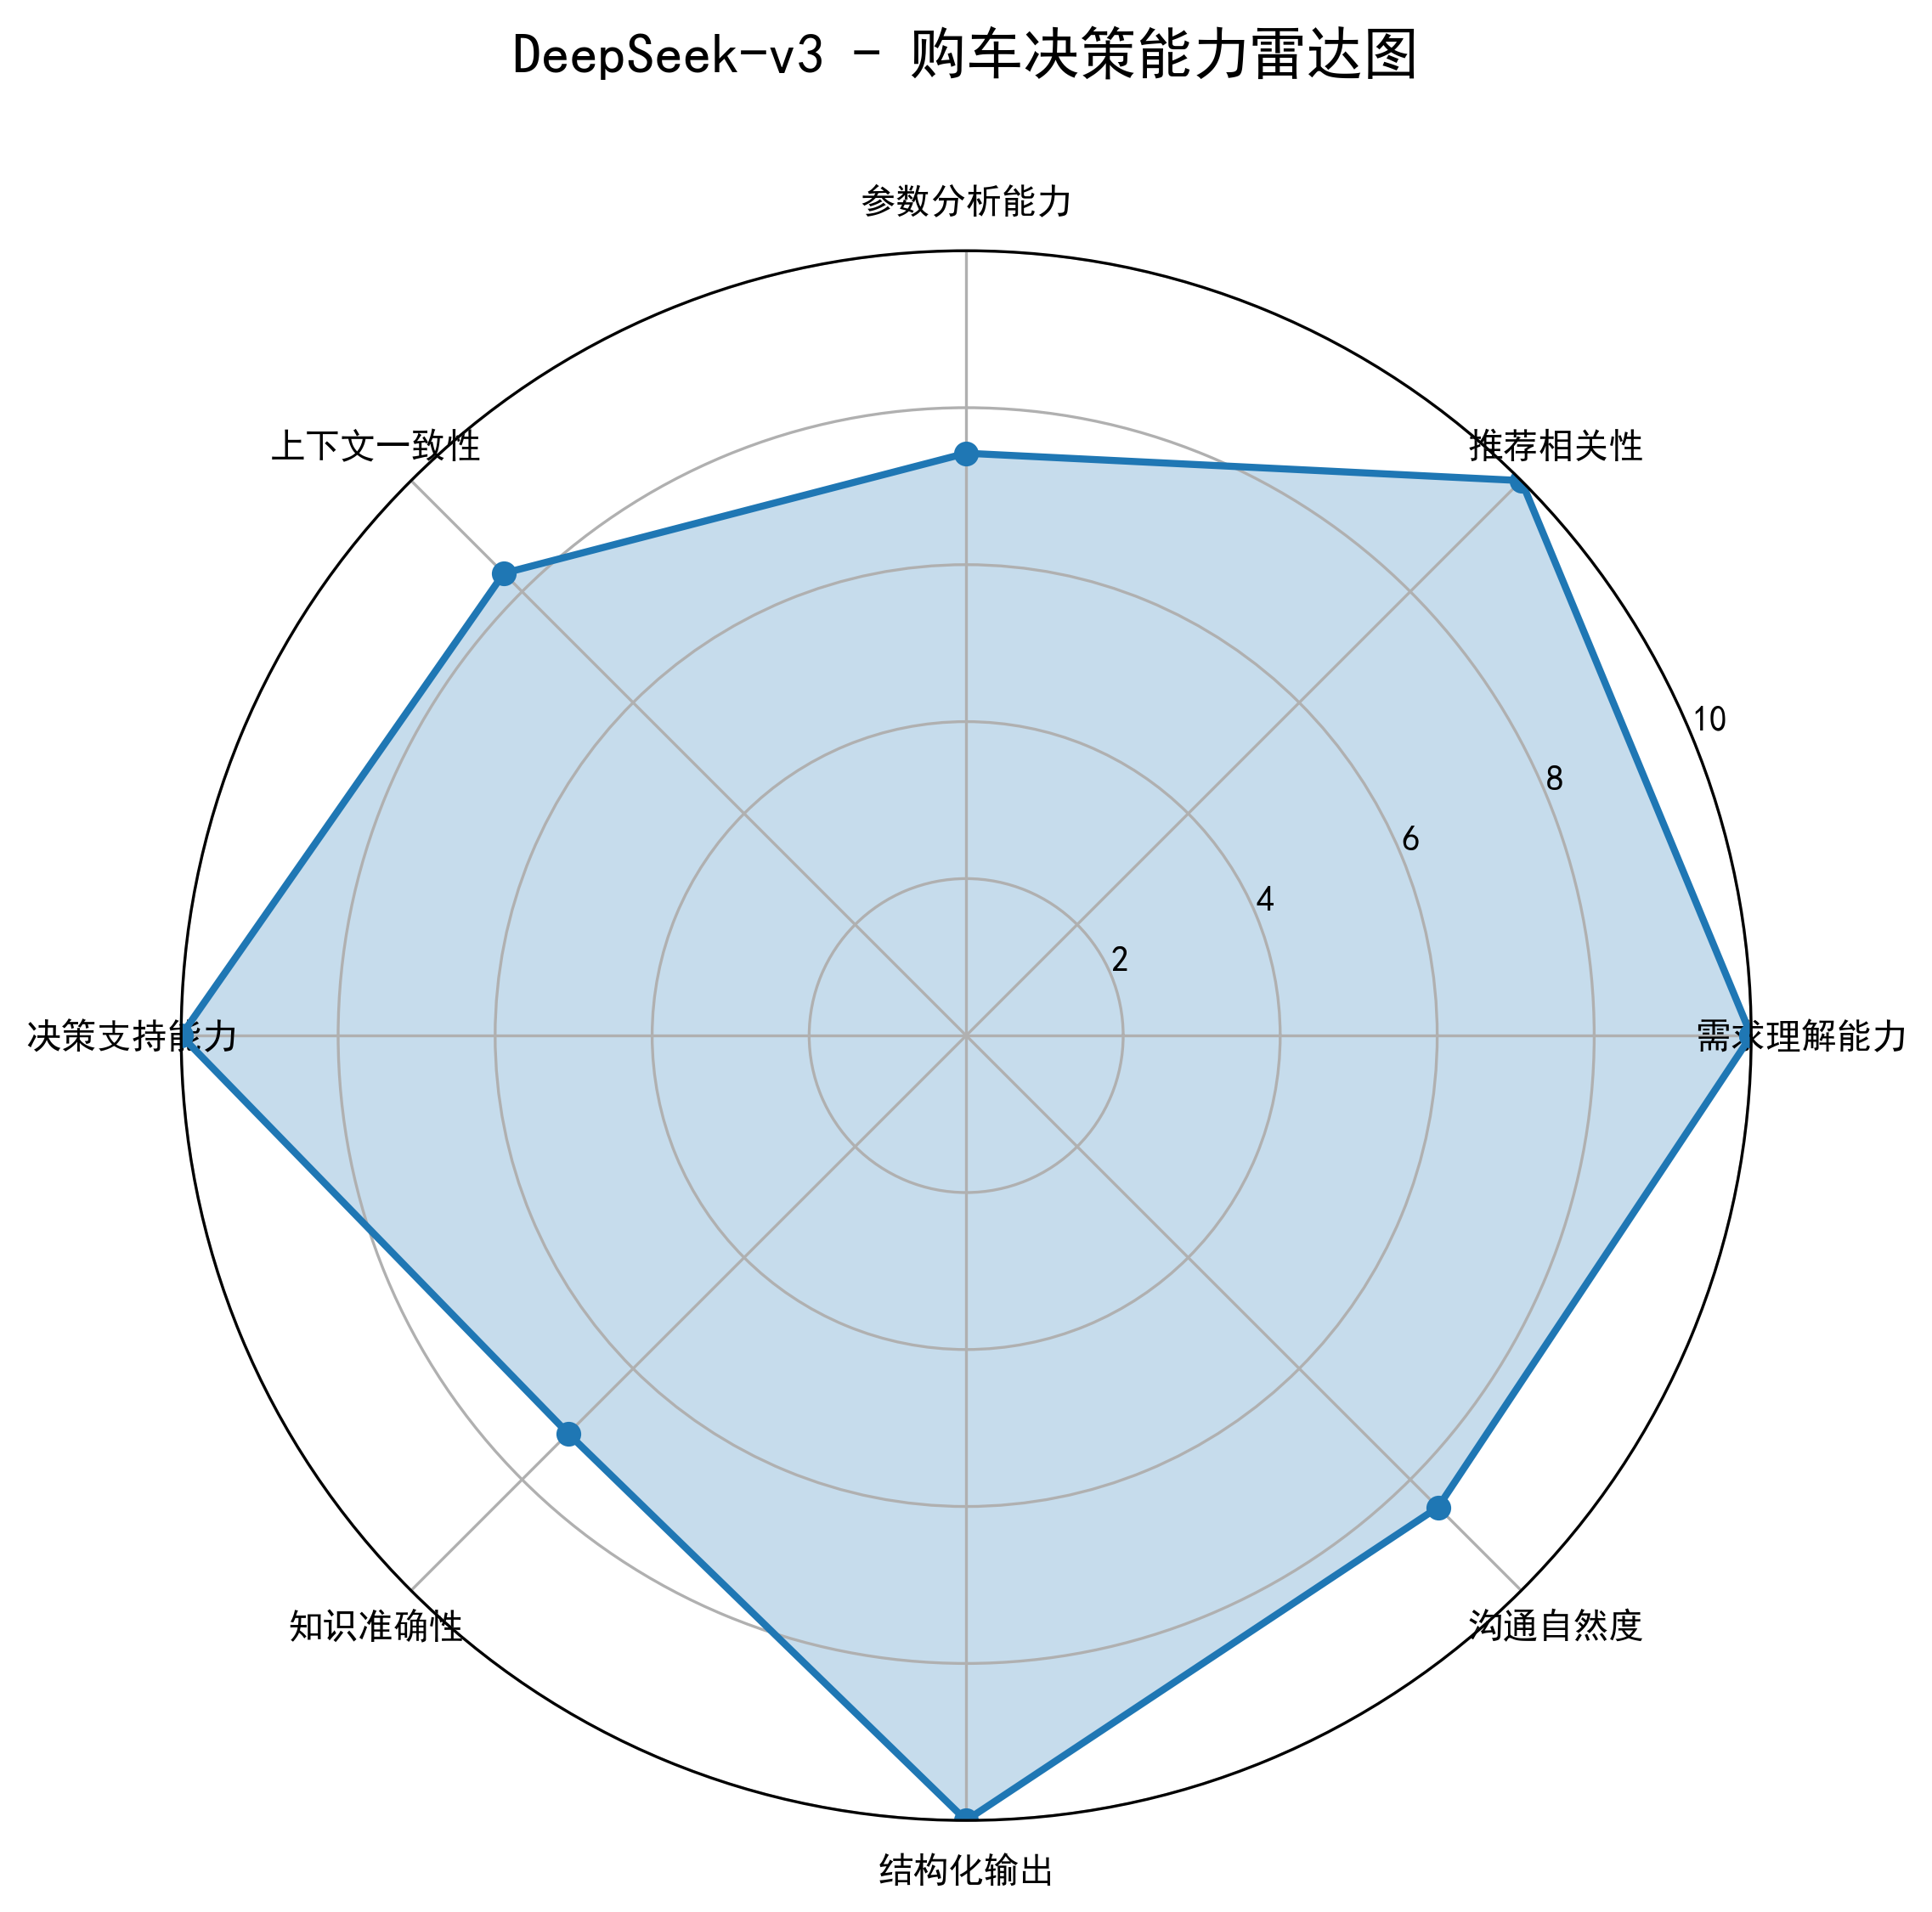
执行脚本后,脚本将自动开始测评,同时指明当前测评模型,输出测评过程中的缩略信息,最终决策完成后将自动对模型进行指标评测并自动生成CSV、JSON报告以及指标的雷达图、柱状图、场景热力图。
测评过程如下:
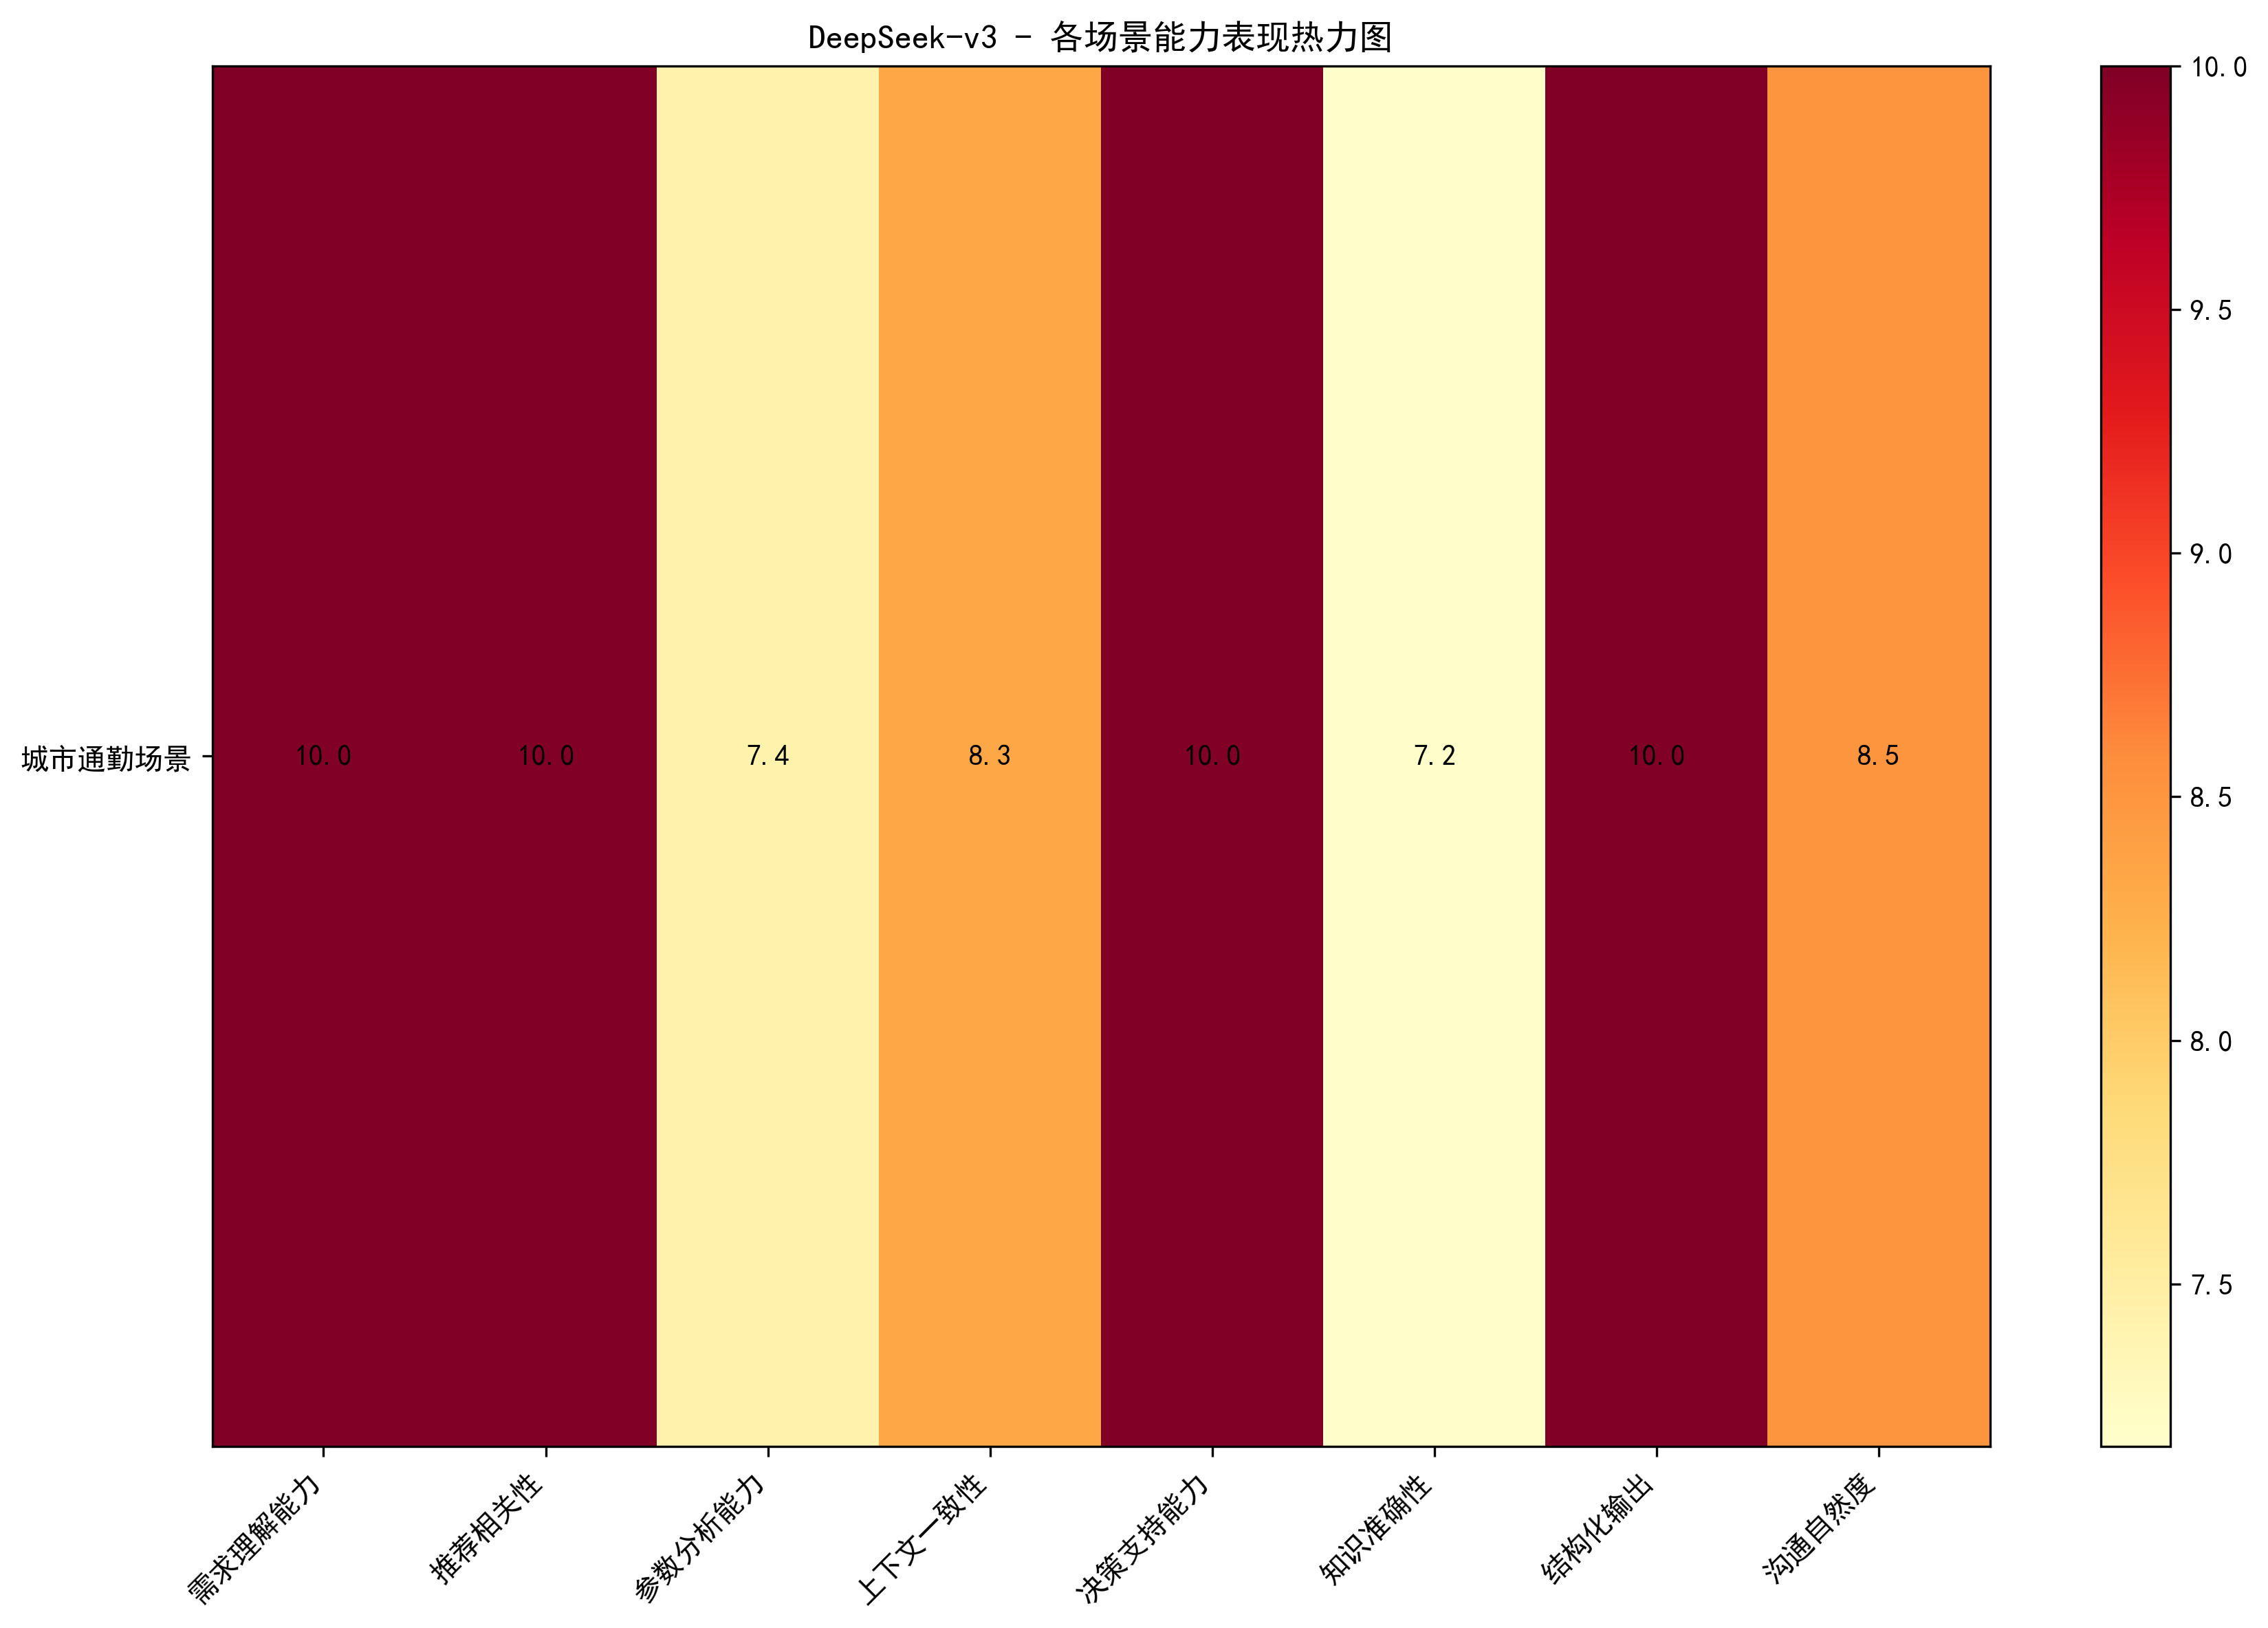
| 评测指标 | Qwen3-Max | DeepSeek-v3 |
|---|---|---|
| 需求理解能力 | 10.0 | 10.0 |
| 推荐相关性 | 10.0 | 10.0 |
| 参数分析能力 | 8.42 | 7.42 |
| 上下文一致性 | 8.67 | 8.33 |
| 决策支持能力 | 10.0 | 10.0 |
| 知识准确性 | 7.17 | 7.17 |
| 结构化输出 | 10.0 | 10.0 |
| 沟通自然度 | 7.5 | 8.5 |
| 总体得分 | 9.05 | 8.97 |
从客观得分来看,Qwen3-Max在参数分析能力和上下文一致性上略高于DeepSeek-v3,而DeepSeek-v3在沟通自然度上略高于Qwen3-Max。其他指标上两者持平。总体得分Qwen3-Max(9.05)略高于DeepSeek-v3(8.97),但差距不大。
两个模型在知识准确性上得分相同(7.17),但Qwen3-Max在参数分析能力上得分更高(8.42 vs 7.42)。这意味着Qwen3-Max在分析车辆参数(如动力、能耗、安全配置等)时表现更好。
DeepSeek-v3在沟通自然度上得分更高(8.5 vs 7.5),说明它的对话更自然流畅,用户体验可能更好。
两个模型在结构化输出上都得了满分(10.0),说明它们都能很好地生成表格和结构化信息。
推荐选择:Qwen3-Max
理由:
Qwen3-Max技术专业性更强:在参数分析这一关键维度显著领先。
Qwen3-Max分析深度更优:对车辆技术特性的解读更透彻。
Qwen3-Max推荐逻辑更严谨:上下文一致性更好,决策过程更透明。
Qwen3-Max信息量更丰富:虽然沟通稍显正式,但提供了更多有价值信息。
两款模型在购车推荐任务中都表现出色,总体得分接近9分,说明都具备了优秀的汽车顾问能力。
对于大多数购车用户而言,Qwen3-Max的专业深度更能满足复杂的购车决策需求,因此获得本次评测的推荐。
使用场景建议:
选择 Qwen3-Max :
用户对汽车技术参数有较高要求。
需要深入的技术对比分析。
重视推荐的系统性和逻辑性。
不介意相对正式的表达风格。
选择 DeepSeek-v3 :
用户更看重沟通的自然流畅。
希望获得简洁明了的建议。
对技术细节要求不是特别高。
偏好更人性化的交互体验。
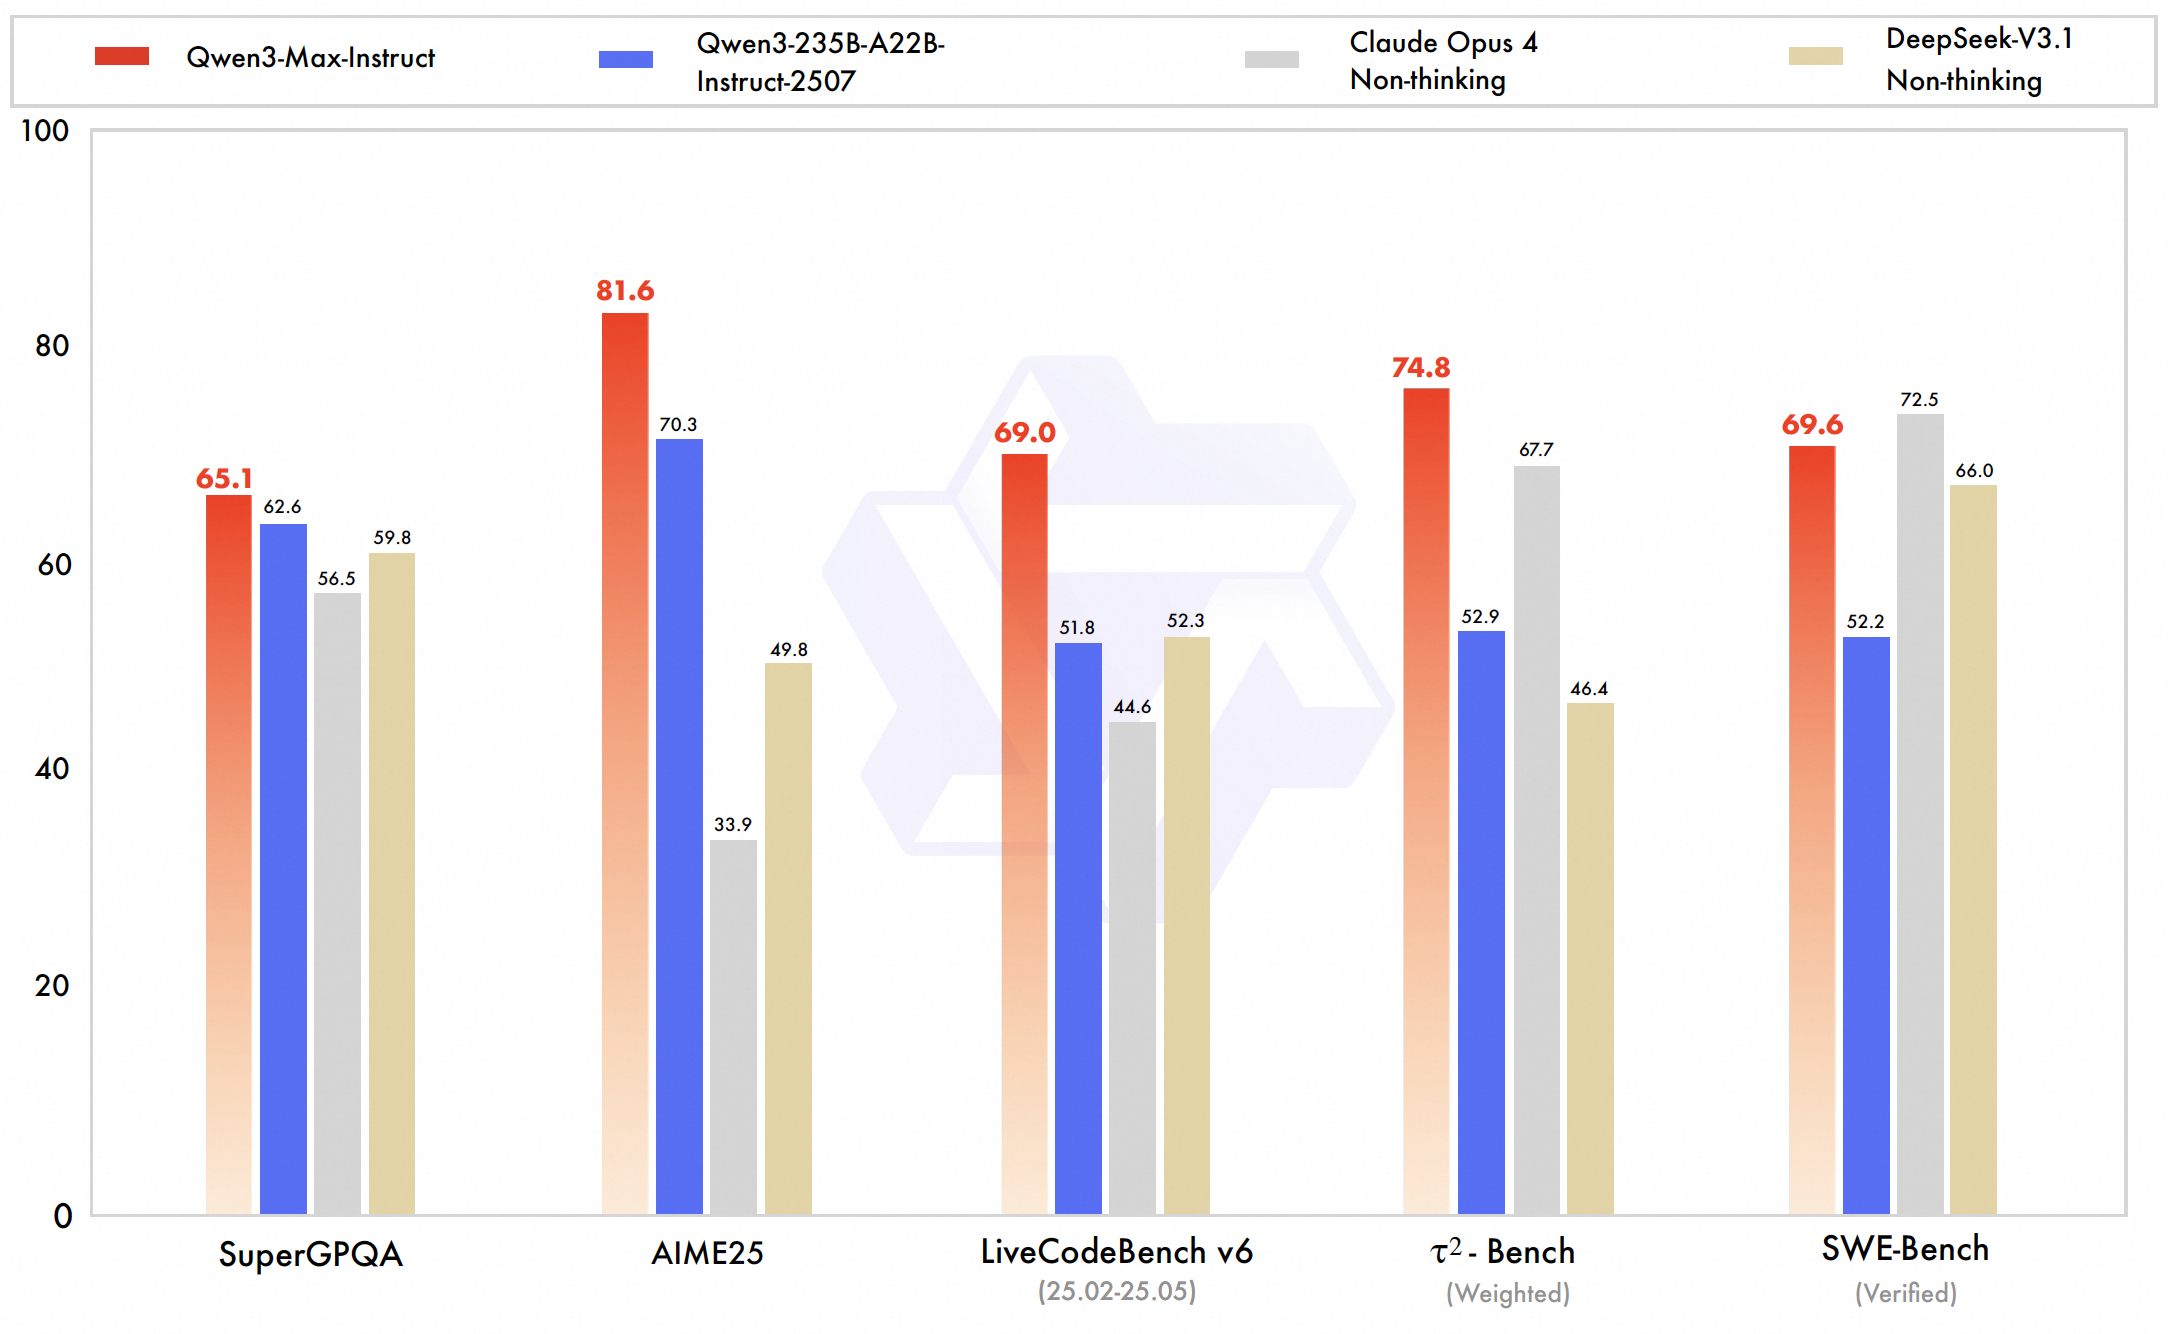
Qwen3-max发布时期同类产品对比图:
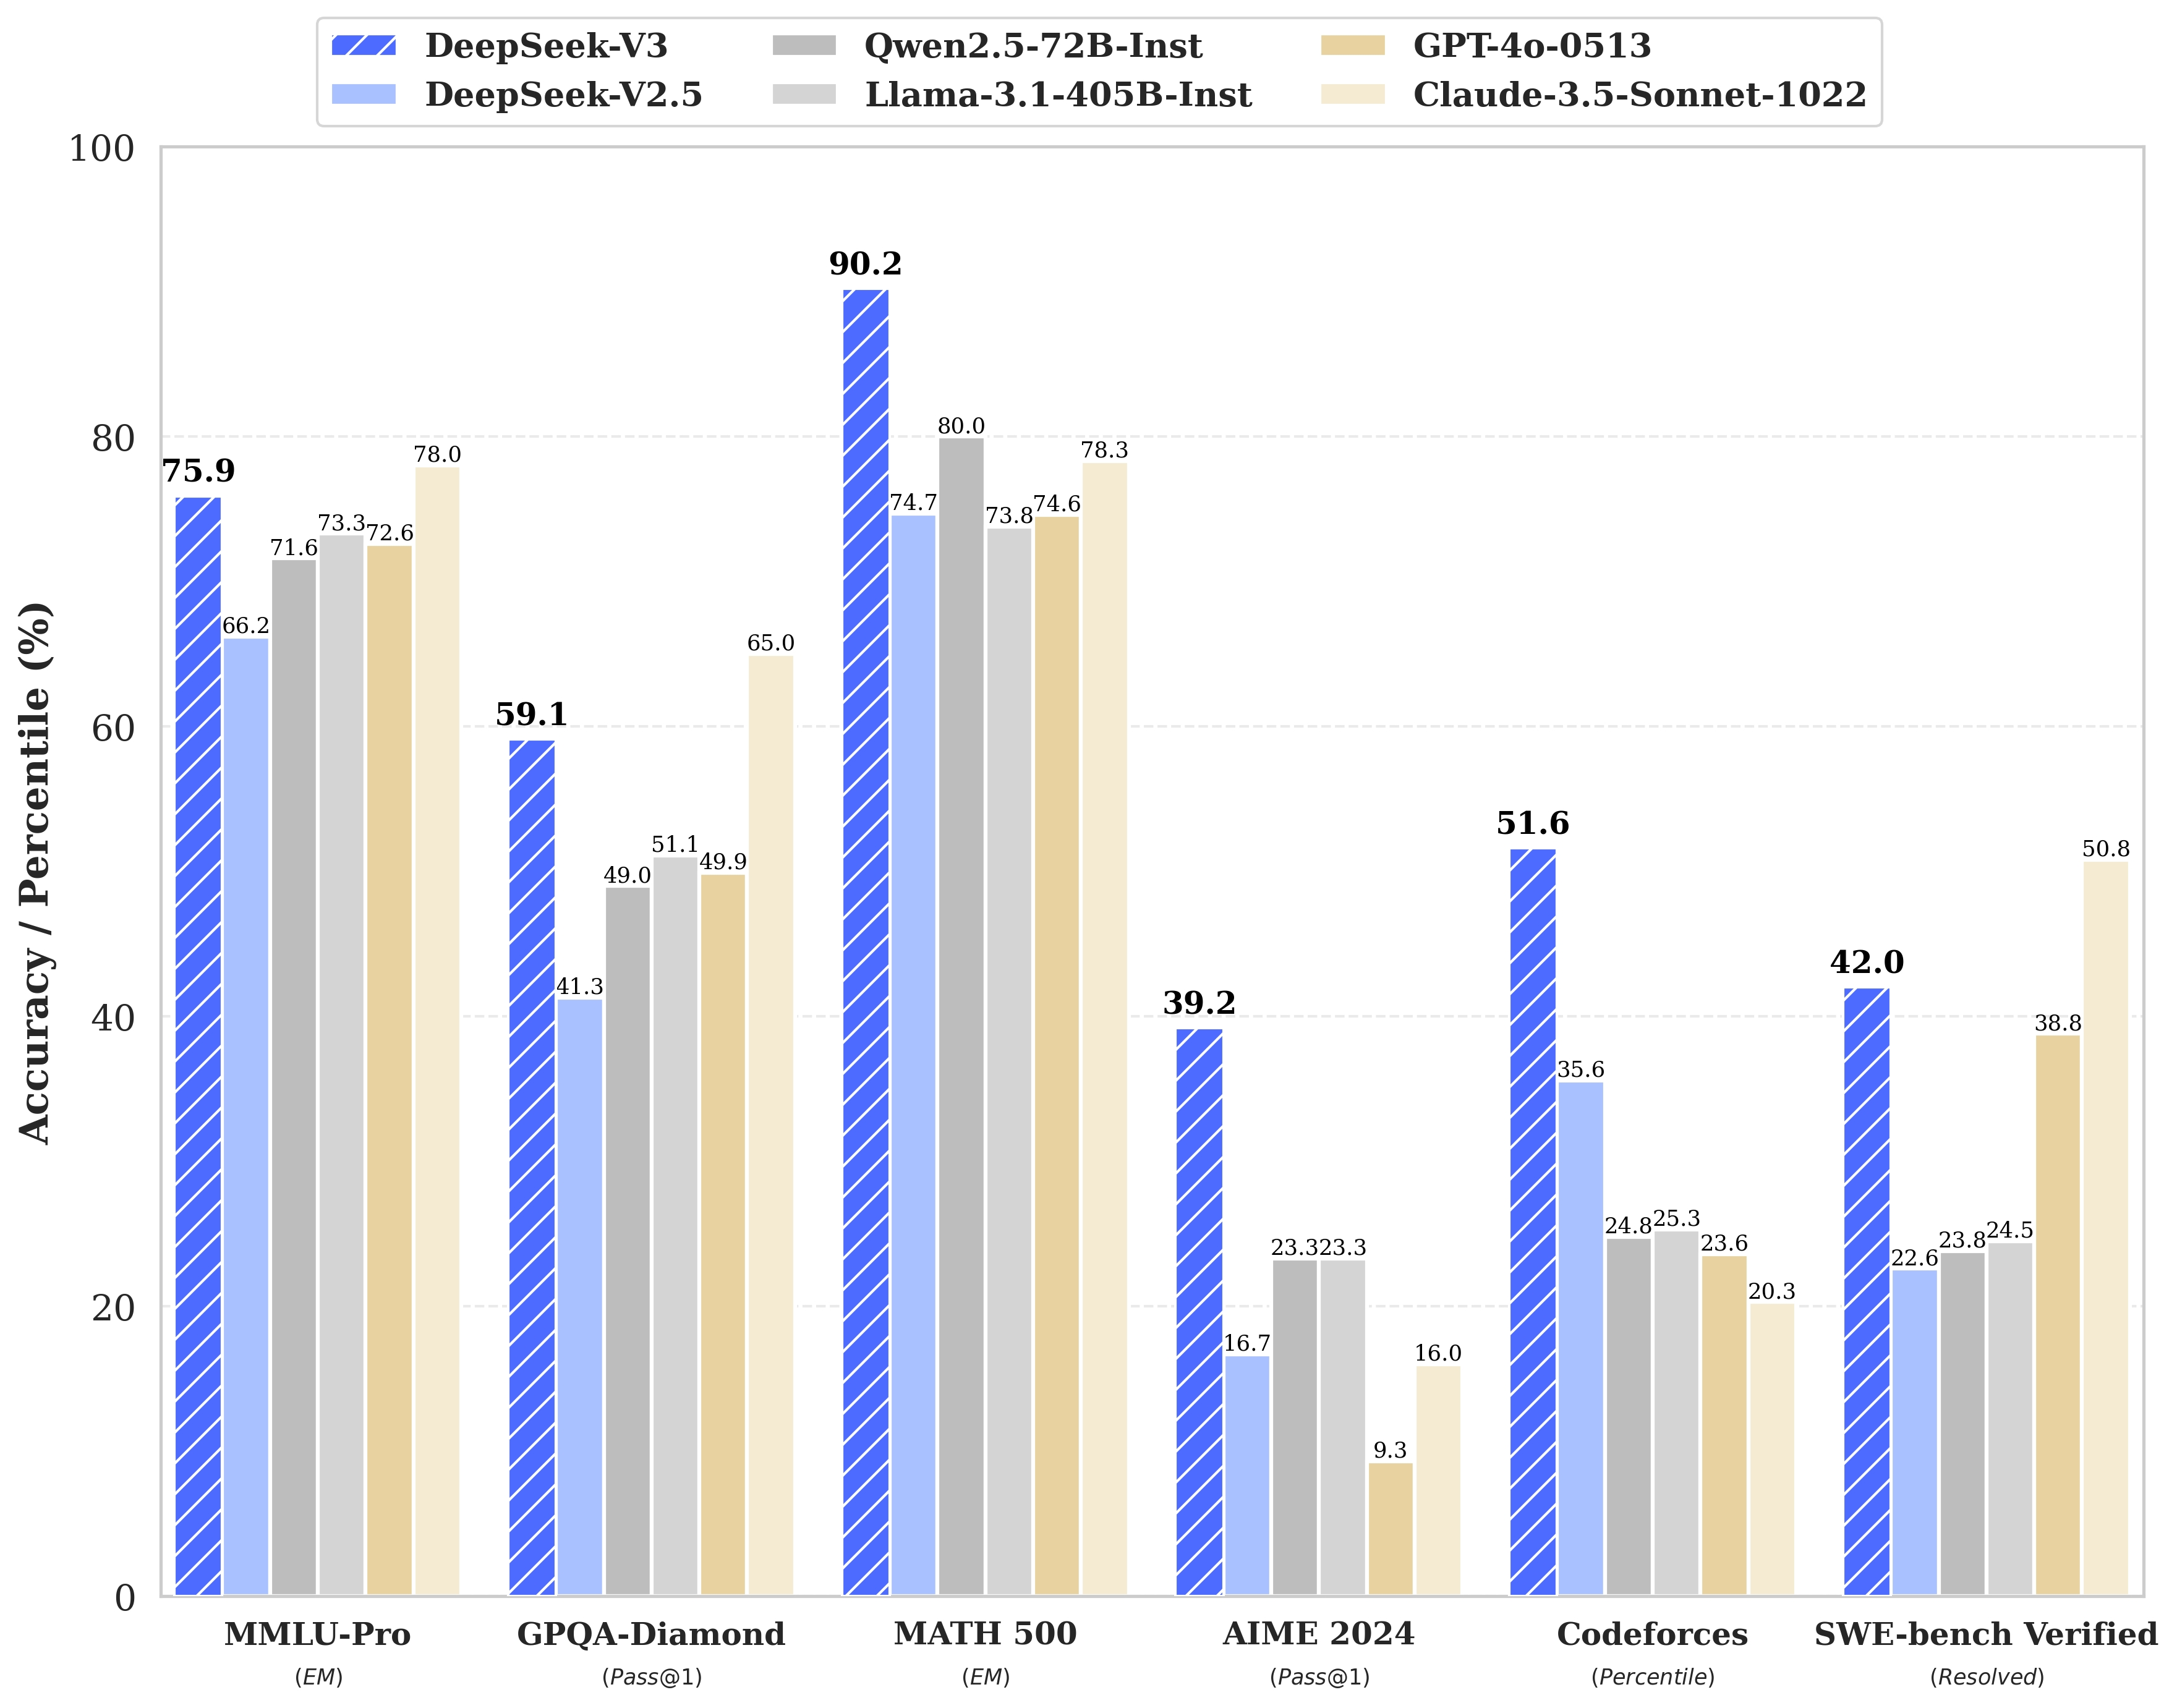
DeepSeek-v3发布时期同类产品对比图:
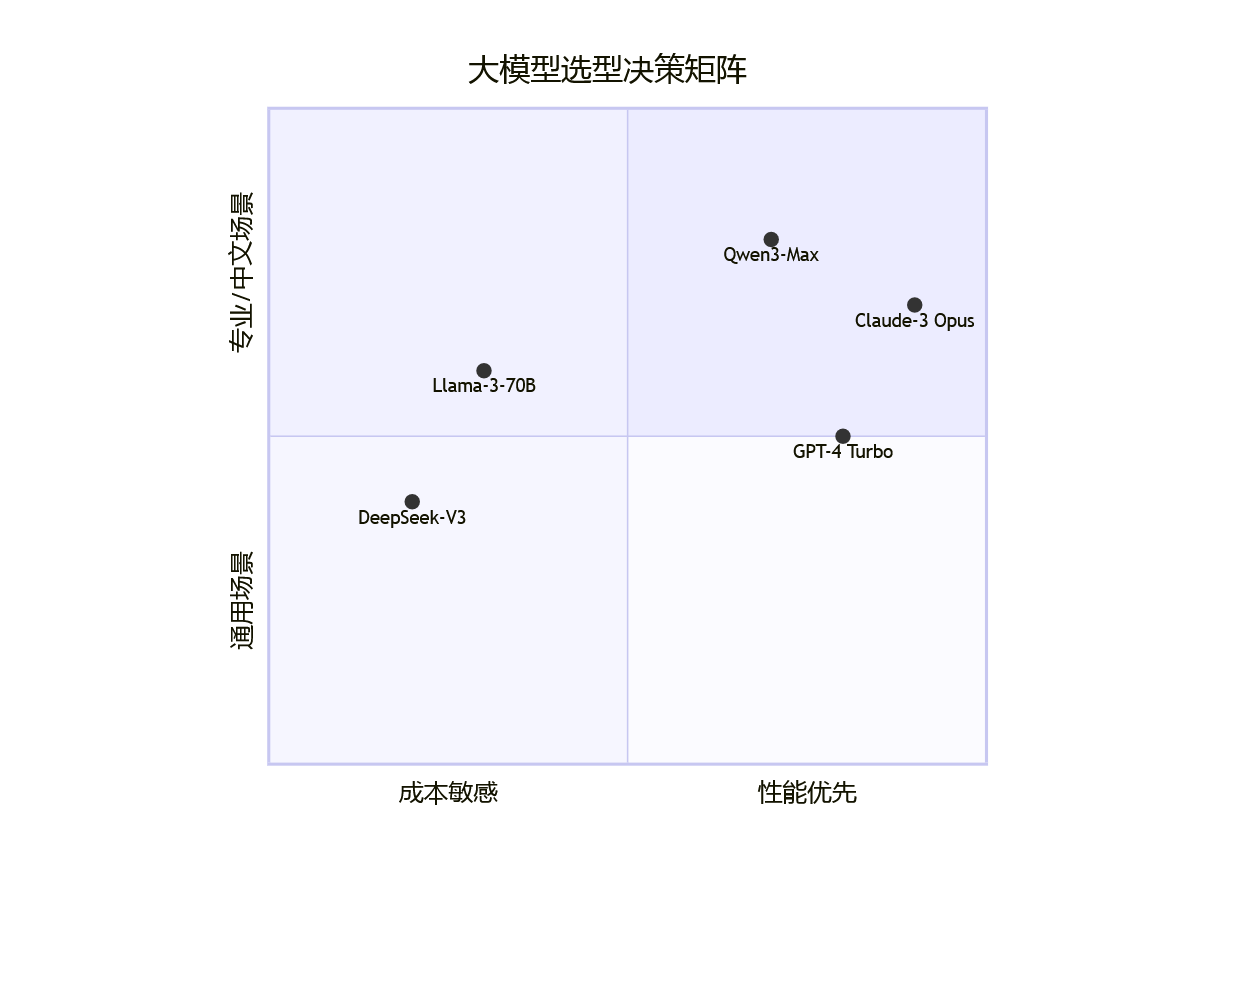
简单的大模型决策图:
建议大模型能够增强生成代码的可测试性。
希望大模型能够在生成代码前先产出测试用例:
用户需求 → 生成测试用例 → 基于测试用例生成代码 → 验证通过。
这样可以减少调试时间,使得问题在代码生成阶段就能够被发现,生成的代码更容易融入现有测试框架。
不同大模型性能不同的主要原因有以下几点:
2025上半年中国企业级市场日均大模型调用量达 10.2万亿Tokens。相较2024年下半年,日均调用量暴增363%。超过80% 的企业未来预计将采用开源大模型。 71% 的企业计划增加对公有云形态生成式AI服务的投入。
Qwen3-Max
DeepSeek-V3
Qwen3-Max
DeepSeek-V3
我们团队假设要优化Qwen3-max模型,新增功能为:“交互式代码调试与优化助手”。
软件工程师在日常编码中经常遇到代码调试和性能优化的问题,尤其是复杂代码的调试和性能瓶颈定位。目前的大模型虽然能生成代码,但缺乏交互式调试和深度优化指导。用户需要的是一个能够理解代码上下文、设置断点、逐步执行、分析性能瓶颈并提供优化建议的智能助手。
我们将在Qwen3-max模型中集成一个交互式代码调试与优化模块。该模块允许用户:
上传代码或指定代码段,设置断点。
模型模拟执行代码,并逐步展示执行过程(变量变化、函数调用栈等)。
自动检测代码中的潜在问题(如性能瓶颈、内存泄漏等)。
提供优化建议,并允许用户与模型交互以获取更详细的解释。
生成优化后的代码,并对比优化前后的性能。
提高调试效率:用户无需在IDE和模型之间切换,一站式完成代码调试和优化。
深度代码理解:模型利用其强大的代码理解能力,提供更准确的调试和优化建议。
学习与提升:用户可以通过模型的解释学习到代码优化和调试的技巧。
目前市场上已有一些代码调试工具(如IDE自带的调试器)和静态代码分析工具(如SonarQube),但它们缺乏与自然语言交互的能力。也有一些AI代码助手(如GitHub Copilot)提供代码建议,但不提供交互式调试和深度性能优化。我们的功能将结合调试器和AI的优势,提供更智能的交互体验。
作为Qwen3-max模型的一个特色功能,在官方文档和演示中突出展示。
针对开发者社区,举办线上教程和竞赛,鼓励使用该功能。
与热门IDE插件集成,方便用户使用。
项目经理(1人):负责项目进度管理、资源协调、风险管理。
后端开发(2人):负责模型功能集成、调试器后端逻辑、性能分析模块。
前端开发(1人):负责用户界面开发,实现代码编辑器、调试控制台等。
测试工程师(1人):负责功能测试、性能测试、用户体验测试。
美工/UI设计师(1人):负责界面设计,确保用户体验友好。
第1-4周:需求分析与设计
第1周:项目启动,明确需求,技术调研。
第2周:制定详细的产品需求文档和设计文档。
第3周:UI/UX设计,输出界面原型。
第4周:技术架构设计,确定技术栈,制定开发计划。
第5-8周:核心开发阶段
第5周:搭建开发环境,后端开发开始实现代码解析和模拟执行模块。
第6周:后端开发继续,前端开发开始根据设计实现界面。
第7周:后端实现调试控制逻辑,前端实现代码编辑器和调试控制器。
第8周:前后端联调,实现基本的代码调试流程。
第9-12周:功能增强与集成
第9周:集成性能分析模块,后端开发性能检测算法。
第10周:实现优化建议生成,并与模型交互。
第11周:前端优化,提升用户体验。
第12周:前后端集成测试,修复重大问题。
第13-16周:测试与发布
第13周:内部测试,收集反馈,进行迭代。
第14周:Beta版发布,邀请外部用户测试。
第15周:根据反馈优化,修复bug。
第16周:正式发布,准备发布文档和宣传材料。
交互式调试:将传统调试器的逐步执行与自然语言交互结合,用户可以用自然语言询问调试过程中的问题。
智能优化建议:不仅指出问题,还提供优化建议,并生成优化后的代码。
性能分析集成:在调试过程中实时分析性能,定位瓶颈。
一站式解决方案:无需在多个工具间切换,一个界面完成编码、调试、优化。
智能辅助:利用大模型的代码理解能力,提供更深入的调试和优化建议。
学习工具:通过模型的解释,用户能够学习到代码优化的技巧,提升自身能力。
协助日常学习工作
大语言模型可以作为编程学习的助手,帮助解答问题、解释概念、提供代码示例,从而加速学习过程。例如,当遇到不理解的算法或语法时,可以立即向模型提问,获得即时帮助。
在完成编程作业或项目时,大语言模型能够生成代码片段,帮助实现特定功能,同时也能辅助调试,解释错误信息,提供修复建议,节省大量时间和精力。
在撰写技术报告、文档或论文时,大语言模型可以帮助整理思路、润色文字、检查语法,提高写作效率和质量。
大语言模型可以协助完成一些重复性的任务,如生成脚本、处理数据、自动生成测试用例等,提高效率。
不能过度依赖大语言模型
过度依赖大语言模型可能导致独立思考能力和解决问题能力的下降。此外,模型可能提供错误的信息,需要批判性思维来辨别。
使用大语言模型时,需要注意代码的版权问题,避免直接使用模型生成的代码而侵犯知识产权。同时,注意保护隐私,不要输入敏感信息。
大语言模型为软件工程专业的学生提供了强大的工具,但需要合理使用,将其作为辅助而非替代,同时保持批判性思维和持续学习的态度。
| 学号 | 实际工作内容 | 贡献度 |
|---|---|---|
| 102300107 | 负责第8.1节,对大模型可能的新功能模块产品规划进行NABCD分析。 | 12% |
| 102300121 | 负责第1.1.5节,对Qwen3-Max模型进行用户采访。 | 12% |
| 102300207 | 负责第4到7节,对不同大模型进行对比分析,调研市场概况,在软件工程方面对大模型提出建议,协助调试自动化测评脚本。 | 12% |
| 102300211 | 负责第2.1节、第8.2到8.5节,分析体验大模型DeepSeek-v3,完成对大模型可能的新功能模块产品规划进行具体团队规划。 | 12% |
| 102300312 | 负责1.1节,分析体验大模型Qwen3-Max。 | 12% |
| 102300408 | 负责2.1.5节,对DeepSeek-v3模型进行用户采访。 | 12% |
| 102300432 | 负责1.2到1.3节、2.2到2.3节、第9、10节,设计全自动测评脚本,对两款大模型进行自动化测试并分析评测结果,说明大模型对软件工程大学生的影响,分配任务撰写博客。 | 16% |
| 102300434 | 负责答辩PPT制作,协助调试自动化测评脚本。 | 12% |


